
식품 제조 데이터, 흩어져 있으면 AI도 답을 찾기 어렵습니다
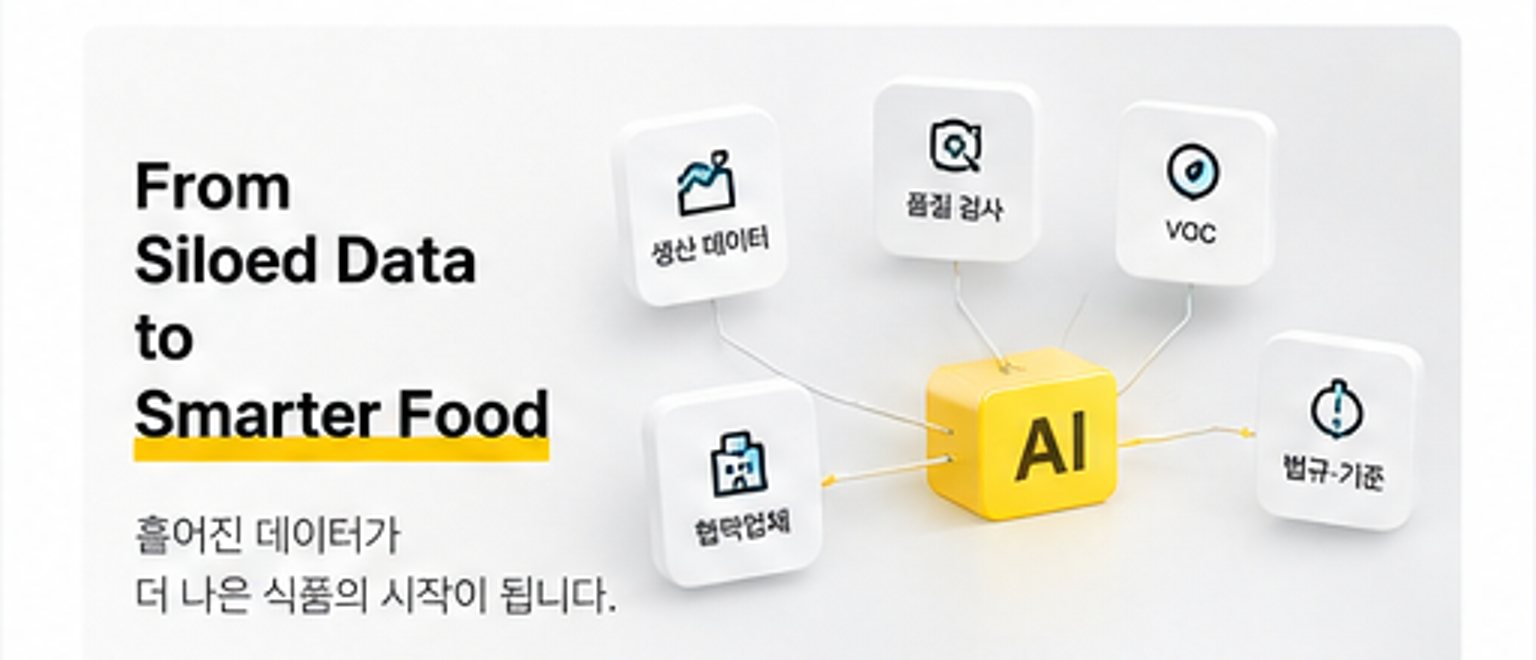
식품 제조 현장에는 데이터가 없는 게 아니라, 너무 많은 곳에 나뉘어 있는 경우가 더 많아요. 생산 데이터, 품질 검사, 협력업체 정보, VOC, 법규·기준 문서가 각자 다른 파일과 시스템에 쌓입니다.
식품 제조 현장의 데이터, 왜 흩어져 있을까요?
업무마다 데이터를 보는 목적이 다르기 때문이에요. 생산팀은 공정과 수율을 보고, 품질팀은 검사 결과와 부적합을 관리하죠.
구매·협력업체 담당자는 업체와 Audit 이력을 보고, CS는 VOC를 중심으로 기록합니다. 각 데이터가 제 역할을 잘하고 있어도 서로 연결되지 않으면 하나의 질문에 답하기가 어려워져요.
특정 이슈가 발생했을 때 생산처, 최근 점검 이력, VOC, 적용 기준을 사람이 다시 찾아 이어 붙여야 하니까요.
좋은 데이터는 좋은 식품을 만드는 가장 확실한 재료입니다.
데이터를 연결하면 무엇이 달라질까요?
연결의 핵심은 모든 데이터를 한 화면에 모으는 게 아니에요. 같은 업체, 생산처, 품목, 기간을 기준으로 서로 다른 기록을 함께 볼 수 있게 만드는 겁니다.
특정 생산처를 선택했을 때 최근 Audit 결과와 VOC 변화, 반복 이슈, 관련 기준을 같이 볼 수 있다고 해볼게요. 질문이 “문제가 있나요?”에서 “무엇이 반복됐고, 다음 확인은 어디인가요?”로 구체적으로 바뀝니다.
- 빠른 현황 파악 — 여러 시스템을 오가지 않고 같은 대상의 이력을 한 흐름에서 확인해요.
- 데이터 기반 의사결정 — 감이나 기억보다 실제 기록을 놓고 우선순위를 정해요.
- 리스크 사전 감지 — 반복되는 변화와 이상 신호를 먼저 확인할 후보로 올려요.
- 업무 효율화 — 자료를 찾고 대조하는 시간을 줄이고, 확인이 필요한 부분에 집중해요.
이때 AI는 흩어진 정보를 대신 검색해주는 도구에서 한 단계 더 나아갑니다. 연결된 데이터를 읽고, 사람이 확인해야 할 맥락을 정리하는 분석 도구가 되는 거죠.
데이터스케쳐스의 접근 방식
데이터스케쳐스는 AI 모델부터 고르기보다 먼저 “무엇을 같은 대상으로 볼 것인가”를 정합니다. 업체명이나 생산처명이 비슷하다는 이유만으로 데이터를 자동으로 합치지 않고, 확인 가능한 키와 매핑 기준을 둬요.
그다음 원본과 분석 결과 사이의 연결을 남깁니다. 어떤 결과가 어느 파일, 어느 시점의 데이터에서 나왔는지 다시 확인할 수 있어야 현업도 AI 결과를 검토할 수 있기 때문이에요.
모르는 값도 억지로 채우지 않습니다. 자료가 없다는 이유만으로 0점이나 ‘문제 없음’으로 처리하지 않고, 미연결이나 자료 부족 상태를 따로 보여줍니다.