
식품 제조 AI 프로젝트 전에 먼저 정리할 7가지 데이터
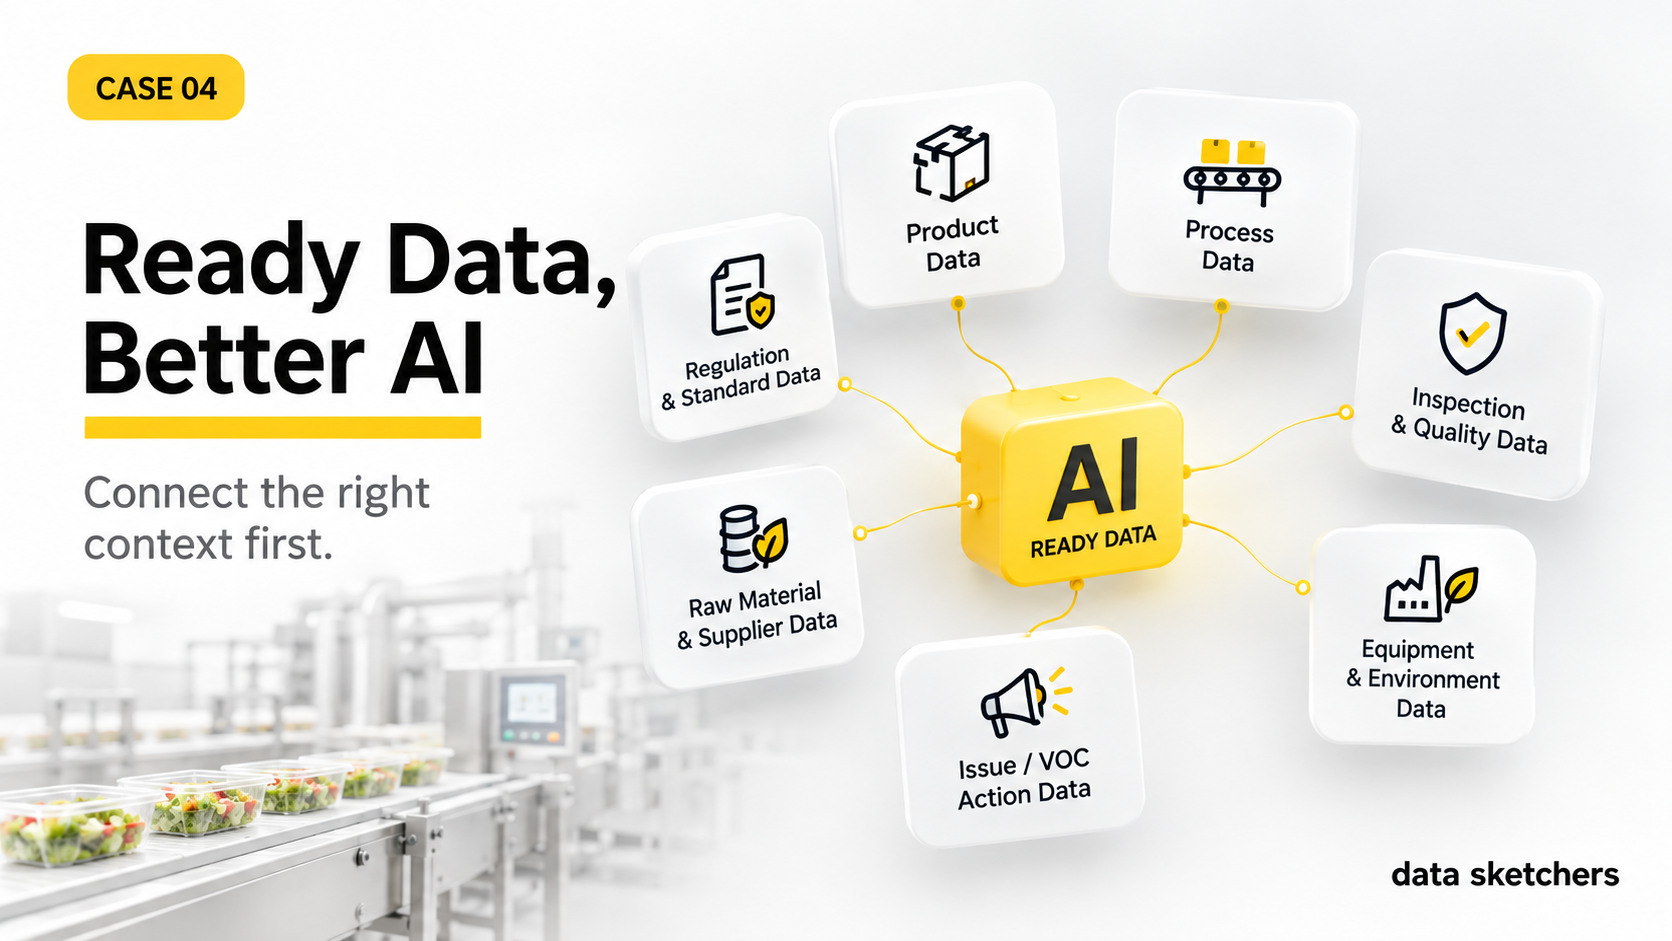
식품 제조 AI를 시작할 때 가장 먼저 모델부터 고르고 싶어집니다. 그런데 실제 프로젝트에서 먼저 답해야 하는 질문은 “어떤 데이터가 이 업무 질문에 답할 수 있나?”예요.
AI에 넣을 데이터보다, 연결할 대상을 먼저 정합니다
예를 들어 품질 이상을 먼저 찾고 싶다고 해볼게요. 검사 결과만 봐서는 부족하고, 같은 품목의 공정 조건과 원료, 설비 상태, 최근 VOC까지 이어서 봐야 원인을 좁힐 수 있습니다.
그래서 첫 단계에서는 파일 목록보다 ‘무엇을 같은 사건과 같은 대상으로 묶을 것인가’를 정합니다. 품목, 생산 Lot, 공정, 설비, 업체처럼 기준이 되는 식별자를 먼저 찾는 이유예요.
AI는 없는 맥락을 만들어내는 도구라기보다, 연결된 맥락을 더 빠르게 읽는 도구에 가깝습니다.
먼저 확인할 7가지 데이터
처음부터 모든 데이터를 모을 필요는 없습니다. 아래 일곱 범주가 어디에 있고 어떤 단위로 기록되는지만 확인해도 AI 준비 상태가 훨씬 선명해집니다.
- 품목·제품 — 품목 코드, 제품군, 생산 단위를 같은 기준으로 볼 수 있는지 확인해요.
- 공정 — 공정 단계, 생산 순서, 작업 조건이 시간축으로 이어지는지 봅니다.
- 검사·품질 — 검사 결과, 부적합, 재검사와 조치 결과가 연결되는지 확인해요.
- 설비·환경 — 설비 상태와 온도·습도 같은 환경값이 생산 시점과 맞물리는지 봅니다.
- 원료·협력업체 — 원료 Lot와 공급업체, Audit·시정조치 이력을 이어볼 수 있어야 해요.
- 이슈·VOC·조치 — 고객 불만과 내부 이슈가 어떤 제품과 공정으로 돌아가는지 확인합니다.
- 규정·기준 — 점검 결과를 해석할 때 참고할 내부 기준과 공개 규정의 버전을 관리해요.
데이터가 있다고 바로 준비된 것은 아닙니다
같은 품목이 시스템마다 다른 이름으로 기록되거나, 날짜 형식과 단위가 제각각이면 AI는 하나의 흐름으로 읽기 어렵습니다. 빈칸이 0인지, 미수집인지, 해당 없음인지도 구분해야 하고요.
이 단계에서 중요한 건 완벽한 정제가 아닙니다. 어떤 데이터가 연결되고 어디가 비어 있는지, 원본까지 다시 돌아갈 수 있는지를 먼저 보이게 만드는 겁니다.
첫 주에는 모델보다 데이터 지도를 만드세요
업무 질문을 가운데 두고 필요한 데이터와 식별자를 그려보면, 지금 바로 PoC가 가능한 부분과 추가 정리가 필요한 부분이 나뉩니다. 모델 선택은 그다음이어도 늦지 않아요.
데이터스케쳐스는 AI 도입 전 이런 연결 지도를 먼저 만듭니다. 좋은 모델보다 좋은 질문과 좋은 데이터 관계가 프로젝트의 방향을 더 크게 바꾸는 경우가 많기 때문이에요.