
OpenTelemetry로 에이전트 실행 계측하기
OpenTelemetry로 에이전트 실행 계측하기
출처: Inspecting runs with OpenTelemetry - Hugging Face smolagents 공식 문서
에이전트를 처음 만들어 보는 분이라면 먼저 에이전트 소개와 smolagents 둘러보기를 읽어 두세요. 이 글은 운영 환경에서 에이전트 실행을 기록하고 모니터링하기 위해 OpenTelemetry 표준으로 계측하는 방법을 다룹니다.
에이전트 실행을 왜 로깅해야 하나요
에이전트 실행은 디버깅하기 까다롭습니다.
실행이 제대로 됐는지 검증하는 것도 어려워요. 에이전트 워크플로는 설계상 예측 불가능하기 때문입니다(예측 가능했다면 그냥 예전 방식의 코드를 쓰면 되겠죠).
실행을 들여다보는 것도 어렵습니다. 멀티 스텝 에이전트는 곧 콘솔을 로그로 가득 채우는 경향이 있고, 대부분의 오류는 그냥 "LLM이 멍청했네" 수준의 오류라 다음 단계에서 LLM이 더 나은 코드나 툴 호출을 쓰며 스스로 고쳐나가거든요.
그래서 프로덕션에서는 에이전트 실행을 계측으로 기록해 두는 것이, 나중에 들여다보고 모니터링하기 위해 필요합니다.
저희는 에이전트 실행 계측에 OpenTelemetry 표준을 채택했습니다.
즉, 계측 코드를 조금 실행하고 나서 에이전트를 평소처럼 실행하기만 하면 모든 것이 플랫폼에 로깅됩니다. 아래는 여러 OpenTelemetry 백엔드로 이를 하는 예시입니다.
플랫폼에서 보면 이렇게 보입니다.

Arize AI Phoenix로 텔레메트리 설정하기
먼저 필요한 패키지를 설치합니다. 여기서는 로그를 수집·조회하기 좋은 솔루션인 Arize AI의 Phoenix를 설치하지만, 수집·조회 부분에는 다른 OpenTelemetry 호환 플랫폼을 써도 됩니다.
pip install 'smolagents[telemetry,toolkit]'
그런 다음 컬렉터를 백그라운드에서 실행합니다.
python -m phoenix.server.main serve
마지막으로 SmolagentsInstrumentor를 설정해 에이전트를 트레이싱하고 트레이스를 Phoenix 기본 엔드포인트로 보냅니다.
from phoenix.otel import register
from openinference.instrumentation.smolagents import SmolagentsInstrumentor

register()
SmolagentsInstrumentor().instrument()
이제 에이전트를 실행하면 됩니다!
from smolagents import (
    CodeAgent,
    ToolCallingAgent,
    WebSearchTool,
    VisitWebpageTool,
    InferenceClientModel,
)

model = InferenceClientModel()

search_agent = ToolCallingAgent(
    tools=[WebSearchTool(), VisitWebpageTool()],
    model=model,
    name="search_agent",
    description="This is an agent that can do web search.",
)

manager_agent = CodeAgent(
    tools=[],
    model=model,
    managed_agents=[search_agent],
)
manager_agent.run(
    "If the US keeps its 2024 growth rate, how many years will it take for the GDP to double?"
)
짜잔!
http://0.0.0.0:6006/projects/로 이동하면 실행을 들여다볼 수 있습니다.

보시다시피 CodeAgent가 매니지드 ToolCallingAgent를 불러서(참고로 매니지드 에이전트는 CodeAgent여도 됩니다) 미국 2024년 성장률 웹 검색을 시키고, 매니지드 에이전트가 보고서를 돌려주면 매니저 에이전트가 이를 바탕으로 경제가 두 배가 되는 시간을 계산했어요. 멋지지 않나요?
MLflow로 텔레메트리 설정하기
MLflow는 Smolagents용 한 줄 자동 로깅을 제공합니다. 실행, 스팬, 입력/출력, 토큰 사용량을 MLflow UI에서 추적해 줍니다.
MLflow를 설치하고 자동 로깅을 켠 뒤, 몇 가지 툴과 함께 에이전트를 실행합니다.
%pip install mlflow smolagents

import mlflow
from smolagents import CodeAgent, ToolCallingAgent, WebSearchTool, VisitWebpageTool, InferenceClientModel

mlflow.smolagents.autolog()  # start tracing everything below

model = InferenceClientModel()
browser = ToolCallingAgent(
    tools=[WebSearchTool(), VisitWebpageTool()],
    model=model,
    name="search_agent",
    description="Web search helper",
)
manager = CodeAgent(model=model, managed_agents=[browser])
manager.run("Find the latest US GDP growth rate and estimate when it would double.")
UI를 시작해 트레이스를 조회하고, 브라우저에서 Traces 뷰를 엽니다.
mlflow server --port 5000
🪢 Langfuse로 텔레메트리 설정하기
이 부분은 SmolagentsInstrumentor로 Hugging Face smolagents를 Langfuse로 모니터링·디버깅하는 방법을 보여줍니다.
Langfuse란? Langfuse는 LLM 엔지니어링을 위한 오픈소스 플랫폼입니다. AI 에이전트를 위한 트레이싱과 모니터링 기능을 제공하며, 개발자가 제품을 디버깅·분석·최적화하도록 돕습니다. Langfuse는 네이티브 통합, OpenTelemetry, SDK를 통해 다양한 툴·프레임워크와 통합됩니다.
1단계: 의존성 설치
%pip install langfuse 'smolagents[telemetry]' openinference-instrumentation-smolagents
2단계: 환경 변수 설정
Langfuse API 키를 설정하고 OpenTelemetry 엔드포인트를 구성해 트레이스를 Langfuse로 보냅니다. Langfuse Cloud에 가입하거나 Langfuse 셀프 호스팅으로 API 키를 얻으세요.
또한 Hugging Face 토큰(HF_TOKEN)을 환경 변수로 추가합니다.
import os
# Get keys for your project from the project settings page: https://cloud.langfuse.com
os.environ["LANGFUSE_PUBLIC_KEY"] = "pk-lf-..."
os.environ["LANGFUSE_SECRET_KEY"] = "sk-lf-..."
os.environ["LANGFUSE_HOST"] = "https://cloud.langfuse.com" # 🇪🇺 EU region
# os.environ["LANGFUSE_HOST"] = "https://us.cloud.langfuse.com" # 🇺🇸 US region

# your Hugging Face token
os.environ["HF_TOKEN"] = "hf_..."
환경 변수가 설정되면 Langfuse 클라이언트를 초기화할 수 있습니다. get_client()는 환경 변수의 자격 증명으로 Langfuse 클라이언트를 초기화합니다.
from langfuse import get_client

langfuse = get_client()

# Verify connection
if langfuse.auth_check():
    print("Langfuse client is authenticated and ready!")
else:
    print("Authentication failed. Please check your credentials and host.")
3단계: SmolagentsInstrumentor 초기화
애플리케이션 코드 이전에 SmolagentsInstrumentor를 초기화합니다.
from openinference.instrumentation.smolagents import SmolagentsInstrumentor

SmolagentsInstrumentor().instrument()
4단계: smolagent 실행
from smolagents import (
    CodeAgent,
    ToolCallingAgent,
    WebSearchTool,
    VisitWebpageTool,
    InferenceClientModel,
)

model = InferenceClientModel(
    model_id="deepseek-ai/DeepSeek-R1-Distill-Qwen-32B"
)

search_agent = ToolCallingAgent(
    tools=[WebSearchTool(), VisitWebpageTool()],
    model=model,
    name="search_agent",
    description="This is an agent that can do web search.",
)

manager_agent = CodeAgent(
    tools=[],
    model=model,
    managed_agents=[search_agent],
)
manager_agent.run(
    "How can Langfuse be used to monitor and improve the reasoning and decision-making of smolagents when they execute multi-step tasks, like dynamically adjusting a recipe based on user feedback or available ingredients?"
)
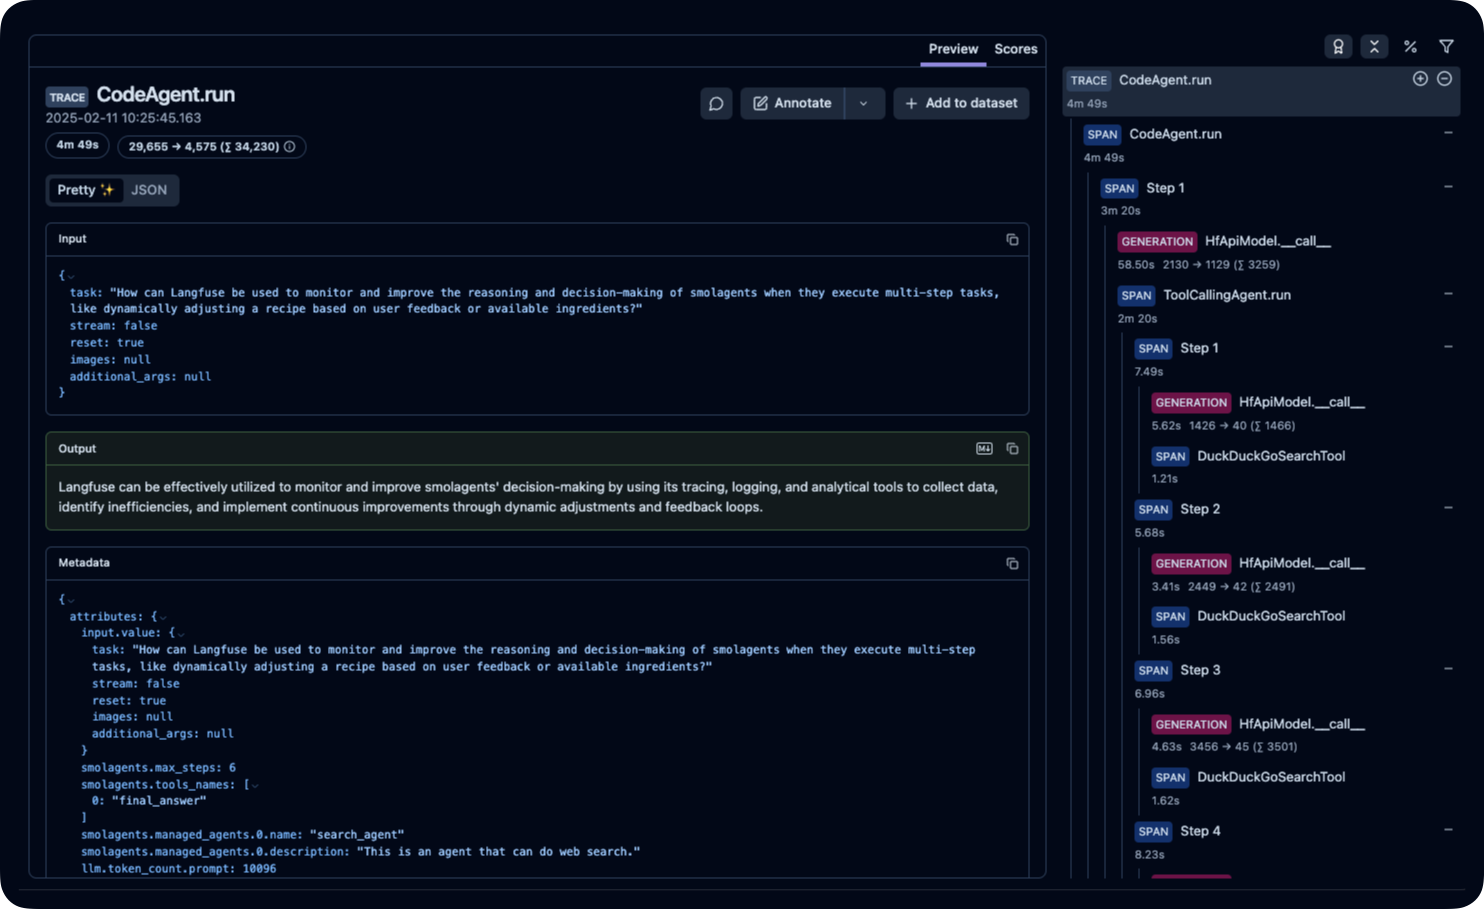
5단계: Langfuse에서 트레이스 조회
에이전트를 실행한 뒤, smolagents 애플리케이션이 생성한 트레이스를 Langfuse에서 조회할 수 있습니다. LLM 상호작용의 상세 단계가 보일 것이고, 이를 통해 AI 에이전트를 디버깅하고 최적화할 수 있어요.
더 알아보기 (Learn more)
- 에이전트 메모리 관리하기 - 에이전트 실행을 재생하고 메모리를 동적으로 바꾸는 방법
- 모델 관련 객체 API -
InferenceClientModel등 모델 클래스의 API 문서