
코드 모드
코드 모드 (Code Mode)
CodeMode는 개별 도구 호출을 하나의 샌드박스 파이썬 실행 환경으로 대체해요. 모델이 동작마다 도구 호출을 하나씩 내는 대신, 도구를 함수로 호출하는 파이썬 프로그램을 써요 — 루프, 조건문, 변수, asyncio.gather까지 — 전부 샌드박스된 Monty 런타임 안에서요.
출처: 문서
Pydantic AI Harness가 0.x 릴리스인 동안 API는 마이너 릴리스 사이에 바뀔 수 있어요. 그럴 때는 deprecation 경고와 릴리스 노트의 마이그레이션 안내가 정확히 어떻게 업그레이드할지 알려줘요. 버전 정책을 참고하세요.
본문
문제 (The problem)
표준 도구 호출은 같은 도구 호출 배치마다 종종 모델 턴을 하나 더 필요로 해요. 10개 항목을 가져오고 그 결과를 처리해야 하는 에이전트는 많은 모델 턴이 필요하고, 지연·비용·컨텍스트 사용이 늘어나요. 중간 결과도 대화 히스토리를 키워요.
해결책 (The solution)
CodeMode는 적격 도구를 하나의 run_code 도구로 감싸요. 모델이 asyncio.gather로 호출을 퍼내고, 결과를 필터·변환하고, 중요한 것만 반환하는 샌드박스 오케스트레이션 코드를 써요. 그 코드의 호출은 Pydantic AI를 통해 호스트 도구로 디스패치돼요.
| 표준 도구 호출 | 코드 모드 |
|---|---|
| 모델 턴에 걸친 의존 도구 배치 | 하나의 run_code 안의 많은 의존 호출 |
| 모델이 배치를 낼 때만 병렬 | 파이썬으로 표현된 병렬성 |
| 로컬 계산 없음 | 코드에서 필터·변환·집계 |
| 큰 대화 히스토리 | 컴팩트 — 메시지 더 적음 |
| — | durable execution 통합이 결정적 재생용 중첩 호출 기록 |
설치 (Installation)
코드 모드는 Monty 샌드박스가 필요하고 codemode extra로 제공돼요(code-mode extra는 동등한 별칭).
pip install "pydantic-ai-harness[codemode]"
uv add "pydantic-ai-harness[codemode]"
사용법 (Usage)
capabilities에 CodeMode()를 넣어 Agent를 만들고 평소대로 도구를 등록하세요. 모든 적격 일반 도구가 run_code 안에서 호출 가능해져요.
from pydantic_ai import Agent
from pydantic_ai_harness import CodeMode

agent = Agent('anthropic:claude-sonnet-4-6', capabilities=[CodeMode()])


@agent.tool_plain
def get_weather(city: str) -> dict:
    """Get current weather for a city."""
    return {'city': city, 'temp_f': 72, 'condition': 'sunny'}


result = agent.run_sync("What's the weather in Paris and Tokyo, in Celsius?")
print(result.output)
단일 run_code 호출 안에서 모델은 이런 코드를 써요(예시 — 모델이 내는 정확한 코드는 달라져요):
import asyncio

paris, tokyo = await asyncio.gather(
    get_weather(city='Paris'),
    get_weather(city='Tokyo'),
)
paris_c = round((paris['temp_f'] - 32) * 5 / 9, 1)
tokyo_c = round((tokyo['temp_f'] - 32) * 5 / 9, 1)
{'paris': paris_c, 'tokyo': tokyo_c}
두 날씨 조회가 병렬로 돌고 변환은 Monty 안에서, 전부 하나의 run_code 호출 안에서 일어나요.
선택적 도구 샌드박싱 (Selective tool sandboxing)
기본적으로 CodeMode(tools='all')은 모든 적격 일반 도구를 샌드박스해요. 프레임워크 제어 도구, 미발견 지연 도구, 네이티브 폴백, 다른 코드 실행 도구는 네이티브로 남아요. 셸 표면(Shell의 run_command와 start_command, ModalSandbox의 run_command)은 코드 실행 도구로 세서 run_code 옆에 앉아 그 안이 아니에요. 그래서 모델이 생성된 파이썬 문자열 안에 셸 명령을 인용할 필요가 없죠. CapabilityCreation의 author_capability도 같은 이유로 네이티브로 남아요. 그 인수가 완전한 파이썬 모듈이니까요. 그들의 비명령 도구(read_file, check_command 등)는 다른 도구처럼 run_code 안으로 접혀요. tools 필드는 Pydantic AI ToolSelector라 어떤 적격 도구가 샌드박스를 거칠지 제어할 수 있어요. 셀렉터와 일치하는 도구는 run_code 안의 callable이 되고, 일치하지 않는 도구는 모델에 일반 도구 호출로 남아 보여요.
from pydantic_ai_harness import CodeMode

# By name -- only these tools are available inside run_code
CodeMode(tools=['search', 'fetch'])

# By predicate -- (ctx, tool_def) -> bool | Awaitable[bool]
CodeMode(tools=lambda ctx, td: td.name != 'dangerous_tool')

# By metadata -- combine with SetToolMetadata or a toolset's .with_metadata()
CodeMode(tools={'code_mode': True})
메타데이터 기반 선택
결정이 하나의 CodeMode 인스턴스가 아니라 도구나 toolset과 함께 가야 할 때 메타데이터를 쓰세요. 공유 toolset에 맞아요. toolset 작성자가 생성된 코드에서 호출하기 안전하고 유용한 도구를 태그하고, 각 에이전트가 CodeMode(tools={...})로 그 태그에 옵트인해요.
CodeMode(tools={'code_mode': True})는 표준 Pydantic AI ToolSelector 메타데이터 형태를 써요. ToolDefinition.metadata가 셀렉터의 모든 키-값 쌍을 포함하면 도구가 샌드박스돼요. 도구의 추가 메타데이터는 괜찮고, 중첩 사전은 깊은 포함으로 일치해요.
흔한 패턴은 .with_metadata(...)로 toolset 전체를 태그하는 거예요.
from pydantic_ai import Agent
from pydantic_ai.toolsets import FunctionToolset
from pydantic_ai_harness import CodeMode


def search(query: str) -> str:
    """Search the web."""
    return f'results for {query}'


def fetch(url: str) -> str:
    """Fetch a URL."""
    return f'contents of {url}'


search_tools = FunctionToolset(tools=[search, fetch]).with_metadata(code_mode=True)

agent = Agent(
    'anthropic:claude-sonnet-4-6',
    toolsets=[search_tools],
    capabilities=[CodeMode(tools={'code_mode': True})],
)
여기서 search와 fetch는 모델 대면 도구 목록에서 제거되고 run_code 안의 callable 함수가 돼요. metadata['code_mode'] == True가 없는 도구는 일반 도구 호출로 남아 보여요.
도구 검색 상호작용 (Tool Search interaction)
도구나 toolset 전체를 defer_loading=True로 표시하면(Tool Search), CodeMode는 미발견 동안 그것을 run_code 밖에 둬요. 곧장 통과하니까 Tool Search가 평소대로 구동해요(네이티브 도구 검색이 있는 프로바이더에서는 defer_loading을 싣고 유선에 보내고, 아니면 발견될 때까지 버리고 run_code 옆에 search_tools 도구를 둬요). CodeMode는 RunContext.is_tool_available로 그 공개 상태를 따르고, 모델이 도구를 발견하거나 — 그것을 소유한 지연 capability를 로드하거나 — 하면 그때부터 CodeMode가 다른 도구처럼 run_code 안으로 접어 생성된 코드에서 호출 가능하게 해요. (도구는 defer_loading=True를 유지하는데, 그것은 작성자가 요청한 것을 기록해요. 바뀌는 것은 실행을 위한 가용성이에요.)
그 접힘이 run_code의 설명을 키워, 발견 순간에 프롬프트 캐시 접두사를 한 번 무효화해요(발견 없는 턴은 캐시 따뜻함 유지). 그 깨짐을 피하는 두 가지 방법:
-
dynamic_catalog=True를 넘겨run_code설명을 발견들 사이에서 정적으로 유지. 샌드박스 도구 서명 카탈로그가 에이전트 지시문으로 옮겨가고(동적InstructionPart로), 새로 발견된 도구는 설명을 다시 짓는 대신ctx.enqueue로 발표돼요.from pydantic_ai_harness import CodeMode CodeMode(dynamic_catalog=True)이것은 Tool Search와 짝지었을 때 보람이 있어요. 도구 정의 블록이 바이트 안정을 유지해 접두사 캐시가 발견을 살아남고, 대가로 더 큰(그러나 캐시 친화적인) 시스템 프롬프트가 와요. 고정 toolset에 Tool Search가 없으면 기본값이 시스템 프롬프트를 더 짧게 유지해 더 나은 선택이에요.
-
대신 Tool Search 말뭉치를 완전히 네이티브로 —
run_code안으로 절대 접히지 않고 안에서 호출되지도 않게 — 유지하려면tools셀렉터로 배제하세요. 말뭉치 구성원은 관리 네이티브 도구로 설정된with_native를 지녀요.from pydantic_ai_harness import CodeMode CodeMode(tools=lambda ctx, td: td.with_native is None)
반환 값 (Return values)
스니펫의 마지막 표현식이 자동으로 반환 값으로 캡처돼요. 모델이 print()할 필요가 없어요. 할당은 REPL에 값을 저장하지만 반환하지 않아요. None으로 평가되는 최종 표현식도 결과 없음으로 취급돼요. None이 아닌 최종 표현식이나 print 출력이 없으면 run_code는 {}를 반환해요. 할당된 이름을 마지막 줄에 두세요.
result = await get_weather(city='Paris')
result
print()는 보조 로깅용으로 남겨두세요. 인쇄된 텍스트는 마지막 표현식 결과와 함께 별도로 드러나요.
| 시나리오 | 반환 |
|---|---|
None이 아닌 최종 표현식 + print 출력 없음 |
마지막 표현식 값 |
최종 할당 또는 None 결과 + print 출력 없음 |
{} |
최종 표현식 없음 또는 None 결과 + print 출력 |
{'output': '<인쇄된 텍스트>'} |
평범한 None이 아닌 최종 표현식 + print 출력 |
{'output': '<인쇄된 텍스트>', 'result': <마지막 표현식>} |
| 멀티모달 최종 표현식 + print 출력 없음 | 모델 처리를 위해 네이티브 반환 |
| 멀티모달 최종 표현식 + print 출력 | 인쇄된 텍스트 뒤에 네이티브 멀티모달 콘텐츠가 오는 목록 |
인쇄된 출력은 10 MiB로 제한돼요. 한도를 넘으면 run_code가 모델 재시도를 반환해요.
샌드박스 실행은 resource_limits로 경계지는데, 기본값은 실행 시간 30초와 256 MiB 힙이에요. 이것이 보장하는 것은 스니펫당 상한이에요. 단일 run_code 스니펫이 max_duration_secs의 샌드박스 시간보다 길게 실행되지 않아요. 그것이 폭주 루프를 멈추는 거죠. 중첩 도구를 await하는 데 쓴 시간은 그 타이머에서 제외돼요.
그것은 실행 전체 CPU 예산이 아니고, 그렇게 의존할 수도 없어요. Monty는 샌드박스 세션마다 한도를 적용하므로 연속 run_code 호출이 하나의 공유 허용치를 소진하고 각 새 세션은 가득 찬 것으로 시작해요. 세션은 restart: true와 REPL을 재설정하는 실패(작업자 충돌, 타입 오류, 호스트 측 실패, 코드 실행 전의 문법 오류)로 교체돼요. 각각은 모델이 재시작을 요청하지 않고 허용치를 갱신해요. 스니펫 안의 평범한 예외는 그중 하나가 아니에요.
세션의 지속 시간 허용치가 소진되면 이후 모든 run_code 호출이 도착 시 실패해요. 거의 비용이 들지 않는 스니펫도요. 같은 세션을 재사용하니까요. 코드를 다시 써도 도움이 안 돼요. restart: true가 회복시키는데, 세션이 들고 있던 REPL 상태를 희생해서요. 그래서 어떤 변수·임포트·정의든 다시 만들어야 해요. run_code가 반환하는 재시도에서 그렇게 말하고, 그 재시도는 스니펫이 이미 만든 중첩 호출도 보고하므로 재시작이 그 유일한 기록을 버리지 않아요. max_duration_secs를 고를 때 알 만한 동작이에요. 낮게 두면 긴 에이전트 실행이 평범한 작업에 그것을 쓰고 계속하려 재시작을 내요.
Monty는 또한 max_suspensions(세션당 기본 1,000)로 누적 서스펜션을 제한해요. 외부 호출, OS 콜백, 이름 조회, future 해결이 각각 이 예산을 소비하므로 도구 호출 수가 아니에요. 연속 스니펫이 공유해요. 소진 후에는 추가 호스트 상호작용이 실패하지만, 기존 상태를 쓰는 순수 파이썬은 여전히 작동할 수 있어요. run_code는 시작된 호출 요약과 명시적 재시작 안내를 포함해요. 계속하기 전에 부분 결과를 검사하세요. restart: true가 REPL 상태를 버리고 완료된 호출을 재생하면 그 부작용을 반복하니까요. 소진에 대한 자동 재시작이나 재생은 없어요.
중첩 도구 호출은 별도로 max_tool_calls로 경계지는데 run_code 호출당 기본 100이에요. 예산은 각 호출이 예약되기 전에 준비되므로 스니펫이 허용보다 많은 일을 디스패치할 수 없어요. 예산을 넘는 호출은 샌드박스 안의 호출 지점에서 실패해요. 오류를 잡는 스니펫은 이미 완료된 호출의 결과를 유지하고 반환할 수 있어요. 전파시키는 스니펫은 몇 개의 중첩 호출이 시작됐는지 보고하는 모델 재시도를 받고, 호출별 상세가 따라와요. 무엇으로 호출됐고, 반환·오류·거부 중 무엇이었는지요. 오류를 일으킨 호출은 걸러지지 않고 포함돼요. 도구가 실패하기 전에 변경을 적용할 수 있으니까요. 그 상세는 경계져요. 인수와 결과가 미리보기되고 목록이 크기 한도에서 멈춰 몇 개 항목을 뺐는지 말해요. 그래서 큰 페이로드가 재시도를 부풀리지 못해요. 보고된 총계는 목록이 잘렸든 아니든 정확히 유지돼, 모델에게 일부 호출이 보이는 것에서 빠졌다는 걸 말해줘요. 그 목록은 모델을 위한 컨텍스트이지 가드가 아니에요. 그 도구를 다시 부르는 것을 막는 건 아무것도 없으니, 반복을 막는 것보다 다음 시도를 알리는 것으로 다루세요.
resource_limits={'max_duration_secs': 10, 'max_memory': 134_217_728, 'max_suspensions': 10_000}와 max_tool_calls=25로 덮어써요. resource_limits='unlimited'는 다른 실행 경계가 같은 한도를 공급할 때만 넘겨요. 시간과 메모리 한도를 제거하지만 Monty 기본 서스펜션 예산은 남겨요. 서스펜션은 무제한일 수 없으니까요.
CodeMode가 Temporal 워크플로우 안에서 실행되면 명시적 덮어쓰기 포함 max_duration_secs를 비활성화해요. run_code는 워크플로우 코드에서 재생되므로 거기서 경과 시간을 재면 재생이 기록된 워크플로우와 다른 경로를 고를 수 있어요. 메모리와 서스펜션 한도는 여전히 적용돼요. 시간 중심 작업은 Temporal 활동 뒤에 두세요.
REPL 상태 (REPL state)
같은 에이전트 실행 안의 run_code 호출 사이에 상태가 지속돼요. 변수, 임포트, 함수 정의가 이어져요. 도구 호출에서 restart: true를 넘기면 상태가 재설정돼요. 작업자 충돌이나 호스트 측 실행 실패가 세션을 무효화하면 run_code가 재설정을 보고하는 모델 재시도를 반환하고, 다음 스니펫이 필요한 상태를 다시 만들어야 해요.
즉시 실행 (Eager execution)
보통 CodeMode는 코드를 실행하기 전에 모델이 run_code 호출 쓰기를 끝내길 기다려요. eager=True를 설정하면 더 일찍 시작해요.
from pydantic_ai import Agent
from pydantic_ai_harness import CodeMode

agent = Agent(
    'openai:gpt-5.6-sol',
    capabilities=[CodeMode(eager=True)],
)
예를 들어 모델이 이 코드를 한 줄씩 만든다고 해 봐요.
first = await fetch_item(item_id=1)
second = await fetch_item(item_id=2)
[first, second]
즉시 모드에서는 첫 줄이 완성되는 즉시 fetch_item을 처음 호출할 수 있어요. CodeMode는 동시에 나머지 줄을 계속 받아요. 즉시 모드가 없으면 모델이 스니펫 전체를 만들 때까지 어느 호출도 시작되지 않아요.
그 코드는 여전히 하나의 run_code 호출로 세요. 하나의 REPL 세션, 하나의 도구 호출 한도, 하나의 결합 결과를 써요. 코드가 부르는 fetch_item과 다른 도구의 훅은 여전히 실행돼요. run_code 자체 주변의 훅은 모델이 호출 쓰기를 끝낸 후에만 실행돼, 즉시 모드가 이미 실행한 줄을 승인하거나 바꿀 수 없어요.
구성된 Monty 리소스 한도는 여전히 적용돼요. 즉시 조각과 나머지 코드가 같은 세션 지속 시간과 메모리 허용치를 공유해요.
이런 한계를 염두에 두세요:
- 즉시 모드는 이미 실행된 코드의 부작용을 되돌릴 수 없어요.
- 모델이 나중에
restart: true를 요청하면 일부 작업이 다시 실행될 수 있어요. - 모델이 스트리밍 중 이전 줄을 바꾸면
CodeMode가 REPL을 재설정하고 코드를 다시 보내라고 요청해요. - 즉시 모드는 프로바이더가 스트리밍된
run_code부분과 도구 이름을 보존하길 신뢰해요. 프로바이더가 그 부분을 제거하거나 이름을 바꾸면 이미 실행된 작업을 되돌릴 수 없어요. - 즉시 실행은
run_code가 모델 응답의 첫 도구 호출일 때만 써요. 이후 도구 호출은 모델이 요청한 순서로 실행되게 정상 디스패치를 기다려요. - 즉시 모드는 Temporal이나 DBOS 같은 durable execution을 쓸 때 비활성화돼요.
- 즉시 모드는 나머지 샌드박스 실행기처럼 asyncio가 필요해요.
- 문이 끝나기 전에 중단되면(예: 호출이 검증 실패) 세션이 재시작되고 다음 스니펫이 상태를 다시 만들어야 해요.
- 즉시 문에서 부르는 중첩 도구는 asyncio 취소와 협력해야 해요. 실행이 끝나거나 스트리밍된 호출이 무효화되면
CodeMode가 진행 중 작업을 취소하고 제한된 시간(현재 5초)을 기다려 풀리게 해요. 시간 안에 풀리지 않는 작업은 버려지고 더 이상 도구 호출을 시작할 수 없어요. - 일찍 실행된 문에서 부른 도구는
run_code스팬이 열리기 전에 추적돼요.
추측 실행 (Speculative execution)
speculate는 모델이 run_code 호출을 쓰는 동안 부작용 없는 도구 호출을 시작해요. code 인수가 스트리밍됨에 따라 CodeMode가 이름 붙은 도구에 대한 호출 중 인수가 전부 키워드 리터럴인 것을 찾아요. 각각은 그것을 완성하는 줄이 스트리밍되면 시작돼요. 그 주변의 문(if 팔, with 본문)이 아직 안 끝났어도요. 완성된 스니펫이 실행되어 같은 호출에 닿으면 차갑게 도구를 시작하는 대신 이미 진행 중인 결과를 가져가요. 이것은 모델 생성과 도구 지연을 겹치게 해요(추측적 프로그래밍 도구 호출, https://alexzhang13.github.io/blog/2026/spec-ptc/).
일찍 안전하게 실행할 도구 고르기
추측된 호출이 스니펫이 결코 안 가는 분기에 실행될 수 있어요. 읽기 전용은 필요하지만 충분하지 않아요. 변하는 상태를 일찍 읽으면 다른 답을 낼 수 있으니까요. 결과와 외부 상호작용이 출시 시점에 받아들일 만한 도구를 고르세요. 결코 안 써도요. 쓰이지 않은 요청도 API 요금이 들고, 속도 한도를 소비하고, 인수를 외부 서비스에 보낼 수 있어요. 취소가 이미 보낸 요청을 되돌리지 않아요.
이 예는 고정 데이터에 대해 독립적 조회 두 개를 등록해요. 실행하려면 OPENAI_API_KEY 같은 프로바이더 자격 증명이 필요해요. 실제 네트워크 조회가 이 로컬 함수들보다 지연을 겹칠 기회가 더 많아요.
from pydantic_ai import Agent
from pydantic_ai_harness import CodeMode


def lookup_author(*, title: str) -> str:
    """Find a book's author in a fixed catalog."""
    return {'Frankenstein': 'Mary Shelley'}.get(title, 'Unknown')


def lookup_year(*, title: str) -> int | None:
    """Find a book's publication year in a fixed catalog."""
    return {'Frankenstein': 1818}.get(title)


code_mode = CodeMode(speculate=['lookup_author', 'lookup_year'])
agent = Agent(
    'openai:gpt-5.6-sol',
    capabilities=[code_mode],
    tools=[lookup_author, lookup_year],
)
result = agent.run_sync(
    'Use run_code to look up the author and publication year of Frankenstein. '
    'Call both tools independently with the literal keyword argument title="Frankenstein".'
)
print(result.output)
print(code_mode.speculation_stats)
모델이 스니펫을 고르므로 프롬프트가 추측 발사를 보장하지 않아요. 스니펫이 결코 주장하지 않는 호출은 스니펫이 성공적으로 끝나면 취소돼요. 실행 전에 실패하는 스니펫(문법·타입 오류)은 발사를 유지해서 재시도가 주장할 수 있게 하고, 재시도가 안 주장하는 것은 다음 모델 스텝이 시작할 때 취소돼요.
도구 이름을 나열하는 대신 speculate='declared'를 넘겨 도구가 스스로에 대해 말하는 것을 신뢰하세요. Tool(..., metadata={'read_only': True})로 표시된 도구와, 서버가 readOnlyHint 주석을 게시하는 MCP 도구요. 멱등성은 충분하지 않아요. 멱등 삭제도 여전히 삭제하니까 idempotent 선언은 세지 않아요. 선언은 작성자의 주장이지 증명이 아니므로, 'declared'는 명시적 목록이 당신에게 두는 것과 같은 신뢰를 작성자에게 확장해요.
from pydantic_ai import Agent, Tool
from pydantic_ai_harness import CodeMode


def search(query: str) -> str:
    """Look something up."""
    return f'results for {query}'


agent = Agent(
    'openai:gpt-5.6-sol',
    capabilities=[CodeMode(speculate='declared')],
    tools=[Tool(search, metadata={'read_only': True})],
)
실행 순서 이해하기
스니펫 실행 시 Code Mode는 아직 진행 중이 아닌 적격 리터럴 호출도 스캔해요. 발사 한도와 순서 장벽이 적용되고요. 그 호출들은 각 await를 차례로 기다리는 대신 겹칠 수 있어요. if/else 양 팔의 적격 호출이 시작될 수 있고, 취해진 팔이 결과를 주장하고 다른 발사는 버려져요.
미리보기는 적격이 아닌 알려진 도구 호출에서 멈춰요. sequential 도구 포함이요. 예를 들어 update_record가 적격이 아니고 search가 적격이면:
await update_record(key='status', value='ready')
await search(query='status')  # Runs after the update, not speculatively ahead of it.
이전 블로킹 읽기를 나중 호출과 겹치려면 그 읽기도 적격이어야 해요. 또 다른 모델 도구 호출 뒤에 오는 스트리밍된 run_code 부분은 정상 디스패치를 기다려요. 적격성은 임의의 파이썬 부작용 분석이 아니라 신뢰 결정이에요.
이런 한계를 염두에 두세요:
- 리터럴 키워드 인수가 있는 호출만 일찍 시작할 수 있어요. 인수가 이전 문에서 오는 호출은 그 문을 기다려요.
- 호출은 스트리밍된 텍스트에서 발견되므로 문자열 리터럴이나 주석 안에 철자가 적힌 호출도 시작될 수 있어요. 스니펫이 끝나면 버려져요.
sequential도구는 절대 추측하지 않고, 실행의 병렬 실행 모드가sequential이면 아무것도 추측하지 않아요.- 추측된 도구의 훅은 스니펫이 주장할 때가 아니라 시작할 때 실행돼요.
run_code자체의 훅·승인·가드레일은 모델이 호출 쓰기를 끝낸 후에만 실행돼, 이미 일찍 시작된 호출을 멈출 수 없어요. 즉시 모드와 같은 계약이에요. run_code호출당 최대max_tool_calls(그리고 결코 32를 넘지 않게) 호출이 일찍 시작돼요. 이후 것은 차갑게 실행돼요. 이 추측 허용치는 스니펫 디스패치 예산과 별개예요. 주장되지 않은 발사는max_tool_calls에 대한 예약이 아니라 추가 작업이에요.- 추측된 도구는 asyncio 취소와 협력해야 해요. 정리가 취소를 요청하고 스트리밍된 호출당 최대 5초를 기다린 뒤 기다리기를 멈춰요. 취소를 억제하는 도구는 실행보다 오래 살 수 있어요. 이 타임아웃이 그 작업을 강제로 멈추지 않아요.
speculate를 켜면 실행이 스트리밍 모드가 되고, 옵션은 Temporal이나 DBOS 같은 durable execution 아래에서 비활성화돼요.
speculate는 eager=True와 조합돼요. 즉시 실행은 모델이 쓴 문을 실행하고, 추측은 아직 닿지 않은 호출(분기 팔, 느린 문 뒤의 호출)을 시작해요. 즉시 모드가 실행하는 문도 그 발사를 주장해요.
추측이 도움이 되는지 확인
CodeMode.speculation_stats는 추측이 비활성화되면 None이에요. 켜면 그 capability 인스턴스를 쓰는 실행들에 걸쳐 카운터가 누적돼요. 실행별 비교를 위해 전후 스냅샷을 떠요. 성공적인 run_code 반환은 tool_calls와 tool_returns 옆 히스토리 전용 메타데이터에 speculation 항목도 실을 수 있어요. 모델에 보이는 콘텐츠는 그대로예요.
| 메트릭 | 범위 | 의미 |
|---|---|---|
launched |
capability 인스턴스 | 스트리밍이나 실행 중 추측적으로 시작된 호출 |
adopted |
capability 인스턴스 | 도구 오류 포함, 실제 디스패치가 소비한 추측 결과 |
evicted |
capability 인스턴스 | 주장되지 않아 버려지거나 취소 요청된 발사 |
hits |
run_code 반환 |
추측 결과를 소비한 디스패치 |
misses |
run_code 반환 |
일치 발사를 못 찾고 정상 실행한 적격 도구로의 디스패치 |
wasted |
run_code 반환 |
이 호출의 성공 완료 시 버려진 주장되지 않은 발사 |
hidden_ms |
run_code 반환 |
채택된 호출의 발사-결제 지속 시간 합 |
hidden_ms는 측정된 종단 간 절약 시간이 아니에요. 호출이 겹칠 수 있고, 주장할 때 여전히 실행 중이던 발사를 기다리며 쓴 시간도 포함해요. 추측 켜고 끄고의 총 실행 지연과 외부 요청 비용을 비교하세요. evicted도 wasted도 쓰이지 않은 호출이 완료했거나, 멈췄거나, 비용을 피했다는 것을 증명하지 않아요.
수명주기는 code_mode 네임스페이스에서 capability 이벤트로도 내보내져, UI와 다른 capability가 실행의 이벤트 스트림에서 실시간으로 따를 수 있어요. SpeculativeCodeUpdateEvent(지금까지의 디코딩된 스니펫, 닫힌 문 경계 포함), SpeculativeCallLaunchedEvent(발사 문의 줄 범위와 streaming/execution phase 포함), SpeculativeCallSettledEvent(스트림이 흐르는 동안만; 나중에 끝나는 호출은 주장·퇴출 이벤트에서 상태 보고), 그리고 스니펫이 실행되면 SpeculativeCallClaimedEvent, SpeculativeCallMissedEvent, SpeculativeCallEvictedEvent가 있어요.
호출이 추측되지 않는 이유
- 도구가 네이티브로 두지 않고
run_code안에 등록·노출됐나요? - 원본 도구 이름이 허용 목록에 있거나 신뢰된 읽기 전용 선언을 지니나요?
- 생성된 호출이 변수나 위치 인수가 아닌 리터럴 키워드 인수를 쓰나요?
- 이전의 비적격 도구 호출이 미리보기를 막거나, 이전 모델 도구 호출이 그것을 지연시키나요?
- 도구가
sequential로 표시됐거나 실행이 전역 순차 실행을 쓰나요? - durable execution이 활성이거나 호출당 추측 발사 한도에 닿았나요?
이 검사들이 통과하면 생성된 코드와 발사 이벤트를 검사하세요. 지나치게 큰 스트리밍 인수와 소진된 파서 작업 예산도 스트림 스캔을 멈춰요. 추측은 모든 적격 호출이 일찍 시작한다는 보장이 아니라 최적화예요.
Temporal 지속성 (Temporal durability)
두 통합 모두 설치하세요.
pip install "pydantic-ai-harness[codemode,temporal]"
uv add "pydantic-ai-harness[codemode,temporal]"
워크플로우 밖에서 이름 붙은 에이전트와 안정 ID toolset을 만들고, TemporalDurability를 CodeMode 옆에 붙이세요.
from pydantic_ai import Agent
from pydantic_ai.durable_exec.temporal import TemporalDurability
from pydantic_ai_harness import CodeMode

agent = Agent(
    'openai:gpt-5.6-sol',
    name='coding-agent',
    capabilities=[CodeMode(), TemporalDurability()],
)
Pydantic AI Temporal 가이드를 따라 워크플로우에서 평범한 에이전트를 부르고 PydanticAIPlugin과 __pydantic_ai_agents__ 또는 AgentPlugin으로 활동을 등록하세요.
PydanticAIPlugin은 pydantic_monty를 Temporal의 워크플로우 샌드박스를 통해 통과시켜요. 그것은 Monty를 거기서 실행 가능하게 하지만, run_code는 여전히 워크플로우 코드에서 실행되고 재생 중 재실행돼요. 모델 요청과, 기본적으로, 중첩 도구 호출은 Temporal 활동 경계를 건너고, asyncio.gather가 중첩 도구 활동을 동시에 예약할 수 있어요. REPL은 한 에이전트 실행을 위한 프로세스 로컬 상태이지 durable 저장소가 아니에요. 재생은 기록된 스니펫을 기록된 활동 결과에 대해 다시 실행해 그것을 재구성해요.
워크플로우 쪽 코드를 결정적으로 유지하세요. mount 읽기·쓰기, os_access 콜백, 호스트 시계 호출이 재생 중 다시 일어나요. 그 결과를 바꾸면 워크플로우가 예약하는 활동이 바뀌어 NondeterminismError를 일으킬 수 있어요. 외부 읽기·쓰기·시계 접근·다른 부작용을 감싼 도구에 두어 Temporal이 활동으로 기록하게 하세요. 같은 활동이 같은 히스토리 위치에 남아 있으면 재생이 바뀐 인수를 표시하지 않을 수 있으므로, 재생 검증은 이 경계를 대체하지 못해요. Temporal 활동 타임아웃은 중첩 도구에 적용되고 run_code 안의 순수 계산에는 아니에요. 시간 중심 계산은 활동 뒤로 옮기세요.
관측성 (Observability)
run_code 안의 중첩 도구 호출은 Logfire나 어떤 OpenTelemetry 백엔드로 계측하면 자체 스팬을 만들어요. 각 run_code 스팬이 샌드박스 안에서 모델이 낸 도구 호출로 퍼지므로 코드 모드가 실제로 뭘 했는지 이해하는 가장 쉬운 길이에요. 설정은 Pydantic AI Logfire 문서를 보세요.
서스펜션 한도 재시도는 별도 capability 스팬이 아니라 기존 run_code 오류 스팬과 중첩 도구 스팬을 써요. 재시도는 경계진 시작된 호출 컨텍스트와 회복 안내를 포함해요. Monty에는 타입 있는 소진 표시가 없어, 같은 문구의 도구 오류가 결정적 소진 이벤트가 아니라 조건부 안내를 받아요.
run_code 도구 반환은 또한 호출 id로 키 지정된 모든 중첩 호출이 있는 메타데이터를 실어 나라요.
from pydantic_ai import Agent
from pydantic_ai.messages import ToolReturnPart
from pydantic_ai_harness import CodeMode

agent = Agent('anthropic:claude-sonnet-4-6', capabilities=[CodeMode()])


@agent.tool_plain
def get_weather(city: str) -> dict:
    """Get current weather for a city."""
    return {'city': city, 'temp_f': 72}


result = agent.run_sync("What's the weather in Paris?")

for msg in result.all_messages():
    for part in msg.parts:
        if isinstance(part, ToolReturnPart) and part.tool_name == 'run_code':
            metadata = part.metadata or {}
            tool_calls = metadata['tool_calls']    # dict[str, ToolCallPart]
            tool_returns = metadata['tool_returns']  # dict[str, ToolReturnPart]
실제로 (In practice)
대표 실행은 CodeMode를 MCP 서버와 웹 검색에 연결하고, 세 피드에 걸쳐 가장 많이 논의된 Hacker News 기사를 찾고, 댓글 스레드와 제출자 프로필을 뽑고, 후속 보도를 웹 검색하라고 요청해요. CodeMode는 그것을 run_code 호출 두 개로 접어요. 첫 번째가 asyncio.gather로 세 피드를 병렬로 가져오고 id로 dedupe하고 점수로 필터하고 댓글 수로 순위를 매겨요 — 평범한 파이썬으로. 두 번째가 후속 호출 세 개(hn_get_thread, hn_get_user, duckduckgo_search)를 함께 배치해요.
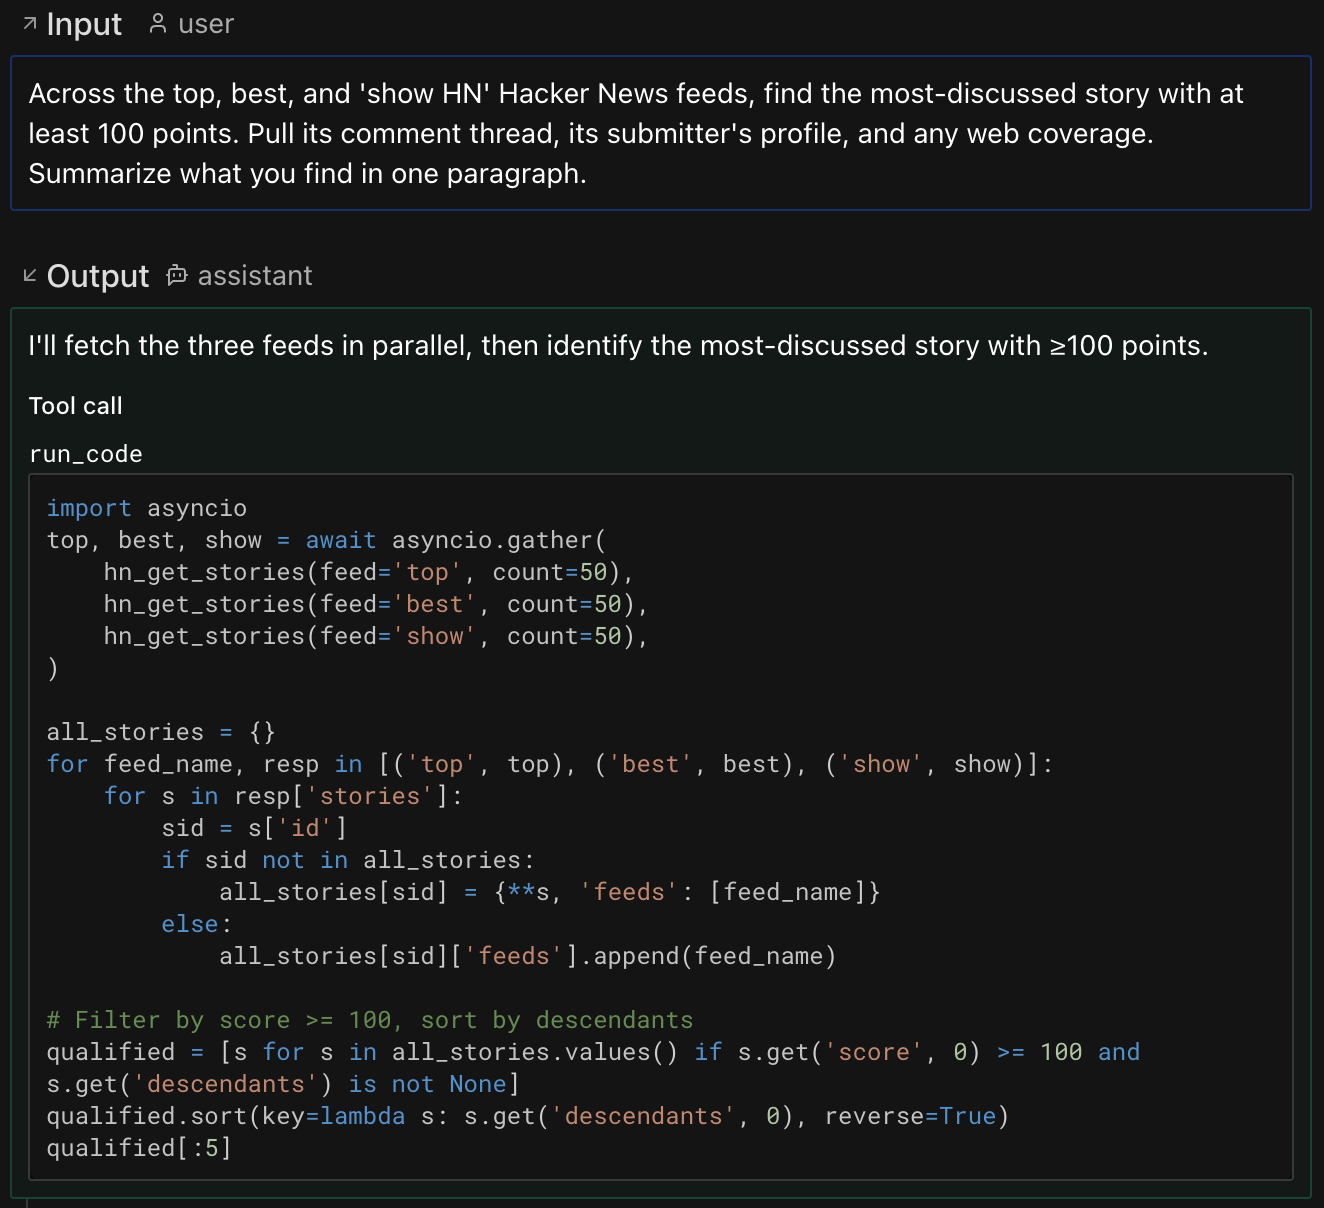
전체 Logfire 트레이스 보기 -> 각 run_code 스팬이 샌드박스 안에서 모델이 낸 도구 호출로 퍼져요.
파일시스템과 OS 접근 (Filesystem and OS access)
샌드박스 코드는 호스트의 파일, 환경, 시계에 아무 접근 없이 시작해요. 두 매개변수가 제어된 파일시스템·환경·시계 동작을 더해요.
두 매개변수는 capability가 만들어질 때 고정되므로, 구성된 접근을 요청에 범위 한정하려면 요청마다 CodeMode를 만들어요.
mount — 호스트 디렉터리 공유
에이전트가 실제 파일로 작업할 때 mount를 손대세요. 폴더에 떨어뜨린 데이터셋을 분석하고 보고서를 다시 쓰거나, 체크아웃을 편집하거나, 문서 배치를 처리하는 것. 샌드박스 pathlib 코드가 마운트된 경로 아래에서 읽고 써요. (환경 변수나 시계는 대신 os_access를 쓰세요.)
from pydantic_ai import Agent
from pydantic_monty import MountDir
from pydantic_ai_harness import CodeMode

# The agent can read /work/data.csv and write /work/summary.md back to the host:
agent = Agent(
    'anthropic:claude-sonnet-4-6',
    capabilities=[CodeMode(mount=MountDir(virtual_path='/work', host_path='/tmp/agent-workspace', mode='read-write'))],
)
MountDir는 기본적으로 copy-on-write mode='overlay'예요. 샌드박스가 호스트 파일을 읽고 현재 run_code 호출 중 일어난 쓰기를 보지만, Monty는 다음 호출 전에 그 쓰기를 버리고 호스트에 닿지 않아요. 이후 호출이 쓰기를 읽어야 하면 mode='read-write'를 넘기거나, 쓰기를 금지하려면 mode='read-only'. mount는 여러 마운트 포인트를 위해 MountDir 목록도 받아요.
os_access — 샌드박스의 OS 호출을 직접 답하기
에이전트가 환경 변수, 현재 날짜·시간, 또는 당신이 제어하는 파일시스템 동작이 필요할 때 os_access를 손대세요. 준비된 OS 구현(AbstractOS)이나, 각 호출을 결정하는 콜백을 넘겨요. 필요한 비밀만 주입하거나, 재현 가능한 실행을 위해 "now"를 고정하거나, 파일 접근을 자신의 저장소로 라우팅할 수 있어요.
from pydantic_ai import Agent
from pydantic_monty import OSAccess
from pydantic_ai_harness import CodeMode

# Give the agent a fixed set of environment values:
agent = Agent(
    'anthropic:claude-sonnet-4-6',
    capabilities=[CodeMode(os_access=OSAccess(environ={'API_BASE': 'https://api.example.com'}))],
)
콜백은 각 OS 호출을 받고 그 운명을 결정해요.
from pydantic_ai import Agent
from pydantic_monty import NOT_HANDLED
from pydantic_ai_harness import CodeMode

allowed_env = {'API_KEY': 'sk-...'}


def my_os(fn, args, kwargs):
    if fn == 'os.getenv':
        # Answer the call: allow-listed keys resolve, every other key reads back
        # as None -- absent, exactly like a real unset variable.
        return allowed_env.get(args[0])
    # Refuse everything else: NOT_HANDLED makes the call fail in the sandbox.
    return NOT_HANDLED


agent = Agent('anthropic:claude-sonnet-4-6', capabilities=[CodeMode(os_access=my_os)])
콜백의 반환 값이 호출의 운명을 결정하고, 두 결과는 혼동하기 쉬워요.
- 어떤 값이든 반환 —
None,'',0포함 — 그것이 샌드박스가 보는 결과가 돼요.os.getenv가None을 반환하면 평범한 설정 안 된 변수처럼 보여 에이전트 코드가 계속 실행돼요. 이것이 숨기는 방법이에요. 빈 값으로 답하세요. NOT_HANDLED반환 — 호출이 지원되지 않는 것으로 취급돼요. 샌드박스 안에서 오류를 일으키고 모델이 재시도를 받아요. 이것은 capability를 거부 해요. "값 없음"이라 말하는 게 아니라 차단에 쓰세요. 에이전트가 합리적으로 기대하는 키에NOT_HANDLED를 반환하면 재시도를 태울 거예요.
샌드박스 제한 (Sandbox restrictions)
코드는 Monty 안에서 실행돼요. 샌드박스된 파이썬 부분집합이에요. 주요 제한:
- 타사 임포트 없음. 허용된 stdlib 모듈:
sys,typing,asyncio,math,json,re,unicodedata,datetime,os,pathlib(각각 사용 전에 임포트해야 해요). asyncio.gather(...)는 위치 awaitable을 받지만 키워드 인수는 없어요. 다른 태스크 생성·대기 API는 쓸 수 없어요.- 벽 시계나 타이밍 기본 요소 없음이 기본:
asyncio.sleep,datetime.datetime.now(),datetime.date.today(),time모듈.datetime.datetime.now()/datetime.date.today()는os_access핸들러가 구현하면 쓸 수 있어요(내장OSAccess는 해요).asyncio.sleep과time은 결코 안 돼요. import *없음.- 파일시스템 I/O는
os_access핸들러나mount가 필요해요.os.getenv/os.environ은os_access핸들러가 필요해요. - 승인을 요구하거나 지연(
CallDeferred) 실행이 있는 도구는 다른 도구처럼 샌드박스돼요. 인라인 해결을 위한HandleDeferredToolCalls(또는 동등) capability가 에이전트에 없으면run_code에서 부르면 모델에 재시도로 드러나는 오류를 일으켜요. - 도구 결과는 생성된 stub이 선언한 JSON 형태로 샌드박스에 도달해요. stub이 도구의 JSON 스키마에서 파생되니까요.
Decimal,UUID,datetime은 문자열로, 매핑 키는 문자열화돼서{1: 'a'}의dict[int, str]이{'1': 'a'}로 도착해요.bytes와bytearray는 예외예요. Monty가 바이너리를 네이티브로 운반해서 stub이 그것에str을 선언해도 그대로 건너거든요.
에이전트 스펙 (YAML/JSON)
CodeMode는 Pydantic AI의 agent spec 기능으로 YAML이나 JSON에서 에이전트를 정의하는 것과 작동해요.
# agent.yaml
model: anthropic:claude-sonnet-4-6
capabilities:
  - CodeMode: {}
from pydantic_ai import Agent
from pydantic_ai_harness import CodeMode

agent = Agent.from_file('agent.yaml', custom_capability_types=[CodeMode])
result = agent.run_sync('...')
print(result.output)
custom_capability_types를 넘겨 스펙 로더가 CodeMode를 인스턴스화하는 법을 알게 하세요. YAML에서도 인수를 넘길 수 있어요.
capabilities:
  - CodeMode:
      tools: ['search', 'fetch']
      max_retries: 5
API 참조 (API reference)
CodeMode
Bases: AbstractCapability[AgentDepsT]
선택된 도구를 run_code 샌드박스 안의 callable로 노출하는 capability.
기본(tools='all')으로 에이전트가 가진 모든 적격 일반 도구가 단일 run_code 도구 뒤에 감싸져요. 모델이 직접 도구 호출을 내는 대신 함수로 부르는 파이썬을 써요. 프레임워크 제어 도구, 미발견 지연 도구, 네이티브 폴백, 다른 코드 실행 도구는 네이티브로 남아요.
tools에 도구 이름 목록이나 callable 술어를 넘겨 toolset을 나눠요. 일치하는 도구는 샌드박스 안의 callable이 되고 나머지는 모델에 일반 도구 호출로 남아 보여요.
from pydantic_ai import Agent
from pydantic_ai_harness import CodeMode

# Sandbox all tools
agent = Agent('openai:gpt-5', capabilities=[CodeMode()])

# Sandbox only specific tools
agent = Agent('openai:gpt-5', capabilities=[CodeMode(tools=['search', 'fetch'])])
기본적으로 샌드박스 코드는 호스트를 건드릴 수 없어요. 파일시스템·환경 변수·시계 없음. 두 매개변수가 열어줘요.
mount는 특정 호스트 디렉터리를 공유해요. 에이전트가 실제 파일을 읽거나 쓸 때 손대세요.os_access는 샌드박스의 OS 호출을 당신이 제공하는 핸들러로 라우팅해요. 에이전트가 환경 변수, 시계, 또는 당신이 제어하는 파일시스템 동작이 필요할 때 손대세요.
mount는 선택된 호스트 디렉터리를 노출해요. 내장 OSAccess는 격리된 파일시스템과 환경을 가지지만 기본적으로 호스트 시계를 써요. 커스텀 OS 핸들러는 다른 호스트 자원을 노출할 수 있어요.
from pydantic_monty import MountDir

agent = Agent('openai:gpt-5', capabilities=[CodeMode(mount=MountDir(virtual_path='/work', host_path='/tmp/agent-work'))])
속성
- tools — 어떤 감싼 도구가
run_code안에서 샌드박스될지.'all'(기본): 모든 적격 일반 도구 샌드박스.Sequence[str]: 이름이 나열된 도구만. Callable(ctx, tool_def) -> bool | Awaitable[bool]: callable이True반환 시 샌드박스, 나머지는 네이티브 도구 호출로 유지. Default:'all' - max_retries —
run_code도구의 최대 재시도 수(문법 오류 재시도 포함). Default:3 - max_tool_calls — 한
run_code호출이 디스패치하는 최대 중첩 도구 호출. 예산이 각 호출이 예약되기 전에 준비되므로 스니펫이 이보다 많은 호스트 태스크를 할당할 수 없어요. 예산을 넘는 호출은 샌드박스 호출 지점에서 거부돼요. Default:100 - os_access — 제공한 핸들러를 통해 샌드박스 코드에 환경 변수, 시계, 파일 I/O를 줘요. 설정 안 하면 쓸 수 없어요. Default:
None - mount — 샌드박스
pathlib코드에 노출할 호스트 디렉터리. 각 mount의mode가 쓰기가 호스트에 닿을지 제어해요. Default:None - resource_limits — Monty 세션마다 적용되는 샌드박스 실행 한도.
None은 30초 실행과 256 MiB 힙 백스톱. 보장은 스니펫당이에요. 단일run_code스니펫이max_duration_secs보다 길게 실행되지 않아요. 실행 전체 예산이 아니에요. 연속 호출이 하나의 세션 허용치를 공유하고 세션의 어떤 재설정(restart: true, 충돌, 타입 오류, 호스트 측 실패)도 새것으로 시작하니까요.'unlimited'는 시간·메모리 한도를 제거하지만 Monty의 유한 서스펜션 예산은 여전히 적용돼요.max_suspensions를 설정해 연속 스니펫에 걸친 누적 호스트 상호작용을 경계 짓게. Default:None - eager —
run_code호출이 끝나기 전에 완성된 스트리밍 문을 실행. 샌드박스 실행기처럼 asyncio가 필요하고 durable execution 아래에서는 비활성. 부작용은 되돌릴 수 없고run_code훅이 완성된 호출을 보기 전에 실행돼요. Default:False - speculate —
run_code인수가 스트리밍되는 동안 부작용 없는 샌드박스 호출을 발사. 인수가 전부 키워드 리터럴인 적격 함수 호출은 텍스트가 스트리밍되면 시작되고, 완성된 스니펫이 같은 호출을 디스패치하면 차갑게 시작하는 대신 진행 중 결과를 채택해요. 일찍 안전한 도구 이름을 넘기거나, 도구가 스스로 선언하는 것을 신뢰하려면'declared'(Tool(metadata={'read_only': True})또는 MCPreadOnlyHint주석).run_code호출당 최대max_tool_calls(결코 32 초과 안 함) 호출이 일찍 시작되고,max_tool_calls에서 예약하지 않아요. 주장되지 않은 발사는 스니펫이 만드는 디스패치 옆의 추가 경계 작업이에요.eager와 조합. durable execution과 순차 실행 모드 아래에서는 비활성. Default:None - dynamic_catalog — 샌드박스 toolset이 자라도
run_code도구 정의를 캐시 안정하게 유지. 기본적으로 모든 샌드박스 도구 서명이run_code설명에 렌더링되는데, prompt-cache 키 tool-definitions 블록에 살아요. 도구 세트가 실행 중 바뀌면(예:ToolSearch가 새 도구를 공개해run_code에 접힘) 설명이 바뀌고 그 지점부터 접두사 캐시가 깨져요.dynamic_catalog=True는 정적 기본 산문만run_code.description에 두고, "available functions" 카탈로그를 동적InstructionPart로 에이전트 지시문에 옮기고, 새 발견 도구를RunContext.enqueue를 통한 짧은SystemPromptPart로 발표해요. Default:False - speculation_stats —
speculate가 설정되면 이 인스턴스의 실행들에 걸친 발사/채택/퇴출 카운터 집계. Default:SpeculationStats - has_wrap_run_event_stream — 스트리밍 실행 계층이 켜졌을 때만 스트림 훅 보고. Type:
bool
메서드
- get_ordering —
def get_ordering() -> CapabilityOrdering. CodeMode가 ToolSearch를 둘러싸search_tools가 네이티브로 남게 해요. - for_run —
@async def for_run(ctx) -> CodeMode[AgentDepsT]. 동시 실행이_announced_tools나 추측 상태를 공유하지 않도록 새 인스턴스 반환. - get_wrapper_toolset —
def get_wrapper_toolset(toolset) -> AbstractToolset[AgentDepsT] | None. 에이전트의 조립 toolset을 감싸, 필요하면 네이티브 + 샌드박스 부분집합으로 나눠요. - wrap_run_event_stream —
@async def wrap_run_event_stream(ctx, *, stream) -> AsyncIterable[AgentStreamEvent]. 스트리밍된run_code인수 델타를 eager 펌프와 추측 발사기에 공급. 감싼 이벤트는 수정 없이 통과하고, watcher는 부작용으로 행동해 닫힌 문을 라이브 REPL에 enqueue하고 적격 호출을 발사해요. durable execution 아래에서는 비활성. - after_tool_execute —
@async def after_tool_execute(ctx, *, call, tool_def, args, result) -> Any. 로컬search_tools반환에서 새로 발견된 도구 발표.dynamic_catalog=True에서만 활성. - after_model_request —
@async def after_model_request(ctx, *, request_context, response) -> ModelResponse. 네이티브(서버 측) 도구 검색 반환에서 새로 발견된 도구 발표.dynamic_catalog=True에서만 활성.
더 알아보기 (Learn more)
- 코드로 도구 사용 (Anthropic)
- 프로덕션의 코드 모드 (Cloudflare)
- Pydantic AI capabilities