
Broker
Broker
Apache Pinot의 브로커 구성 요소가 쿼리 처리와 데이터 검색을 어떻게 최적화하는지 알아보는 페이지예요. 쿼리를 서버에 분산하고 결과를 병합하는 브로커의 역할을 파악할 수 있어요.
출처: Broker
본문
Pinot 브로커는 클라이언트 프로세스에서 쿼리 요청을 받아 적용 가능한 서버로 흩뿌리고, 결과를 모아 클라이언트에 반환해요. Controller는 브로커와 클러스터 메타데이터를 공유해서 브로커가 소스 데이터를 가진 서버의 최소 하위 집합과, 필요 시 결과를 셔플하고 통합할 다른 서버를 포함하는 쿼리 실행 계획을 세울 수 있게 해요.
프로덕션 Pinot 클러스터에는 많은 브로커가 있어요. 일반적으로 브로커가 많을수록 클러스터가 처리할 수 있는 동시 쿼리가 많아지고 쿼리에 더 낮은 지연을 제공할 수 있어요.

Pinot 브로커는 Helix spectator로 모델링돼요. 테이블의 각 세그먼트(와 세그먼트의 각 복제본)의 위치를 알아야 하고, 쿼리되는 테이블의 세그먼트를 호스팅하는 적절한 서버로 요청을 라우팅해야 해요.
브로커는 쿼리에 대한 정확하고 일관된 결과를 반환하기 위해 테이블의 모든 행이 정확히 한 번 쿼리되도록 보장해요. 브로커는 정확성을 희생하지 않는 한 **일부 세그먼트를 가지치기(prune)**하도록 최적화할 수 있어요.
Helix는 spectator가 리소스(즉, participant)의 각 파티션이 위치한 곳을 알게 되는 프레임워크를 제공해요. 브로커는 이 메커니즘을 사용해 테이블의 특정 세그먼트를 호스팅하는 서버를 알아내요.
하이브리드 테이블의 경우 브로커는 **오프라인과 실시간 페더레이션(federation)**을 수행해 실시간과 오프라인 세그먼트 데이터 사이의 겹침이 정확히 한 번 쿼리되도록 보장해요.
예를 들어 보겠습니다. 3월 23일부터 3월 27일까지 5일치의 실시간 데이터가 있고, 오프라인 데이터는 실시간보다 2일 뒤처진 3월 25일까지 푸시됐다고 해요. 브로커는 이 시간 경계를 유지해요.
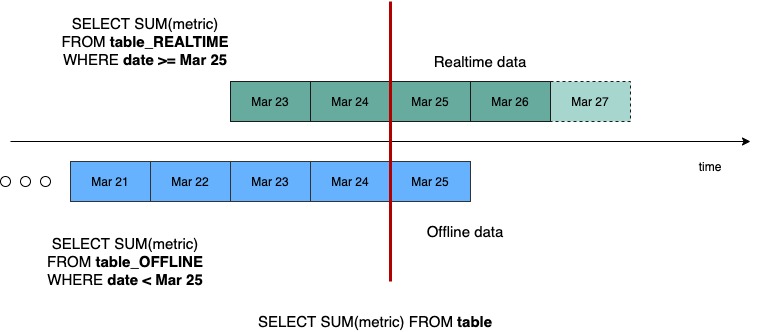
이 테이블에 select sum(metric) from table 쿼리가 들어온다고 가정해 보세요. 브로커는 이 시간 경계를 기준으로 쿼리를 2개로 나눠요. 하나는 오프라인용, 하나는 실시간용이에요. 이 쿼리는 select sum(metric) from table_REALTIME where date >= Mar 25와 select sum(metric) from table_OFFLINE where date < Mar 25가 돼요.
브로커는 클라이언트에 결과를 반환하기 전에 두 쿼리의 결과를 병합해요.
브로커 시작 (Starting a broker)
Zookeeper를 설정했는지 확인하세요. Docker를 사용한다면 Pinot Docker 이미지를 받아두세요. 브로커를 시작하려면:
Docker 이미지:
docker run \
    --network=pinot-demo \
    --name pinot-broker \
    -d ${PINOT_IMAGE} StartBroker \
    -zkAddress pinot-zookeeper:2181
런처 스크립트:
bin/pinot-admin.sh StartBroker \
  -zkAddress localhost:2181 \
  -clusterName PinotCluster \
  -brokerPort 7000