
Observability 도구
Observability 도구 (Observability Tools)
RAG 파이프라인의 품질을 시각화하고 분석하는 데 Observability 도구는 아주 유용해요. 이 문서에서는 Arize의 Phoenix와 LangSmith를 Ragas와 함께 사용해서 평가를 추적하고 시각화하는 방법을 다뤄요.
출처: 문서
본문
Phoenix (Arize)
1. 소개 (Introduction)
RAG 파이프라인의 베이스라인을 구축하는 것은 보통 어렵지 않지만, 이를 프로덕션에 적합하게 개선하고 응답 품질을 보장하는 것은 거의 항상 어려워요. 옵션이 많을 때 RAG에 맞는 올바른 도구와 파라미터를 선택하는 것 자체가 도전이 될 수 있어요. 이 튜토리얼은 RAG를 구축하면서 올바른 선택을 하고 품질을 보장하는 견고한 워크플로우를 공유해요.
이 글은 오픈소스 라이브러리 조합으로 RAG를 평가, 시각화, 분석하는 방법을 다뤄요. 다음을 사용할 거예요.
- Ragas - 합성 테스트 데이터 생성과 평가
- Arize AI의 Phoenix - 추적, 시각화, 클러스터 분석
- LlamaIndex - RAG 파이프라인 구축
이 글에서는 RAG 파이프라인 구축에 프롬프트 엔지니어링에 관한 arXiv 논문 데이터를 사용할 거예요.
ℹ️ 이 노트북은 OpenAI API 키가 필요해요.
2. 의존성 설치 및 라이브러리 임포트
아래 셀을 실행해서 데이터셋 다운로드에 사용하는 Git LFS를 설치해요.
!git lfs install
Python 의존성을 설치하고 임포트해요.
!pip install "ragas<0.1.1" pypdf arize-phoenix "openinference-instrumentation-llama-index<1.0.0" "llama-index<0.10.0" pandas
import pandas as pd

# DataFrame 셀의 전체 내용 표시.
pd.set_option("display.max_colwidth", None)
3. OpenAI API 키 설정
아직 환경 변수로 설정되지 않았다면 OpenAI API 키를 설정해요.
import os
from getpass import getpass
import openai

if not (openai_api_key := os.getenv("OPENAI_API_KEY")):
    openai_api_key = getpass("🔑 Enter your OpenAI API key: ")
openai.api_key = openai_api_key
os.environ["OPENAI_API_KEY"] = openai_api_key
4. 합성 테스트 데이터셋 생성
평가용 골든 테스트 데이터셋을 큐레이션하는 것은 길고 지루하며 비싼 과정이라 비현실적일 수 있어요. 특히 시작 단계이거나 데이터 소스가 계속 바뀌는 경우 더 그렇죠. 이는 고품질 데이터 포인트를 합성 생성함으로써 해결할 수 있어요. 개발자가 검증할 수 있는 데이터를 만들면 테스트 데이터 큐레이션의 시간과 노력을 90% 줄일 수 있어요.
아래 셀을 실행해서 arXiv의 프롬프트 엔지니어링 논문 데이터셋을 PDF 형식으로 다운로드하고 LlamaIndex로 이 문서들을 읽어요.
!git clone https://huggingface.co/datasets/vibrantlabsai/prompt-engineering-papers
from llama_index import SimpleDirectoryReader

dir_path = "./prompt-engineering-papers"
reader = SimpleDirectoryReader(dir_path, num_files_limit=2)
documents = reader.load_data()
이상적인 테스트 데이터셋은 프로덕션에서 관찰되는 분포와 유사한 고품질의 다양한 데이터 포인트를 포함해야 해요. Ragas는 고유한 진화 기반 합성 데이터 생성 패러다임을 사용해 최고 품질의 질문을 생성하며, 생성되는 질문의 다양성도 보장해요. Ragas는 기본적으로 OpenAI 모델을 사용하지만, 원하는 모델을 자유롭게 쓸 수 있어요. Ragas로 100개의 데이터 포인트를 생성해볼게요.
from ragas.testset import TestsetGenerator
from langchain_openai import ChatOpenAI
from ragas.embeddings import OpenAIEmbeddings
import openai

TEST_SIZE = 25

# openai 모델을 사용한 generator
generator_llm = ChatOpenAI(model="gpt-4o-mini")
critic_llm = ChatOpenAI(model="gpt-4o")
openai_client = openai.OpenAI()
embeddings = OpenAIEmbeddings(client=openai_client)

generator = TestsetGenerator.from_langchain(generator_llm, critic_llm, embeddings)

# testset 생성
testset = generator.generate_with_llamaindex_docs(documents, test_size=TEST_SIZE)
test_df = testset.to_pandas()
test_df.head()
필요에 따라 질문 유형 분포를 자유롭게 바꿀 수 있어요. 테스트 데이터셋이 준비됐으니, 이제 LlamaIndex로 간단한 RAG 파이프라인을 구축해볼게요.
5. LlamaIndex로 RAG 애플리케이션 구축
LlamaIndex는 RAG 애플리케이션 구축에 쉽고 유연한 프레임워크예요. 단순함을 위해 기본 LLM(gpt-3.5-turbo)과 임베딩 모델(openai-ada-2)을 사용해요.
백그라운드에서 Phoenix를 실행하고 LlamaIndex 애플리케이션을 계측해서 OpenInference 스팬과 트레이스가 Phoenix로 전송·수집되도록 해요. OpenInference는 OpenTelemetry 위에 구축된 오픈 표준으로, LLM 애플리케이션 실행을 캡처하고 저장해요. 벡터 저장소에서의 검색이나 검색 엔진·API 같은 외부 도구의 사용 등 LLM 실행과 주변 애플리케이션 컨텍스트를 이해하는 데 사용되는 텔레메트리 데이터 카테고리로 설계되었어요.
import phoenix as px
from llama_index import set_global_handler

session = px.launch_app()
set_global_handler("arize_phoenix")
쿼리 엔진을 구축해요.
from llama_index.core import VectorStoreIndex, ServiceContext
from llama_index.embeddings.openai import OpenAIEmbedding

def build_query_engine(documents):
    vector_index = VectorStoreIndex.from_documents(
        documents,
        service_context=ServiceContext.from_defaults(chunk_size=512),
        embed_model=OpenAIEmbedding(),
    )
    query_engine = vector_index.as_query_engine(similarity_top_k=2)
    return query_engine

query_engine = build_query_engine(documents)
Phoenix를 확인하면 코퍼스 데이터가 인덱싱될 때의 임베딩 스팬을 볼 수 있어요. 나중에 시각화하기 위해 그 임베딩들을 DataFrame으로 내보내서 저장해요.
from phoenix.trace.dsl import SpanQuery

client = px.Client()
corpus_df = px.Client().query_spans(
    SpanQuery().explode(
        "embedding.embeddings",
        text="embedding.text",
        vector="embedding.vector",
    )
)
corpus_df.head()
누적된 트레이스를 지우기 위해 Phoenix를 다시 실행해요.
px.close_app()
session = px.launch_app()
6. LLM 애플리케이션 평가
Ragas는 RAG 파이프라인을 컴포넌트 단위와 엔드투엔드로 평가하는 데 사용할 수 있는 포괄적인 메트릭 목록을 제공해요.
Ragas를 사용하려면 먼저 질문, 생성된 답변, 검색된 컨텍스트, ground-truth 답변(주어진 질문에 대한 실제 기대 답변)으로 구성된 평가 데이터셋을 만들어요.
from datasets import Dataset
from tqdm.auto import tqdm
import pandas as pd

def generate_response(query_engine, question):
    response = query_engine.query(question)
    return {
        "answer": response.response,
        "contexts": [c.node.get_content() for c in response.source_nodes],
    }

def generate_ragas_dataset(query_engine, test_df):
    test_questions = test_df["question"].values
    responses = [generate_response(query_engine, q) for q in tqdm(test_questions)]

    dataset_dict = {
        "question": test_questions,
        "answer": [response["answer"] for response in responses],
        "contexts": [response["contexts"] for response in responses],
        "ground_truth": test_df["ground_truth"].values.tolist(),
    }
    ds = Dataset.from_dict(dataset_dict)
    return ds

ragas_eval_dataset = generate_ragas_dataset(query_engine, test_df)
ragas_evals_df = pd.DataFrame(ragas_eval_dataset)
ragas_evals_df.head()
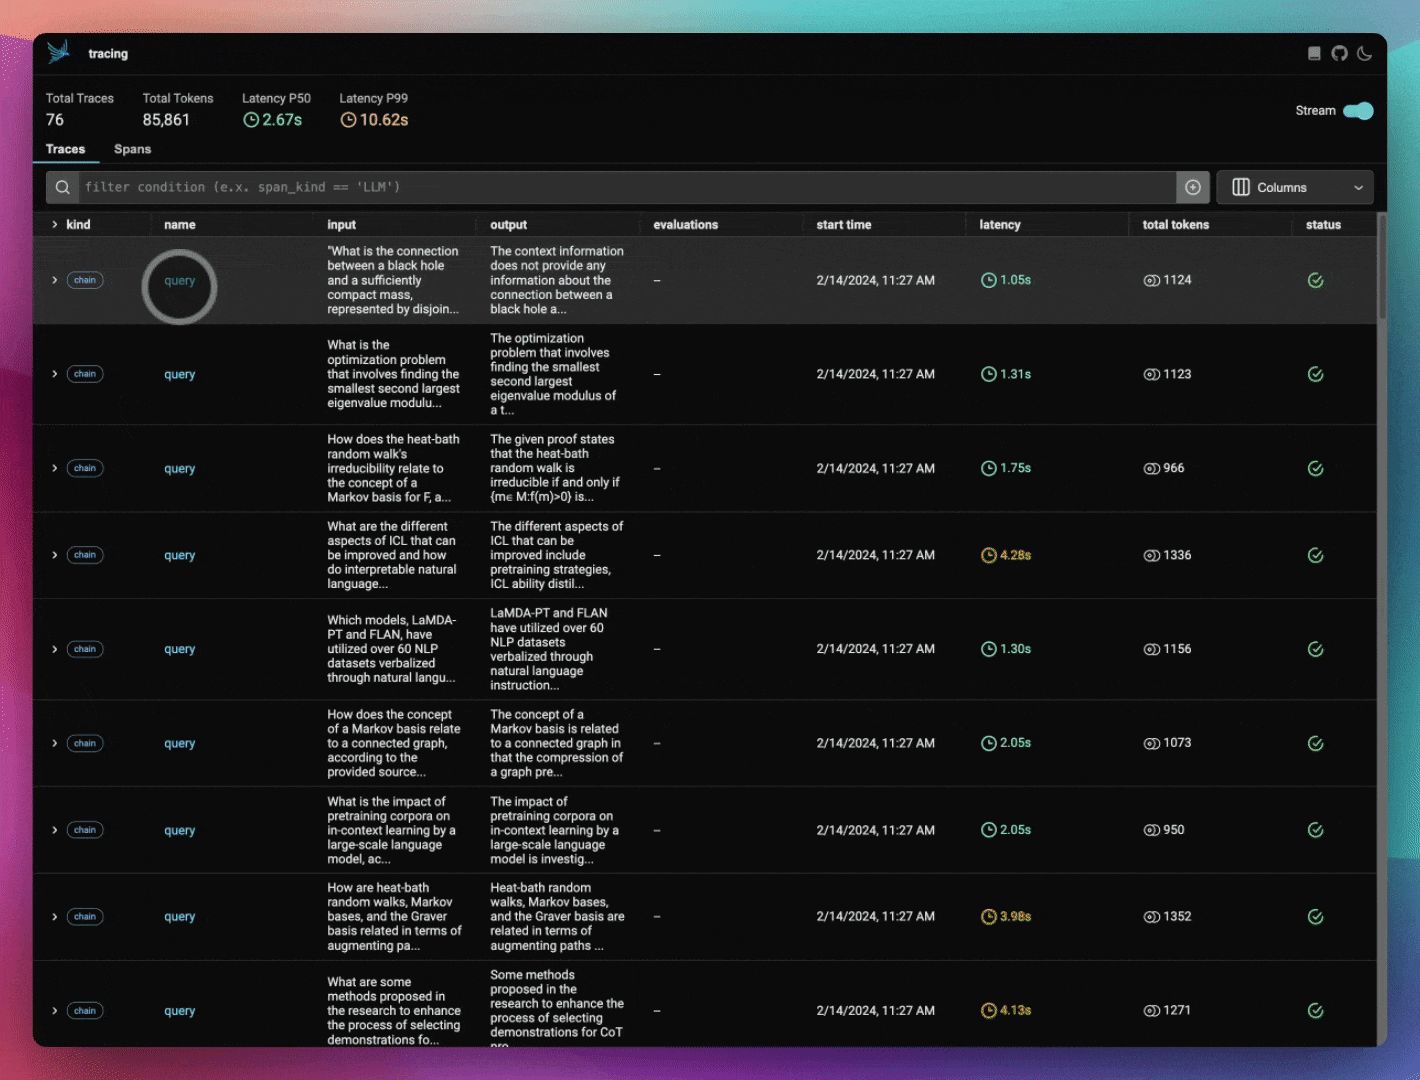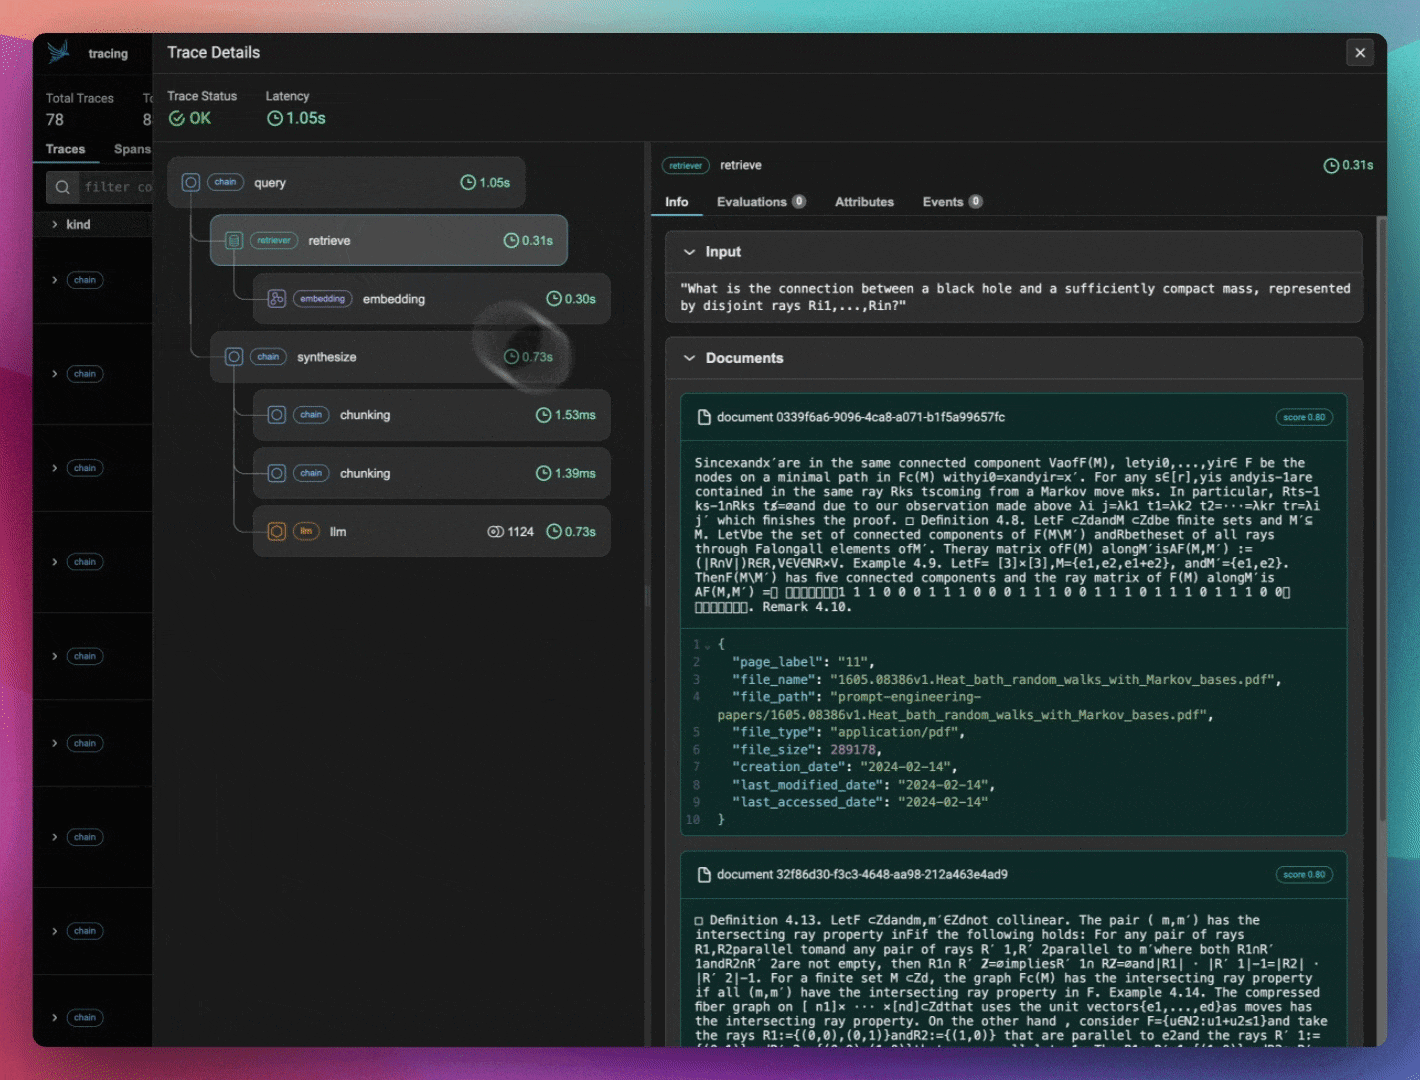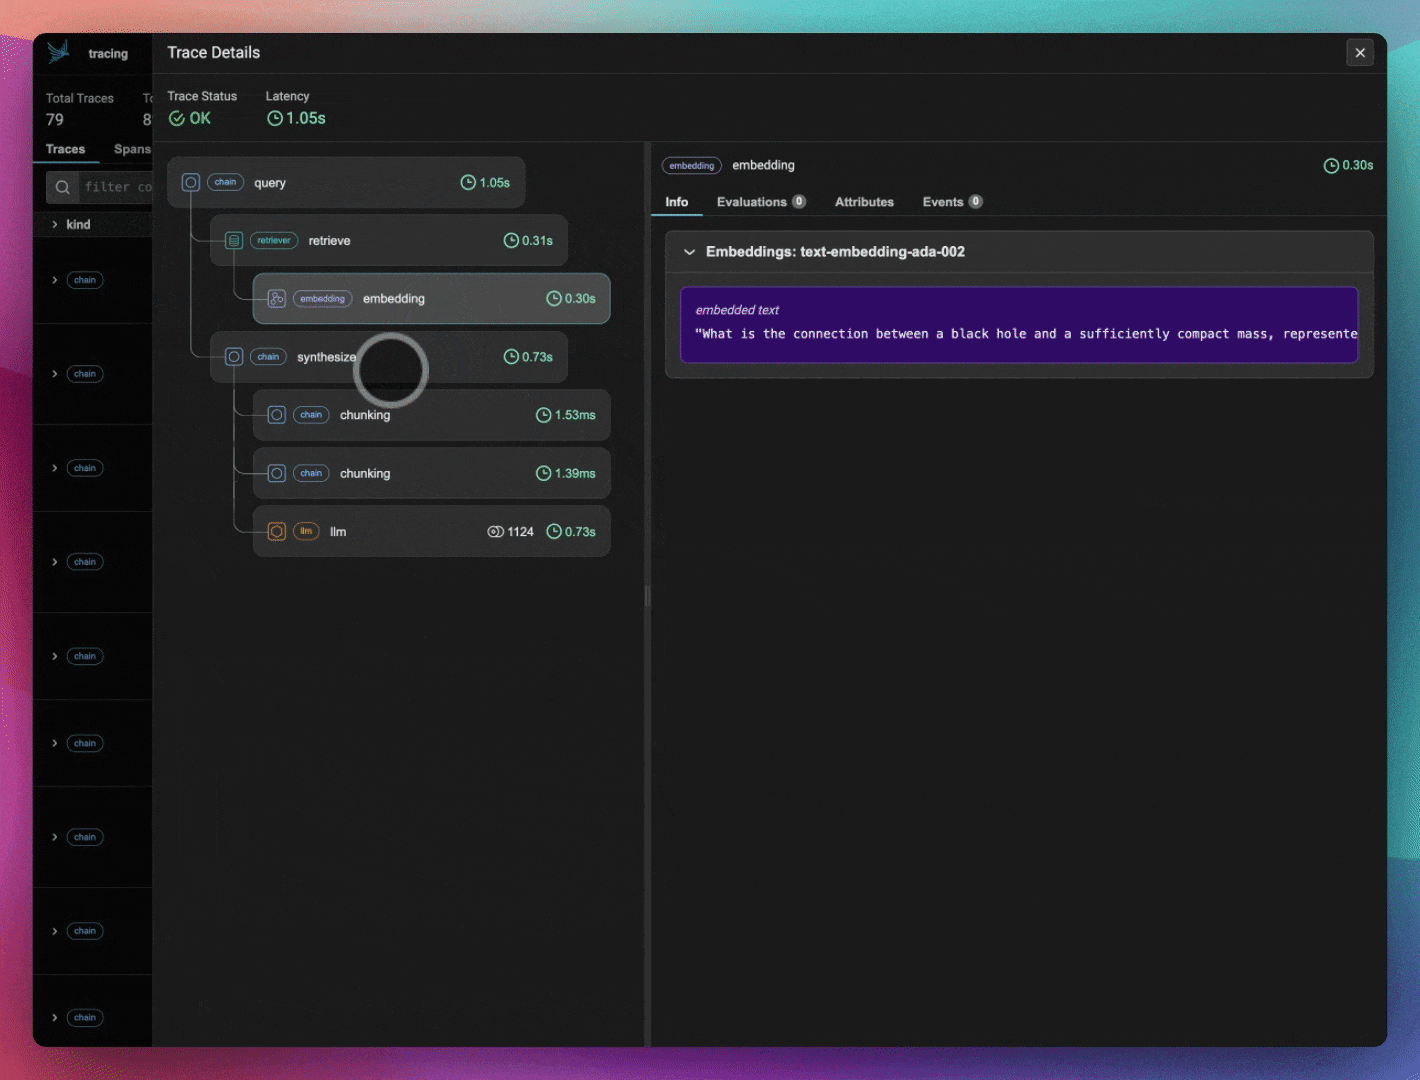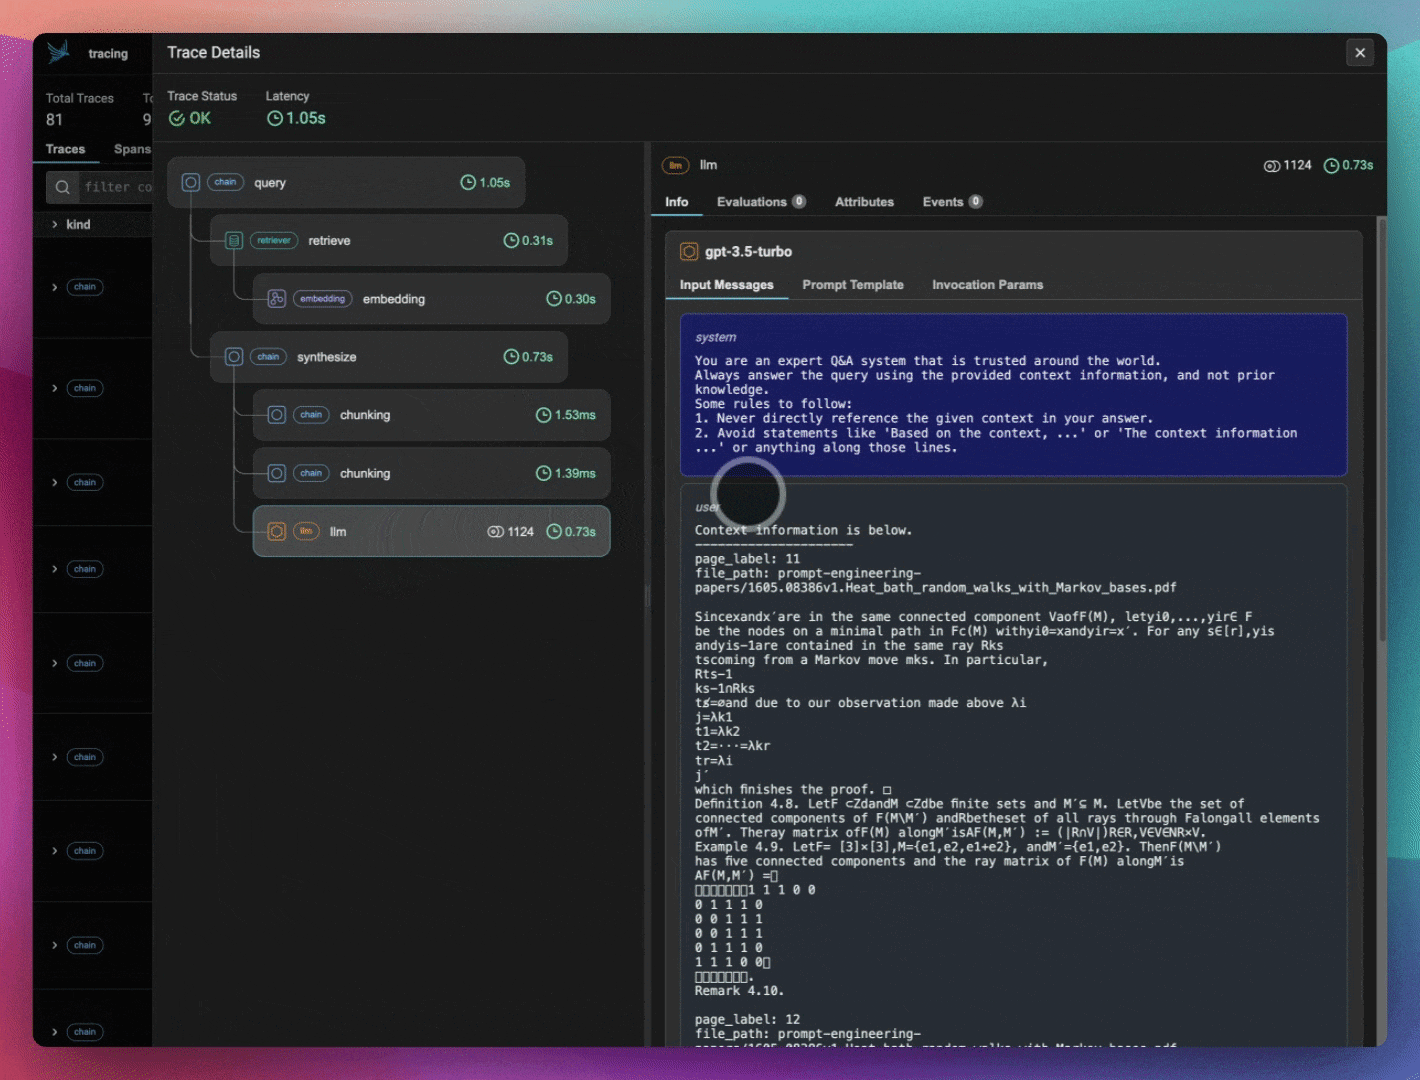
Phoenix에서 LlamaIndex 애플리케이션 트레이스를 확인해요.
print(session.url)
두 개의 DataFrame을 저장해요. 하나는 나중에 시각화할 임베딩 데이터, 다른 하나는 Ragas로 평가할 내보낸 트레이스와 스팬이에요.
# 시각화용 임베딩이 포함된 데이터셋
query_embeddings_df = px.Client().query_spans(
    SpanQuery().explode(
        "embedding.embeddings", text="embedding.text", vector="embedding.vector"
    )
)
query_embeddings_df.head()
from phoenix.session.evaluation import get_qa_with_reference

# Ragas로 평가할 스팬 데이터가 포함된 데이터셋
spans_dataframe = get_qa_with_reference(client)
spans_dataframe.head()
Ragas는 LangChain을 사용해서 LLM 애플리케이션 데이터를 평가해요. LangChain을 OpenInference로 계측해서 LLM 애플리케이션을 평가할 때 내부에서 무슨 일이 일어나는지 확인해요.
from openinference.instrumentation.langchain import LangChainInstrumentor

LangChainInstrumentor().instrument()
LLM 트레이스를 평가하고 DataFrame 형식으로 평가 점수를 확인해요.
from ragas import evaluate
from ragas.metrics import (
    faithfulness,
    answer_correctness,
    context_recall,
    context_precision,
)

evaluation_result = evaluate(
    dataset=ragas_eval_dataset,
    metrics=[faithfulness, answer_correctness, context_recall, context_precision],
)
eval_scores_df = pd.DataFrame(evaluation_result.scores)
평가 결과를 Phoenix에 제출해서 스팬에 주석으로 표시되게 해요.
from phoenix.trace import SpanEvaluations

# ragas 평가 점수에 스팬 id를 할당 (Phoenix가 스팬을 어디에 붙일지 알아야 하기 때문).
eval_data_df = pd.DataFrame(evaluation_result.dataset)
assert eval_data_df.question.to_list() == list(
    reversed(spans_dataframe.input.to_list())  # 스팬은 역순임
), "Phoenix spans are in an unexpected order. Re-start the notebook and try again."
eval_scores_df.index = pd.Index(
    list(reversed(spans_dataframe.index.to_list())), name=spans_dataframe.index.name
)

# 평가를 Phoenix에 기록.
for eval_name in eval_scores_df.columns:
    evals_df = eval_scores_df[[eval_name]].rename(columns={eval_name: "score"})
    evals = SpanEvaluations(eval_name, evals_df)
    px.Client().log_evaluations(evals)
Phoenix를 확인하면 Ragas 평가가 애플리케이션 스팬에 주석으로 표시된 것을 볼 수 있어요.
print(session.url)
7. 임베딩 시각화 및 분석
임베딩은 검색된 문서와 사용자 쿼리의 의미를 인코딩해요. RAG 시스템의 필수적인 부분일 뿐만 아니라 LLM 애플리케이션 성능을 이해하고 디버깅하는 데도 매우 유용해요.
Phoenix는 RAG 애플리케이션의 고차원 임베딩을 가져와 차원을 축소하고, 의미적으로 의미 있는 데이터 그룹으로 클러스터링해요. 그런 다음 원하는 메트릭(예: Ragas로 계산된 faithfulness 또는 answer correctness)을 선택해서 애플리케이션 성능을 시각적으로 검사하고 문제가 있는 클러스터를 표면화할 수 있어요. 이 접근 방식의 장점은 데이터의 세분화된 의미 있는 하위 집합에 메트릭을 제공해서 전역이 아닌 지역 성능도 분석할 수 있다는 점이에요. 또한 LLM 애플리케이션이 어떤 종류의 쿼리를 답하는 데 어려움을 겪는지에 대한 직관을 얻는 데도 도움이 돼요.
임베딩 시각화 도구로 Phoenix를 다시 실행해서 테스트 데이터셋에서 애플리케이션 성능을 검사할게요.
query_embeddings_df = query_embeddings_df.iloc[::-1]
assert ragas_evals_df.question.tolist() == query_embeddings_df.text.tolist()
assert test_df.question.tolist() == ragas_evals_df.question.tolist()
query_df = pd.concat(
    [
        ragas_evals_df[["question", "answer", "ground_truth"]].reset_index(drop=True),
        query_embeddings_df[["vector"]].reset_index(drop=True),
        test_df[["evolution_type"]],
        eval_scores_df.reset_index(drop=True),
    ],
    axis=1,
)
query_df.head()
query_schema = px.Schema(
    prompt_column_names=px.EmbeddingColumnNames(
        raw_data_column_name="question", vector_column_name="vector"
    ),
    response_column_names="answer",
)
corpus_schema = px.Schema(
    prompt_column_names=px.EmbeddingColumnNames(
        raw_data_column_name="text", vector_column_name="vector"
    )
)
# 임베딩을 보기 위해 primary와 corpus 데이터셋으로 phoenix를 다시 실행
px.close_app()
session = px.launch_app(
    primary=px.Dataset(query_df, query_schema, "query"),
    corpus=px.Dataset(corpus_df.reset_index(drop=True), corpus_schema, "corpus"),
)
Phoenix를 실행하면 다음 단계로 원하는 메트릭으로 데이터를 시각화할 수 있어요.
vector임베딩 선택,Color By > dimension을 선택한 뒤 원하는 차원을 선택해서 데이터를 특정 필드로 색칠 (예: faithfulness 또는 answer correctness 같은 Ragas 평가 점수),metric드롭다운에서 원하는 메트릭을 선택해서 클러스터 단위로 집계 메트릭을 확인.
8. 요약 (Recap)
축하해요! Ragas와 Phoenix로 LlamaIndex 쿼리 엔진을 구축하고 평가했어요. 배운 내용을 정리해볼게요.
- Ragas로 테스트 데이터셋을 부트스트랩하고 faithfulness, answer correctness 같은 메트릭을 계산해서 LlamaIndex 쿼리 엔진을 평가했어요.
- OpenInference로 쿼리 엔진을 계측해서 LlamaIndex와 Ragas 모두의 내부 동작을 관찰할 수 있었어요.
- Phoenix로 스팬과 트레이스를 수집하고 평가를 가져와 쉽게 검사하며, 임베딩된 쿼리와 검색된 문서를 시각화해서 성능이 낮은 부분을 식별했어요.
이 노트북은 Ragas와 Phoenix 기능의 소개일 뿐이에요. 더 배우려면 Ragas와 Phoenix 문서를 참고해요.
이 튜토리얼이 마음에 들었다면 GitHub에 ⭐를 남겨주세요.
LangSmith
LangSmith는 대규모 언어 모델(LLM)을 활용하는 애플리케이션의 개발과 배포를 개선하도록 설계된 고급 도구예요. LLM 워크플로우를 추적, 분석, 최적화하기 위한 포괄적인 프레임워크를 제공해서 개발자가 애플리케이션 내 복잡한 상호작용을 더 쉽게 관리할 수 있게 해줘요.
이 튜토리얼은 LangSmith를 사용해서 Ragas 평가의 트레이스를 기록하는 방법을 설명해요. Ragas는 LangChain 위에 구축되어 있으므로 LangSmith만 설정하면 트레이스 기록을 자동으로 처리해요.
1. LangSmith 설정
LangSmith를 설정하려면 다음 환경 변수를 설정해요(자세한 내용은 LangSmith 문서 참고).
export LANGCHAIN_TRACING_V2=true
export LANGCHAIN_ENDPOINT=https://api.smith.langchain.com
export LANGCHAIN_API_KEY=<your-api-key>
export LANGCHAIN_PROJECT=<your-project>  # 설정하지 않으면 "default"로 기본 설정
2. 데이터셋 가져오기
평가 데이터셋을 만들거나 인스턴스를 평가할 때는 용어가 SingleTurnSample 또는 MultiTurnSample에 사용된 스키마와 일치하는지 확인해요.
from ragas import EvaluationDataset

dataset = [
    {
        "user_input": "Which CEO is widely recognized for democratizing AI education through platforms like Coursera?",
        "retrieved_contexts": [
            "Andrew Ng, CEO of Landing AI, is known for his pioneering work in deep learning and for democratizing AI education through Coursera."
        ],
        "response": "Andrew Ng is widely recognized for democratizing AI education through platforms like Coursera.",
        "reference": "Andrew Ng, CEO of Landing AI, is known for democratizing AI education through Coursera.",
    },
    {
        "user_input": "Who is Sam Altman?",
        "retrieved_contexts": [
            "Sam Altman, CEO of OpenAI, has advanced AI research and advocates for safe, beneficial AI technologies."
        ],
        "response": "Sam Altman is the CEO of OpenAI and advocates for safe, beneficial AI technologies.",
        "reference": "Sam Altman, CEO of OpenAI, has advanced AI research and advocates for safe AI.",
    },
    {
        "user_input": "Who is Demis Hassabis and how did he gain prominence?",
        "retrieved_contexts": [
            "Demis Hassabis, CEO of DeepMind, is known for developing systems like AlphaGo that master complex games."
        ],
        "response": "Demis Hassabis is the CEO of DeepMind, known for developing systems like AlphaGo.",
        "reference": "Demis Hassabis, CEO of DeepMind, is known for developing AlphaGo.",
    },
    {
        "user_input": "Who is the CEO of Google and Alphabet Inc., praised for leading innovation across Google's product ecosystem?",
        "retrieved_contexts": [
            "Sundar Pichai, CEO of Google and Alphabet Inc., leads innovation across Google's product ecosystem."
        ],
        "response": "Sundar Pichai is the CEO of Google and Alphabet Inc., praised for leading innovation across Google's product ecosystem.",
        "reference": "Sundar Pichai, CEO of Google and Alphabet Inc., leads innovation across Google's product ecosystem.",
    },
    {
        "user_input": "How did Arvind Krishna transform IBM?",
        "retrieved_contexts": [
            "Arvind Krishna, CEO of IBM, transformed the company by focusing on cloud computing and AI solutions."
        ],
        "response": "Arvind Krishna transformed IBM by focusing on cloud computing and AI solutions.",
        "reference": "Arvind Krishna, CEO of IBM, transformed the company through cloud computing and AI.",
    },
]

evaluation_dataset = EvaluationDataset.from_list(dataset)
3. ragas 메트릭 추적
데이터셋에서 Ragas 평가를 실행하면 지정된 프로젝트 이름 또는 "default" 아래의 LangSmith 대시보드에 트레이스가 나타나요.
from ragas import evaluate
from ragas.llms import LangchainLLMWrapper
from langchain_openai import ChatOpenAI
from ragas.metrics import LLMContextRecall, Faithfulness, FactualCorrectness

llm = ChatOpenAI(model="gpt-4o-mini")
evaluator_llm = LangchainLLMWrapper(llm)

result = evaluate(
    dataset=evaluation_dataset,
    metrics=[LLMContextRecall(), Faithfulness(), FactualCorrectness()],
    llm=evaluator_llm,
)

result
출력
Evaluating:   0%|          | 0/15 [00:00<?, ?it/s]

{'context_recall': 1.0000, 'faithfulness': 0.9333, 'factual_correctness': 0.8520}
4. LangSmith 대시보드
