
데이터 파일 구성
데이터 파일 구성 (Data files Configuration)
데이터셋 저장소의 구조에 대한 제약은 없어요. 하지만 Dataset Viewer가 특정 데이터 파일을 보여주게 하거나, 데이터셋을 train/validation/test split으로 나누고 싶다면 그에 맞게 구조를 잡아야 해요. 보통은 train.csv, test.csv처럼 파일 이름을 split 이름에 맞춰 짓는 것만으로 충분하답니다.
출처: 문서
본문
데이터셋 저장소를 구조화하는 방법에 제약은 없어요.
하지만 Dataset Viewer가 특정 데이터 파일을 보여주게 하거나, 데이터셋을 train/validation/test split으로 나누고 싶다면 그에 맞게 데이터셋을 구조화해야 해요.
보통은 데이터 파일 이름을 split 이름에 맞게 짓는 것처럼 간단해요. 예: train.csv, test.csv.
splits와 subsets란 무엇인가?
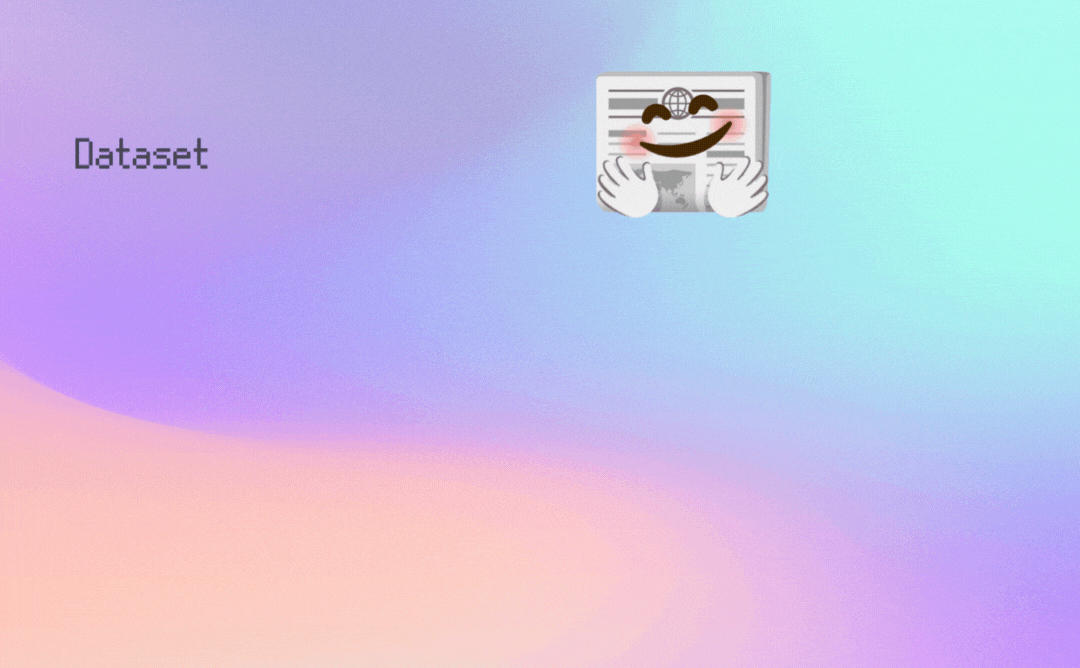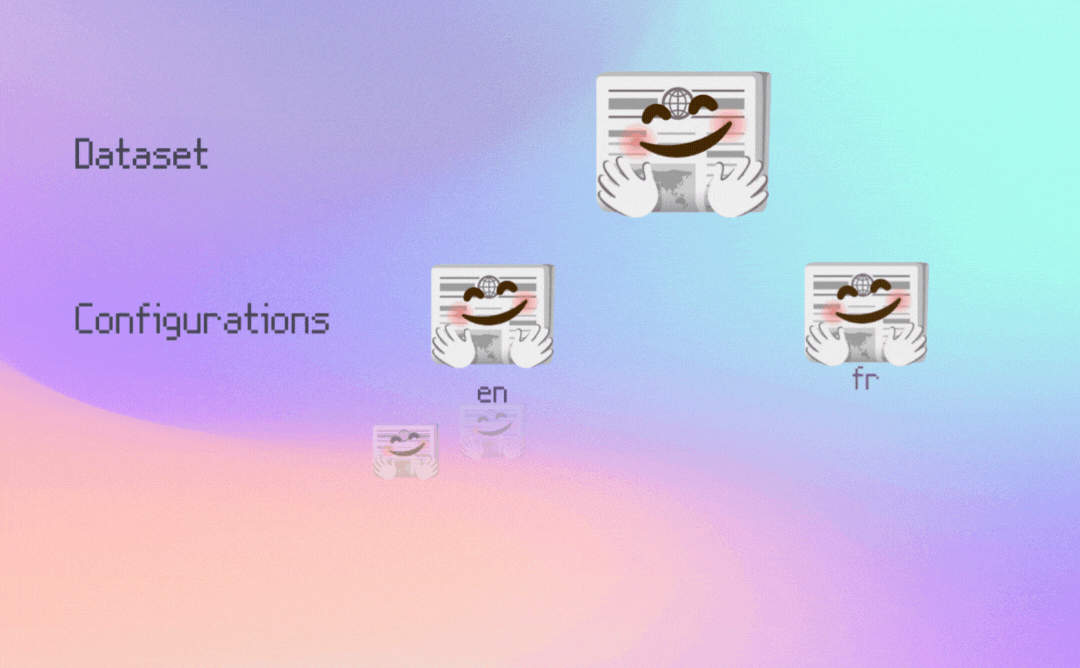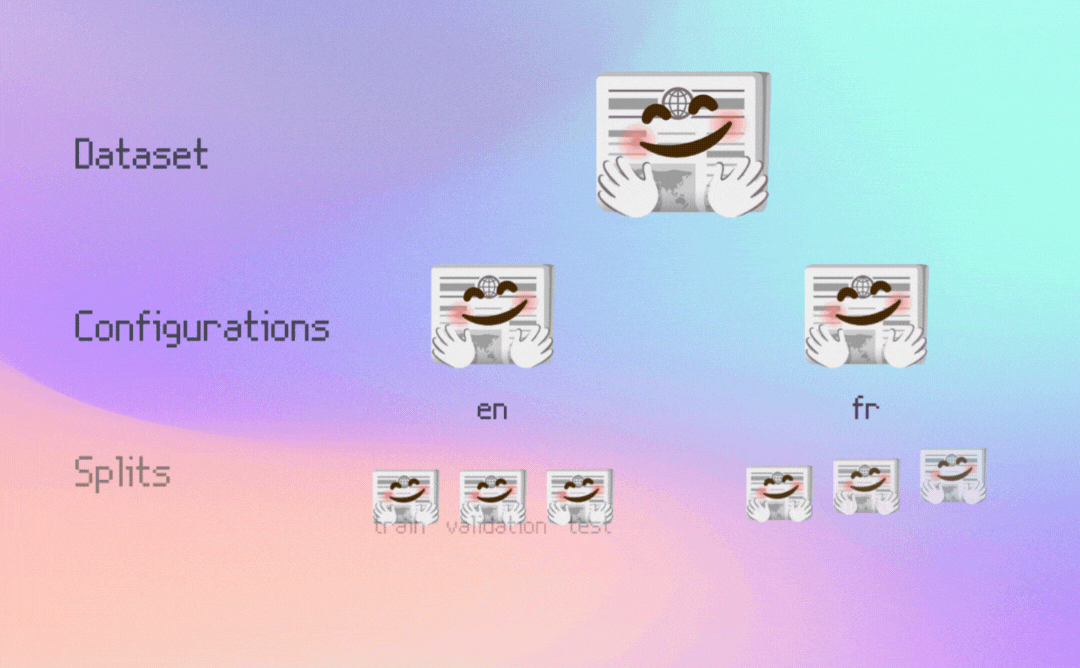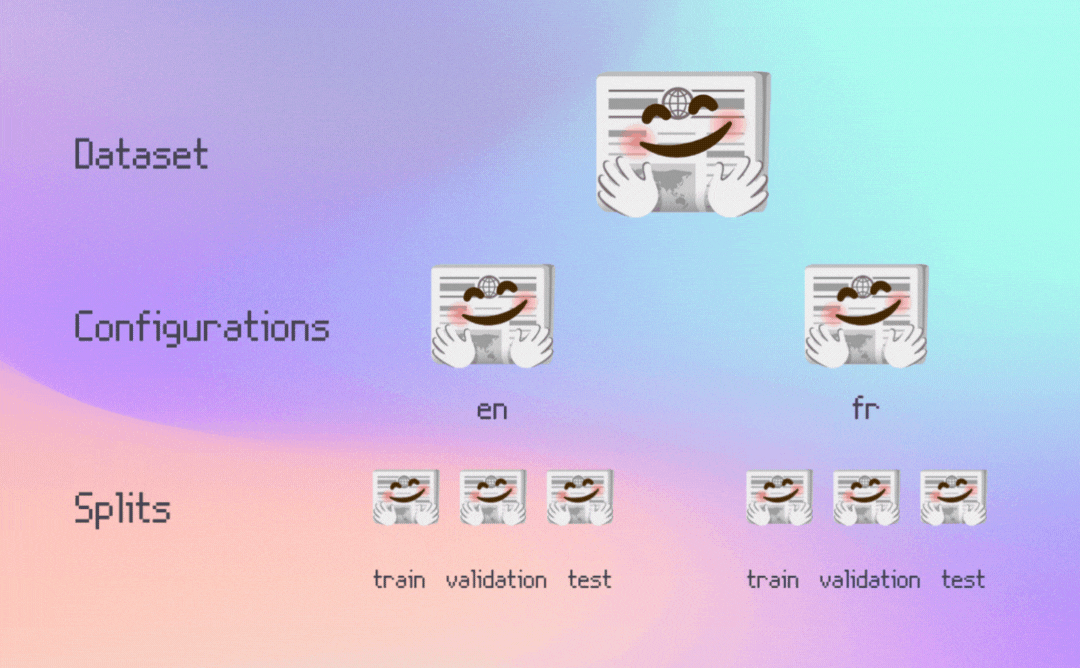
머신러닝 데이터셋은 보통 splits를 가지며 subsets도 가질 수 있어요. 데이터셋은 일반적으로 모델 학습·평가의 여러 단계에서 사용되는 splits(예: train, test)로 구성돼요. subset(또는 configuration)은 더 큰 데이터셋 안에 포함된 하위 데이터셋이에요. Subset은 언어마다 다른 subset이 있을 수 있는 다국어 음성 데이터셋에서 특히 흔해요. splits와 subsets에 대해 더 알고 싶다면 Splits and subsets 가이드를 확인해 주세요!
자동 split 감지
Splits는 파일과 디렉토리 이름을 기반으로 자동 감지돼요. 예를 들어 train, test, validation split이 있는 데이터셋은 이렇게 생겼어요:
my_dataset_repository/
├── README.md
├── train.csv
├── test.csv
└── validation.csv
데이터 파일이나 디렉토리 이름을 split 이름에 맞춰 데이터셋을 구성하는 방법은 파일 이름과 splits 문서와 예시 데이터셋 컬렉션을 참고해요.
수동 split 및 subsets 구성
YAML을 사용해 데이터셋의 Dataset Viewer에서 보여줄 데이터 파일을 선택할 수 있어요. 어떤 파일이 어떤 split에 들어갈지 수동으로 지정하고 싶을 때 유용해요.
데이터셋에 여러 subset을 정의하고, 데이터셋 빌드 파라미터(예: CSV 파일에 사용할 구분자)도 전달할 수 있어요.
다음은 test split을 가진 "benchmark"라는 subset을 정의하는 구성 예시예요.
configs:
- config_name: benchmark
  data_files:
  - split: test
    path: benchmark.csv
자세한 내용은 수동 구성 (Manual configuration) 문서를 참고해요. 예시 데이터셋도 확인해 보세요.
지원되는 파일 형식
지원되는 형식 목록과 데이터셋 권장 사항은 파일 형식 (File formats) 문서를 확인해 주세요. 데이터셋이 CSV나 TSV 파일을 사용한다면 예시 데이터셋에서 더 많은 정보를 찾을 수 있어요.
Dataset Viewer 크기 제한 오류 (TooBigContentError)
Error code: TooBigContentError가 보이면, Dataset Viewer가 한계 내에서 미리보기를 읽지 못한 거예요. 흔한 메시지로는 Parquet error: Scan size limit exceeded와 The size of the content of the first rows exceeds the maximum supported size가 있어요.
할 수 있는 일:
- Parquet 파일의 경우 더 작은 row groups를 사용하고 페이지 인덱스(
write_page_index=True)를 포함해 Viewer가 필요한 것만 읽게 해요. - 첫 행에 매우 큰 값(매우 긴 문자열, 큰 JSON blob, base64 페이로드)을 피해요. 가능하면 큰 페이로드는 별도 파일로 옮겨요.
- 매우 큰 파일을 더 작은 shard나 split으로 나눈 뒤 다시 업로드해요.
- 문제가 계속되면 Dataset Viewer 구성 (Configure the Dataset Viewer)을 검토하고, 전체 오류 텍스트와 함께 데이터셋 페이지에서 논의를 열어 주세요.
이미지, 오디오, 비디오 데이터셋
이미지/오디오/비디오 분류 데이터셋의 경우 디렉토리를 사용해 이미지/오디오/비디오 클래스를 이름 지을 수도 있어요. 그리고 이미지/오디오/비디오 파일에 메타데이터(예: 캡션, 바운딩 박스, 트랜스크립션 등)가 있다면 그 옆에 메타데이터 파일을 둘 수 있어요.
확인할 수 있는 가이드 두 가지를 제공해요:
더 알아보기 (Learn more)
- 파일 이름을 split 이름에 맞추면(Dataset Viewer가) split을 자동으로 감지해요.
- Dataset Viewer에 너무 큰 데이터는
write_page_index=True같은 방법으로 최적화해서TooBigContentError를 피할 수 있어요.