
GGUF
GGUF
허깅페이스 Hub는 모든 파일 형식을 지원하지만, GGUF 형식에 내장 기능이 있어요. GGUF는 모델의 빠른 로딩·저장에 최적화된 바이너리 형식으로, 추론 목적에 매우 효율적이에요. GGML과 다른 실행 엔진과 함께 사용되도록 설계됐고, llama.cpp 개발자인 @ggerganov가 만들었답니다.
출처: 문서
본문
Hugging Face Hub는 모든 파일 형식을 지원하지만, GGUF 형식에 내장 기능이 있어요 — 모델의 빠른 로딩·저장에 최적화된 바이너리 형식으로, 추론 목적에 매우 효율적이에요. GGUF는 GGML 및 다른 실행 엔진과 함께 사용되도록 설계됐어요. GGUF는 llama.cpp — 인기 있는 C/C++ LLM 추론 프레임워크 — 의 개발자이기도 한 @ggerganov가 개발했어요. PyTorch 같은 프레임워크에서 처음 개발된 모델은 이 엔진들과 사용하기 위해 GGUF 형식으로 변환할 수 있어요.
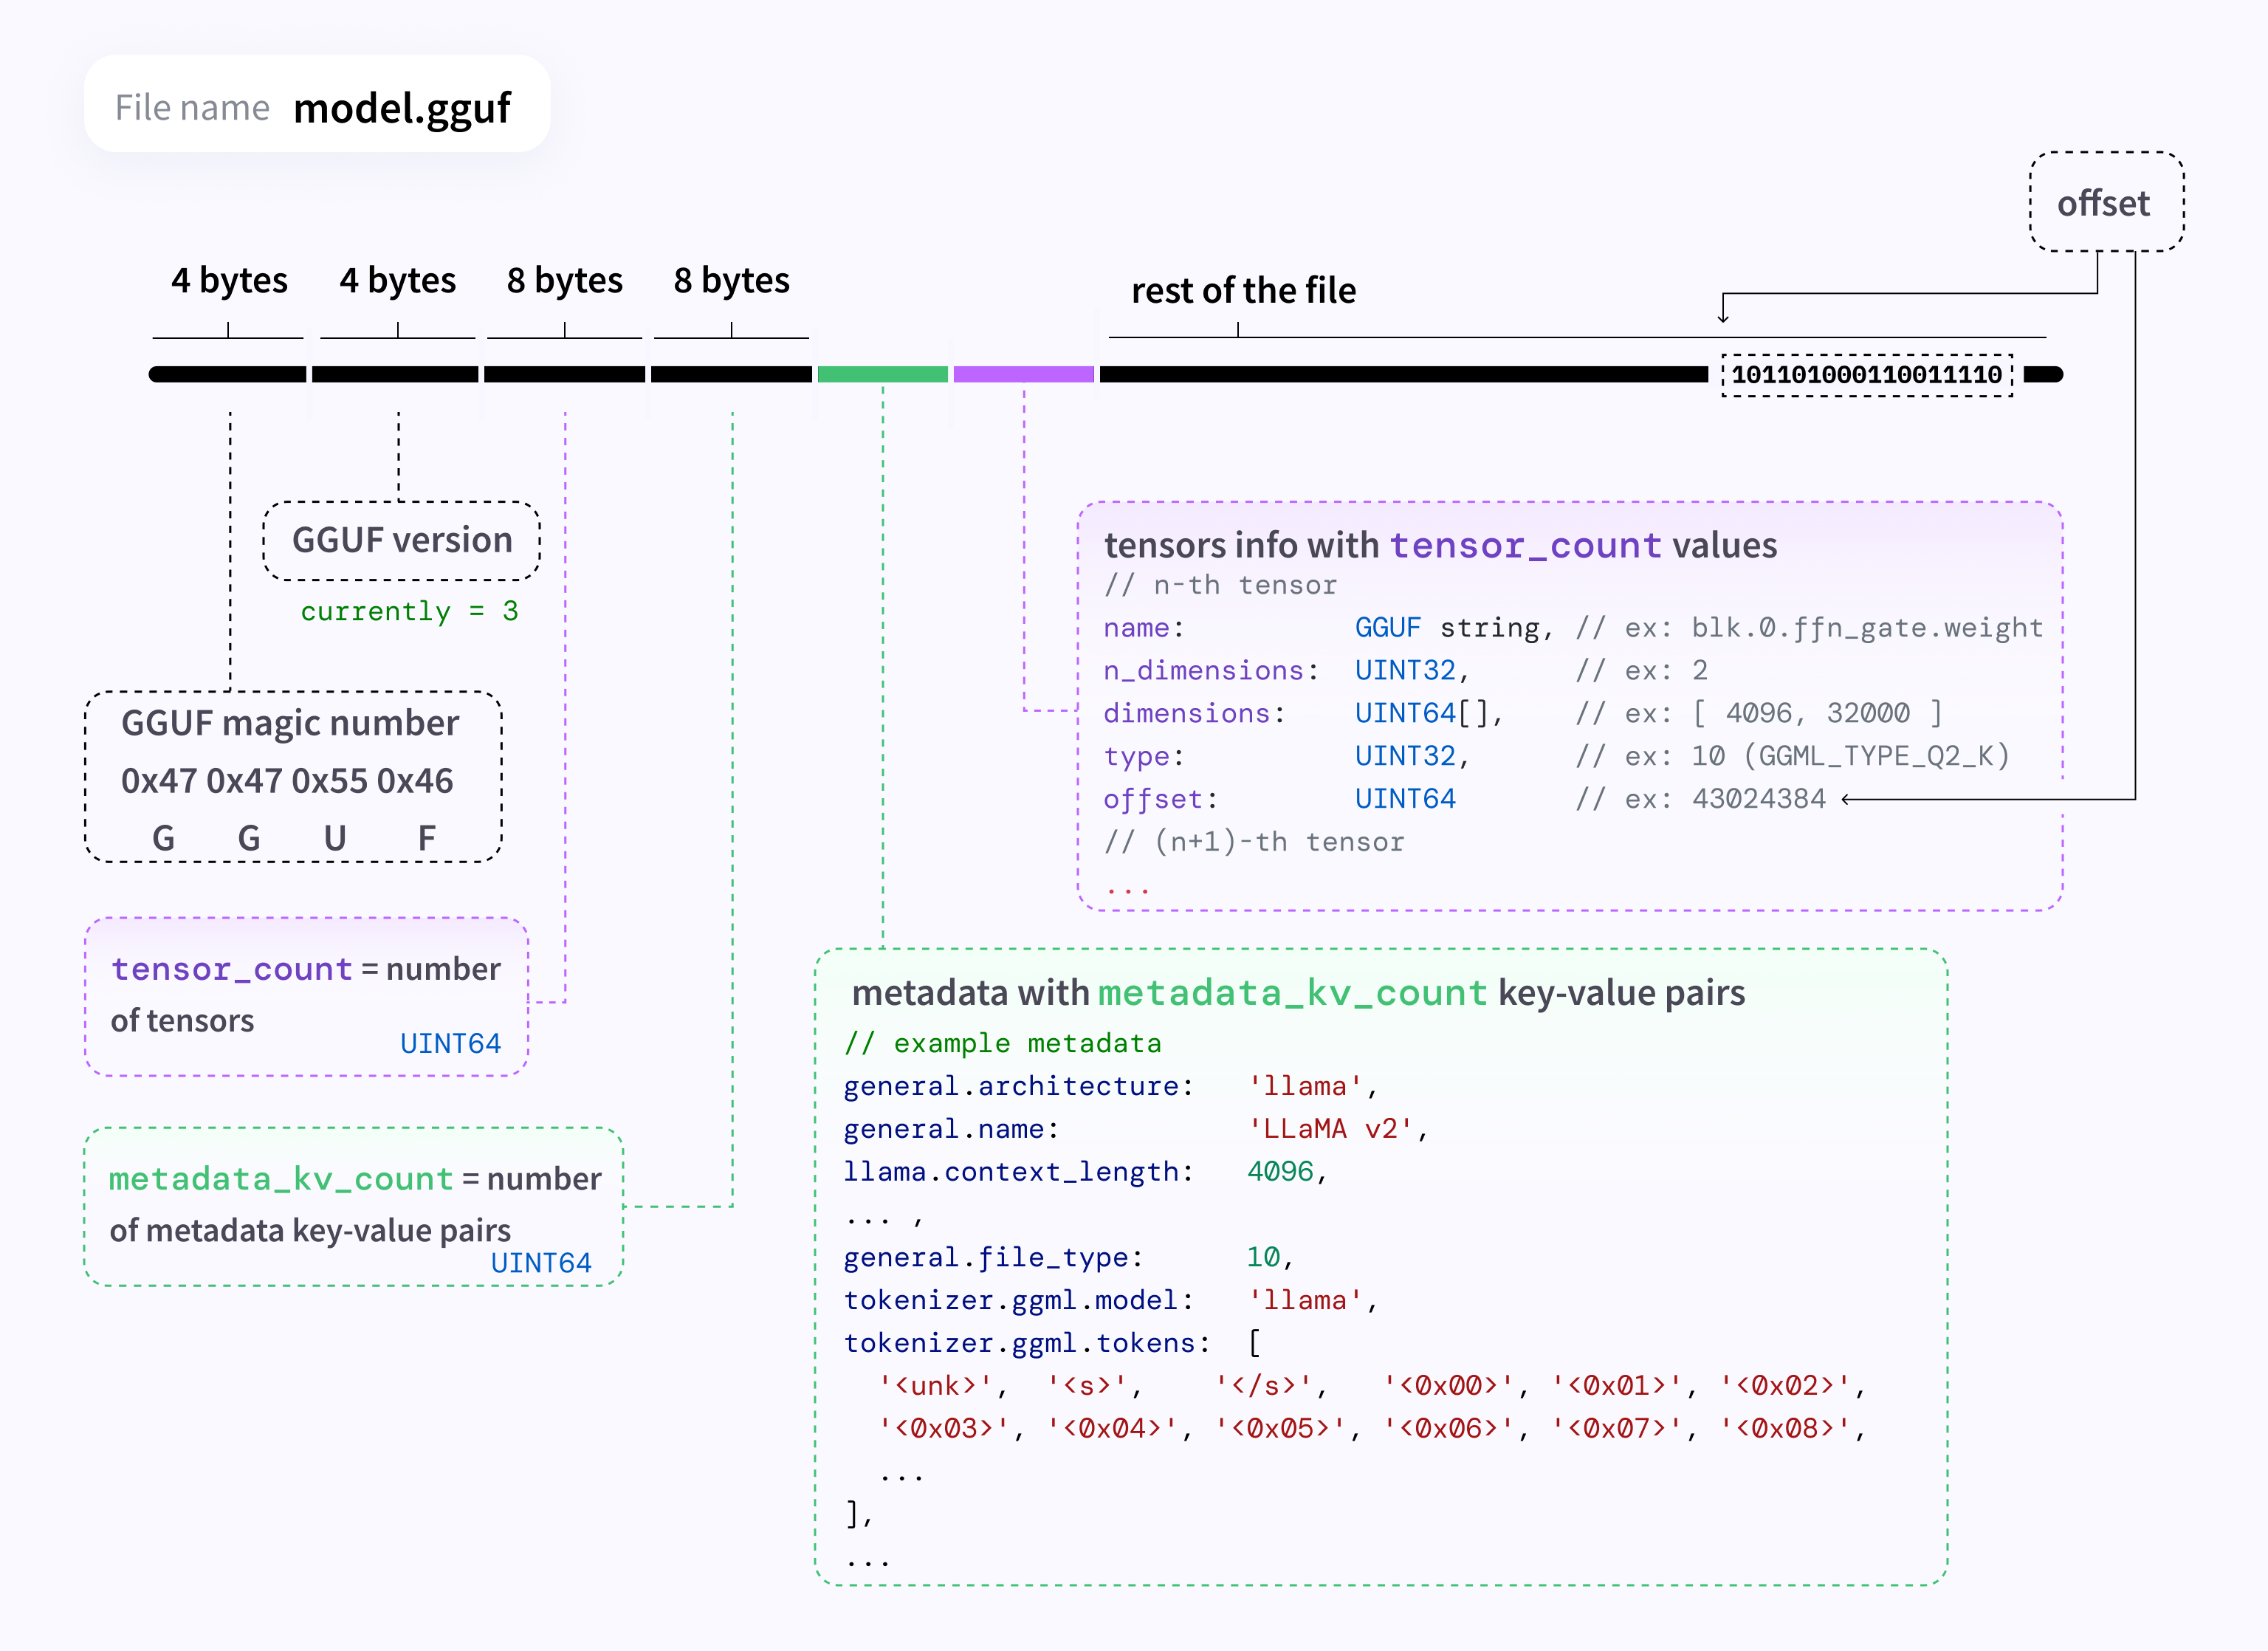
이 그래프에서 볼 수 있듯이, safetensors — Hub에서도 권장되는 모델 형식 — 같은 텐서 전용 파일 형식과 달리 GGUF는 텐서와 표준화된 메타데이터 집합 둘 다를 인코딩해요.
GGUF 파일 찾기
GGUF 태그로 필터링해 GGUF 파일이 있는 모든 모델을 탐색할 수 있어요: hf.co/models?library=gguf. 또한 ggml-org/gguf-my-repo 도구로 모델 가중치를 GGUF 가중치로 변환·양자화할 수 있어요.
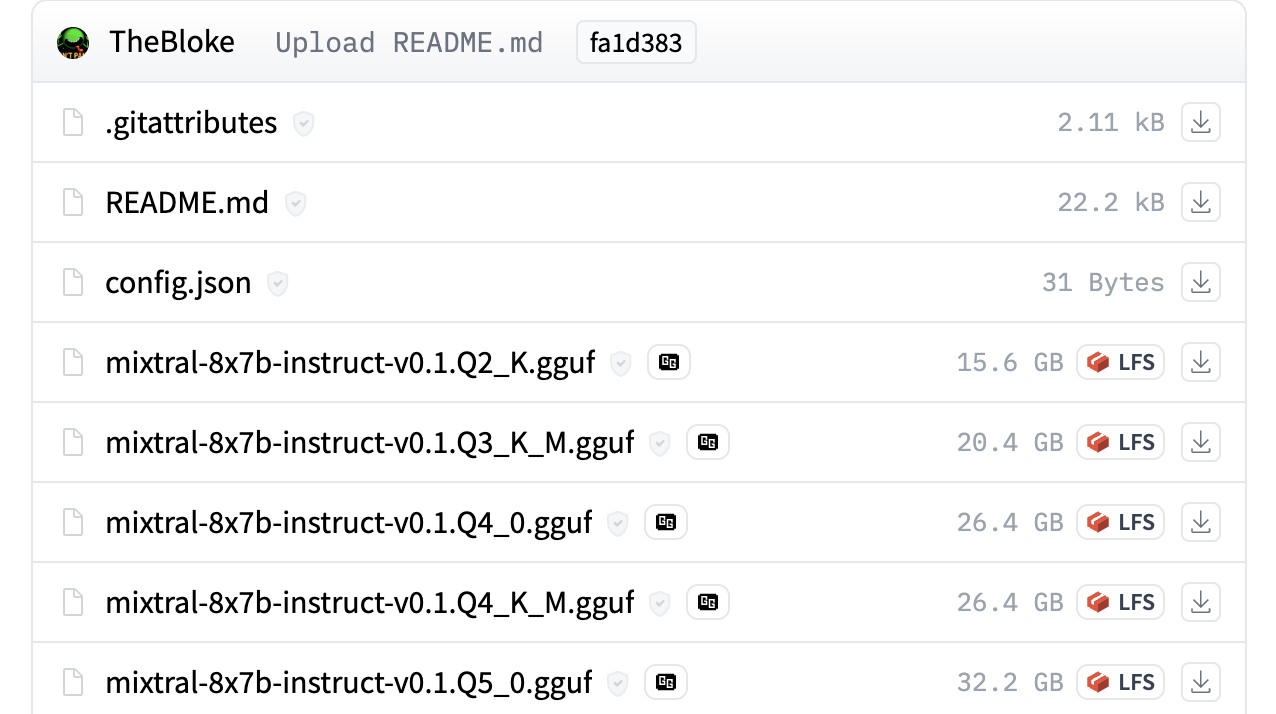
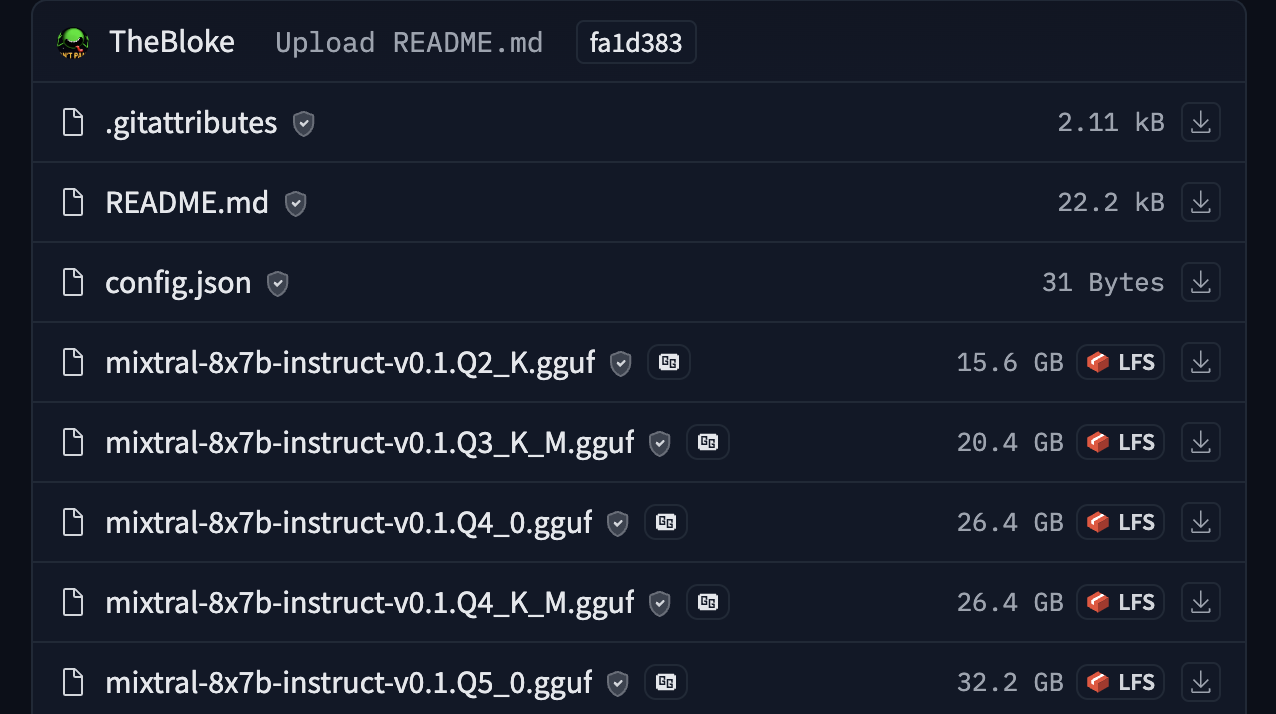
예를 들어 TheBloke/Mixtral-8x7B-Instruct-v0.1-GGUF에서 GGUF 파일이 실제로 어떻게 쓰이는지 볼 수 있어요.
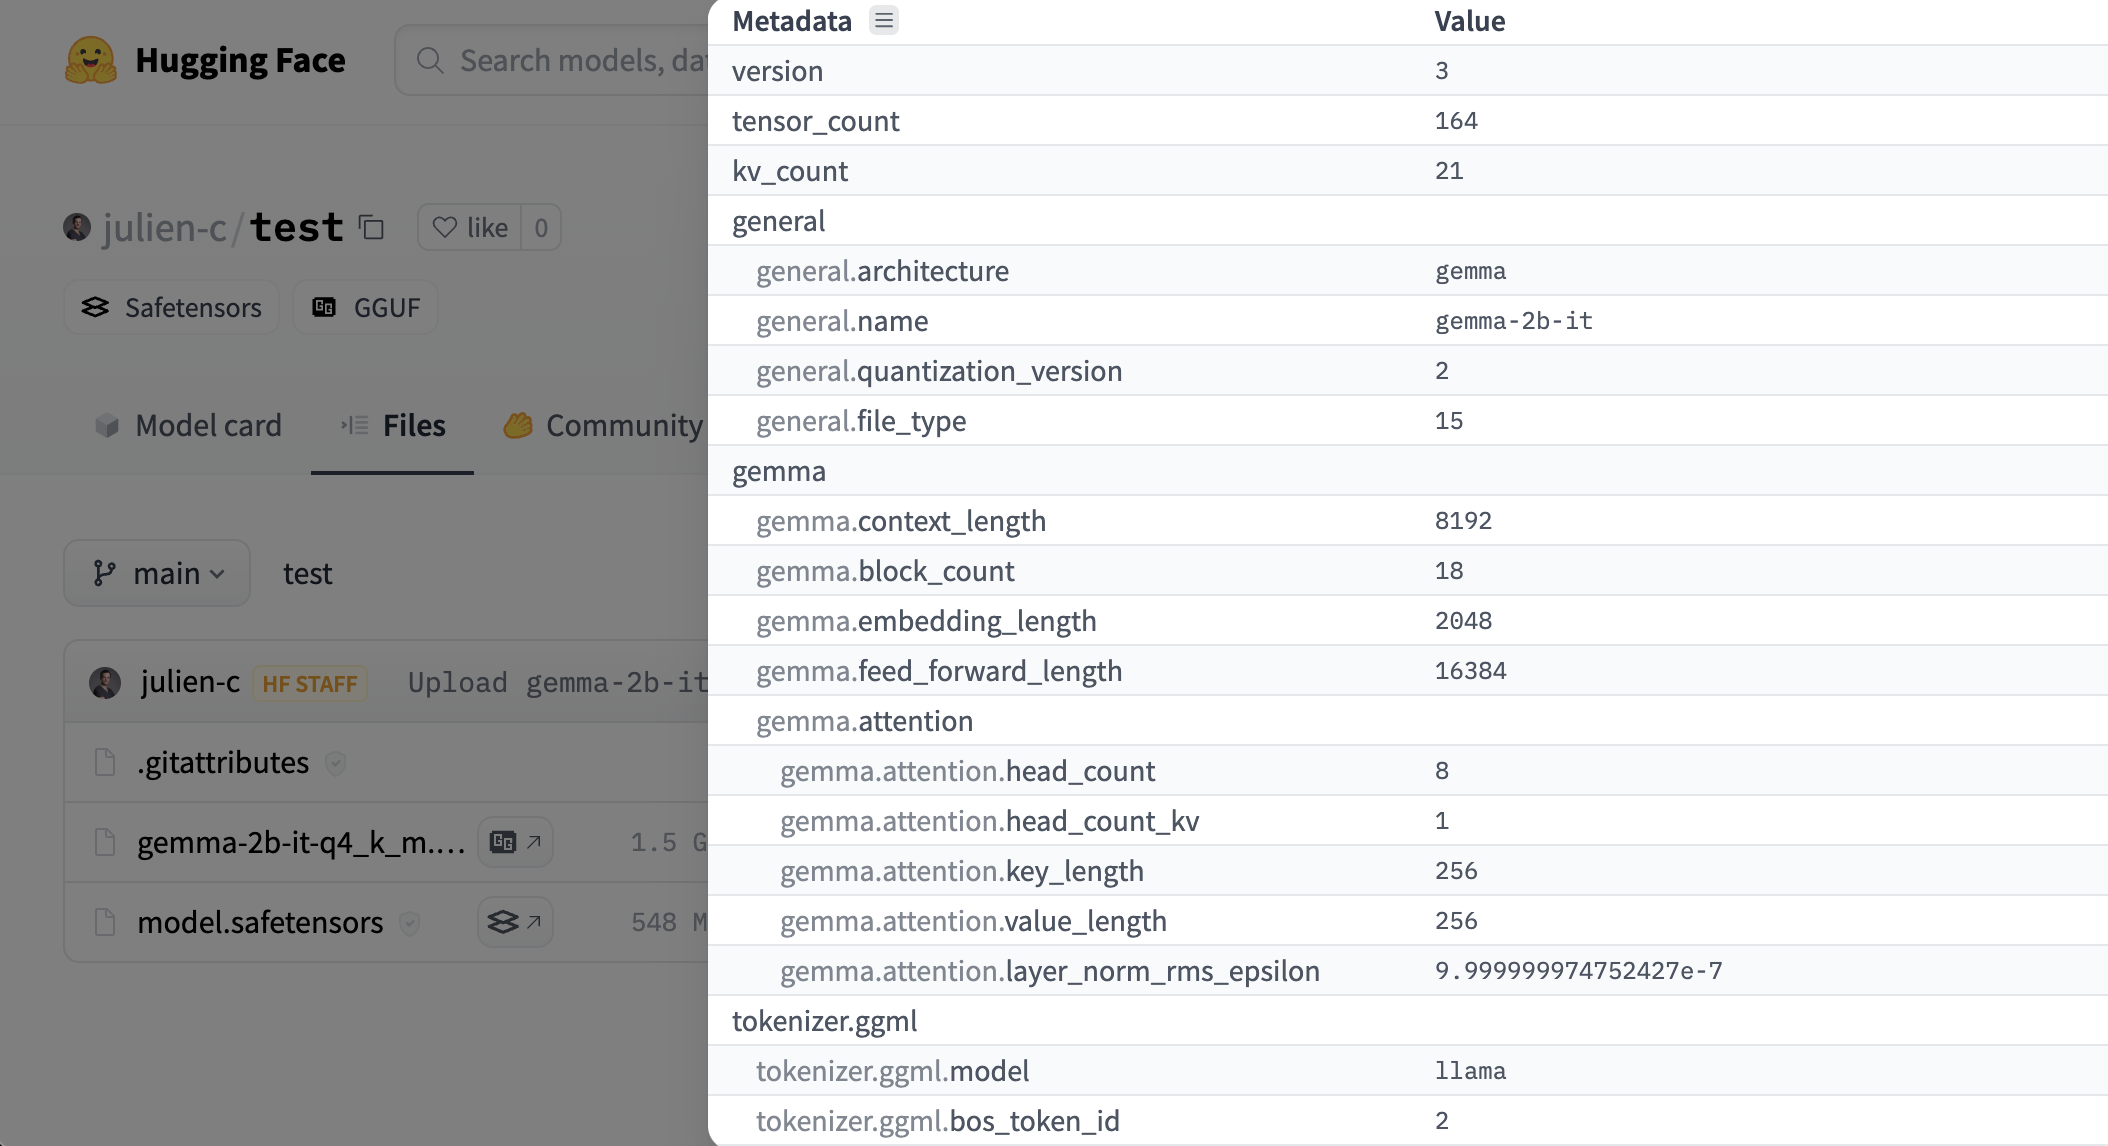
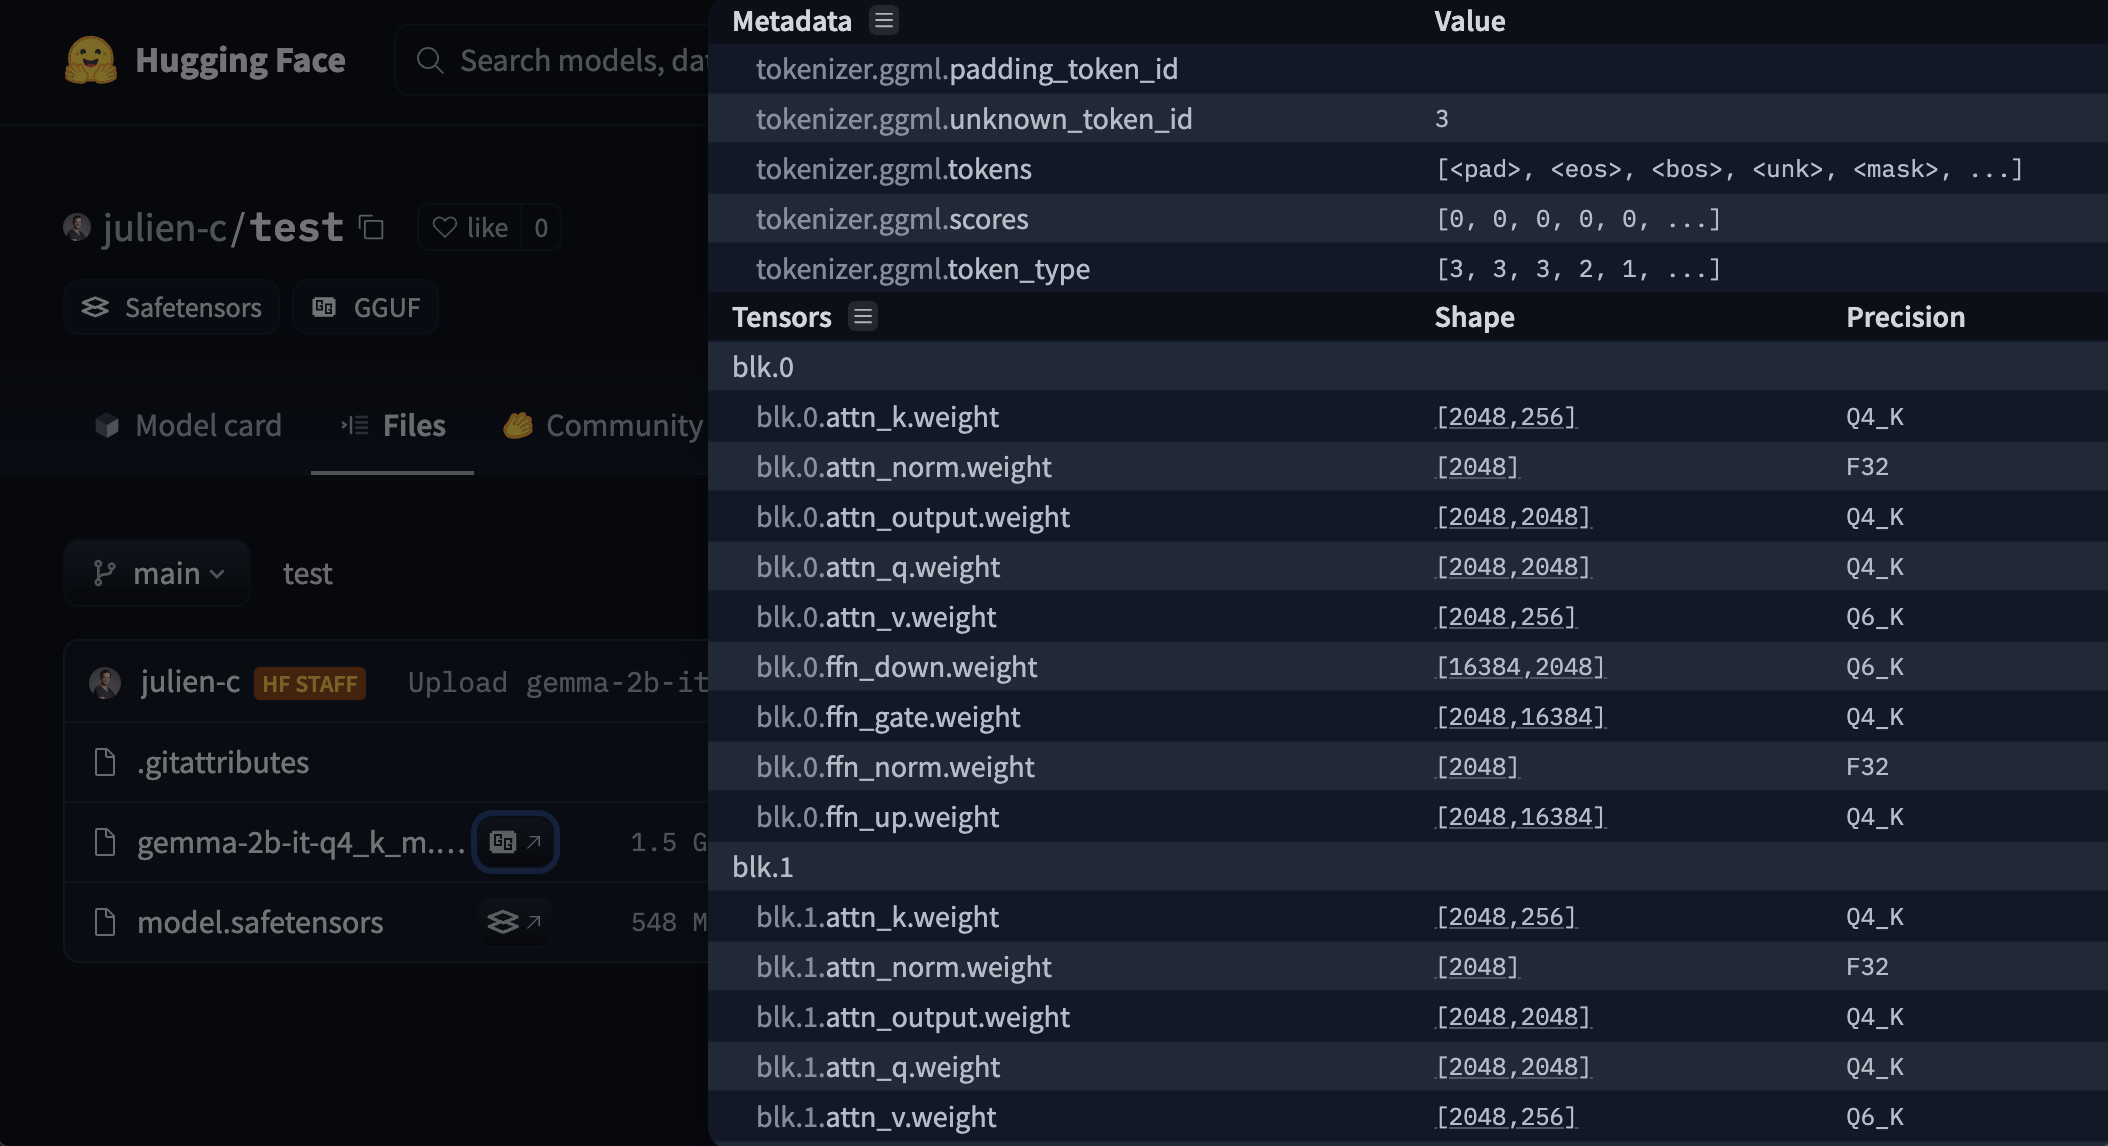
메타데이터 & 텐서 정보 뷰어
Hub에는 GGUF 파일용 뷰어가 있어서 사용자가 메타데이터·텐서 정보(이름, shape, 정밀도)를 확인할 수 있어요. 뷰어는 모델 페이지(예시)와 파일 페이지(예시)에서 사용할 수 있어요.
오픈소스 도구와 사용하기
@huggingface/gguf로 메타데이터 파싱하기
원격 호스팅 파일(예: Hugging Face Hub)에서 동작하는 JavaScript GGUF 파서도 만들었어요.
npm install @huggingface/gguf
import { gguf } from "@huggingface/gguf";
// remote GGUF file from https://huggingface.co/TheBloke/Llama-2-7B-Chat-GGUF
const URL_LLAMA = "https://huggingface.co/TheBloke/Llama-2-7B-Chat-GGUF/resolve/191239b/llama-2-7b-chat.Q2_K.gguf";
const { metadata, tensorInfos } = await gguf(URL_LLAMA);
더 많은 정보는 여기에서 확인할 수 있어요.
양자화 타입 (Quantization Types)
| 타입 | 출처 | 설명 |
|---|---|---|
| F64 | Wikipedia | 64비트 표준 IEEE 754 배정밀도 부동소수점 수. |
| I64 | GH | 64비트 고정폭 정수. |
| F32 | Wikipedia | 32비트 표준 IEEE 754 단정밀도 부동소수점 수. |
| I32 | GH | 32비트 고정폭 정수. |
| F16 | Wikipedia | 16비트 표준 IEEE 754 반정밀도 부동소수점 수. |
| BF16 | Wikipedia | 32비트 IEEE 754 단정밀도 부동소수점 수의 16비트 축약 버전. |
| I16 | GH | 16비트 고정폭 정수. |
| Q8_K | GH | 8비트 양자화(q). 각 블록이 256개 가중치. 중간 결과 양자화에만 사용. 이 양자화 타입에 대해 2-6비트 내적 전부 구현됨. 가중치 공식: w = q * block_scale. |
| I8 | GH | 8비트 고정폭 정수. |
| Q6_K | GH | 6비트 양자화(q). 16개 블록의 슈퍼블록, 각 블록은 16개 가중치. 가중치 공식: w = q * block_scale(8-bit), 가중치당 6.5625비트. |
| Q5_K | GH | 5비트 양자화(q). 8개 블록의 슈퍼블록, 각 블록은 32개 가중치. 가중치 공식: w = q * block_scale(6-bit) + block_min(6-bit), 가중치당 5.5비트. |
| Q4_K | GH | 4비트 양자화(q). 8개 블록의 슈퍼블록, 각 블록은 32개 가중치. 가중치 공식: w = q * block_scale(6-bit) + block_min(6-bit), 가중치당 4.5비트. |
| Q3_K | GH | 3비트 양자화(q). 16개 블록의 슈퍼블록, 각 블록은 16개 가중치. 가중치 공식: w = q * block_scale(6-bit), 가중치당 3.4375비트. |
| Q2_K | GH | 2비트 양자화(q). 16개 블록의 슈퍼블록, 각 블록은 16개 가중치. 가중치 공식: w = q * block_scale(4-bit) + block_min(4-bit), 가중치당 2.625비트. |
| IQ4_NL | GH | 4비트 양자화(q). 256개 가중치의 슈퍼블록. 가중치 w는 super_block_scale & importance matrix로 구함. |
| IQ4_XS | HF | 4비트 양자화(q). 256개 가중치의 슈퍼블록. 가중치 w는 super_block_scale & importance matrix로 구함, 가중치당 4.25비트. |
| IQ3_S | HF | 3비트 양자화(q). 256개 가중치의 슈퍼블록. 가중치 w는 super_block_scale & importance matrix로 구함, 가중치당 3.44비트. |
| IQ3_XXS | HF | 3비트 양자화(q). 256개 가중치의 슈퍼블록. 가중치 w는 super_block_scale & importance matrix로 구함, 가중치당 3.06비트. |
| IQ2_XXS | HF | 2비트 양자화(q). 256개 가중치의 슈퍼블록. 가중치 w는 super_block_scale & importance matrix로 구함, 가중치당 2.06비트. |
| IQ2_S | HF | 2비트 양자화(q). 256개 가중치의 슈퍼블록. 가중치 w는 super_block_scale & importance matrix로 구함, 가중치당 2.5비트. |
| IQ2_XS | HF | 2비트 양자화(q). 256개 가중치의 슈퍼블록. 가중치 w는 super_block_scale & importance matrix로 구함, 가중치당 2.31비트. |
| IQ1_S | HF | 1비트 양자화(q). 256개 가중치의 슈퍼블록. 가중치 w는 super_block_scale & importance matrix로 구함, 가중치당 1.56비트. |
| IQ1_M | GH | 1비트 양자화(q). 256개 가중치의 슈퍼블록. 가중치 w는 super_block_scale & importance matrix로 구함, 가중치당 1.75비트. |
| TQ1_0 | GH | 삼진(ternary) 양자화. |
| TQ2_0 | GH | 삼진(ternary) 양자화. |
| MXFP4 | GH | 4비트 Microscaling Block Floating Point. |
| 레거시 타입 | ||
| Q8_0 | GH | 8비트 반올림 양자화(q). 각 블록이 32개 가중치. 가중치 공식: w = q * block_scale. 레거시 양자화 방식 (오늘날 널리 쓰이지 않음). |
| Q8_1 | GH | 8비트 반올림 양자화(q). 각 블록이 32개 가중치. 가중치 공식: w = q * block_scale + block_minimum. 레거시 양자화 방식 (오늘날 널리 쓰이지 않음). |
| Q5_0 | GH | 5비트 반올림 양자화(q). 각 블록이 32개 가중치. 가중치 공식: w = q * block_scale. 레거시 양자화 방식 (오늘날 널리 쓰이지 않음). |
| Q5_1 | GH | 5비트 반올림 양자화(q). 각 블록이 32개 가중치. 가중치 공식: w = q * block_scale + block_minimum. 레거시 양자화 방식 (오늘날 널리 쓰이지 않음). |
| Q4_0 | GH | 4비트 반올림 양자화(q). 각 블록이 32개 가중치. 가중치 공식: w = q * block_scale. 레거시 양자화 방식 (오늘날 널리 쓰이지 않음). |
| Q4_1 | GH | 4비트 반올림 양자화(q). 각 블록이 32개 가중치. 가중치 공식: w = q * block_scale + block_minimum. 레거시 양자화 방식 (오늘날 널리 쓰이지 않음). |
위 표에 부정확한 점이 있으면 이 파일에 PR을 열어 주세요.
더 알아보기 (Learn more)
- GGUF는 텐서와 표준화된 메타데이터를 함께 인코딩하는 형식으로, 추론에 최적화돼 있어요.
- GGUF 모델은 llama.cpp, LM Studio, GPT4All, Ollama 같은 오픈소스 도구에서 사용할 수 있어요.