
허깅페이스에서 PEFT 사용하기
허깅페이스에서 PEFT 사용하기
🤗 Parameter-Efficient Fine-Tuning (PEFT)은 모델의 모든 파라미터를 파인튜닝하지 않고도 사전 학습된 언어 모델을 다양한 다운스트림 애플리케이션에 효율적으로 적응시키기 위한 라이브러리예요. PEFT 모델은 Hub에서 쉽게 로드하고, 기본 모델과 함께 사용할 수 있답니다.
출처: 문서
본문
🤗 Parameter-Efficient Fine-Tuning (PEFT)은 모델의 모든 파라미터를 파인튜닝하지 않고도 사전 학습된 언어 모델을 다양한 다운스트림 애플리케이션에 효율적으로 적응시키는 라이브러리예요.
Hub에서 PEFT 탐색하기
모델 페이지의 왼쪽 필터에서 PEFT 모델을 찾을 수 있어요.
설치
시작하려면 PEFT 문서의 Quick Tour를 확인해요. 설치는 PEFT 설치 가이드를 따라가요. pip를 통한 한 줄 설치는 다음과 같아요:
$ pip install peft
기존 모델 사용하기
모든 PEFT 모델은 Hub에서 로드할 수 있어요. PEFT 모델을 사용하려면 아래처럼 파인튜닝된 기본 모델도 함께 로드해야 해요. 모든 파인튜닝된 모델은 모델 카드에 기본 모델이 명시돼 있어요.
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import PeftModel, PeftConfig

base_model = "mistralai/Mistral-7B-v0.1"
adapter_model = "dfurman/Mistral-7B-Instruct-v0.2"

model = AutoModelForCausalLM.from_pretrained(base_model)
model = PeftModel.from_pretrained(model, adapter_model)
tokenizer = AutoTokenizer.from_pretrained(base_model)

model = model.to("cuda")
model.eval()
로드한 뒤에는 입력을 tokenizer에 전달해 준비하고, 일반적인 transformers 방식으로 model.generate()를 호출하면 돼요.
inputs = tokenizer("Tell me the recipe for chocolate chip cookie", return_tensors="pt")

with torch.no_grad():
    outputs = model.generate(input_ids=inputs["input_ids"].to("cuda"), max_new_tokens=10)
    print(tokenizer.batch_decode(outputs.detach().cpu().numpy(), skip_special_tokens=True)[0])
다음과 같이 출력돼요:
Tell me the recipe for chocolate chip cookie dough.

1. Preheat oven to 375 degrees F (190 degrees C).
2. In a large bowl, cream together 1/2 cup (1 stick) of butter or margarine, 1/2 cup granulated sugar, and 1/2 cup packed brown sugar.
3. Beat in 1 egg and 1 teaspoon vanilla extract.
4. Mix in 1 1/4 cups all-purpose flour.
5. Stir in 1/2 teaspoon baking soda and 1/2 teaspoon salt.
6. Fold in 3/4 cup semisweet chocolate chips.
7. Drop by
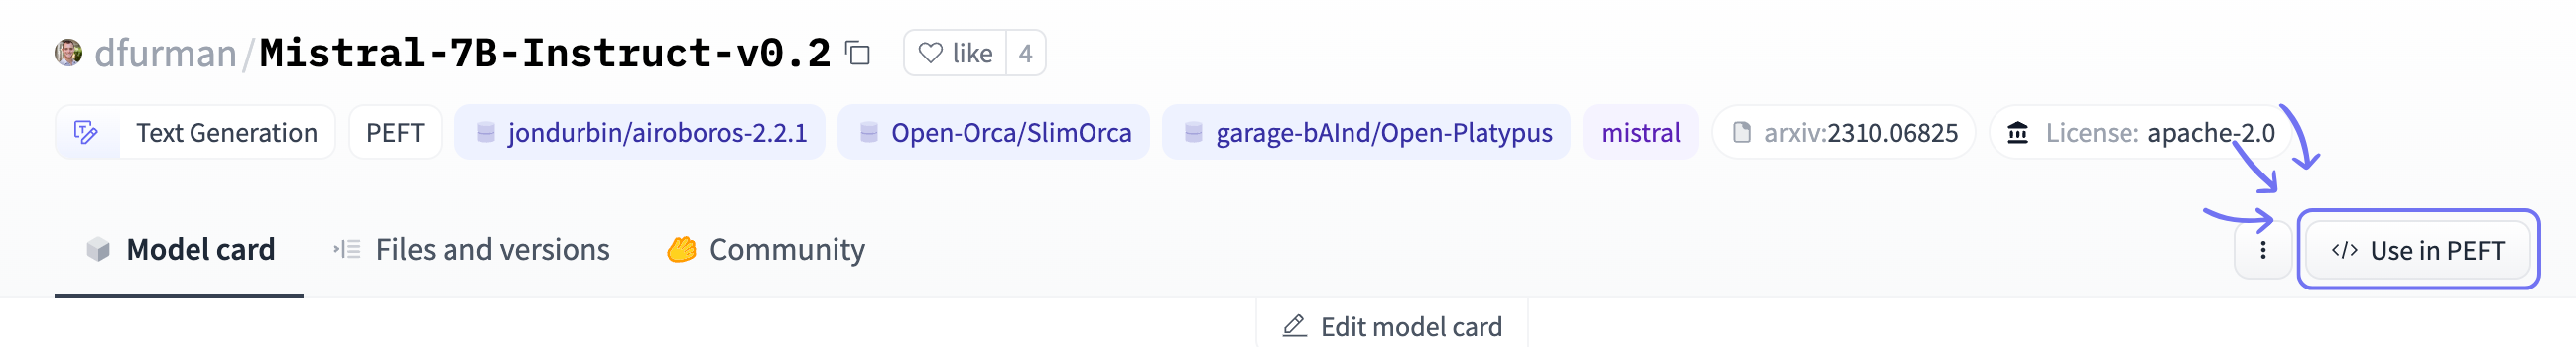
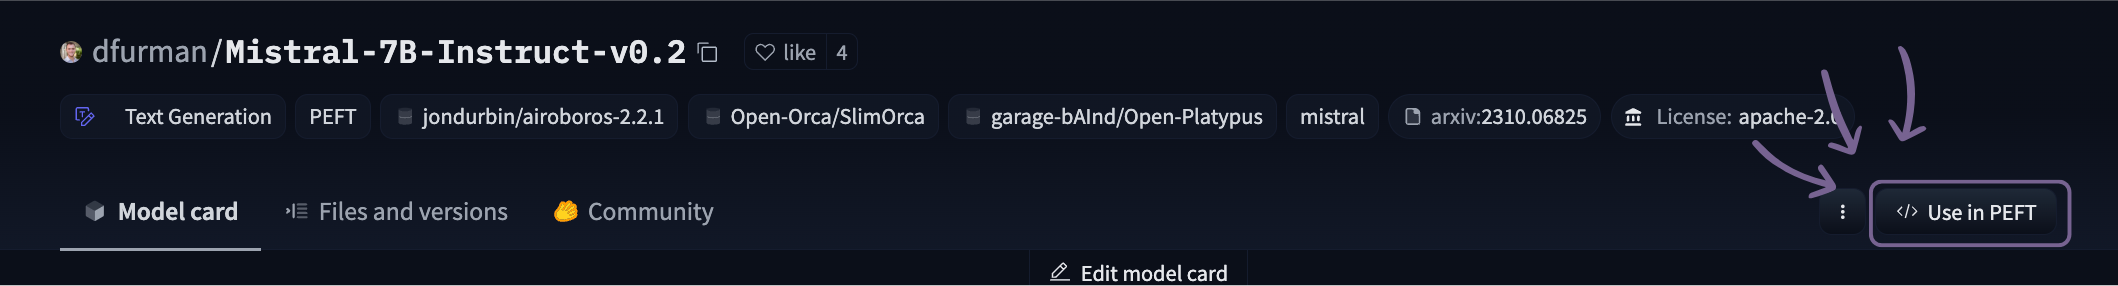
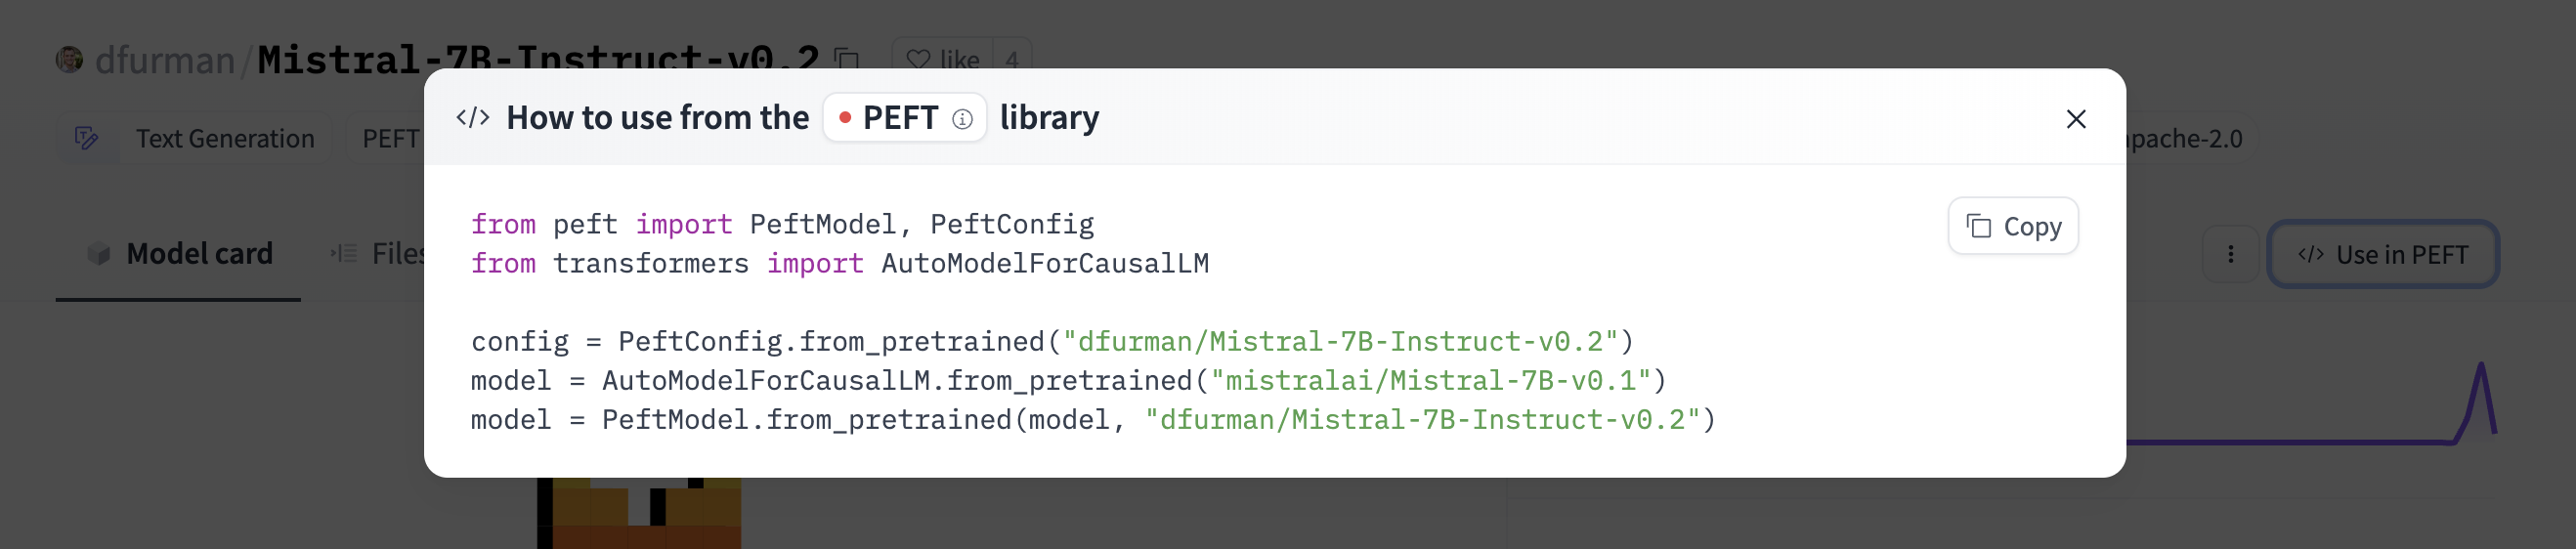
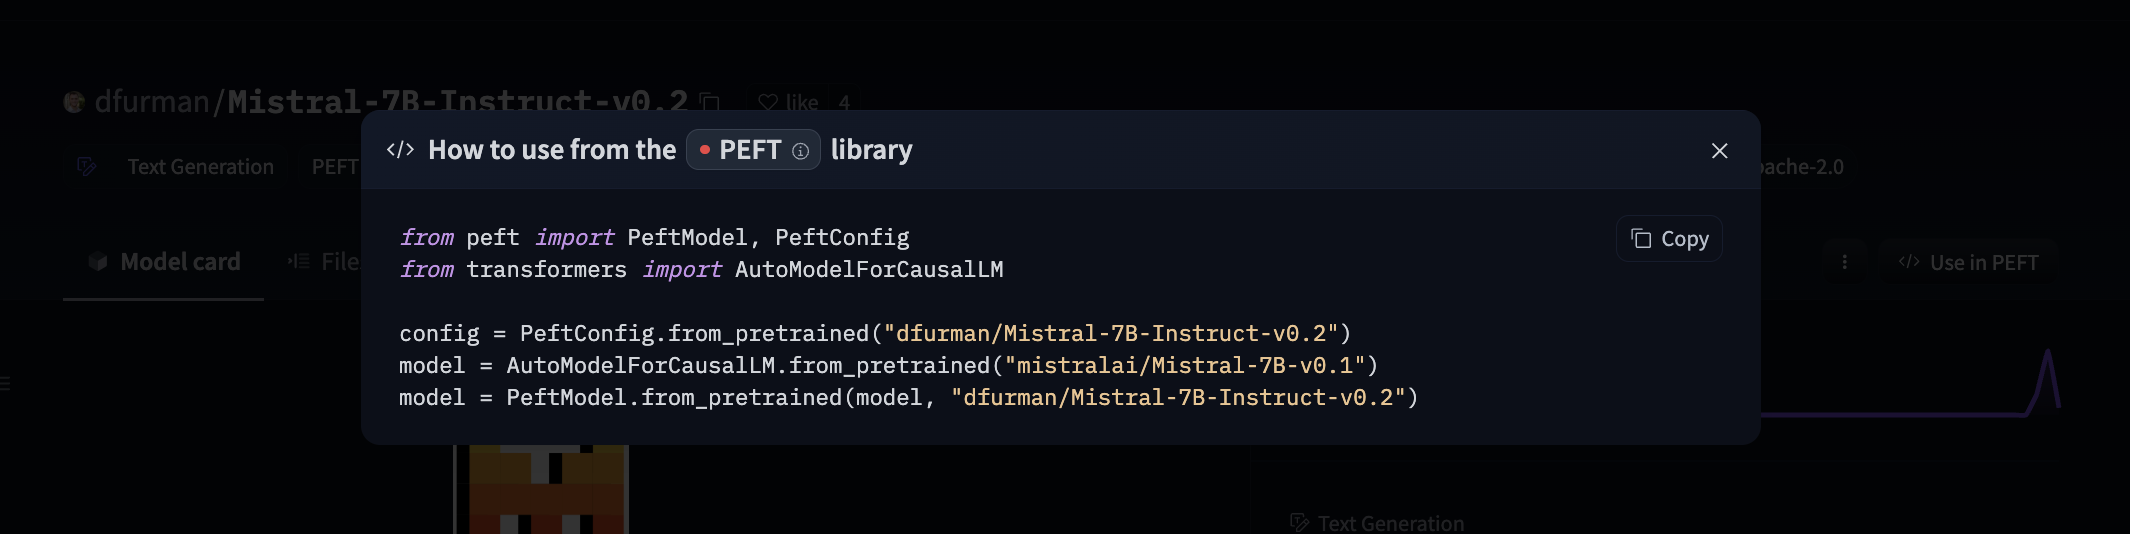
특정 PEFT 모델을 로드하고 싶다면 모델 카드에서 Use in PEFT을 클릭하면 바로 사용할 수 있는 스니펫이 주어져요!
추가 자료
더 알아보기 (Learn more)
- PEFT를 쓰려면 파인튜닝된 어댑터 모델과 함께 기본(base) 모델을 함께 로드해야 해요.
- 모델 카드에서
Use in PEFT을 클릭하면 바로 사용 가능한 스니펫을 얻을 수 있어요.