
GPU Space 사용하기
GPU Space 사용하기 (Using GPU Spaces)
Space 상단 탐색 바의 Settings 버튼으로 Space를 GPU 가속기로 업그레이드할 수 있어요. 사이드 프로젝트로 멋진 데모를 만드는 중이라면 무료 업그레이드를 요청할 수도 있습니다!
출처: 문서
본문
Space 상단 탐색 바의 Settings 버튼을 사용해 Space를 GPU 가속기를 쓰도록 업그레이드할 수 있어요. 사이드 프로젝트용 멋진 데모를 만들고 있다면 무료 업그레이드를 요청할 수도 있습니다!
[!TIP] 장기적으로 HPU, IPU, TPU 같은 비-GPU 하드웨어도 노출하고 싶습니다. 특정 AI 하드웨어에서 실행하고 싶다면 알려주세요(website at huggingface.co).
Space가 GPU에서 실행되기 시작하면 바로 이 배지에서 어떤 하드웨어에서 실행 중인지 볼 수 있어요:
하드웨어 사양 (Hardware Specs)
아래 표에서 다양한 업그레이드 옵션의 사양을 확인할 수 있어요.
CPU
| 하드웨어 (Hardware) | CPU | 메모리 (Memory) | GPU 메모리 | 디스크 (Disk) | 시간당 가격 (Hourly Price) |
|---|---|---|---|---|---|
| CPU Basic | 2 vCPU | 16 GB | - | 50 GB | 무료! (Free!) |
| CPU Upgrade | 8 vCPU | 32 GB | - | 50 GB | $0.03 |
[!NOTE] CPU Basic은 시간당 비용이 없지만, 컴퓨트(Gradio 또는 Docker)에서 실행되는 새 Space를 만들려면 유료 요금제가 필요합니다. Static Space는 누구에게나 무료예요. 자세한 내용은 Spaces Overview를 참고하세요.
GPU
| 하드웨어 (Hardware) | CPU | 메모리 (Memory) | GPU 메모리 | 디스크 (Disk) | 시간당 가격 (Hourly Price) |
|---|---|---|---|---|---|
| Nvidia T4 - small | 4 vCPU | 15 GB | 16 GB | 50 GB | $0.40 |
| Nvidia T4 - medium | 8 vCPU | 30 GB | 16 GB | 100 GB | $0.60 |
| 1x Nvidia L4 | 8 vCPU | 30 GB | 24 GB | 400 GB | $0.80 |
| 4x Nvidia L4 | 48 vCPU | 186 GB | 96 GB | 3200 GB | $3.80 |
| 1x Nvidia L40S | 8 vCPU | 62 GB | 48 GB | 380 GB | $1.80 |
| 4x Nvidia L40S | 48 vCPU | 382 GB | 192 GB | 3200 GB | $8.30 |
| 8x Nvidia L40S | 192 vCPU | 1534 GB | 384 GB | 6500 GB | $23.50 |
| Nvidia A10G - small | 4 vCPU | 15 GB | 24 GB | 110 GB | $1.00 |
| Nvidia A10G - large | 12 vCPU | 46 GB | 24 GB | 200 GB | $1.50 |
| 2x Nvidia A10G - large | 24 vCPU | 92 GB | 48 GB | 1000 GB | $3.00 |
| 4x Nvidia A10G - large | 48 vCPU | 184 GB | 96 GB | 2000 GB | $5.00 |
| Nvidia A100 - large | 12 vCPU | 142 GB | 80 GB | 1000 GB | $2.50 |
| 4x Nvidia A100 | 48 vCPU | 568 GB | 320 GB | 4000 GB | $10.00 |
| 8x Nvidia A100 | 96 vCPU | 1136 GB | 640 GB | 8000 GB | $20.00 |
프로그래밍 방식 하드웨어 구성 (Configure hardware programmatically)
huggingface_hub를 사용해 Space 하드웨어를 프로그래밍 방식으로 구성할 수 있어요. 동적으로 GPU를 할당해야 하는 다양한 사용 사례를 가능하게 합니다.
자세한 내용은 이 가이드를 확인하세요.
프레임워크별 요구사항 (Framework specific requirements)
대부분의 Space는 GPU 업그레이드 후 바로 실행되어야 하지만, 사용하는 머신러닝 프레임워크의 CUDA 버전을 설치해야 하는 경우가 있어요. 개선된 하드웨어를 활용하려면 이 가이드를 따르세요.
PyTorch
내장 CUDA 드라이버와 호환되는 PyTorch 버전을 설치해야 합니다. requirements.txt 파일에 다음 두 줄을 추가하면 동작할 거예요:
--extra-index-url https://download.pytorch.org/whl/cu113
torch
app.py에서 다음 코드를 실행하고 Space 로그의 출력을 확인해 설치가 성공했는지 검증할 수 있어요:
import torch
print(f"Is CUDA available: {torch.cuda.is_available()}")
# True
print(f"CUDA device: {torch.cuda.get_device_name(torch.cuda.current_device())}")
# Tesla T4
많은 프레임워크는 GPU가 있으면 자동으로 사용합니다. 🤗 transformers의 Pipelines, fastai 등이 그렇습니다. 다른 경우이거나 PyTorch를 직접 사용한다면, 연산이 CPU가 아니라 가속기에서 수행되도록 모델과 데이터를 GPU로 옮겨야 할 수 있어요. PyTorch의 .to() 문법을 사용할 수 있습니다. 예:
model = load_pytorch_model()
model = model.to("cuda")
JAX
JAX를 사용한다면 CUDA 호환 패키지가 포함된 URL을 지정해야 해요. requirements.txt 파일에 다음 줄을 추가하세요:
-f https://storage.googleapis.com/jax-releases/jax_cuda_releases.html
jax[cuda11_pip]
jaxlib
그 후 다음 코드의 출력을 Space 로그에서 확인해 설치를 검증할 수 있어요.
import jax

print(f"JAX devices: {jax.devices()}")
# JAX devices: [StreamExecutorGpuDevice(id=0, process_index=0)]
print(f"JAX device type: {jax.devices()[0].device_kind}")
# JAX device type: Tesla T4
Tensorflow
기본 tensorflow 설치가 CUDA 디바이스를 인식해야 합니다. requirements.txt 파일에 tensorflow만 추가하고 app.py에서 다음 코드를 사용해 Space 로그에서 검증하세요.
import tensorflow as tf
print(tf.config.list_physical_devices('GPU'))
# [PhysicalDevice(name='/physical_device:GPU:0', device_type='GPU')]
청구 (Billing)
Spaces 청구는 하드웨어 사용에 기반하며 분 단위로 계산됩니다: Space가 요청된 하드웨어에서 실행되는 매 분마다, Space를 사용하는지 여부와 무관하게 요금이 부과돼요.
Space의 수명주기 동안 Space가 Starting 또는 Running일 때만 청구됩니다. 즉 빌드 중에는 비용이 없어요.
실행 중인 Space가 실패하기 시작하면 자동으로 중단되고 청구도 멈춥니다.
무료 하드웨어에서 실행되는 Space는 오랫동안(예: 이틀) 사용되지 않으면 자동으로 중단됩니다. 업그레이드된 Space는 사용이 없어도 기본적으로 무기한 실행돼요. 이 동작은 Space 설정에서 커스텀 "sleep time"을 설정해 바꿀 수 있습니다. Space 청구를 중단하려면 하드웨어를 CPU basic으로 바꾸거나 일시 중지할 수 있어요.
청구에 대한 추가 정보는 전용 Hub-wide 섹션에서 확인할 수 있어요.
커뮤니티 GPU 그랜트 (Community GPU Grants)
멋진 Space가 있는데 GPU 하드웨어 업그레이드 비용을 충당하는 데 도움이 필요하신가요? 혁신적인 Space를 가진 분들을 돕는 것을 좋아하므로 커뮤니티 GPU 그랜트에 자유롭게 지원해 보세요! 이 신청서는 Space 하드웨어 저장소 설정의 왼쪽 아래 "sleep time settings" 아래에서 찾을 수 있어요:
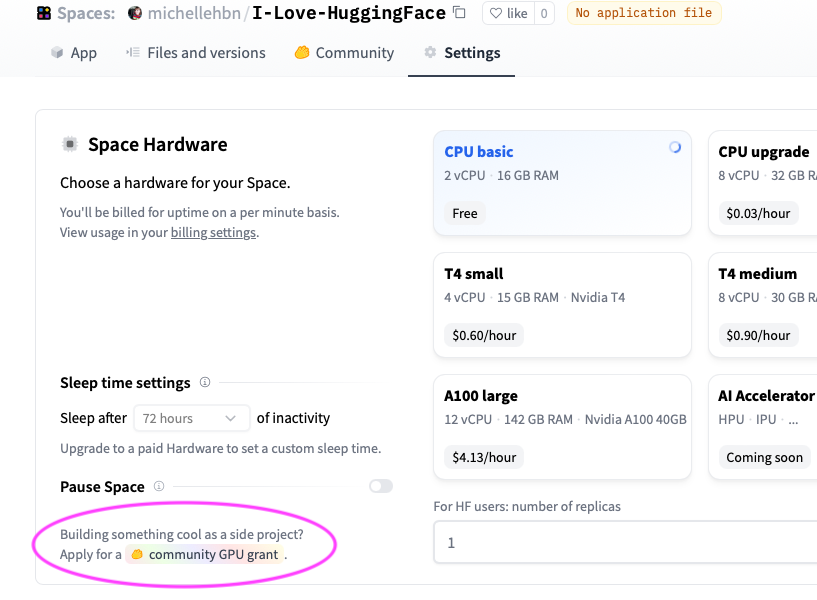
커스텀 sleep time 설정 (Set a custom sleep time)
Space가 기본 cpu-basic 하드웨어에서 실행된다면, 설정된 시간(현재 48시간)보다 오래 비활성이면 절전 모드로 전환됩니다. Space를 방문하는 사람은 누구나 자동으로 재시작해요.
Space가 절대 비활성화되지 않게 하거나 커스텀 sleep time을 설정하려면 유료 하드웨어로 업그레이드해야 합니다.
기본적으로 업그레이드된 Space는 절대 절전 모드로 가지 않아요. 하지만 이 설정을 사용해 업그레이드된 Space가 사용되지 않을 때 유휴(stopped 단계) 상태가 되도록 할 수 있습니다 😴. 절전 중에는 업그레이드된 하드웨어 요금이 부과되지 않습니다. Space는 새 방문자를 받으면 '깨어나거나' 재시작됩니다.
그러면 Spaces 하드웨어 설정에서 다음 인터페이스를 사용할 수 있어요:
다음 옵션을 사용할 수 있습니다:
복제본 (Replicas)
여러 복제본을 요청해 Space를 수평 확장할 수 있어요. Space의 여러 인스턴스에 트래픽을 분산해 가용성과 처리량을 개선합니다. API로 복제본 수를 설정할 수 있어요:
POST https://huggingface.co/api/spaces/{namespace}/{repo}/replicas
Content-Type: application/json

{
  "replicas": 2
}
[!NOTE] 복제본은 업그레이드(유료) 하드웨어에서만 사용할 수 있습니다. 각 복제본은 독립적으로 청구됩니다.
로그·이벤트·메트릭 스트리밍 (Streaming Logs, Events, and Metrics)
SSE(Server-Sent Events)를 통해 Space에서 실시간 로그, 상태 이벤트, 메트릭을 스트리밍할 수 있어요:
- 빌드 또는 실행 로그:
GET /api/spaces/{namespace}/{repo}/logs/{build|run} - 상태 이벤트:
GET /api/spaces/{namespace}/{repo}/events - 메트릭:
GET /api/spaces/{namespace}/{repo}/metrics
이 엔드포인트들은 인증이 필요하며 SSE 프로토콜로 데이터를 반환합니다.
logs 엔드포인트는 선택적 tail 쿼리 파라미터(음이 아닌 정수)를 받아 응답을 마지막 N줄의 로그로 제한할 수 있어요:
GET /api/spaces/{namespace}/{repo}/logs/{build|run}?tail=100
Space 일시 중지 (Pausing a Space)
저장소 설정에서 Space를 pause할 수 있어요. "paused" Space는 보류 상태가 되어 수동으로 재시작할 때까지 리소스를 사용하지 않으며, 일시 중지된 Space는 소유자만 재시작할 수 있습니다. 일시 중지된 시간은 청구되지 않아요.
더 알아보기 (Learn more)
GPU Space는 Settings에서 업그레이드하며, CPU/GPU 하드웨어별 사양과 시간당 가격으로 구성돼요. PyTorch·JAX·TensorFlow는 CUDA 호환 버전 설치가 필요하고(requirements.txt에 패키지 지정), 모델은 .to("cuda")로 옮길 수 있어요. 청구는 실행 분 단위이며, 커스텀 sleep time, 복제본, SSE 로그 스트리밍, 일시 중지 등도 지원합니다. 커뮤니티 GPU 그랜트에 지원해 비용을 충당할 수도 있어요.