
복합 타입(Array, Map) 처리
복합 타입(Array, Map) 처리 (Complex Type (Array, Map) Handling)
Apache Pinot에서 복합 타입을 처리하는 방법을 다루는 페이지예요.
본문
일반적으로 수집되는 데이터는 복잡한 구조를 가져요. 예를 들어 Avro 스키마는 record와 array가 있고, JSON은 object와 array를 지원해요.
Apache Pinot의 데이터 모델은 기본 데이터 타입(int, long, float, double, BigDecimal, string, bytes 등)과 원시 타입 배열 같은 제한된 다중 값 타입을 지원해요. 단순 데이터 타입은 좋은 쿼리 성능을 위한 빠른 인덱싱 구조를 만들 수 있게 하지만, 복잡한 구조를 어느 정도 처리해야 해요.
복합 타입 처리에는 세 가지 옵션이 있어요:
- 복합 타입 데이터를 JSON 문자열로 변환한 후 JSON 인덱스를 구축.
- 객체 컬럼을 한 필드로 유지해야 하지만 자주 조회되는 키가 컬럼형 저장과 보조 인덱스를 필요로 할 때
OPEN_STRUCT사용. - 수집 구성의 내장 복합 타입 처리 규칙 사용.
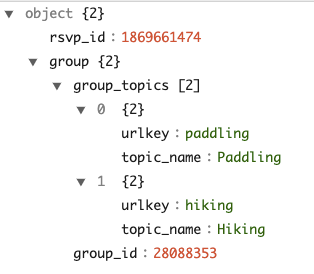
이 페이지에서는 이 세 가지 접근법으로 복합 타입 구조를 처리하는 방법을 보여 줘요. Meetup events Quickstart 예제의 group 필드로 구성된 예제 데이터를 처리할 거예요.
이 객체는 두 자식 필드를 가지며, 자식 group은 객체 타입 요소로 된 중첩 배열이에요.
JSON 인덱싱
Apache Pinot은 컬럼의 값 조회와 필터링을 가속화하는 강력한 JSON 인덱스를 제공해요. 복합 타입 객체 group을 JSON으로 변환하려면 테이블 구성에 다음을 추가하세요.
{
    "ingestionConfig":{
      "transformConfigs": [
        {
          "columnName": "group_json",
          "transformFunction": "jsonFormat(\"group\")"
        }
      ],
    },
    ...
    "tableIndexConfig": {
    "loadMode": "MMAP",
    "noDictionaryColumns": [
      "group_json"
    ],
    "jsonIndexColumns": [
      "group_json"
    ]
  },

}
transformConfigs 구성은 객체 group을 JSON 문자열 group_json으로 변환하고, jsonIndexColumns 구성으로 JSON 인덱싱을 만듭니다. 전체 스펙은 meetupRsvpJson_realtime_table_config.json을 참고하세요.
또한 group은 SQL 예약어이므로 transformFunction에서 인용 부호로 감싸야 해요.
참고
columnName은 소스 JSON 데이터의 어느 필드와도 같은 이름을 쓸 수 없어요. 예를 들어 소스 데이터에group필드가 있고 그 필드의 데이터를 저장 전에 변환하고 싶다면, 대상 컬럼 이름은group_json처럼 다른 이름이어야 해요.
참고 스키마 상
group_json필드의maxLength를 걱정할 필요는 없어요.JSON데이터 타입은maxLength가 없고 잘리지 않기 때문이에요.JSON이 내부적으로 문자열로 저장되더라도 마찬가지예요.
스키마는 다음과 같아요:
{
  {
      "name": "group_json",
      "dataType": "JSON",
    }
    ...
}
전체 스펙은 json_meetupRsvp_schema.json을 참고하세요.
이렇게 하면 group 아래 중첩 필드를 쿼리할 수 있어요. 지원되는 JSON 함수에 대한 자세한 내용은 가이드를 참고하세요.
OPEN_STRUCT 스토리지와 키별 인덱스
소스 필드가 키 집합이 시간에 따라 진화하는 객체나 맵이지만, Pinot이 가장 중요한 키를 표준 컬럼으로 저장하길 원할 때 OPEN_STRUCT를 사용하세요.
Pinot은 OPEN_STRUCT 컬럼을 두 계층으로 저장해요:
- Dense 키는
<column>$<key>라는 구체화된 자식 컬럼이 돼요. - 나머지 키는
<column>$__sparse__라는 하나의 희소 JSON 컬럼으로 묶여요.
Pinot은 다음 순서로 어떤 키가 dense가 될지 결정해요:
denseKeys에 나열된 키는 항상 구체화돼요.- 다른 키는 채움률(fill rate)이
denseKeyMinFillRate(기본값0.5) 이상이면 구체화돼요. maxDenseKeys가 허용하는 것보다 더 많은 키가 조건을 만족하면 Pinot은 채움률이 가장 높은 키만 dense로 유지하고 나머지는 희소 JSON 컬럼에 써요.
Dense 키는 Pinot의 표준 컬럼 인프라를 재사용하므로, 각 구체화된 키는 forward index를 얻고 valueFieldConfigs를 통해 dictionary, inverted, range, bloom-filter 동작에 대한 검증된 키별 설정도 사용할 수 있어요. dense 키를 명시적으로 구성하지 않으면 Pinot은 그 키에 대해 dictionary 인코딩과 inverted 인덱스를 기본으로 사용해요.
스키마 정의
객체 컬럼을 OPEN_STRUCT로 선언하세요. childFieldSpecs는 선택이지만, 일부 키가 항상 특정 타입을 유지해야 할 때 유용해요:
{
  "complexFieldSpecs": [
    {
      "name": "attributes",
      "dataType": "OPEN_STRUCT",
      "fieldType": "COMPLEX",
      "childFieldSpecs": {
        "customerId": {
          "name": "customerId",
          "dataType": "STRING",
          "fieldType": "DIMENSION"
        },
        "country": {
          "name": "country",
          "dataType": "STRING",
          "fieldType": "DIMENSION"
        }
      }
    }
  ]
}
Dense 키와 키별 인덱스 구성
fieldConfigList의 필드 indexes 객체에 open_struct 항목을 추가하세요:
{
  "fieldConfigList": [
    {
      "name": "attributes",
      "indexes": {
        "open_struct": {
          "denseKeys": ["customerId", "country"],
          "ignoredKeys": ["debug", "internalTrace"],
          "denseKeyMinFillRate": 0.5,
          "maxDenseKeys": 32,
          "sparseJsonIndex": true,
          "valueFieldConfigs": [
            {
              "name": "customerId",
              "indexes": {
                "inverted": {}
              }
            },
            {
              "name": "country",
              "indexes": {
                "bloom": {}
              }
            }
          ]
        }
      }
    }
  ]
}
수집 중 Pinot이 버려야 하는 객체 키에는 ignoredKeys를 사용하세요. ignored 키는 dense 자식 컬럼으로 구체화되지 않고, 희소 컬럼에도 쓰이지 않으며, 쿼리할 수도 없어요. ignored 키는 denseKeys, valueFieldConfigs, 또는 스키마의 childFieldSpecs에도 나타나면 안 돼요.
OPEN_STRUCT 키 쿼리
item 연산자로 키에 접근하세요. 같은 구문이 프로젝션, 필터, 집계에서 동작해요:
SELECT
  attributes['customerId'],
  MIN(attributes['customerId']),
  MAX(attributes['customerId']),
  DISTINCTCOUNT(attributes['customerId'])
FROM events
WHERE attributes['country'] IN ('US', 'CA')
GROUP BY attributes['customerId']
구체화된 키에 대해 Pinot은 생성된 자식 컬럼을 읽고 그 dictionary, inverted, range, 또는 다른 구성된 인덱스를 사용할 수 있어요. 키별 인덱스 필터링은 등호·부등호, IN, NOT IN, 범위, IS NULL, IS NOT NULL을 지원해요. 필터가 이 경로를 사용하면 EXPLAIN PLAN은 delegateTo:per_key_index를 보고해요.
공유 희소 컬럼에 저장된 키도 item 연산자로 사용할 수 있어요. Pinot은 각 희소 키를 가상 타입 데이터 소스로 노출하므로, 프로젝션·필터·그룹핑·집계가 dense 키와 같은 SQL 구문을 사용해요. 희소 키는 기본적으로 스캔 기반 실행을 사용해요. 희소 컬럼에 JSON 인덱스를 만들려면 sparseJsonIndex를 true로 설정하세요. Pinot은 호환되는 문자열 키 등호·IN 조건에 이를 사용할 수 있고, 다른 조건은 계속 가상 데이터 소스를 스캔해요.
문서에 없는 키는 타입의 기본 null 값을 반환하며, null 처리가 활성화되면 null로 표시돼요. 키가 전체 세그먼트에 없는 경우에도 같은 규칙이 적용돼요. Pinot은 childFieldSpecs의 키 선언 타입과 defaultNullValue를 사용하며, 선언되지 않은 키는 표준 기본값을 가진 단일 값 STRING 필드를 사용해요. null 처리가 활성화되면 조회는 NULL을 반환하고 IS NULL은 모든 문서와 일치하며 값 조건은 null과 일치하지 않아요. null 처리가 비활성화되면 프로젝션과 조건은 구성되거나 타입별 기본값을 대신 보게 돼요. 예를 들어 없는 선언 STRING 키가 "defaultNullValue": "N/A"를 가지면 attributes['key'] = 'N/A'는 그 세그먼트의 모든 문서와 일치해요.
참고:
OPEN_STRUCT는 단일 값OPEN_STRUCT컬럼에 대한 필드 수준 인덱스예요.childFieldSpecs에 나열되지 않은 키도 Pinot이 수집할 수 있어요. 가능할 때 관찰된 값에서 저장 타입을 추론해요.ignoredKeys변경은 새로 수집되는 데이터에만 영향을 줘요. 기존 봉인 세그먼트는 이전 구성으로 수집된 값을 유지해요.- 스키마 필드가
OPEN_STRUCT를 사용하면, Pinot이 생성된 자식 컬럼 이름에$를 사용하므로$는 스키마 컬럼 이름의 예약 문자가 돼요. - 정확한 스키마 JSON은 스키마 레퍼런스, 전체
open_struct구성 표면은 테이블 레퍼런스를 참고하세요.
수집 구성으로 평탄화 및 언네스트
JSON 인덱싱은 복합 타입을 처리하는 편리한 방법이지만 몇 가지 한계가 있어요:
- JSON 필드로 group by나 order by 하는 것은 비효율적이에요. GROUP BY와 ORDER BY 절에서 값을 추출하려면
JSON_EXTRACT_SCALAR가 필요해 함수 평가를 호출하기 때문이에요. DISTINCTCOUNTMV같은 Pinot의 다중값 컬럼 함수와 동작하지 않아요.
대안으로, Pinot 0.8부터 수집 구성의 복합 타입 처리를 사용해 복잡한 구조를 평탄화(flatten)·언네스트(unnest)해 원시 타입으로 변환할 수 있어요. 그러면 복합 타입 데이터를 평탄화된 Pinot 테이블로 줄이고 SQL로 쿼리할 수 있어요. 내장 처리 규칙으로 Flink나 Spark 같은 다른 컴퓨팅 프레임워크에서 ETL 잡을 쓸 필요가 없어요.
이 복합 타입을 처리하려면 ingestionConfig에 complexTypeConfig 구성을 추가할 수 있어요. 예:
{
  "ingestionConfig": {
    "complexTypeConfig": {
      "delimiter": ".",
      "fieldsToUnnest": ["group.group_topics"],
      "collectionNotUnnestedToJson": "NON_PRIMITIVE"
    }
  }
}
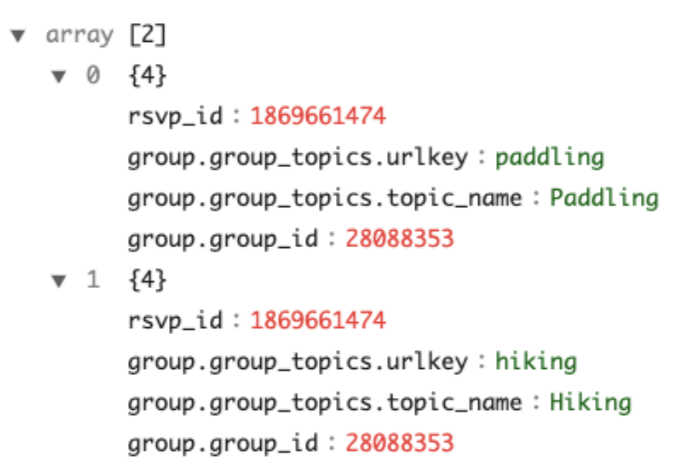
complexTypeConfig로 모든 맵 객체는 자동으로 직접 필드로 평탄화돼요. unnestFields로 중첩 컬렉션이 있는 레코드는 여러 레코드로 언네스트돼요. 예를 들어 시작 부분의 예제는 이 구성으로 두 행으로 변환돼요.
참고:
group아래 중첩 필드group_id는group.group_id로 평탄화돼요. 구분자의 기본값은.이에요.complexTypeConfig아래delimiter구성을 지정해 다른 구분자를 선택할 수 있어요. 이 평탄화 규칙은 언네스트될 컬렉션의 맵에도 적용돼요.group아래 중첩 배열group_topics는 최상위로 언네스트되고 출력을 두 행 컬렉션으로 변환해요.group_topics내 중첩 필드와 결국 최상위 필드group.group_topics.urlkey의 처리를 주목하세요. 언네스트할 모든 컬렉션은fieldsToUnnest구성에 포함되어야 해요.fieldsToUnnest에 지정되지 않은 컬렉션은 JSON 문자열로 직렬화되는데, 기본적으로 다중 값 컬럼으로 수집되는 원시 값 배열은 제외돼요. 이 동작은collectionNotUnnestedToJson구성으로 정의되며 다음 값을 가져요:NON_PRIMITIVE- 배열을 다중 값 컬럼으로 변환. (기본값)ALL- 원시 값 배열을 JSON 문자열로 변환.NONE- 아무 변환도 하지 않음.
테이블 구성의 전체 스펙은 여기, 테이블 스키마는 여기에서 볼 수 있어요.
다음 SQL 쿼리로 원시 값을 가진 테이블을 쿼리할 수 있어요:
SELECT "group.group_topics.urlkey",
       "group.group_topics.topic_name",
       "group.group_id"
FROM meetupRsvp
LIMIT 10
참고
.은 SQL 예약 문자이므로 쿼리에서 평탄화된 컬럼을 인용 부호로 감싸야 해요.
Avro 스키마와 JSON 데이터에서 Pinot 스키마 추론
복합 구조가 있으면 Pinot 스키마를 수동으로 파악하기 어렵고 지루할 수 있어요. 스키마 추론을 돕기 위해 Pinot은 Avro 스키마나 JSON 데이터를 입력으로 받아 추론된 Pinot 스키마를 출력하는 유틸리티 도구를 제공해요.
Avro 스키마에서 Pinot 스키마를 추론하려면 다음 같은 명령을 사용할 수 있어요:
bin/pinot-admin.sh AvroSchemaToPinotSchema \
  -timeColumnName fields.hoursSinceEpoch \
  -avroSchemaFile /tmp/test.avsc \
  -pinotSchemaName myTable \
  -outputDir /tmp/test \
  -fieldsToUnnest entries
complexTypeConfig의 것과 같은 fieldsToUnnest 같은 구성을 입력할 수 있어요. 이렇게 하면 Avro 스키마에 복합 타입 처리 규칙을 시뮬레이션하고 outputDir에 지정된 파일에 Pinot 스키마를 출력해요.
마찬가지로 JSON 객체 파일에서 Pinot 스키마를 추론하려면 다음 같은 명령을 사용할 수 있어요:
bin/pinot-admin.sh JsonToPinotSchema \
  -timeColumnName hoursSinceEpoch \
  -jsonFile /tmp/test.json \
  -pinotSchemaName myTable \
  -outputDir /tmp/test \
  -fieldsToUnnest payload.commits
이 실행의 예제는 이 PR에서 확인할 수 있어요.