
비용과 지능 최적화하기
비용과 지능 최적화하기 (Optimizing for cost and intelligence)
워크로드가 프로토타입에서 프로덕션으로 넘어가면 비용은 가장 중요한 설계 제약 조건이 돼요. 가장 뛰어난 모델은 규모가 커지면 너무 비쌀 수 있고, 가장 저렴한 모델은 품질이 부족할 수 있죠. 비용을 잘 관리하려면 각 비용 레버(cost lever)가 출력 품질에 어떤 영향을 주는지 이해해야 해요. 일부 레버는 품질을 맞바꾸는 대가가 있는 반면, 어떤 레버는 전혀 그렇지 않거든요. 클로드 플랫폼에서는 비용과 지능 사이의 트레이드오프를 직접 조절할 수 있어요. 요청마다 모델, effort 수준, 아키텍처를 직접 고르면, 워크로드를 비용 대비 지능 프런티어(frontier)의 거의 어느 지점에든 놓을 수 있어요.
출처: 문서
본문
비용과 지능은 보통 한쪽이 다른 한쪽을 사는 프런티어로 그려져요. 이 페이지의 첫 번째 레버 그룹은 품질을 건드리지 않고 비용만 줄여 워크로드를 그 프런티어 쪽으로 옮겨요. 두 번째 그룹만이 그 프런티어를 따라 이동해요:
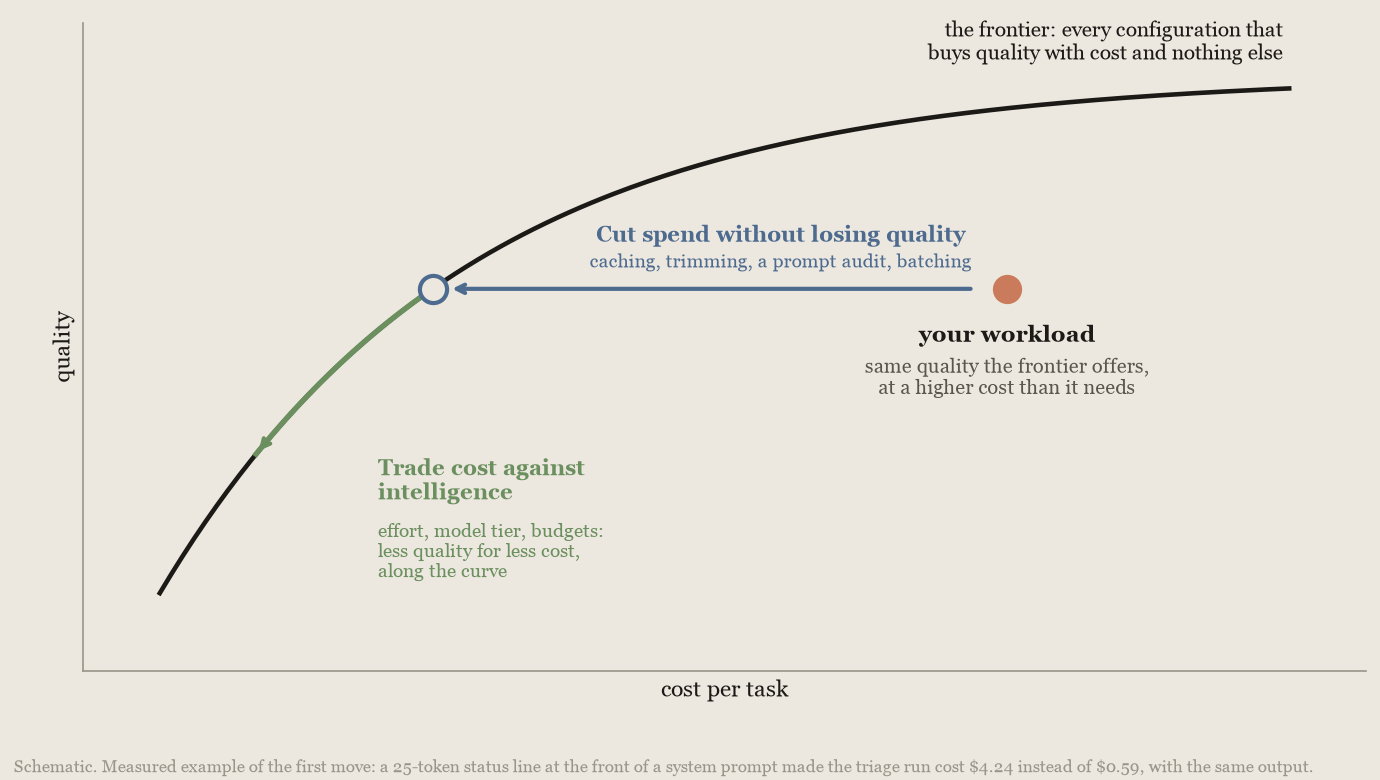
레버에는 두 종류가 있어요:
- **공짜 승리(Free wins)**는 품질을 건드리지 않고 비용만 줄여요: 프롬프트 캐싱(prompt caching), 토큰 위생(token hygiene), 실행 중인 모델에 대한 프롬프트 감사, 최대 24시간 기다릴 수 있는 작업에 50% 할인이 적용되는 배치 처리(batch processing), 그리고 최후의 방어선 역할을 하는 워크스페이스 지출 한도가 있어요.
- **트레이드오프(Tradeoffs)**는 비용을 지능과 맞바꿔요: 모델 선택, effort, 출력 상한과 작업 예산, 그리고 다중 모델 아키텍처가 여기에 속해요.
각 레버마다 측정된 결과와 언제 효과가 있는지에 대한 규칙이 함께 제공돼요. Anthropic의 측정에서 프롬프트 캐싱은 압도적으로 가장 큰 레버였어요. 이 가이드의 벤치마크에서 에이전트 루프 비용을 2.7배에서 5.3배 줄였고, 작은 트리아지 에이전트의 청구액을 83%(입력 트리밍을 더하면 88%) 줄였어요. 다중 모델 레버는 더 좁아요. 두 번째 모델은 어드바이저(advisor)와 오케스트레이터(orchestrator)라는 두 가지 형태로 효과가 있었어요.
여기서 시작하기 (Start here)
자신의 상황에 맞는 행을 찾아보세요.
| 상황 | 해야 할 일 | 자세히 보기 |
|---|---|---|
| 모든 워크로드, 모든 모델 | 프롬프트 캐싱을 켜고 불필요한 토큰을 정리하세요. 둘 다 공짜예요 | 반복 컨텍스트 캐싱 · 토큰 정리 |
| 턴 사이에 사람이 기다리는 경우 | 약 20턴 중 1턴이 5분에서 1시간 사이의 대기 뒤에 오고, 1시간을 넘는 간격이 드물다면 1시간 캐시 지속 시간을 사용하세요. Claude Fable 5.1에서는 대기가 몇 분이면 5분 캐시를 유지하고, 대기가 1시간에 가까워지면 1시간 지속 시간을 구매하세요 | 캐시 지속 시간 고르기 |
| 비용은 너무 높고 품질은 괜찮은 경우 | 현재 모델에서 effort를 낮춰 보세요 | Effort 조정 |
| 최신 모델을 쓰지 않는 경우 | 업그레이드하세요. 현재 모델이 더 많은 작업을 해결하며, 해결된 작업당 비용은 약 40% 낮은 것에서 20% 높은 것까지예요 | 모델 업그레이드 |
| 모델을 고르거나 바꾸는 중인 경우 | 토큰당이 아니라 완료된 작업당 비용으로 비교하세요 | 모델 비교 |
| 품질이 충분하지 않은 경우 | effort를 낮췄다면 복원하고, 그렇지 않으면 한 단계 위 모델을 low effort로 시도하세요 |
Effort 조정 · 모델 비교 |
시도가 stop_reason: max_tokens로 끝나는 경우 |
max_tokens를 올리세요. 64,000이 기본 effort에서 측정된 14,000턴 중 2턴을 제외하고 모두 처리했고, 128,000은 해결된 작업당 추가 비용이 없어요 |
예산 설정 |
| 출력을 검증할 수 있는 경우(테스트, 검증기) | 모든 것을 낮은 effort로 실행하고 실패한 것만 high로 다시 실행하세요. 측정된 코딩 벤치마크에서 약 절반의 비용으로 통과율이 유지됐어요 |
실패 재실행 |
| 몇 번의 매우 비싼 실행이 있는 에이전트 루프 | 작업 예산(베타, 지원 모델 표 참고), Claude Managed Agents 세션 예산, 워크스페이스 지출 한도를 설정하세요 | 예산 설정 |
| 저비용 모델이 어려운 결정에서만 막히는 경우 | 프런티어 어드바이저를 추가하세요. 어드바이저가 실행자보다 훨씬 비싸게 책정되고 실제로 자문받을 때 효과가 있으므로, 먼저 어드바이저 모델을 low effort로 따로 책정하고 자문률을 측정하세요 |
어드바이저 전략 |
| 작업이 하나의 컨텍스트 창을 넘어서는 경우 | 파티션(분할)을 저비용 워커에게 위임하세요 | 오케스트레이터 전략 |
이 결과는 Anthropic 내부 측정(참조 벤치마크)이며 방향성을 보여주는 것이지 보장이 아니에요. 그러니 4단계 방법으로 자신의 워크로드에서 직접 측정하세요.
품질을 잃지 않고 비용 줄이기
프롬프트 캐싱, 토큰 위생, 배치 처리, 그리고 현재 모델에 대한 프롬프트 감사는 모두 출력 품질을 낮추지 않으면서 지불 금액을 줄여줘요. 여기에는 두 가지 주의사항이 있어요: 배치 처리는 지연 시간을 할인과 맞바꾸고, 토큰 위생 레버인 컨텍스트 편집(context editing)은 이 섹션에서 측정한 실행에서 아낀 것보다 더 많은 비용이 들었어요.
반복 컨텍스트 캐싱 (Cache repeated context)
왜 캐싱이 먼저인가
다른 어떤 레버보다 먼저 프롬프트 캐싱을 켜세요. 에이전트 작업의 매 턴마다 커져가는 전체 대화, 즉 시스템 프롬프트, 도구 정의, 이전 모든 턴을 다시 전송하거든요. 40턴짜리 작업은 첫 턴을 40번 보내므로, 작업 비용은 턴 수의 제곱에 대략 비례해서 커져요. 캐싱은 재전송을 막지는 않지만, 재전송마다 약 10분의 1 비용만 들고 더 빨리 처리돼요. 프리픽스(prefix)는 입력 가격의 10분의 1인 캐시 읽기 요율로 청구되고, 매 턴은 새로 생긴 부분에 대해서만 1.25배 캐시 쓰기 요율을 내요.
좋은 모습이란. 실제 트래픽이 흐르는 하루 동안, 에이전트 루프는 입력의 중앙값 84%를 캐시에서 읽었고, 코딩 여부와 무관하게 상위 10%의 하네스는 94% 이상을 읽었어요17. 작업 깊숙한 곳에서는 잘 만든 루프가 입력의 1% 미만에서만 정가를 내요. 대략 80% 아래로 떨어지면 캐시를 깨뜨리는 무엇인가가 있는지 찾아보세요(캐시를 깨뜨리는 것 참고).
Anthropic의 측정 실행 전반에서 캐시 읽기는 작업 비용 중 가장 큰 단일 구성 요소인 경우가 많아서, 캐싱은 대부분의 모델 선택 결정보다 가치가 커요. Anthropic은 DeepResearch Bench II7 실행을 캐싱 유무로 각각 가격을 매겼어요:
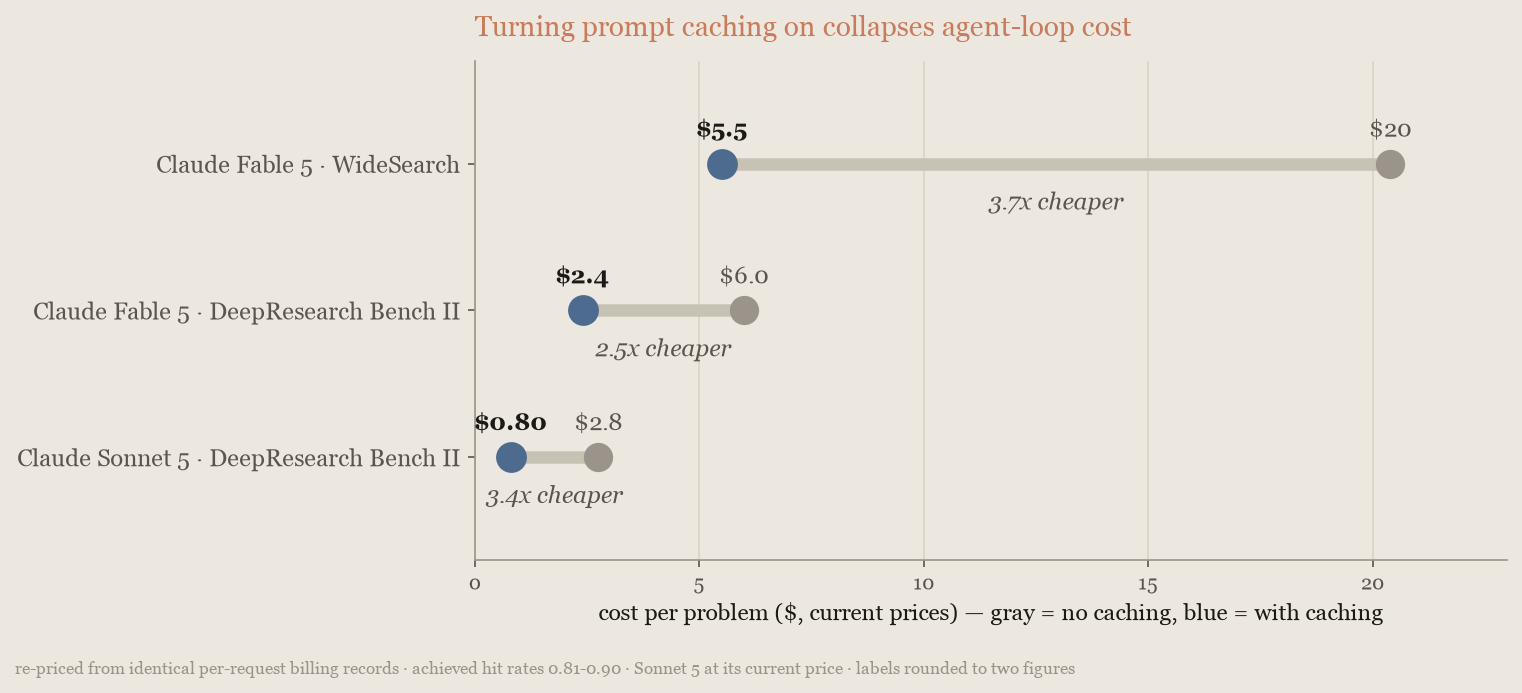
캐시의 기본 수명은 5분이고 에이전트 루프의 턴 간격은 몇 초이므로, 매 턴 대부분의 토큰에 할인이 적용돼요. 캐싱 차트의 실행은 입력 토큰의 79%에서 90%를 캐시에서 읽었어요. 절약액은 에피소드 깊이에 따라 달라져요. 짧은 루프는 재읽기를 덜 하니까요. 하지만 캐싱은 측정된 모든 모델과 벤치마크에서 가장 큰 단일 레버로 유지됐어요.
캐시 지속 시간 고르기
루프가 턴 사이에 사람을 기다려야 한다면 1시간 캐시 지속 시간을 사용하세요. 쓰는 비용이 더 들어요(입력 가격의 1.25배 대신 2배). 어느 지속 시간에서든 miss가 나면 전체 프리픽스가 읽기 가격 대신 쓰기 가격으로 청구되므로, 세션당 몇 턴이 5분에서 1시간 사이의 대기 뒤에 오면 더 긴 지속 시간이 효과가 있어요.
결정하려면 대화에서 연속 요청 사이의 간격을 세어 보세요:
- 간격 20개 중 약 1개 이상이 5분에서 1시간 사이에 있고, 1시간을 넘는 간격이 드물다면: 1시간 지속 시간을 사용하세요.
- 턴이 몇 초 간격으로 도착한다면: 5분 기본값을 유지하세요. 대기가 없을 때 1시간 설정보다 Claude Sonnet 5에서 15%, Claude Opus 5에서 11% 저렴했어요.
- 1시간을 넘는 간격이 흔하다면: 기본값을 유지하세요. 1시간을 넘는 간격은 두 지속 시간 모두를 만료시키고, 1시간 설정은 그때 더 높은 쓰기 가격으로 프리픽스를 다시 쓰므로 그 간격마다 손해예요. 5분보다 긴 대기 중 약 60% 이상이 1시간도 넘는다면 기본값을 유지하세요. 1시간 지속 시간은 긴 대기의 약 40% 이상이 1시간 안에 끝날 때만 효과가 있어요.
Anthropic은 입력 및 컨텍스트 토큰 정리의 트리아지 작업을 일부 턴 앞에 사용자의 지연을 시뮬레이션하는 대기를 삽입해서 측정했어요16. 측정한 두 모델 모두에서 약 30턴 중 1턴이 대기 뒤에 오면 1시간 캐시가 더 저렴한 설정이 됐으므로, 20분의 1 규칙은 여유를 남겨두고 교차점을 지나면 간격이 빠르게 벌어져요. 5분 설정의 대기 턴마다 전체 프리픽스를 다시 쓰기 때문이에요. 모든 현재 모델이 동일한 캐시 쓰기 배수를 사용하고, Claude Fable 5.1, Claude Mythos 5.1, Claude Opus 5.5를 제외한 모든 모델이 동일한 읽기 가격을 사용하므로, 교차점은 다른 모델에서도 비슷한 범위예요. Fable 5.1은 다음에 다루는 사례예요. 모든 셀에서 정확도는 실행 간 노이즈 범위 내에 유지됐어요. 대기 다음 턴은 1시간 설정에서 웜 캐시 지연 시간을 유지했어요(Claude Sonnet 5와 Claude Opus 5에서 측정, Claude Opus 5.5에서는 미측정). 다음 차트는 Claude Sonnet 5에서 대기 턴 비율에 따른 세션당 비용을 보여줘요:
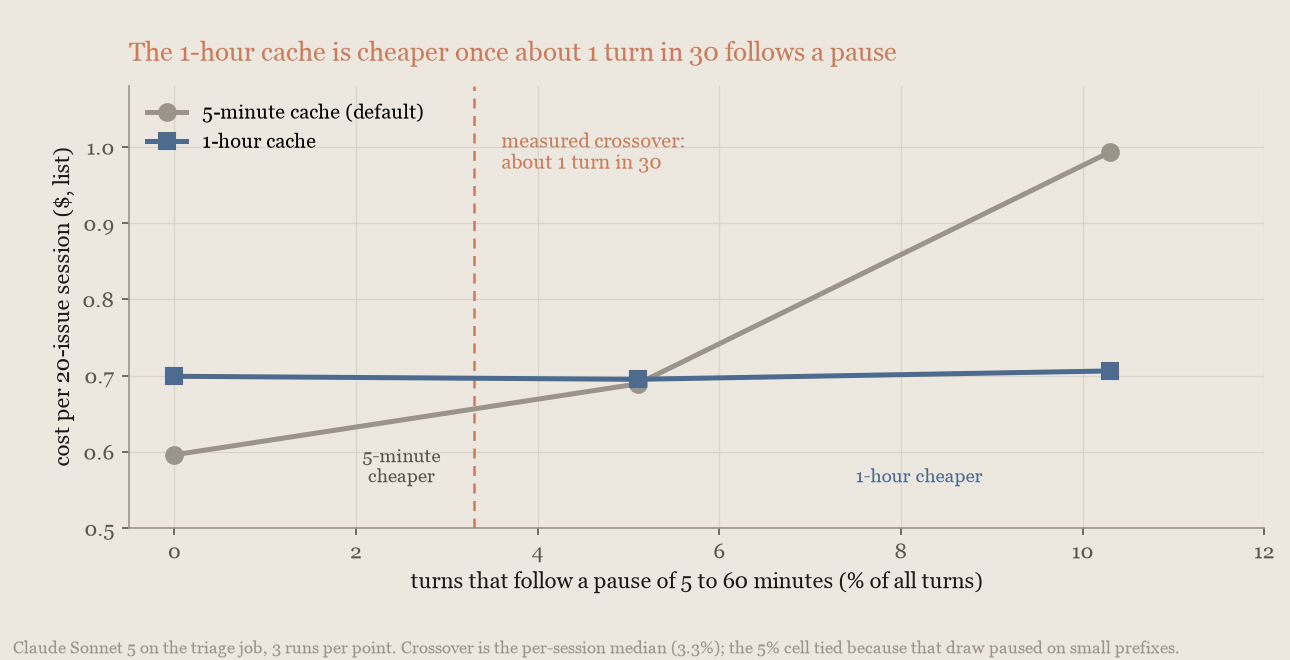
Anthropic은 5분 캐시를 따뜻하게 유지하는 추가 요청도 측정했어요. Claude Sonnet 5와 Claude Opus 5에서는 어떤 대기 턴 비율에서도 1시간 지속 시간에 비해 측정 가능한 절약이 없었고, 매 턴 앞에 대기가 있으면 더 비쌌으므로 지속 시간을 사용하세요.
Claude Fable 5.1에서는 가장 저렴한 설정이 다릅니다. Fable 5.1의 캐시 읽기는 입력 가격의 0.025배(백만 토큰당 0.25달러)인 반면 캐시 쓰기는 표준 배수를 유지하므로, 프리픽스를 다시 읽는 keep-alive 요청은 저렴하고 1시간 지속 시간의 쓰기 프리미엄이 더 큰 청구 항목이 돼요. Anthropic은 Claude Fable 5.1에서 동일한 세 가지 설정으로 트리아지 작업을 측정했어요19. 대기가 몇 분일 때마다 5분 캐시를 따뜻하게 유지하는 것이 세션당 1시간 캐시보다 13%에서 20% 저렴했어요. 대기가 약 45분에 가까울 때만 1시간 캐시가 세션당 약 12센트 이득이었어요. Claude Fable 5.1에서는 사람이 몇 분 자리를 비우는 동안 5분 캐시를 따뜻하게 유지하고, 대기가 1시간에 가까워지면 1시간 지속 시간을 구매하세요:
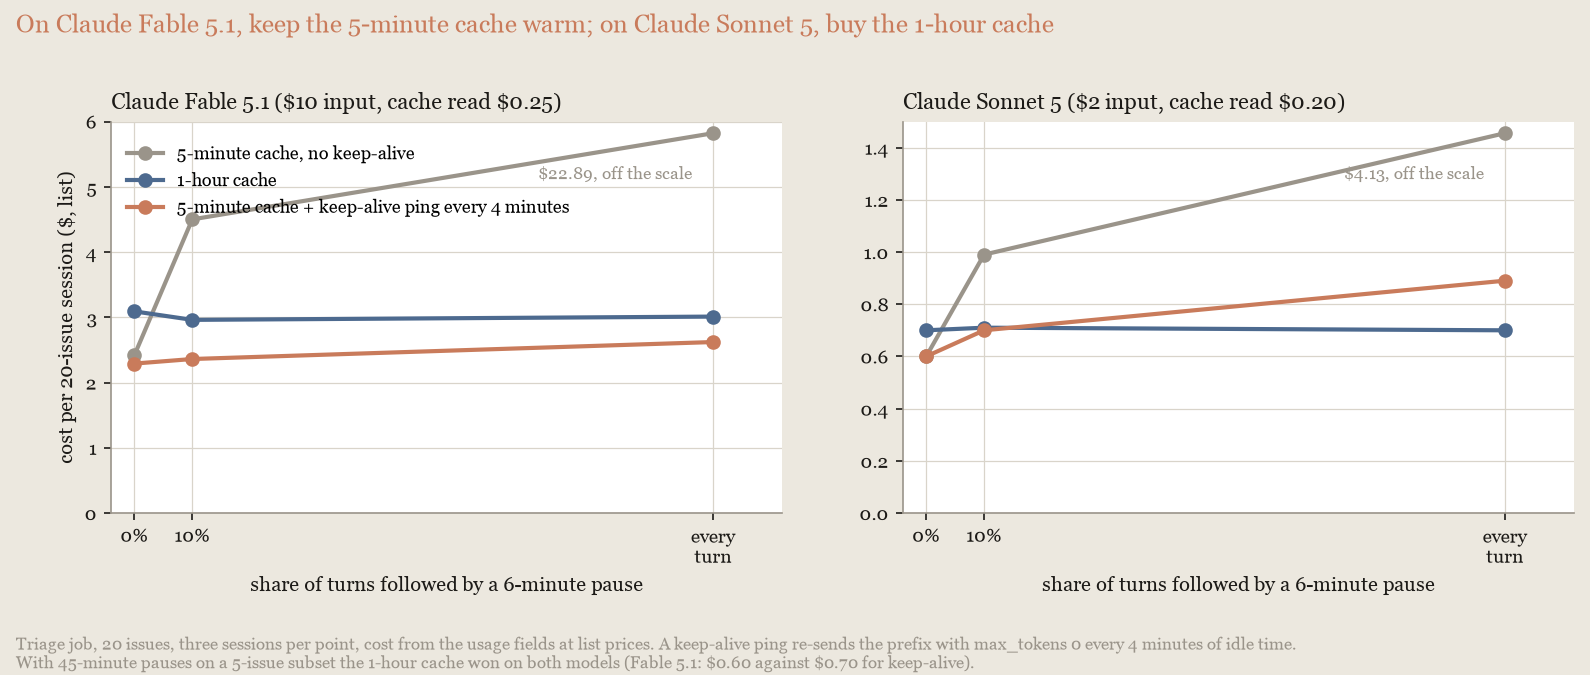
캐시를 따뜻하게 유지하려면, 이전 요청 시작 후 4분 이내에 max_tokens를 0으로 설정한 이전 요청을 다시 보내고, 그 후 4분마다 다시 보내세요. stream이 설정되어 있었다면 제거하세요. 요청의 응답 끝이 아니라 시작부터 계산해요. 캐시의 5분 수명은 항목을 쓰거나 새로고침한 요청의 시작부터 흐르므로, 응답 생성에 걸린 시간도 여기에 포함돼요. 이것이 프리워밍 요청(pre-warming request)이에요. 캐시의 수명을 새로고침하고 아무것도 생성하지 않으며 캐시 읽기만 청구해요. 프리픽스의 한 바이트도 바꾸지 말고, 이유 없이 토큰을 샘플링하는 max_tokens: 1도 사용하지 마세요. 요청의 본문뿐 아니라 헤더도 다시 보내세요. 요청에 anthropic-beta 헤더가 있다면(예: 작업 예산용), keep-alive 요청에도 같은 헤더가 필요해요. 그렇지 않으면 재생된 본문의 베타 게이트 필드가 거부돼요. thinking.type: \"enabled\"(Claude Fable 5.1의 기본 적응형 사고는 괜찮아요), 구조화 출력, 또는 강제 도구 선택(그 한계)을 설정한 요청에서는 max_tokens: 0 요청이 거부돼요. 이런 워크로드에서는 1시간 지속 시간을 구매하세요.
캐싱 켜기
설정은 많은 작업이 필요 없어요. 자동 캐싱이 브레이크포인트를 직접 배치해 주고, 그렇지 않으면 Claude Code에 내장된 Claude API 스킬이 프롬프트 하나로 기존 통합에 캐싱을 추가할 수 있어요. 다음 발췌는 이 스킬이 이 측정을 만든 하네스에 캐싱을 추가하는 모습을 보여줘요:
$ claude
> /claude-api add prompt caching to this integration

Done. Prompt caching is now wired into the harness. Two changes:

- build_system() now adds cache_control: {"type": "ephemeral"} to the
  system block. Since the API renders tools -> system -> messages, this
  one breakpoint caches the entire static prefix -- the full tool array
  plus the system prompt.
- apply_moving_cache_breakpoints() strips any stale markers, then marks
  the last content block of the two most recent user turns. The older
  marker is the read point matching the prefix the previous request
  cached; the newer one extends the cache for the next request.

That's 3 breakpoints total, under the limit of 4.
...
이 브레이크포인트 배치는 명시적 캐시 브레이크포인트의 표준 패턴을 따른 거예요.
캐시를 깨뜨리는 것
작업 중 캐시를 깨뜨릴 수 있는 것이 여러 가지 있어요. 타임스탬프나 큐 위치처럼 요청마다 바뀌는 것을 안정적인 프리픽스 앞에 두면 모든 요청이 완전한 캐시 쓰기가 돼요. 입력 및 컨텍스트 토큰 정리의 트리아지 실행에서, 시스템 프롬프트 앞부분의 25토큰 상태 줄이 실행당 4.24달러(캐싱을 끈 상태보다 더 많은) 대신 0.59달러가 들게 만들었어요. 요청별 텍스트는 가장 최근 사용자 턴에 두세요.
캐시는 요청 전체(도구, 시스템 프롬프트, 메시지 순서)에 대한 바이트 단위 정확한 프리픽스 매치이므로, 어디서든 한 곳만 바뀌어도 그 뒤의 모든 것을 무효화해요. 요청 사이에 effort나 사고 구성을 바꾸면 그 시점부터 캐시가 무효화되고, 일부 모델에서는 그 앞의 도구와 시스템 프롬프트도 무효화돼요. 시스템 프롬프트를 편집하면 그 시점부터 캐시가 무효화되고, 출력 형식을 설정하거나 바꾸면 전체 대화의 캐시가 무효화되며, 도구 정의를 추가·제거·재정렬하면 전체가 무효화돼요. 프롬프트 캐싱 페이지에 이런 사례가 나열되어 있고, 출력 형식은 구조화 출력이 다뤄요. 최신 모델에서는 최상위 system 필드를 편집하는 대신 대화 중간 시스템 메시지, 즉 messages에 추가된 {\"role\": \"system\"} 메시지로 지침을 바꾸면 캐시된 프리픽스가 그대로 유지돼요. 어떤 모델이 이를 지원하는지는 해당 페이지를 확인하세요. 지원하는 모델에서는 메시지별 effort 변경도 캐시된 프리픽스를 그대로 남겨요. 위험은 Claude Fable 5.1과 Claude Mythos 5.1에서 가장 커요. 캐시가 깨지면 프리픽스를 0.025x 읽기 대신 1.25x 입력 가격으로 다시 쓰거든요. 그래서 100,000토큰 프리픽스에서 한 턴이 깨지면 읽기 대신 50배인 0.03달러 대신 1.25달러가 들고, Claude Opus 5에서는 12.5배(0.05달러 대신 0.63달러)가 돼요.
Anthropic은 트리아지 에이전트의 긴 세션에서 이를 측정했어요18. 세션 중간에 한 번의 effort 변경과 도구 하나 추가가 39,000 및 60,000개의 캐시된 토큰을 다시 쓰게 했고, 그 세션들은 세션당 0.95달러가 들었어요. 컴팩션(compaction) 후 첫 요청에 동일한 두 변경을 가하면 0.75달러, 컴팩션을 촉발한 요청에서는 0.92달러였어요. 컴팩션의 요약화 통과가 81,000토큰 컨텍스트를 캐시 쓰기 가격으로 재처리했기 때문이에요. 그 요약화 통과는 0.21달러였고, 같은 변경이 한 요청 뒤에 온 경우에는 0.04달러였어요. 모든 팔에서 정확도는 실행 간 노이즈 범위 내였어요:
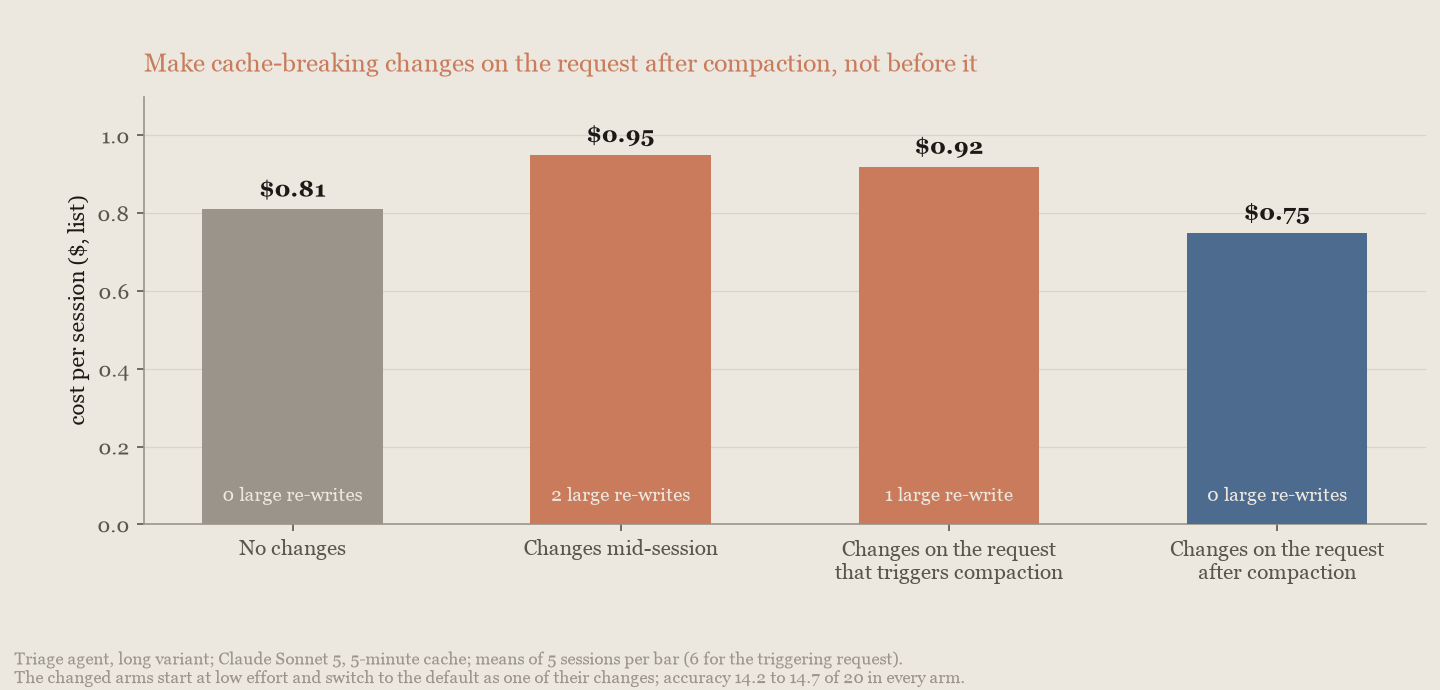
작업 예산을 도중에 바꾸면 예산 값을 포함하는 캐시된 프리픽스가 무효화되므로 첫 요청에 한 번만 설정하세요. 컨텍스트 편집 패스마다 지워지는 지점부터 프리픽스가 무효화되고 다음 요청이 그 이후의 모든 것을 다시 캐시하는 비용을 내므로, 작은 배치 여러 번보다 큰 배치 몇 번으로 지우세요. Claude Fable 5.1과 Claude Mythos 5.1에서는 각각이 토큰당 읽기 가격의 50배가 들므로 거기서 가장 중요해요. 모든 캐시 무효화 변경을 자연스러운 경계에서 하고, 캐시 읽기가 떨어지지 않았는지 확인하세요. 떨어졌다면 캐시 진단이 프리픽스가 어디서 벌어졌는지 보여줘요.
입력 및 컨텍스트 토큰 정리 (Trim input and context tokens)
대부분의 에이전트 요청은 답에 전혀 영향을 주지 않는 토큰을 담고 있어요. 이들을 정리하는 것은 출력 품질을 거의 손상시키지 않지만, 여기의 모든 레버가 측정 시 돈을 절약한 것은 아니에요. 살펴볼 두 곳:
- 입력 정리. 웹 가져오기 도구의 동적 필터링은 가져온 페이지에서 상용구를 제거하고, 이미지 크기 조정은 비전 입력을 적절한 크기로 만들며, 지연 로딩이 있는 도구 검색은 필요할 때만 도구 정의를 로드해요(이 섹션에서 나중에 측정). 프로그래매틱 도구 호출을 사용하면 클로드가 코드에서 여러 도구 호출을 실행하게 해 필터링된 결과만 컨텍스트에 들어가요. 문서에 따르면 에이전트 검색 벤치마크에서 입력 토큰을 24% 줄이고 더 높은 점수를 냈어요. 도구 컨텍스트 관리가 도구 검색, 프로그래매틱 도구 호출, 프롬프트 캐싱, 컨텍스트 편집을 비교해요.
- 컨텍스트 수명 주기. 컨텍스트 편집은 오래된 도구 결과를 지우고, 임계값이 있는 자동 컴팩션은 긴 루프가 전체 이력을 앞으로 계속 가져가지 못하게 해요.
레버들은 캐시 및 서로와 상호작용하므로 총 효과로 판단하고, 캐시 진단으로 캐시된 프리픽스가 각 변경 후에도 유지되는지 확인하세요. Anthropic은 공개 리포지토리에서 스크린샷이 있는 20개의 실제 버그 리포트를 처리하는 이슈 트리아지 에이전트와, 토큰이 2.6배인 같은 작업의 더 긴 변형으로 측정했어요. 캐싱을 켠 상태에서 입력 정리(이미지 크기 조정과 도구 검색)는 짧은 실행에서 추가로 26%, 긴 실행에서 21%를 절약했어요.
사용하지 않는 도구 정의 지연하기
요청에 붙은 모든 도구 정의는 매 턴 입력이 되고, 몇 개의 MCP 서버면 수백 개까지 늘어나요. Anthropic은 트리아지 에이전트를 자체 도구 두 개와 공개 MCP 서버의 실제 도구 정의 카탈로그, 총 최대 502개 도구와 함께 실행했어요. 모두 로드하거나, 추가 도구를 도구 검색 뒤 defer_loading로 표시했어요:
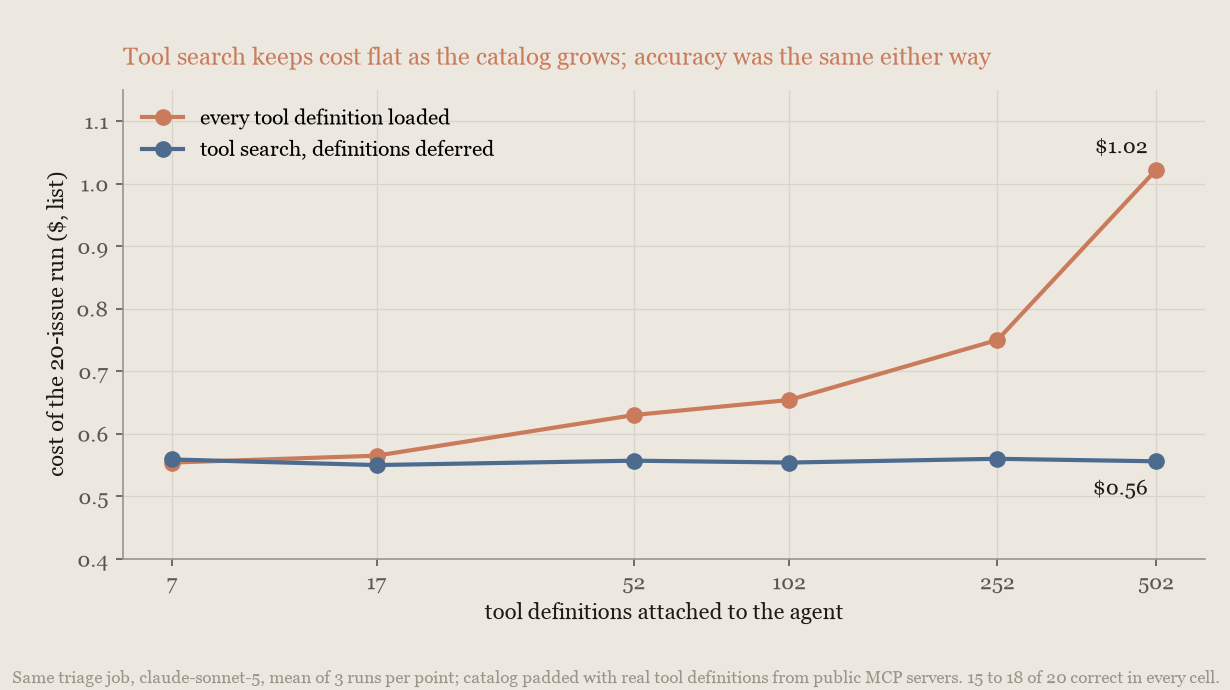
모든 정의를 로드하면 카탈로그가 커질수록 실행 비용이 거의 두 배로 늘었어요. 각 요청의 스키마 토큰을 따르기 때문이에요. 도구 검색을 쓰면 어떤 카탈로그 크기에서도 일정하게 유지되어 502개 도구에서 45% 저렴했어요. 정확도는 어느 셀이든 20개 중 15~18개였고 모델이 잘못된 도구를 호출한 적은 없었으므로, 이 규모에서는 카탈로그가 정확성이 아니라 비용만 들게 해요. MCP 커넥터를 통해 들어오는 도구도 마찬가지예요. 공개 GitHub MCP 서버를 붙였을 때 그 도구 세트를 지연(default_config: {defer_loading: true})시키자 실행이 같은 정확도에서 20% 줄었어요.
데이터 파일을 프롬프트에서 빼기
모델이 표(table) 위에서 계산해야 한다면, Files API로 파일을 업로드하고 코드 실행으로 모델이 그 파일을 질의하게 하세요. 붙여 넣지 말고요. Anthropic은 공개 CSV의 1,862행에 대해 25개의 집계 질문15(합계, 필터링된 개수, group-by, 날짜 필터)을 pandas로 계산된 답과 함께 물었어요:
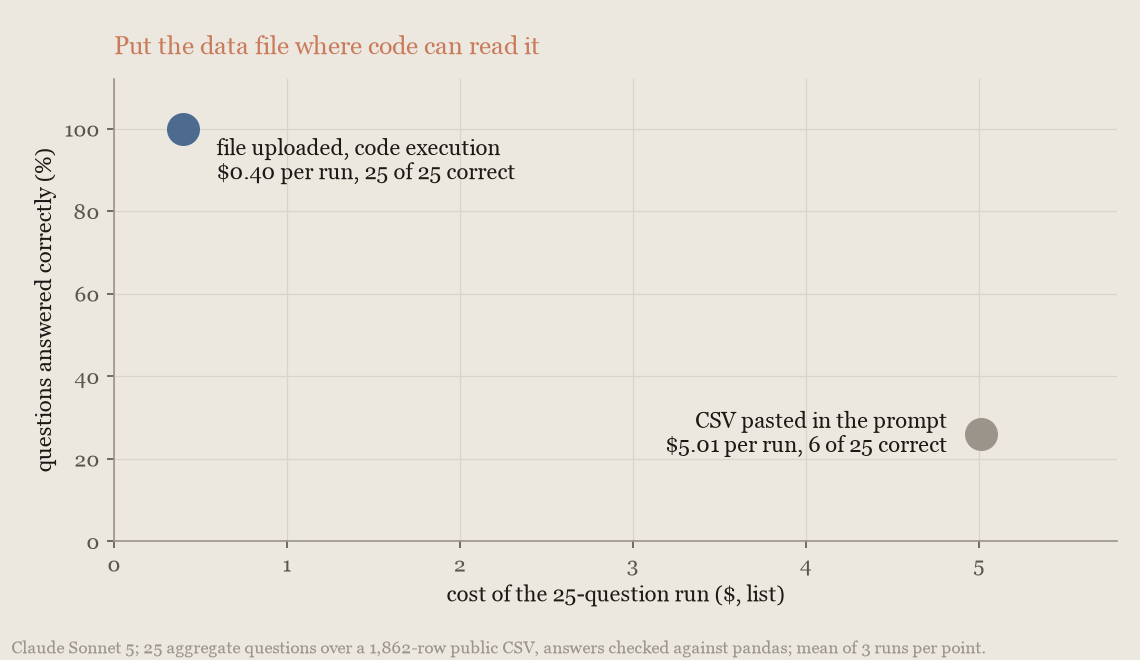
프롬프트에 붙여 넣으면 이 표는 매 요청 약 91,000 입력 토큰이고, Claude Sonnet 5는 25개 질문 중 6개만 정확히 답했어요. 업로드하고 코드 실행을 쓰면 25개 모두 답했고 실행 비용은 약 12분의 1이었어요. Claude Opus 5도 같은 패턴을 보였어요.
컨텍스트 수명 주기 관리하기
컨텍스트 레버는 그것이 필요한 만큼 긴 세션에서만 효과가 있어요:
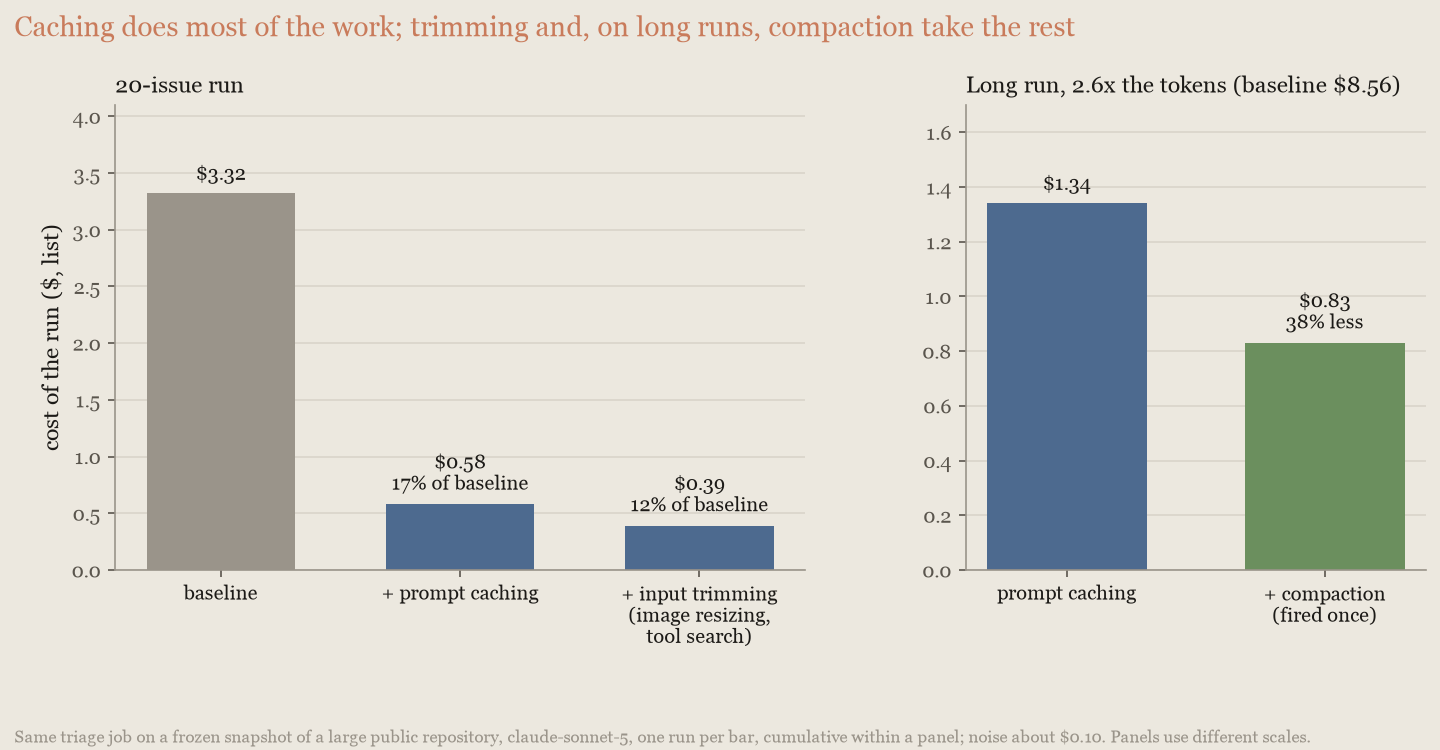
20-이슈 실행에서는 아무것도 절약하지 못했고 컨텍스트 편집은 74% 더 들었어요. 긴 실행에서는 프루닝이 39%, 컴팩션이 32%를 절약했고 컨텍스트 편집은 아무 변화가 없었어요. 프루닝은 직접 작성하는 몇 줄이에요. 각 작업 경계에서 크고 오래된 도구 결과를 한 줄 요약으로 바꿔요. 편집이 다음 작업이 어차피 새 콘텐츠를 추가하는 대화의 꼬리에 있으므로 캐싱이 잘 돼요. 경계 후 첫 요청에서 캐시 읽기 89%, 경계 사이 요청에서 81%였어요. 전체 실행 기준으로 프루닝과 컨텍스트 편집은 비슷하게 잘 캐싱돼요. 프루닝이 더 저렴한 이유는 컨텍스트 편집이 프루닝이 삭제하는 내용을 작업 중간에 다시 쓰고(격차의 약 3분의 2), 컨텍스트를 약 절반 크기로 유지하기 때문이에요(나머지 3분의 1). 컨텍스트 편집을 사용한다면 큰 배치 몇 번으로 지우세요. 하네스에서 가져온 프루닝:
import re

PRUNED = "[pruned at issue boundary]"


def prune_task_boundary(messages, tool_name_by_id, threshold=2000):
    """Call once per task boundary. Replaces large, stale search results with a one-line extract."""
    for message in messages:
        if message["role"] != "user" or not isinstance(message["content"], list):
            continue
        for block in message["content"]:
            if not (isinstance(block, dict) and block.get("type") == "tool_result"):
                continue
            if tool_name_by_id.get(block.get("tool_use_id")) != "search_issues":
                continue
            result_text = block.get("content")
            if not isinstance(result_text, str) or len(result_text) <= threshold:
                continue
            if result_text.startswith(PRUNED):
                continue  # already pruned on an earlier boundary
            # cap single-line results so the extract stays short
            first_line = result_text.split("\n", 1)[0].strip()[:200]
            refs = re.findall(r"#(\d+)", result_text)[:5]
            extract = f"{PRUNED} {first_line}"
            if refs:
                extract += " kept refs: " + " ".join("#" + r for r in refs)
            block["content"] = extract
기다려도 되는 작업 배치 처리
Batch API는 캐시된 것을 포함해 요청의 모든 토큰에서 50%를 할인해 주는 대신, 결과가 24시간 안에 어느 때든 도착해요. 아무도 기다리지 않는 모든 요청은 배치로 돌리고, 그 외에는 인터랙티브 경로를 유지하세요. 배칭은 캐싱 다음으로 큰 공짜 레버이며, 사람이 없는 에이전트 작업(평가 실행, 백필, 그리고 토큰 정리 측정의 이슈 트리아지 에이전트 반복 실행 같은 예약 작업)에 적합해요. 상호작용성만 빼면 이 페이지의 모든 것과 결합할 수 있지만, 설계상 인터랙티브한 Claude Managed Agents 세션에는 사용할 수 없어요(Claude Managed Agents 가격 참고).
현재 모델에 대해 프롬프트 감사하기
각 모델 세대는 프롬프트에 다르게 반응하므로, 더 이상 사용하지 않는 모델을 위해 작성된 텍스트가 프롬프트에 쌓여요. 흔한 경우는 이전 모델을 보완하기 위해 추가된 지나치게 구체적인 지시예요. "두 번 검증하세요", "최대한 철저하게", 필수 단계별 절차, 또는 직접 만든 추론 스크래치패드 같은 것들이요. 최신 모델은 이를 글자 그대로 따르므로 도구 라운드와 글쓰기가 늘어나고, 정확도는 오르지 않으면서 청구액만 올라가요. 지금 실행 중인 모델에 대해, 또 모델을 바꿀 때마다 프롬프트를 감사하는 것은 공짜 승리예요.
감사는 명령 하나로 끝나요. Claude Code에 내장된 Claude API 스킬에는 prompt-audit 명령이 있어, 프로젝트의 프롬프트와 요청 코드를 읽고 다른 모델을 위해 작성된 부분을 보고해요. 다음 발췌는 그런 패턴을 담은 지원 데스크 프롬프트와 요청 코드에 대해 실행한 모습이에요:
$ claude
> /claude-api prompt-audit

10 findings. The three that matter most:

1. budget_tokens returns a 400 on Opus 5 (support_agent.py:10). This code
   does not run against its own target model. Everything else here is
   quality; this one is an outage.
2. The prompt contains two live contradictions. Line 15 says confirm before
   every refund, line 17 says process every eligible refund immediately.
   Line 19 asks for a complete recap *and* a three-sentence maximum.
3. The reasoning scaffold and the 6-step script fight the model rather than
   steer it. <scratchpad> + "reason step by step" is now a request
   parameter, not prose; the mandatory 6-step procedure plus "investigate
   fully even when the ticket looks simple" forces four tool calls on a
   "where's my package" ticket.
...
-After any refund or escalation, verify twice before submitting: re-fetch
-the order, re-check every figure in your reply against the fresh lookup,
-and review the reply a second time for errors.
+Before submitting a refund or an escalation, re-fetch the order and confirm
+every figure in your reply matches the fresh lookup.
명령은 그다음 자신의 편집을 diff로 제안하고(한 헌크 표시), 의도적으로 건드리지 않은 것(환불 창, 톤 요구 사항, 품질 기준)을 나열해요. 다시 쓰기(rewrite)가 아니라 패치(patch)를 검토하게 돼요.
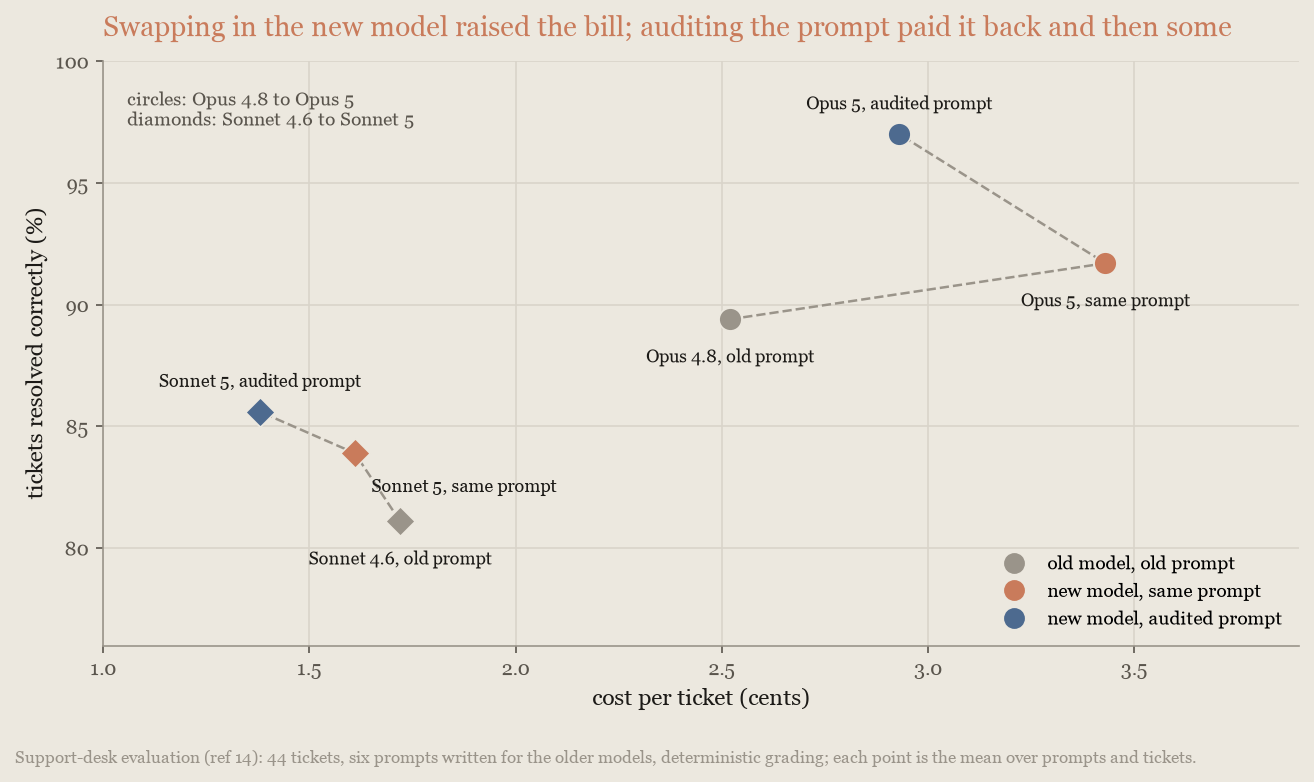
그 효과는 측정 가능해요. 지원 데스크 평가14에서, Claude Opus 4.8을 위해 작성된 프롬프트는 Claude Opus 5에서 정확도 변화 없이 티켓당 36% 더 비쌌어요. 같은 프롬프트에 감사를 실행하자 Opus 5가 감사 전보다 더 저렴해졌고(14%), 더 정확해졌어요(티켓의 97%, 92%에서 상승, 노이즈 밖의 이득). Claude Sonnet 4.6에서 Claude Sonnet 5 마이그레이션에서는 감사가 같은 정확도에서 14%를 줄였어요:
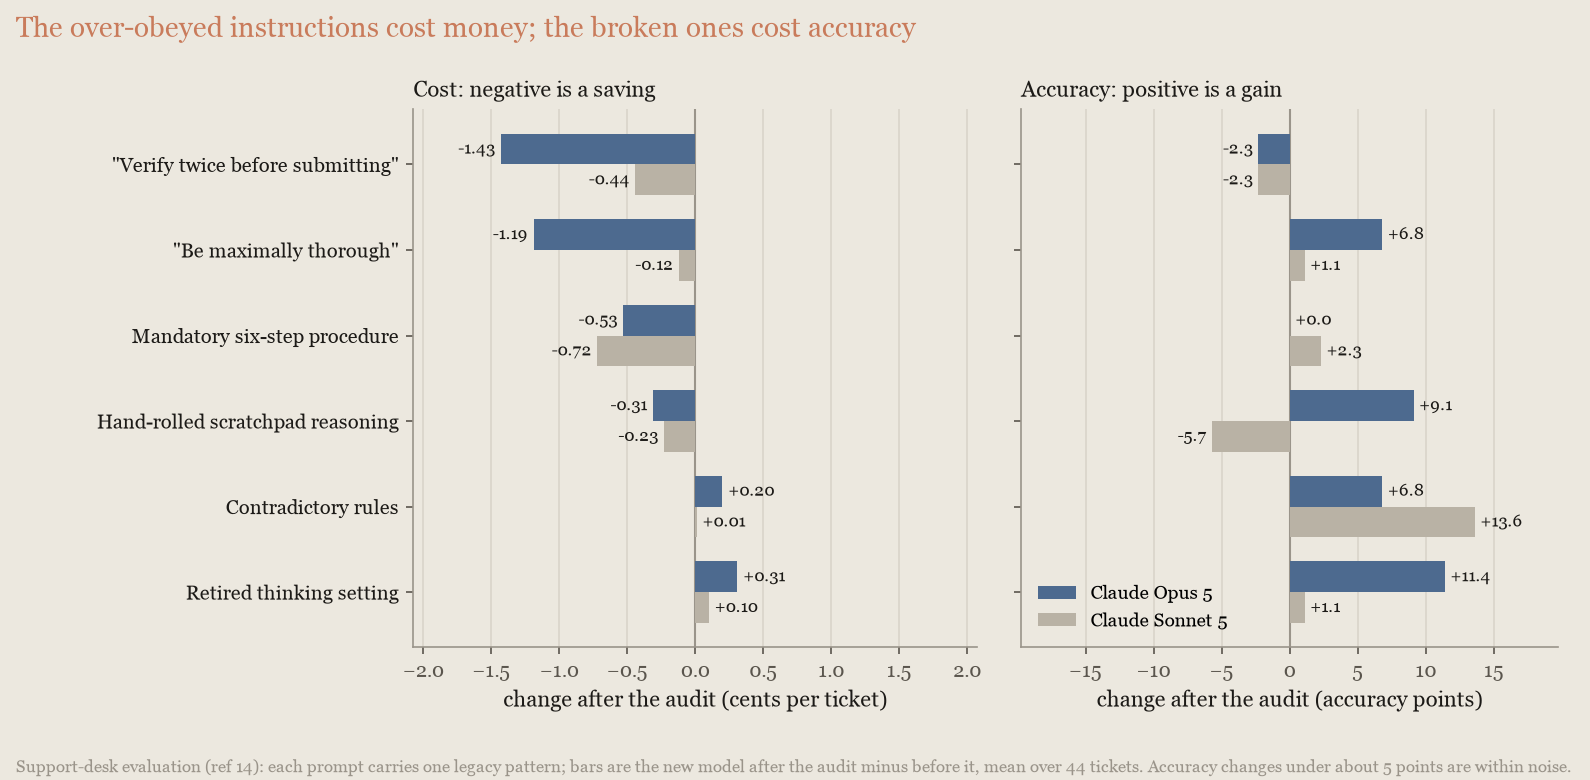
두 종류의 오래된 텍스트는 비용이 달라요. 새 모델이 지나치게 문자 그대로 따르는 지시는 돈이 들어요. "verify twice"를 제거하자 Opus 5의 티켓당 비용이 3분의 1 줄었고, "be maximally thorough"를 제거해도 거의 비슷했어요. 더 이상 모델에 맞지 않는 텍스트는 대신 정확도를 깎아요. 은퇴한 사고 설정, 모순된 규칙, 그리고 모델 자신의 사고와 충돌하는 직접 만든 스크래치패드는 각각 제거 시 Opus 5에서 7에서 11포인트를 복원했어요:
같은 패턴은 도구 설명과 스킬에도 나타나는 경향이 있으니 그것들도 감사할 가치가 있어요.
비용을 지능과 맞바꾸기
이 레버들은 단일 모델이 비용과 지능 사이의 어디에 놓일지 정해요: 모델 선택, effort, 더 높은 설정에서 실패 재실행, 그리고 그것이 작동하는 예산과 상한. 현재 모델에서 effort 스윕부터 시작하세요(Effort 조정). 비용과 성능이 낮은 것에서 높은 순으로 현재 모델은 Claude Haiku 4.5, Claude Sonnet 5, Claude Opus 5.5, Claude Fable 5.1(프런티어 모델)이에요. 모델 개요에 전체 라인업과 가격이 있어요.
작업당 비용으로 모델 비교
가격표는 토큰당으로 작성되며, 토큰당으로는 프런티어 모델이 비싸 보여요. Claude Fable 5.1의 토큰당 가격은 Claude Sonnet 5의 몇 배예요. 하지만 당신은 완료된 작업에 돈을 내므로, 완료된 작업당 비용으로 모델을 비교하세요. 더 뛰어난 모델은 작업을 더 적은 노력으로 끝내요. 턴이 적고, 검색이 적고, 자체 컨텍스트 재읽기가 적고, 되돌아가는 일이 적어요. 토큰당 프리미엄은 종종 "모든 것을 덜 하는 것"에 압도돼요.
Anthropic은 이걸 SWE-bench Pro3 부분집합에서 고객이 청구받는 방식으로 가격을 매겨 측정했어요:
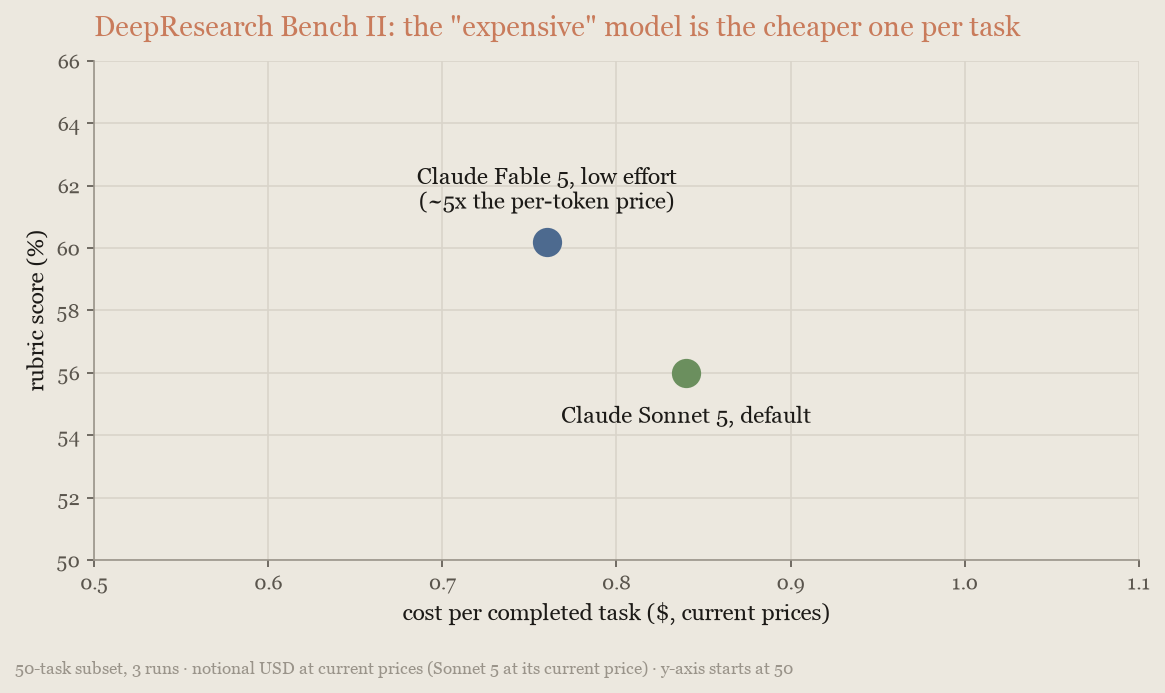
Claude Fable 5.1을 low effort로 쓰면 작업의 88.6%를 해결 작업당 0.54달러로 해결했고, Claude Sonnet 5 기본값은 77.4%를 0.84달러에 해결했어요. 토큰당 가격이 5배 높은데도 해결 작업당 35% 저렴하면서 11포인트 더 높은 거예요. 하지만 항상 이기는 것은 아니에요. 같은 부분집합에서(두 모델이 대부분 포화되고 공개 리더보드와 비교할 수 없는 점수), Claude Opus 5 단독이 기본값에서 Claude Fable 5.1 단독과 거의 같았고(91.7% 대 92.1%, 실행 간 노이즈 범위 내), 해결 작업당 약 15% 저렴했어요(1.01달러 대 1.19달러). Opus 5를 low로 쓰면 84.0%를 0.25달러에 해결했어요. 그리고 긴 연구 루프에서는 프런티어 모델이 덜이 아니라 더 많은 작업을 해요. DeepResearch Bench II7에서 Fable 5.1 low는 Sonnet 5보다 10포인트 높았지만(66% 대 56%), 작업당 비용은 약 4배였어요(4.66달러 대 1.20달러). 더 큰 컨텍스트에서 더 긴 연구 루프를 돌리기 때문이에요. Claude Opus 5 기본값은 같은 기준으로 71%를 작업당 6.71달러에 기록해, Fable 5.1 기본값(65%, 7.12달러)보다 높았으므로, 연구에서도 Fable 5.1은 low에서만 가격을 정당화해요.
대부분의 에이전트 워크로드에서는 Claude Fable 5.1을 low effort로 시작하고 실패하는 지점에서 effort를 올리세요. 토큰당으로는 캐시되지 않은 입력에서 Claude Opus 5의 2배가 들지만, 캐시된 입력에서는 절반(백만당 0.25달러 대 0.50달러)이고, 에이전트 루프에서 캐시된 입력이 가장 큰 항목이에요. 어드바이저 전략의 코딩 벤치마크에서 Fable 5.1 medium은 Opus 5 기본값과 시도당 비용의 약 3분의 1로 맞섰어요(2.91달러 대 8.50달러). 차트 읽기 벤치마크인 Chartography13에서는 Fable 5.1 low가 차트당 0.15달러로 62.5를 기록했고, Opus 5 low는 0.38달러로 49를 기록했어요. SWE-bench Pro 부분집합에서는 앞서 언급했듯 Claude Opus 5 기본값이 최고 점수로 가는 더 저렴한 길로 남아 있어요. 반대쪽 끝에서 Claude Haiku 4.5는 GPQA Diamond9 질문을 Opus 5의 질문당 비용의 약 10분의 1로 답했고, 정확도는 Opus의 92%와 비교해 63%였으며, 긴 코딩 작업에서는 훨씬 더 뒤쳐졌어요. 검증 가능한 출력이 있는 대량 작업에는 맞지만, 긴 에이전트 루프에는 맞지 않아요.
순위는 워크로드에 따라 뒤집히며, 어떤 가격표도 방향을 알려주지 않아요. Claude Opus 5와 프런티어 모델을 줄인 effort를 포함해, 모든 후보를 자신의 트래픽에서 완료된 작업당 비용으로 가격을 매기세요.
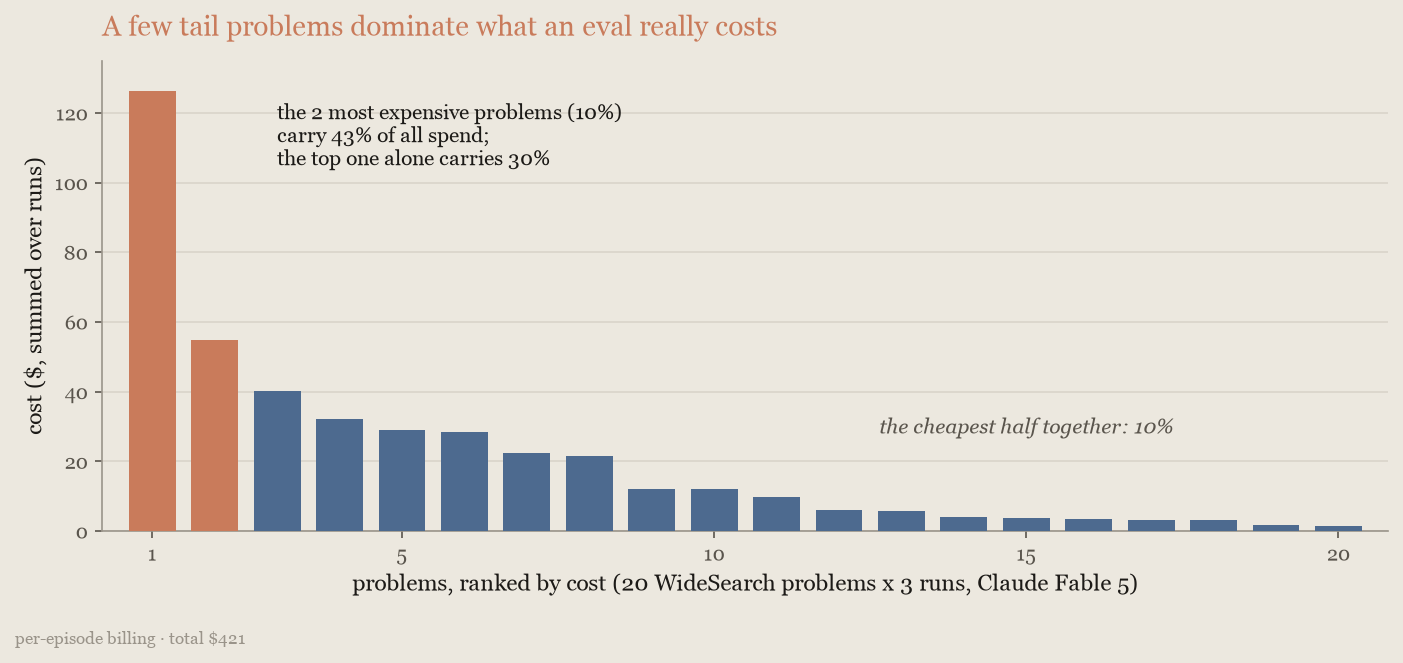
작업의 중앙값이 아니라 꼬리(tail)의 가격을 매기세요. 흔한 작업이 아니라 작업 중 가장 어려운 10분의 1로 모델을 비교하세요. 흔한 작업에서는 모든 모델이 비슷해 보이고 가장 저렴한 것이 가장 좋아 보이지만, 청구액은 저렴한 모델이 실패하는 작업에 의해 결정돼요. 실패한 작업도 토큰을 청구하고, 재시도도 청구하고, 실패가 하류에 끼치는 비용도 청구하니까요. 아무것도 실패하지 않아도 돈이 가는 곳이 바로 꼬리예요. 20문제 WideSearch1 실행에서 두 문제가 지출의 43%를 차지했어요:
다중 모델 전략은 나머지에 프런티어 요율을 내지 않고 그 꼬리에 프런티어 지능을 쓰기 위해 존재해요.
모델 업그레이드
한두 세대 뒤처져 있다면 가장 저렴한 레버는 모델 문자열이에요. Anthropic은 최근 Claude Opus, Claude Sonnet, Claude Fable 모델을 SWE-bench Pro3 부분집합에서 동일한 하네스로 각각 출시 기본값과 목록 요율로 실행하고, Opus 라인을 Terminal-Bench 320에서 다시 실행했어요:
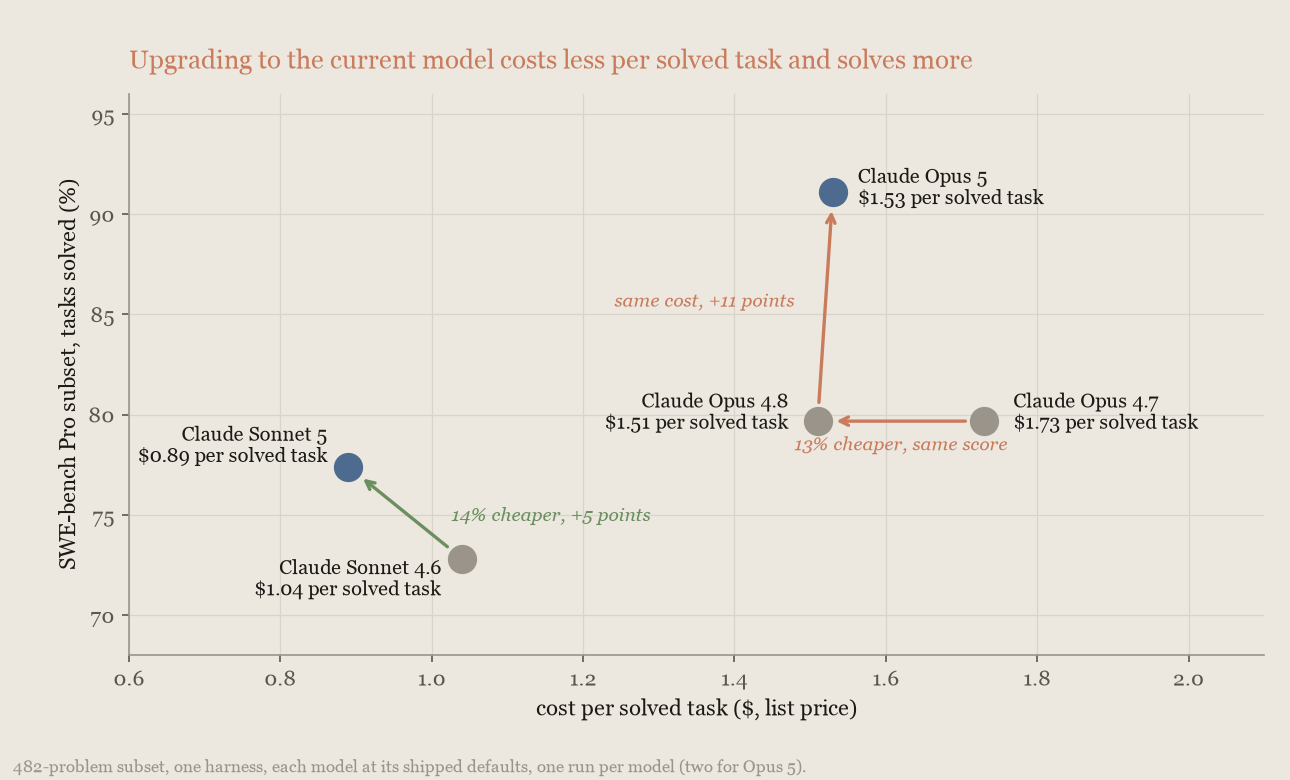
Anthropic은 Claude Opus 4.7, Opus 4.8, Opus 5를 토큰당 동일하게 가격을 매기므로, 그들 사이의 어떤 차이도 모델이 작업당 하는 일의 양에서 나와요. 고객이 청구받는 방식으로 가격을 매기면 Claude Opus 4.8은 Opus 4.7과 같은 비율의 작업을 해결 작업당 14% 저렴하게 해결하고, Claude Opus 5는 12포인트 더 많은 작업을 해결 작업당 21% 더 비싸게 해결해요. Claude Opus 5를 low effort로 쓰면 이 벤치마크에서 Opus 4.8 기본값을 해결 작업당 비용의 약 30%로 이겨요. 그래서 가장 저렴한 업그레이드는 더 낮은 설정의 새 모델이에요. Sonnet 5의 절약은 더 낮은 토큰당 가격에서 나오며, 이는 Sonnet 4.6과 비교해 작업당 쓰는 추가 토큰을 상쇄하고도 남아요. 해결 작업당 15% 저렴하고 5포인트 더 높아요. 프런티어 티어도 같은 방식으로 얻었어요. Claude Fable 5.1은 Fable 5의 점수를 해결 작업당 43% 저렴하게 맞추는데, 대부분 더 낮은 캐시 읽기 가격 덕분이에요. 그 방향이 보장되지는 않아요. DeepResearch Bench II7에서는 같은 업그레이드가 모든 팔에서 깨끗한 작업(참조 7)의 2~3포인트를 위해 high에서 작업당 41%(low에서 79%) 더 들었어요. 새 모델이 거기서 작업당 더 많은 일을 하기 때문이에요. 입력·출력 가격은 같고 캐시 읽기는 4배 저렴하므로, 절약을 가정하기 전에 자신의 워크로드에서 업그레이드를 측정하세요.
더 어려운 작업에서는 격차가 커져요. Terminal-Bench 320에서 작업이 충분히 어려워 청구액이 토큰이 아니라 통과율로 정해지는데, Claude Opus 4.7, Opus 4.8, Opus 5가 각각 작업당 8~15달러를 쓰지만 7%, 15%, 41%의 작업을 해결하므로 해결 작업당 비용은 사다리를 따라 183달러에서 63달러로 28달러로 떨어져요. Claude Opus 5가 포화된 코딩 부분집합에서 Opus 4.8보다 지니는 21% 프리미엄은, 이전 모델이 대부분 실패하는 Terminal-Bench 3에서는 56% 절약이 돼요. 워크로드가 이전 모델을 더 많이 무너뜨릴수록 업그레이드가 결과당 더 많이 절약해 줘요.
토큰당이 아니라 해결된 작업당 비용으로 비교하세요. 같은 텍스트가 Claude Opus 4.7 이상에서 약 30% 더 많은 토큰이 들므로, 토큰당 비교는 구조적으로 새 모델을 더 비싸 보이게 해요.
Effort 조정
Effort는 모델을 작업에 맞추는 가장 직접적인 방법이에요. effort 파라미터는 모델이 얼마나 많이 생각하고, 도구를 호출하고, 자기 검증을 하는지를 조절하며, 대부분의 모델에서 기본값인 high는 까다로운 작업에 적합해요. Claude Opus 5.5는 기본값이 medium이에요. 비용은 그 모든 활동에 따라 늘어나지만, 정확도는 작업이 실제로 필요로 하는 부분에 따라서만 늘어나요. 모델의 한계 아래에서는 가장 높은 effort 수준이 작업이 결코 사용하지 않는 깊이에 돈을 내요.
연구 및 지식 작업 벤치마크(WideSearch1, DeepWideSearch6, BrowseComp4, GDPval2, 모두 Claude Fable 5 사용)에서 정확도 대 비용 곡선은 거의 평평해요. low는 작업당 비용의 3분의 1절반으로 13포인트를 내주고, medium은 비용의 약 70%~87%로 기본값 정확도를 맞추며, 기본값은 네 벤치마크 어디서도 medium에 비해 측정 가능한 것을 사지 못했어요. DeepWideSearch에서 low는 Claude Sonnet 5 워커가 있는 오케스트레이터를 29% 더 낮은 비용으로 맞추기도 했어요. effort 낮추기가 아키텍처 변경을 이긴 거예요.
낮은 effort 설정은 종종 더 빨라요. 지연 시간이 제약이라면 중요해요. 이 실행들에서 low는 DeepWideSearch에서 문제당 4.5분이 걸렸고(기본값은 7.9분), 입력이 어떤 단일 컨텍스트 창에도 맞지 않는 코퍼스 벤치마크에서는 Fable 5.1이 low, medium, high에서 에피소드당 15.2, 17.5, 19.9시간이 걸렸어요.
장시간 코딩은 effort가 정말로 정확도를 사는 곳이에요. SWE-bench Pro3에서 Claude Opus 5는 medium에서 절반 비용으로 약 2포인트, low에서 4분의 1 비용으로 약 8포인트를 내줬어요. 실제 트레이드오프이며, 더 높은 effort에서 실패 재실행이 이를 다시 절약으로 바꿔줘요. 이 차트는 연구·지식 작업 벤치마크와 SWE-bench Pro의 effort별 정확도 대 비용을 보여줘요:
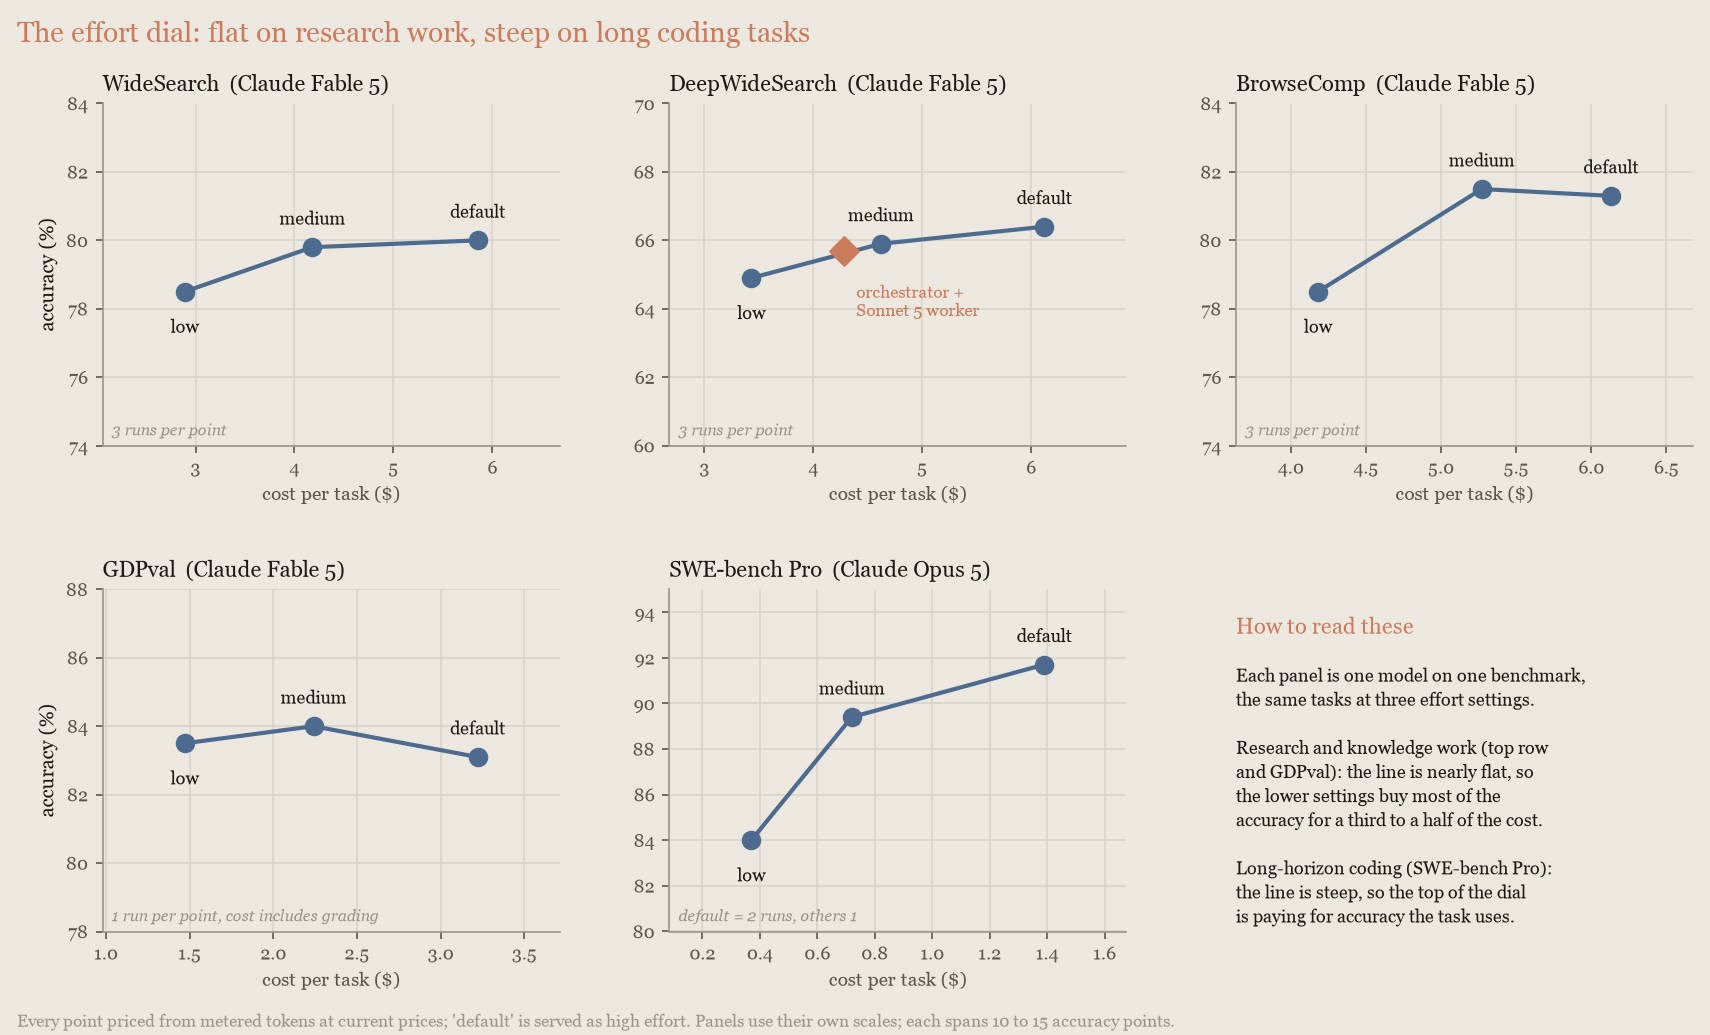
두 가지 결과가 따라와요. 첫째, 두 번째 모델을 추가하기 전에 자신의 워크로드에 대해 이 곡선을 그리세요. 내부 측정에서 기본 단일 모델보다 저렴해 보였던 다중 모델 구성이, 같은 모델을 낮은 effort로 쓰는 것보다 더 비쌌어요. 둘째, 이 곡선은 어떤 다중 모델 전략도 이겨야 하는 단일 모델 기준선이므로, 자신의 워크로드에서 측정하기의 2단계가 effort 수준별 기준선을 잡아요.
어려운 작업이 자동으로 높은 effort를 필요로 하지는 않아요. DeepResearch Bench II7에서 Claude Fable 5.1은 low, medium, high에서 거의 같은 점수를 기록했는데 작업당 비용은 4.66달러에서 7.12달러로 올랐어요. 이 경우 effort를 올리는 것이 출력 품질을 눈에 띄게 높이지 않아요. 모든 팔에서 깨끗한 21개 작업(참조 7)에서 Claude Fable 5도 effort 전반에 걸쳐 평평했지만, 차트의 33작업 기준(각 모델의 중도에 잘린 시도를 제거한)은 그것이 오르는 것처럼 보여요. 지난번에 측정한 모델이 아니라 실제로 서비스하는 모델에 대해 곡선을 측정하세요:
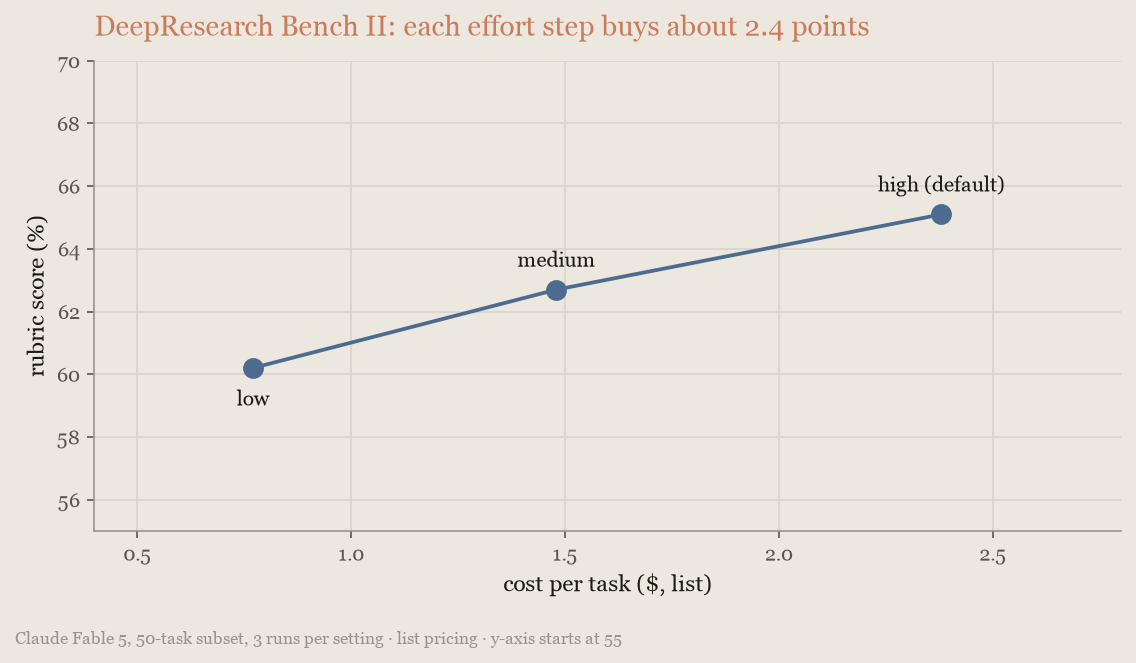
작업 설명만으로는 어떤 종류의 워크로드인지 알 수 없으므로, 샘플 트래픽에서 두세 개의 effort 수준을 스윕하고 곡선에서 답을 읽으세요. 각 수준을 별도 세션에서 테스트하세요. 세션 중간에 최상위 effort를 바꾸면 캐시가 무효화되고(반복 컨텍스트 캐싱 참고) 비교가 왜곡돼요. 파라미터 세부 사항은 Effort를 참고하세요.
더 높은 effort에서 실패 재실행
작업 결과를 검증할 수 있을 때, effort 곡선에서 가장 저렴한 정책은 고정 설정이 아니에요. 모든 작업을 낮은 설정으로 실행하고 실패한 것만 더 높은 설정으로 다시 실행하세요.
Anthropic은 이 정책을 Effort 조정의 SWE-bench Pro3 부분집합 effort 실행에서 작업별로 계산했어요. Claude Opus 5 low에서 작업의 16%가 실패했고, 그들을 기본값으로 다시 실행하자 약 93%가 약 0.45달러에 통과했으며, 모든 것을 기본값으로 실행할 때(91.7%, 0.93달러)와 비교해 실패한 저렴한 시도까지 세면 같은 통과율을 절반 비용으로 얻었어요. medium으로 시작하면 약 94%를 약 0.61달러에 해결했어요. 작은 상승의 대부분은 두 번째 시도에서(기본값 자신의 실패를 기본값으로 다시 실행해도 비슷한 점수지만 돈은 더) 나오므로, 이 정책은 상승이 아니라 절약을 위해 사용하세요:
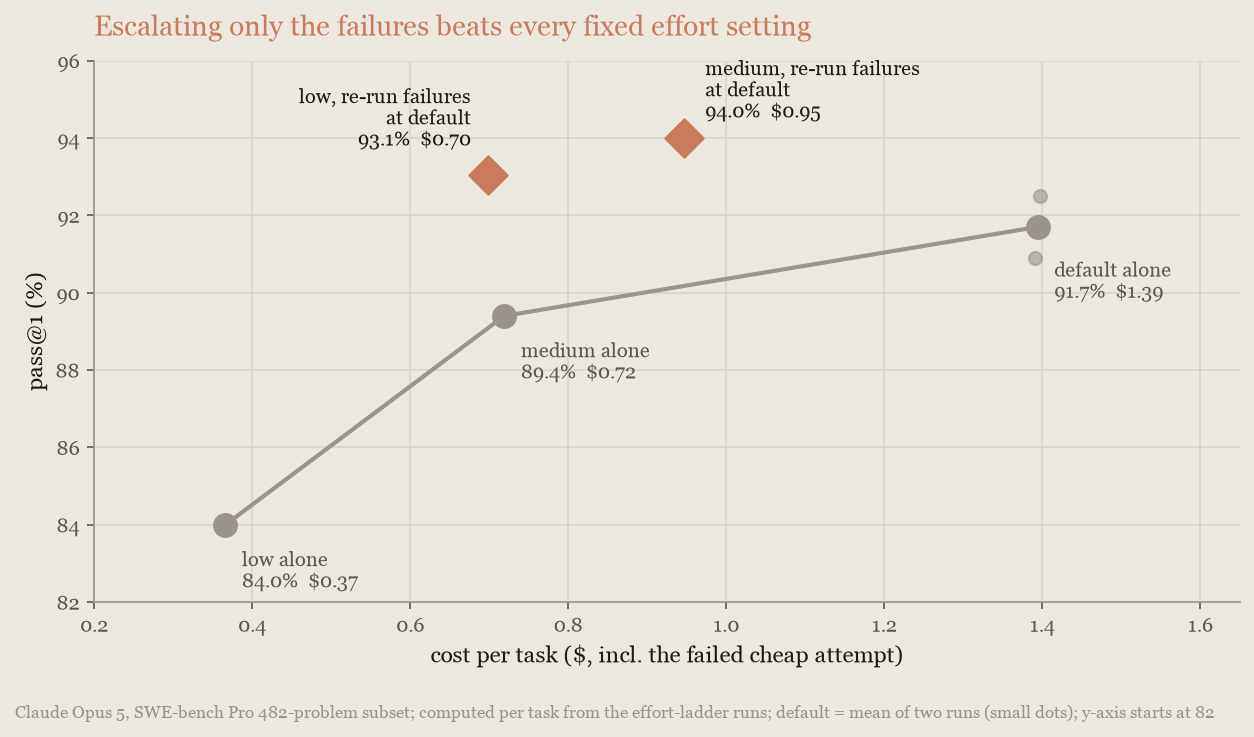
두 가지 조건이 적용돼요. 첫째, 실패 신호가 필요해요(여기서는 벤치마크 자체의 테스트). 나쁜 작업을 통과시키는 검사기는 그 실패를 통과시키거든요. 둘째, 모든 첫 패스 실패는 두 실행 분의 벽시계 시간이 걸리므로, 절약은 실패에서 지연 시간으로 지불돼요.
예산 및 출력 상한 설정
대부분의 에이전트 작업 실행은 저렴하지만, 소수가 중앙값의 몇 배를 검색, 재검증, 과잉 테스트에 써요. 작업 예산이 그 꼬리를 겨냥해요. 모델은 전체 작업에 대한 실시간 토큰 카운트다운을 보고 스스로 규제하며, 가치 낮은 검색을 줄이고, 중복 검증을 건너뛰고, 나선형 대신 마무리해요.
Anthropic은 예산을 조여가며 Claude Fable 5.1로 SWE-bench Pro3의 통과율과 작업당 비용을 측정했어요:
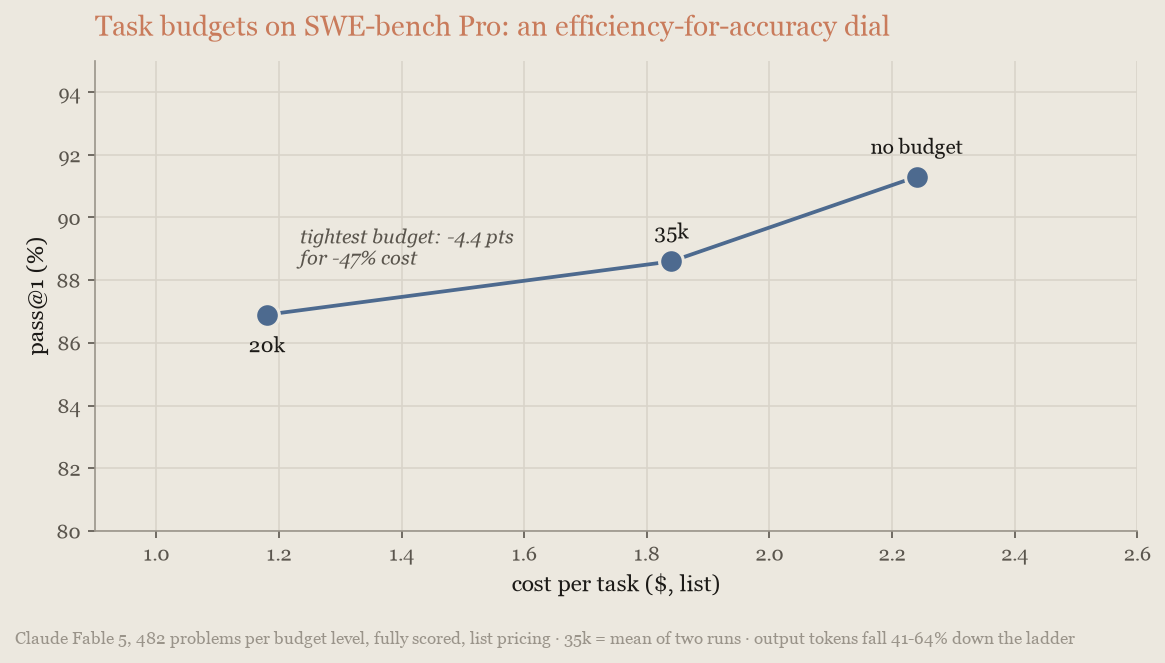
넉넉한 예산은 실행 간 노이즈의 경계에서 통과율 약 3포인트로 작업당 비용을 44% 줄였고, 가장 빡빡하게 허용된 예산은 6포인트로 58%를 줄였어요. 예산은 여기서 효율을 샀고, 예산이 조여질수록 커지는 통과율이라는 대가가 있었어요.
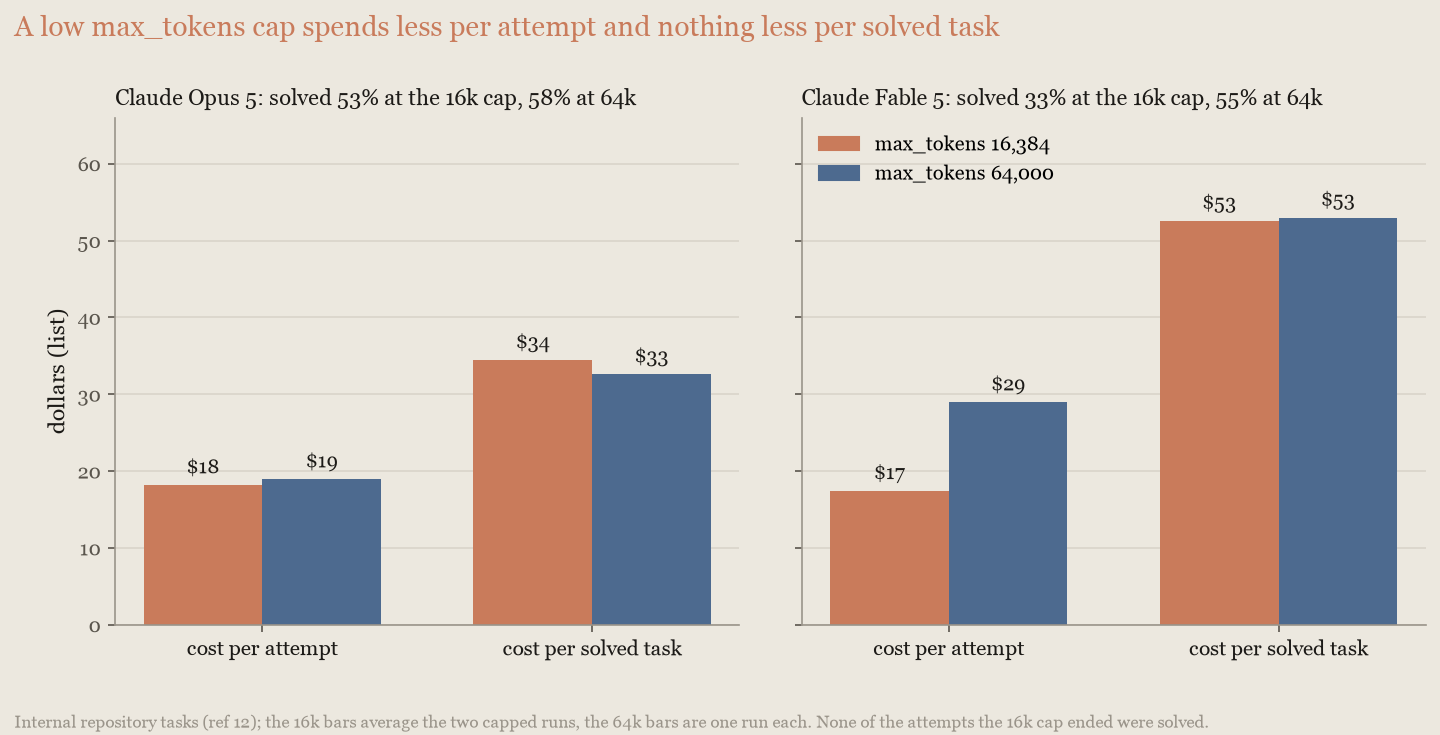
세 가지 컨트롤이 세 가지 다른 일을 해요. 작업 예산은 돈을 절약해요. 모델이 그것을 보기 때문이에요. max_tokens는 안전 상한이에요. 낮추면 해결된 작업당 비용을 낮추지 않고 시도당 비용만 줄였어요. Claude Managed Agents에서 세션 예산은 둘 뒤의 확실한 달러 스톱이에요. 세 가지 모두 설정하세요. 작업 예산, 높은 max_tokens, 그리고 청구서에 절대 올리고 싶지 않은 실행을 위한 세션 상한. 워크스페이스 지출 한도를 최후의 백스톱으로요.
- **작업 예산(Task budgets)**은 최신 모델에서 베타(베타 헤더
task-budgets-2026-03-13)예요. 어느 모델인지 지원 표를 확인하세요. 루프의 90번째 백분위 토큰 사용량 근처에서 시작해 조여가세요(예산 선택이 그 분포 수집 방법을 보여줘요). 현재 20,000토큰 하한 아래의 예산은 거부되고, 매우 빡빡한 예산은 거부와 같은 동작을 만들 수 있어요. 예산은 첫 요청에 한 번 설정하세요. 작업 중 변경은 캐시를 무효화하기 때문이에요. 예산은 권고적(advisory)이라 모델을 멈추기보다 이끌므로, 자신의 워크로드에서 준수를 검증하세요. - **
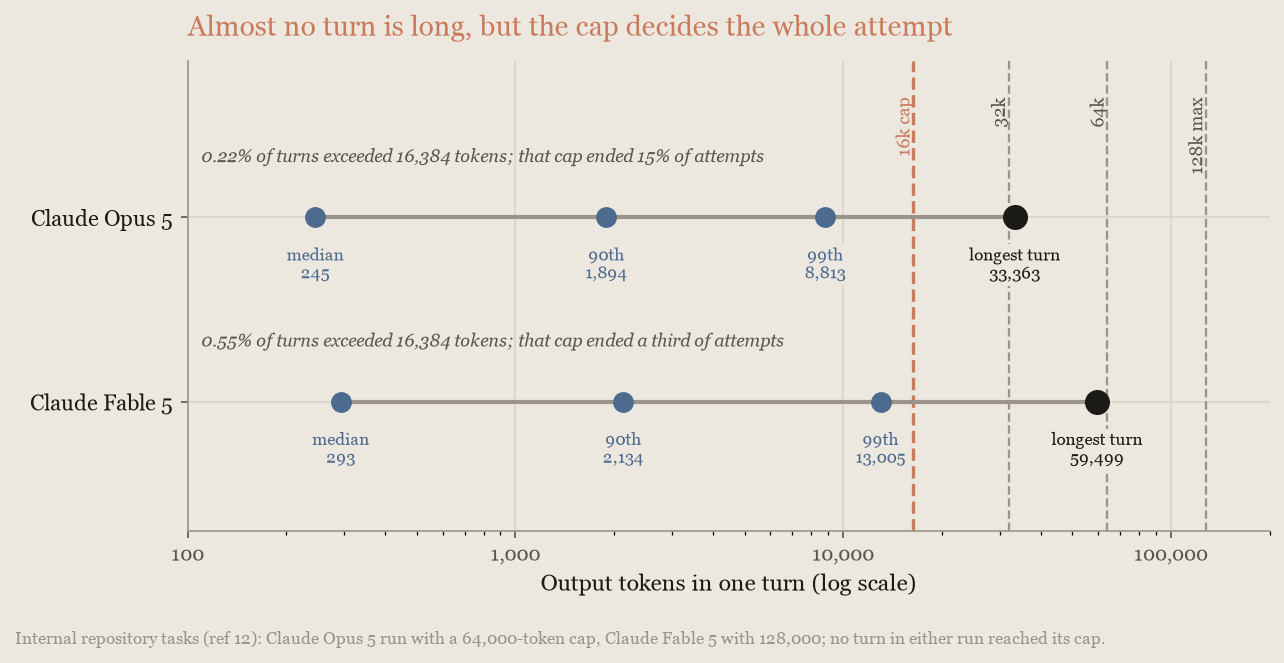
max_tokens**는 모델에 보이지 않게 단일 응답을 제한하므로, 낮춰도 모델이 절약하지 않아요. 여유가 필요했던 턴은 버려지고 여전히 청구돼요. 내부 리포지토리 작업 벤치마크12에서 16,384토큰 상한이 기본 effort에서 Claude Opus 5 시도의 15%, Claude Fable 5.1 시도의 43%를 끝냈고, 케이프된 Fable 시도 117개 중 9개만 여전히 통과했어요. 케이프된 실행은 시도당 덜 썼지만 해결도 비례적으로 줄었으므로 해결 작업당 비용은 64,000일 때와 거의 같았어요(21달러 대 22달러). 64,000에서는 기본 effort의 약 14,000턴 중 2턴이 여전히 잘렸고, Fable 5.1은 작업의 58.5%를 해결했습니다(36.3% 대신, 참조 12에 설명된 SWE-bench Pro3 부분집합의 별도 컷에서는 차이 없음: 어느 상한에서든 100개 중 94개). 케이프된 시도를 재시도하는 것이 거의 도움이 되지 않아요. 같은 상한에서는 대부분 다시 실패하고, 더 높은 상한에서는 낭비된 시도도 지불해요. 에이전트 작업에는max_tokens를 64,000으로 설정하거나, 단일 잘림 시도가 비쌀 때는 최대치인 128,000으로 설정하세요. 128,000에서 Fable 5.1은 같은 해결 작업당 비용으로 60.0%를 해결했어요. 큰 응답은 스트리밍하고,stop_reason: max_tokens를 실패로 취급하며, 모델이 볼 수 있는 effort와 작업 예산으로 돈을 아끼세요. - **Claude Managed Agents의 세션 예산(Session budgets)**이 확실한 스톱이에요. 세션 예산은 토큰, 검색, 세션 시간에 대해 목록 요율로 한 세션에 부과되는 달러 상한이에요. 상한에 도달하면 세션은
stop_reason: budget_reached로 일시정지되고, 예산을 올리면 재개돼요. 플랫폼에서 강제되며, 목록 가격이 있는 모든 모델(작업 예산이 아직 없는 모델 포함)에서 작동하고, 권고적 작업 예산과 결합돼요. 배포는 모든 실행에 같은 필드를 적용해요.
더 짧은 답을 요청하세요. 출력 토큰은 Claude Sonnet 5에서 입력 토큰의 5배 비용이며, 에이전트 루프에서 모델이 쓰는 모든 토큰은 이후 모든 턴에서 입력으로 돌아오므로, 긴 답변에 반복해서 지불하게 돼요. Anthropic은 같은 모델과 도구로 최종 답 지시 세 가지, 각각 3회 실행으로 트리아지 작업을 실행했어요. 원래는 두 줄을 요청했어요:
4. Finish with exactly two lines:
LABEL: <one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish>
SUMMARY: <one or two sentences for the engineering team>
더 짧은 변형은 한 줄을 요청했어요:
4. Finish with exactly one line in this form:
DECISION | LABEL | REASON
where DECISION is one of: triage-now, needs-info, close-duplicate; LABEL is one of: bug-confirmed, needs-more-info, duplicate-candidate, feature-request, upstream-issue, perf, ui-polish; REASON is one clause under 15 words. Output nothing after that line.
더 긴 변형은 문제 요약, 증거, 중복 확인, 권장 레이블, 다음 단계라는 다섯 개의 제목 섹션으로 된 메모를 요청했어요. 질문을 건너뛴 후 절대 보내지 않는 큐 프롬프트가 있는 한 이슈에서, 처음 두 답은 다음과 같았어요:
LABEL: bug-confirmed
SUMMARY: When a user submits a new prompt instead of answering an agent's pending question, the question is cancelled/skipped but the new prompt remains stuck in "QUEUED" state indefinitely since it's waiting on a response to the now-cancelled question; the queued prompt should be processed immediately after cancellation.
triage-now | bug-confirmed | Clear repro steps show prompt queues indefinitely after cancelled question.
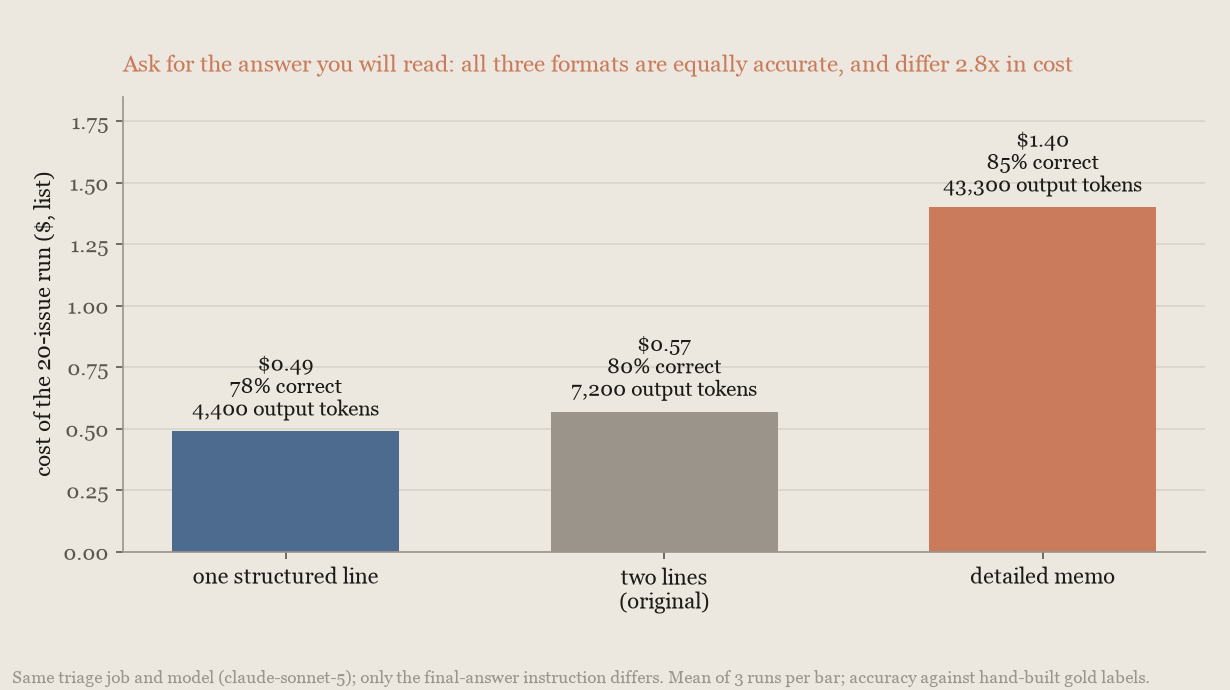
한 줄 답은 원래 두 줄보다 출력 토큰을 39% 적게 썼고 실행당 14% 저렴했어요. 메모는 출력 토큰 6배를 썼고 한 줄 답의 2.8배 비용이 들었어요. 세 가지 모두 골드 라벨에 대해 서로 실행 간 노이즈 범위 내에서 점수를 냈으므로, 형식은 맞히는 것보다 지불하는 것에서 훨씬 더 차이가 나요. 철저해 보이는 답이 아니라 읽을 답을 요청하세요.
더 낮은 max_tokens 상한에서 두 모델 모두 시도당 덜 쓰지만 해결하는 작업도 비례적으로 줄어, 해결 작업당 비용은 거의 움직이지 않아요:
거의 모든 턴은 어느 상한보다 훨씬 아래에서 끝나요. 드문 긴 턴이 더 높은 상한이 사는 것이에요:
모델 조합하기 (Combine models)
다중 모델 아키텍처는 작업 복잡성이 충분히 다양해서 서로 다른 단계를 서로 다른 모델이 가장 잘 처리하는 워크로드에 맞아요. 작은 모델이 안정적으로 처리하는 일상 작업과 프런티어 성능이 필요한 더 어려운 단계가 섞인 트래픽이라면, 작업을 분할하면 대부분의 토큰이 작은 모델 요율로 청구되면서 프런티어 지능이 필요한 곳에 유지돼요. 워크로드에 그런 혼합이 없을 때(난이도가 균일하거나 하나의 의존 체인이라면) 잘 조정된 단일 모델이 보통 더 나은 선택이에요. 각 전략 섹션은 두 경우를 구별하는 규칙을 제시해요.
두 전략이 대부분의 워크로드를 다루며, 어느 모델이 메인 루프를 잡는지에서 차이가 나요:
| 전략 | 제어 흐름 | 프런티어 모델의 역할 | 어울리는 곳 | 프런티어 비용이 확장되는 곳 |
|---|---|---|---|---|
| 어드바이저(Advisor) | 작은 모델이 루프를 돌리고 필요 시 에스컬레이션 | 계획과 수정을 위해 자문받음 | 몇 개의 실제 결정 사이에 코딩 에이전트의 많은 턴처럼 지점마다 어려운 직렬 작업 | 실행자가 갇히는 빈도 |
| 오케스트레이터(Orchestrator) | 프런티어 모델이 루프를 돌리고 대량 작업을 위임 | 계획, 파견, 종합 | 진정으로 독립적인 파일, 문서, 사례에 걸쳐 퍼지는 작업, 특히 컨텍스트 창 하나를 넘는 작업 | 조각들을 조정하기 어려운 정도 |
어드바이저 전략: 어려운 결정 에스컬레이션
어드바이저 전략에서는 저비용 실행자(executor) 모델이 에이전트 루프를 돌리고 대부분의 턴을 수행해요. 접근 방식을 고르거나 실패에서 회복하는 것처럼 더 깊은 판단이 필요한 결정에 부딪히면, 더 높은 지능의 어드바이저 모델을 불러 전략적 지침을 받은 뒤 계속해요. 대부분의 토큰은 실행자 요율로 청구되고, 가끔만 어드바이저 요율로 자문이 청구돼요.
사용하려면 요청에 어드바이저 도구를 추가하세요. 이 베타 기능은 전체 전략을 서버 측에서 단일 /v1/messages 요청으로 실행해요. 실행자가 도구 호출을 내고, Anthropic이 어드바이저 추론을 실행하며, 실행자가 그 조언으로 계속해요. 오케스트레이션 코드를 작성하지 않아도 돼요. Claude Managed Agents에서는 에이전트의 multiagent 로스터에 advisor 항목을 추가해 세션에 어드바이저를 부여하고, 세션의 기본 스레드가 같은 방식으로 자문해요. Claude Code도 지원해요. 어드바이저 도구로 어려운 결정 에스컬레이션을 참고하세요.
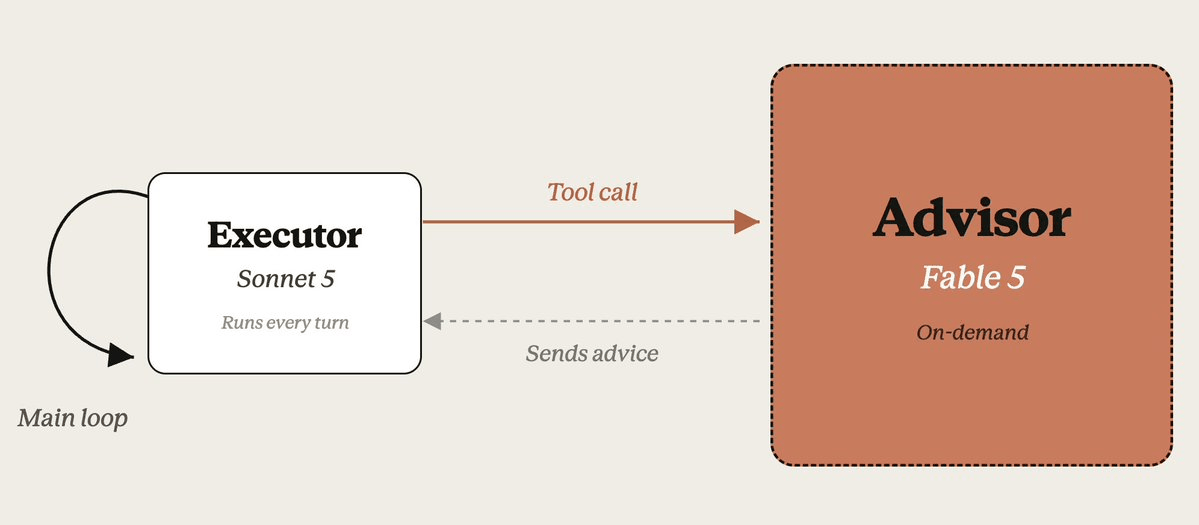
무엇이 보상을 정하나. 어드바이저는 실행자의 호출을 통해서만 작업을 보므로, 두 가지가 얼마나 도움이 되는지를 정해요.
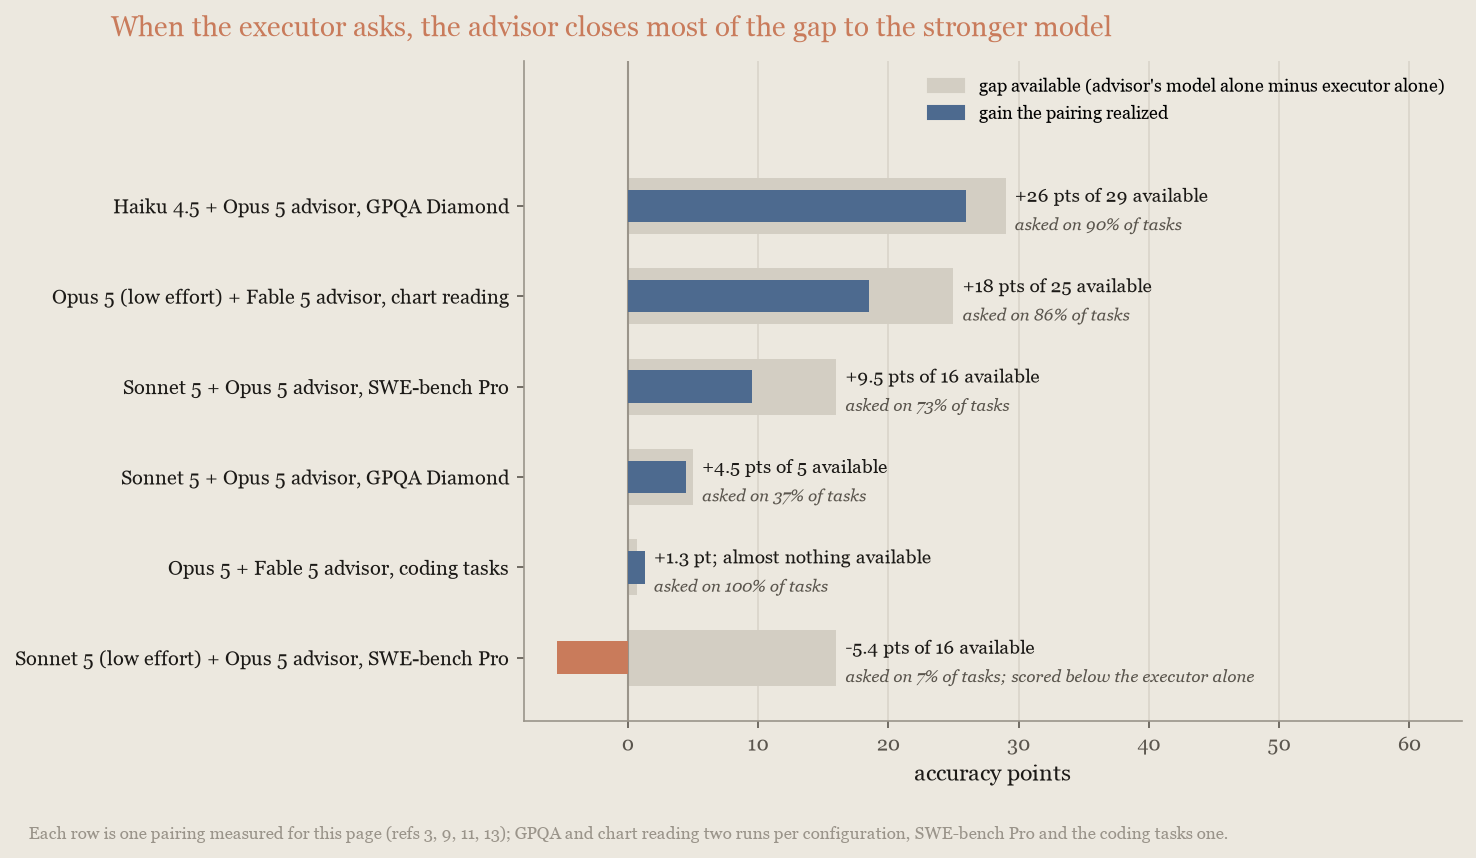
첫 번째는 모델 사이의 격차예요. 어드바이저는 실행자가 부족한 성능만 넘겨줄 수 있어요. GPQA Diamond9에서 Claude Haiku 4.5 실행자는 Claude Opus 5 어드바이저로부터 많은 것을 얻었고, Claude Sonnet 5 실행자는 몇 포인트를 얻었으며, 프런티어 실행자는 거의 아무것도 얻지 못했어요.
두 번째이자 깨지기 쉬운 것은 실행자가 실제로 묻는지(자문률, consult rate)예요. 낮은 effort의 실행자는 자기 자신이 갇힌 것을 감지하는 것을 멈출 수 있어요. 기본 effort에서 대부분의 작업에 자문하는 짝이 effort를 낮추면 거의 자문하지 않는 수준으로 떨어지고, 그러면 실행자 단독보다 낮은 점수를 내요. 이 비율은 작업에 따라도 달라져요. DeepSWE10에서는 저effort Sonnet 5 실행자가 계속 물으며 23포인트를 얻었지만, SWE-bench Pro3에서는 같은 실행자가 멈췄어요. 실행자가 물을 때는 격차의 많은 부분을 회복해요. 다음 차트에서 실행자가 계속 물은 짝들 전체에서, 어드바이저는 더 강한 모델로 가는 격차의 최소 절반을 메웠어요.(코딩 짝은 더 강한 모델을 완전히 이겼어요.) 그리고 자문에 대해서만 더 강한 모델 비용을 내므로, 이것이 비용 사례를 가능하게 해요.
자문률은 프롬프트에 반응해요. 도구의 내장 설명만 있으면 실행자(특히 코딩 작업에서)가 과소 호출하므로, 어드바이저 도구 문서는 실질 작업 전 한 번, 마무리 전 한 번, 작업당 약 2~3회 호출을 요청하는 시스템 프롬프트를 제공해요. 다음에 측정된 코딩 짝은 그 리듬, 즉 작업마다 약 2회 자문으로 실행됐어요. 그 페이지는 과소 호출 실행자를 부추기는 방법과 비용을 제한하기 위해 클라이언트 측에서 호출을 상한화하는 방법도 다뤄요. 그러니 자문률을 지켜보세요. 프롬프트로 끌어내고, 측정하고, 무너지면 실행자의 effort를 복원하세요.
비용 측면에서 언제 효과가 있나. 어드바이저는 어드바이저 요율로 청구되는 짧은 자문 몇 개가 전체 작업에 대해 어드바이저의 모델을 실행하는 것을 대체할 때 돈을 절약해요. 이는 어드바이저의 모델이 실행자보다 훨씬 높게 책정되었을 때 가장 잘 작동하고, 가장 비용 효율적인 구성은 중간 계층 실행자 위의 프런티어 어드바이저예요. 짝은 범위의 최상위에서도 견딜 수 있어요. 조언이 실행자 토큰도 절약하기 때문이에요. 올바른 접근을 들은 실행자는 더 적은 막다른 길을 탐색하며, 이는 자문을 덮을 수 있어요.
내부 에이전트 코딩 벤치마크11에서 플레인 API 에이전트로 실행했을 때, Claude Opus 5 실행자 + Claude Fable 5.1 어드바이저가 측정된 구성 중 가장 정확했고 시도당 7.69달러였어요. 이는 각 모델의 자체 effort 설정을 통한 선 위에 서 있어요. Opus 5 단독 기본값보다 약간 적은 돈으로 3.5포인트, 작업당 5회 시도가 노이즈와 구분해 주는 격차이며, 어드바이저의 모델 단독(약 절반의 추가 비용)보다 약 2.5포인트 높아요.
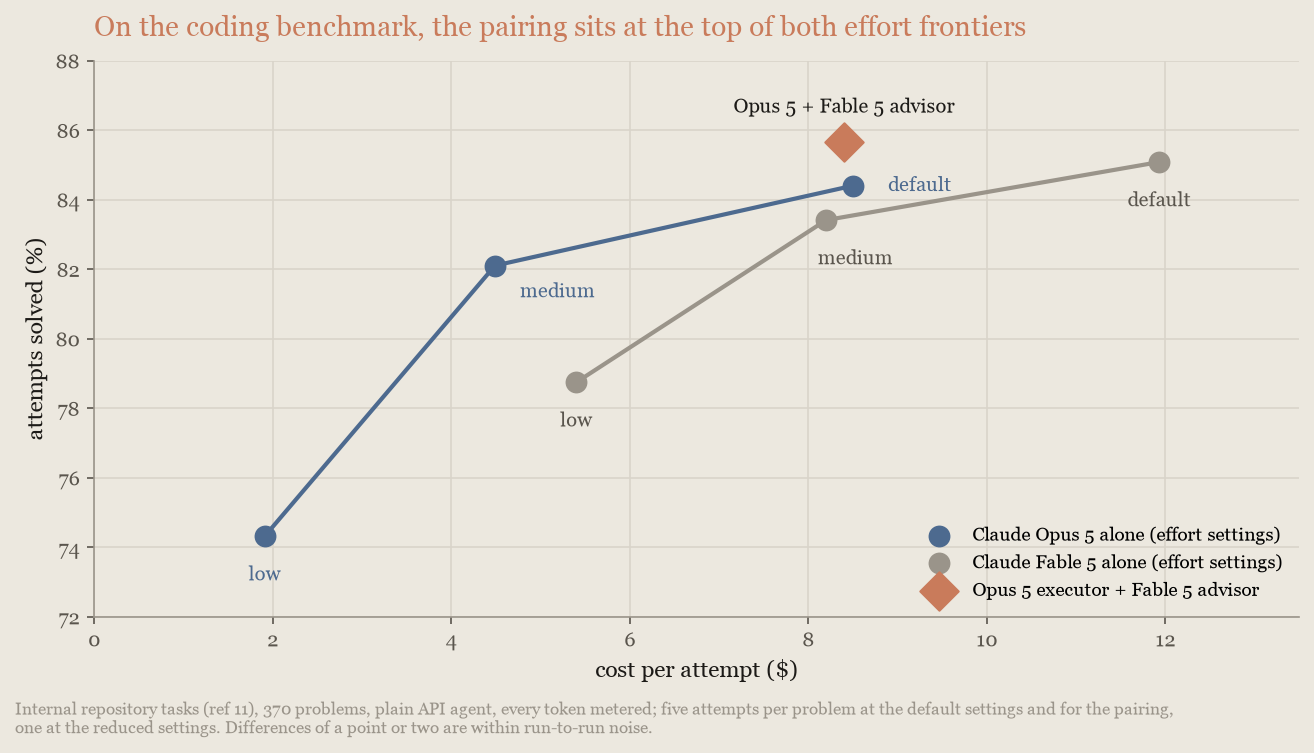
Claude Code의 어드바이저 모드를 통한 이전 측정도 같은 순서를 만들었어요. 이 결과를 자신의 워크로드에서 테스트할 형태로 읽으세요. 어드바이저는 실행자 자체 가격 정도로 몇 포인트를 사요. 더 넓은 성능 격차가 더 좋은 거래를 보장하지는 않아요. 지연 시간 비용은 자문 자체예요. 이 벤치마크에서 작업당 약 2회의 추가 프런티어 모델 호출이며, 각각 작업의 크리티컬 패스에 있어요.
더 강한 모델 단독이 더 좋은 단계일 때. 워크로드의 정확도가 effort에 반응한다면, 짝을 만들기 전에 어드바이저의 모델 단독을 줄인 설정과 비교하세요. 어드바이저는 필요할 때만 지불되지만, 대부분의 작업에서 발화하는 자문은 더 강한 모델 자체를 실행하는 것보다 더 비싸요. Chartography13에서 같은 짝은 작업당 비용의 약 2.6배로 Claude Fable 5.1 단독 medium과 실행 간 노이즈 범위 내에서 맞섰어요(65.0 대 67.5). 거의 모든 작업에서 어드바이저가 자문받았기 때문이에요. 먼저 자신의 자문률을 측정하세요. 실행자가 대부분의 작업에서 묻는다면, 전체 워크로드에 어드바이저 요율을 내는 것이고, 같은 점수로 가는 더 저렴한 길은 어드바이저의 모델 자체를 실행하는 것이에요.
어떤 짝이든 먼저 어드바이저의 모델 단독을 low effort로 가격을 매기세요. 그것이 이겨야 할 기준선이에요. 릴리스마다 성능 격차와 가격 비율을 모두 움직이므로, 매 모델 릴리스마다 다시 확인하세요.
언제 어울리나. 어드바이저 전략은 대부분의 턴이 기계적이지만 훌륭한 계획이 중요한 워크로드, 즉 코딩 에이전트, 컴퓨터 사용, 다단계 연구 파이프라인에 적합해요. 모든 턴이 진정으로 프런티어 성능을 필요로 하거나, 계획할 것이 없거나(단일 턴 Q&A), 실행자가 이미 어드바이저의 성능에 가깝다면 잘 맞지 않아요.
오케스트레이터 전략: 대량 작업 위임
오케스트레이터 전략에서는 프런티어 모델이 루프를 잡아요. 작업을 분해하고, 하위 작업을 저비용 워커 모델에게 파견하며, 그 결과를 병합해요. 워커가 토큰이 무거운 탐색을 흡수하므로 오케스트레이터 자신의 대본은 짧게 유지되고, 대부분의 토큰은 워커 요율로 청구되면서 계획과 종합은 여전히 프런티어 모델에서 나와요.
만들려면 Claude Managed Agents의 멀티에이전트 오케스트레이션을 사용하세요. 각각 자체 모델을 가진 코디네이터 에이전트(오케스트레이터)와 워커 에이전트 로스터를 구성해요. 프런티어 코디네이터와 Claude Sonnet 5 워커가 있는 완전한 작동 예시는 Claude Cookbook 레시피 Coordinator pattern: big models for planning, small models for execution을 참고하세요.
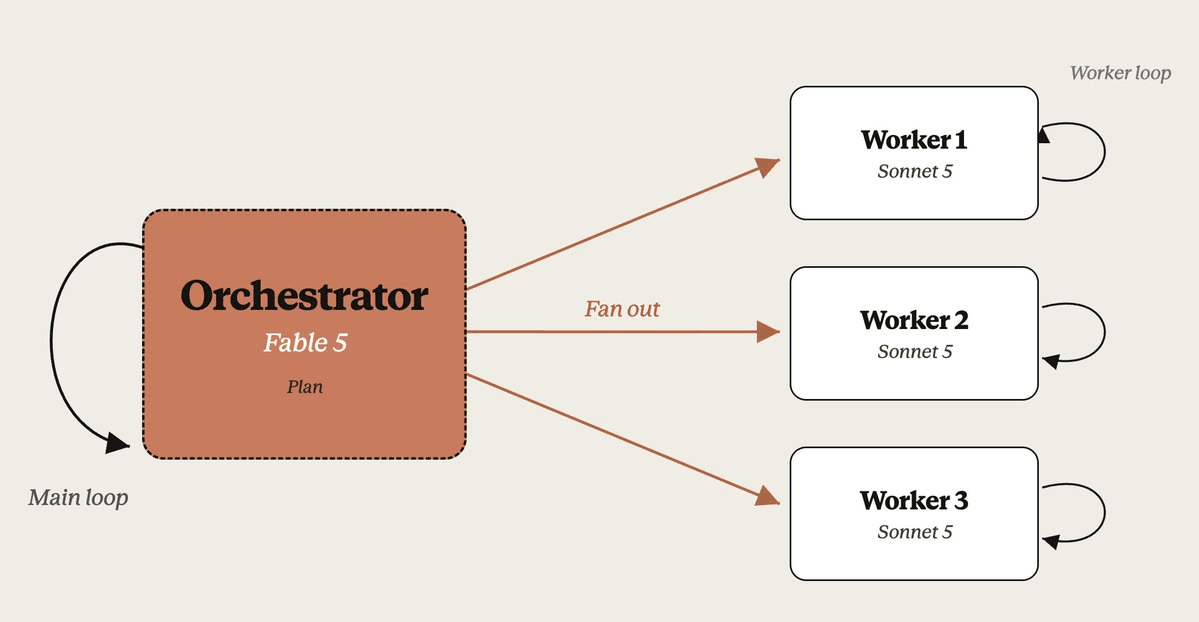
이 패턴은 워커가 병렬로 실행될 수 있을 때 벽시계 시간을 절약해요. 코퍼스 벤치마크에서 코디네이터가 플랫폼의 문서화된 한도인 25개 동시 워커로 실행하면 에피소드가 약 2.3시간 걸렸고, 솔로는 15~20시간이었어요. 돈을 절약한 경우는 측정된 두 상황뿐이었어요. 단일 모델이 혼자 처리할 수 있는 작업에서는, 같은 모델을 낮은 effort로 쓰는 것이 매번 더 저렴했어요.
사례 1: 일상 작업의 비용 꼬리에 대한 보험. 프런티어 모델 단독은 보통 해결할 일상적인 문제에서 가끔 나선형을 그려요. 어떤 것이 그럴지 미리 알 수 없으므로, 그런 실행 몇 개가 청구액을 지배해요. 일상 작업을 저비용 워커에게 넘기는 코디네이터는 그 꼬리를 상한화해요. 어떤 나선형이든 이제 워커 요율로 발생하니까요.
Anthropic은 BrowseComp4의 의도적으로 쉬운 조각(솔로 모델이 안정적으로 해결하는 10문제, 위임 50회, 솔로 70회)에서 이를 측정했어요. 하나의 Claude Sonnet 5 워커가 있는 Claude Fable 5 코디네이터는 평균적으로 Claude Fable 5 단독의 약 절반, 90번째 백분위에서는 약 3분의 1(33달러 대비 12달러)이 들었고, 솔로 모델의 가장 비싼 단일 실행(84달러)은 틀리기도 했어요:
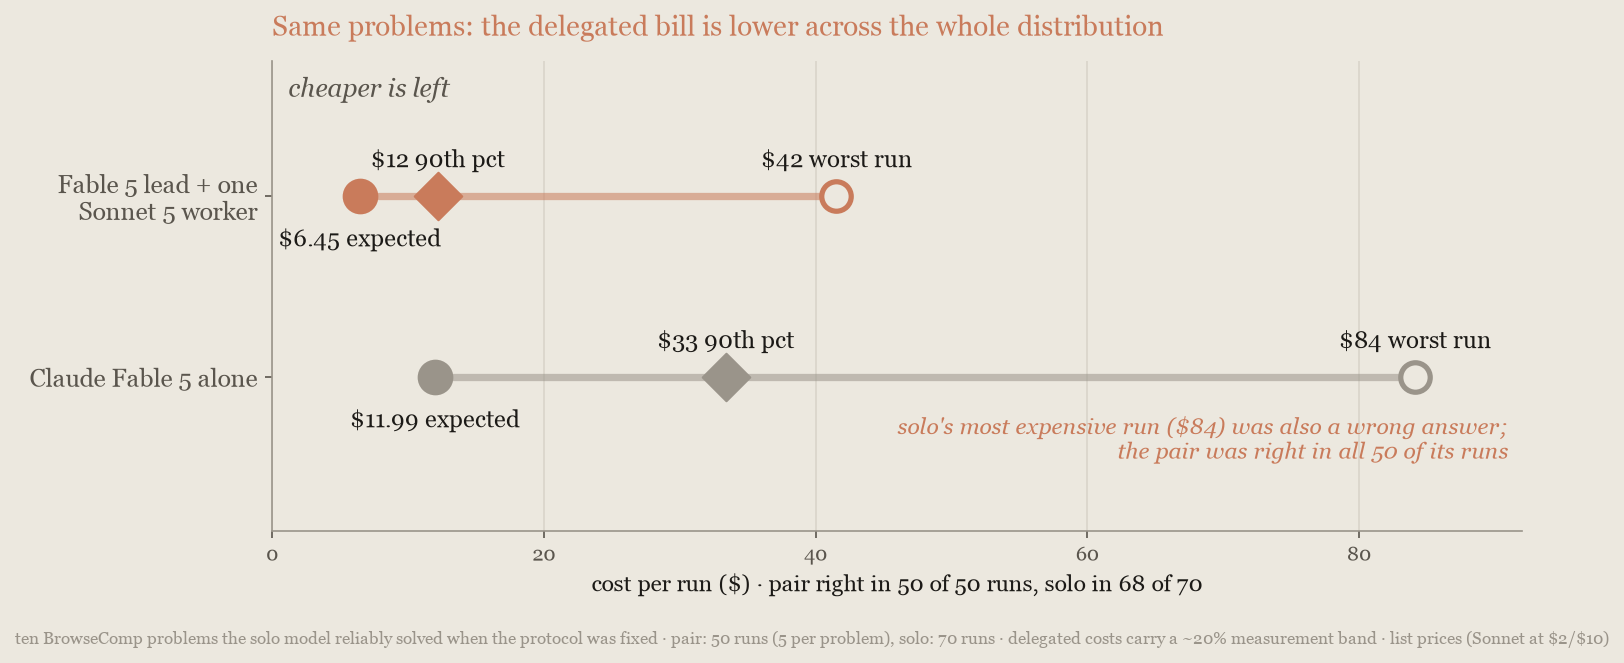
위임은 어려운 문제에 워커를 쓰라는 직관과 반대로, 일상적이고 보통 해결 가능한 작업 몫에서 효과가 있었어요. 더 어렵고 완전한 BrowseComp 세트에서는 경제성이 뒤집혔어요. 트래픽이 일상 작업에 긴 비용 꼬리가 있다면 이것이 먼저 측정할 오케스트레이터 사례예요.
사례 2: 컨텍스트 창 하나보다 큰 작업. 솔로 모델은 그렇게 큰 입력을 직렬로, 컨텍스트 창 하나씩 처리해야 하고, 매 패스마다 자신의 상태를 다시 읽는 비용을 내요. 워커는 각자 자신의 파티션을 병렬로, 워커 요율로 읽어요. 여전히 컨텍스트 창 하나에 맞는 읽기 중심 작업은 위임 문제가 아니라 모델 선택 문제예요. 읽기 비용만으로는, 단일 컨텍스트가 작업을 담을 수 없을 때만 오케스트레이터가 앞서요.
Anthropic은 이 사례를 위한 벤치마크를 만들었어요8. 130개의 심어진 결함이 있는 14개 공개 Python 패키지로 된 2,160만 토큰 코퍼스로, 어떤 컨텍스트 창에도 너무 커요. effort를 낮추는 것은 도움이 안 돼요. 청구액이 코퍼스 읽기 자체이기 때문이에요. Claude Fable 5.1 솔로는 세 effort 설정에서 에피소드당 468552달러가 들었고 정확도만 움직였어요. 25개 Claude Sonnet 5 워커를 이끄는 Claude Fable 5.1 코디네이터 구성은 그 설정들의 약 절반(47%20시간 대신 약 2.3시간에 냈으며, Claude Sonnet 5 솔로 기준선을 완전히 이겼어요:55% 덜)이 들었고, 그들보다 1012포인트 낮은 점수를, 에피소드당 15
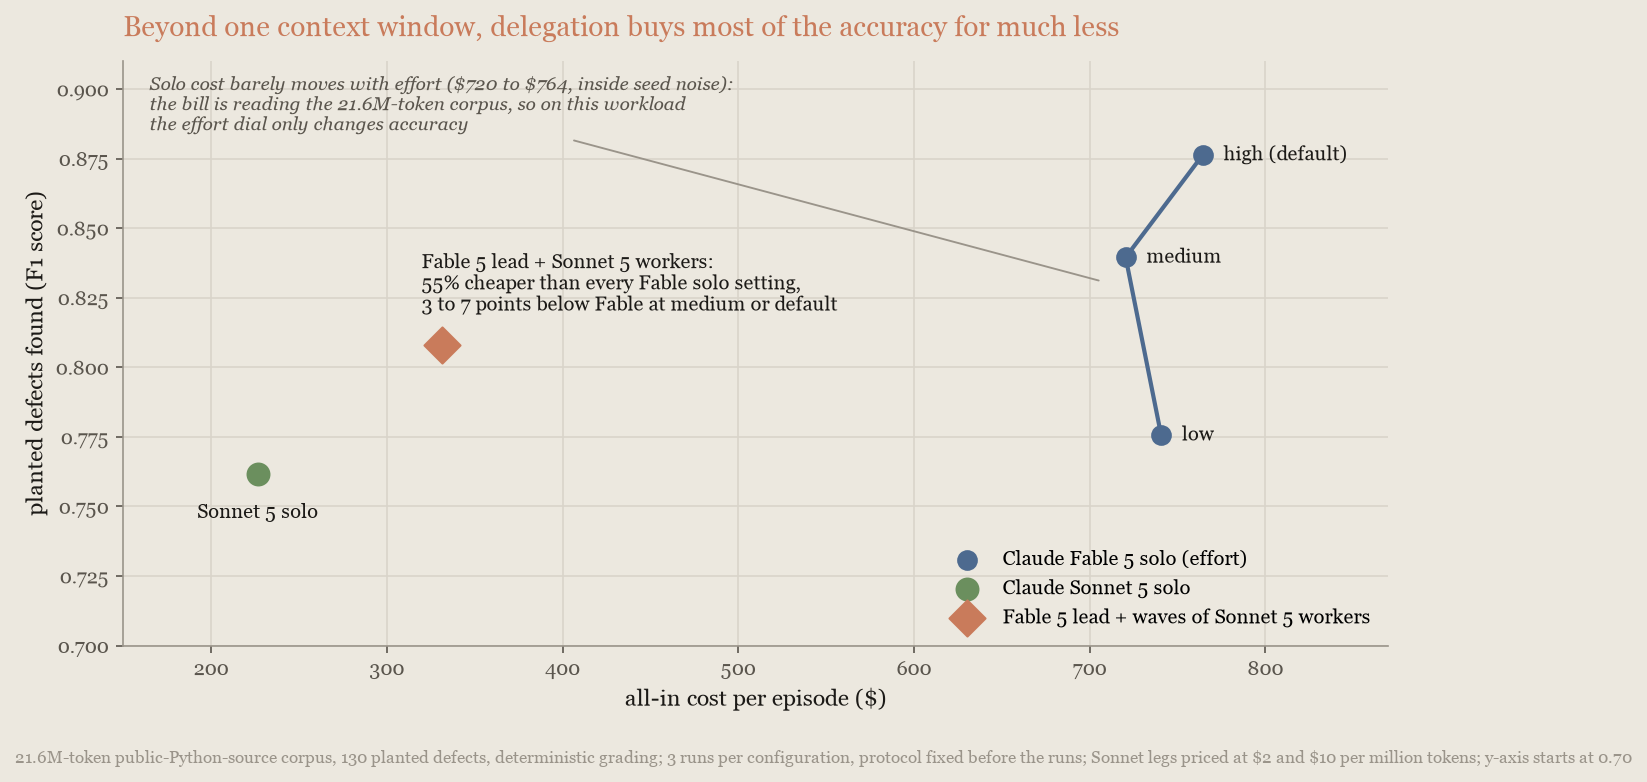
토큰 회계가 읽기 규모를 보여줘요. 코디네이터 구성은 에피소드당 약 5억 6천만 캐시 토큰을 읽었고, 솔로 모델의 약 3억 6천 5백만의 약 1.5배이며, 거의 모두 Claude Sonnet 5의 캐시 읽기 요율이었지만 여전히 전체적으로 약 절반 비용이 들었어요. high effort의 Fable 5.1이 여전히 최고 정확도를 유지하며, 코디네이터 구성 비용의 약 2.2배가 들므로, 위임은 여기서 정확도의 대부분을 사지 전부는 사지 않아요.
위임이 효과가 없을 때. 오케스트레이터는 넘겨줄 대량이 있을 때만 무언가를 사요. 많은 독립적인 조각, 이상적으로는 컨텍스트 창 하나에 너무 많은 조각이요. 작업이 하나의 의존 체인이거나 단일 컨텍스트에 맞을 때, 오케스트레이터는 단일 모델이 공짜로 얻는 계획, 인계, 병합에 돈을 내요. 측정된 그런 모든 사례에서 코디네이터의 모델 단독을 낮은 effort로 쓰는 것이 앞섰어요.
경계는 벤치마크가 아니라 작업 난이도예요. 완전하고 더 어려운 BrowseComp4 세트에서 Claude Fable 5 단독은 코디네이터 구성의 정확도에 22%~30% 낮은 비용으로 도달했어요. 독립적인 외부 연구도 같은 패턴을 보고해요5. 작업이 하나의 체인이거나, 긴 비용 꼬리 없이 하나의 컨텍스트에 맞거나, 낮은 effort의 단일 모델이 이미 기준을 충족한다면, 오케스트레이터를 만들지 마세요.
전략 사이에서 고르기
대부분의 경우는 한 질문으로 귀결돼요. 작업이 독립적인 조각으로 나뉘나요, 아니면 의존 단계의 체인을 통한 하나의 답인가요? 전략 표가 두 답을 두 전략에 매핑해요.
확실하지 않다면 아직 아무것도 만들지 마세요:
- 먼저 현재 모델에서 effort를 스윕하세요. 이 페이지에서 가장 저렴한 실험이며, 대부분의 워크로드가 거기서 끝나요.
- 스윕이 격차를 보여주면, 더 강한 모델 단독을
loweffort로 가격을 매기세요. 그것이 어드바이더 짝이 이겨야 하는 숫자이며, 이 페이지에서 이긴 짝들은 실행자가 실제로 자문한 것이었어요.
이 페이지의 다중 모델 결과는 같은 모델을 낮은 effort로 쓴 것과, 그다음 아래 모델을 단독으로 실행한 것에 대비해 판단됐어요. 그것이 자신의 워크로드에서 실행할 비교이며, 첫 단계가 effort 스윕인 이유예요.
어드바이저를 추가할 때는 재아키텍처가 아니라 도구 정의로 추가해요.
자신의 워크로드에서 측정하기
이 페이지의 숫자는 측정 당시의 목록 가격을 반영하며 모델과 가격이 변함에 따라 달라져요. 당신의 에스컬레이션율, 작업이 얼마나 깔끔하게 나뉘는지, 대본 길이도 그것을 움직여요. 방법은 동일해요:
- 프로덕션 로그에서 실제 트래픽처럼 가중된 작업 몇 개를 뽑아 각각 결과 검사를 작성하세요. 테스트 통과, 티켓 종결, 행 개수 정확 등요. 각 응답의
usage에 있는 다섯 개 청구가능 토큰 개수를 각자의 요율(캐시되지 않은 입력, 5분·1시간 캐시 쓰기는 입력 가격의 1.25배·2배, 캐시 읽기, 출력)로 가격을 매기고 작업의 요청에 걸쳐 합산해 점수 옆에 작업당 비용을 기록하세요(Usage and Cost API가 집계를 보고해요). - 기본값만이 아니라 effort 수준 전반에 걸쳐 모델 티어의 기준선을 잡고 점수 대 지출을 그래프로 그리세요. 다중 모델 구성은 단일 모델의 전체 곡선을 이겨야 해요.
- 곡선이 effort로 닫을 수 없는 격차를 보여주면, 어울리는 다중 모델 전략을 추가하고 제품군을 다시 실행하세요.
- 전환 전에 트래픽 조각에서 승자를 섀도우로 실행하고, 제품군을 계속 실행하세요.
다음 예는 한 요청의 1단계 비용을 Claude Opus 5의 목록 가격으로 계산해요:
response=$(curl --fail-with-body -sS https://api.anthropic.com/v1/messages
-H "x-api-key: $ANTHR...KEY"
-H "anthropic-version: 2023-06-01"
-H "content-type: application/json"
-d '{
"model": "claude-opus-5",
"max_tokens": 1024,
"messages": [{"role": "user", "content": "Hello, Claude"}]
}')
cost=$(jq -r --argjson in_price "$INPUT_PER_MTOK" --argjson read_price "$CACHE_READ_PER_MTOK" --argjson out_price "$OUTPUT_PER_MTOK" ' .usage | (.input_tokens * $in_price + (.cache_creation.ephemeral_1h_input_tokens // 0) * $in_price * 2.00 # 1-hour cache write + (.cache_creation.ephemeral_5m_input_tokens // 0) * $in_price * 1.25 # 5-minute cache write + (.cache_read_input_tokens // 0) * $read_price # cache read + .output_tokens * $out_price) / 1e6 ' <<<"$response") printf 'Request cost: $%.6f\n' "$cost"
```bash CLI
# 가격 페이지의 백만 토큰당 가격, 다른 모델은 이 세 개를 바꾸세요.
INPUT_PER_MTOK=5.00 # Claude Opus 5
CACHE_READ_PER_MTOK=0.50 # Claude Opus 5에서 입력 가격의 0.1배, 일부 모델은 다른 배수 사용
OUTPUT_PER_MTOK=25.00

USAGE=$(ant messages create \
  --model claude-opus-5 \
  --max-tokens 1024 \
  --message '{role: user, content: "Hello, Claude"}' \
  --transform usage)

COST=$(jq -r --argjson in_price "$INPUT_PER_MTOK" --argjson read_price "$CACHE_READ_PER_MTOK" --argjson out_price "$OUTPUT_PER_MTOK" '
  (.input_tokens * $in_price
    + (.cache_creation.ephemeral_1h_input_tokens // 0) * $in_price * 2.00  # 1-hour cache write
    + (.cache_creation.ephemeral_5m_input_tokens // 0) * $in_price * 1.25  # 5-minute cache write
    + (.cache_read_input_tokens // 0) * $read_price                   # cache read
    + .output_tokens * $out_price) / 1e6
' <<<"$USAGE")
printf 'Request cost: $%.6f\n' "$COST"
# 가격 페이지의 백만 토큰당 가격, 다른 모델은 이 세 개를 바꾸세요.
INPUT_PER_MTOK = 5.00  # Claude Opus 5
# Claude Opus 5에서 입력 가격의 0.1배, 일부 모델은 다른 배수 사용
CACHE_READ_PER_MTOK = 0.50
OUTPUT_PER_MTOK = 25.00

client = anthropic.Anthropic()
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Hello, Claude"}],
)
usage = response.usage
cache_writes = usage.cache_creation
writes_1h = cache_writes.ephemeral_1h_input_tokens if cache_writes else 0
writes_5m = cache_writes.ephemeral_5m_input_tokens if cache_writes else 0
cost = (
    usage.input_tokens * INPUT_PER_MTOK
    # 1시간 캐시 쓰기는 입력 가격의 2배, 5분 캐시는 1.25배, 읽기는 캐시 읽기 가격 청구.
    + writes_1h * INPUT_PER_MTOK * 2.0
    + writes_5m * INPUT_PER_MTOK * 1.25
    + (usage.cache_read_input_tokens or 0) * CACHE_READ_PER_MTOK
    + usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
print(f"Request cost: ${cost:.6f}")
// 가격 페이지의 백만 토큰당 가격, 다른 모델은 이 세 개를 바꾸세요.
const INPUT_PER_MTOK = 5.0; // Claude Opus 5
const CACHE_READ_PER_MTOK = 0.5; // Claude Opus 5에서 입력 가격의 0.1배, 일부 모델은 다른 배수 사용
const OUTPUT_PER_MTOK = 25.0;

const client = new Anthropic();
const response = await client.messages.create({
  model: "claude-opus-5",
  max_tokens: 1024,
  messages: [{ role: "user", content: "Hello, Claude" }]
});
const usage = response.usage;
const cost =
  (usage.input_tokens * INPUT_PER_MTOK +
    (usage.cache_creation?.ephemeral_1h_input_tokens ?? 0) * INPUT_PER_MTOK * 2 + // 1-hour cache write
    (usage.cache_creation?.ephemeral_5m_input_tokens ?? 0) * INPUT_PER_MTOK * 1.25 + // 5-minute cache write
    (usage.cache_read_input_tokens ?? 0) * CACHE_READ_PER_MTOK + // cache read
    usage.output_tokens * OUTPUT_PER_MTOK) /
  1_000_000;
console.log(`Request cost: $${cost.toFixed(6)}`);
// 가격 페이지의 백만 토큰당 가격, 다른 모델은 이 세 개를 바꾸세요.
const double InputPerMtok = 5.00; // Claude Opus 5
const double CacheReadPerMtok = 0.50; // Claude Opus 5에서 입력 가격의 0.1배, 일부 모델은 다른 배수 사용
const double OutputPerMtok = 25.00;

AnthropicClient client = new();
var response = await client.Messages.Create(
    new MessageCreateParams
    {
        Model = Model.ClaudeOpus5,
        MaxTokens = 1024,
        Messages = [new() { Role = Role.User, Content = "Hello, Claude" }],
    }
);
var usage = response.Usage;
double cost =
    (
        usage.InputTokens * InputPerMtok
        + (usage.CacheCreation?.Ephemeral1hInputTokens ?? 0) * InputPerMtok * 2.00 // 1-hour cache write
        + (usage.CacheCreation?.Ephemeral5mInputTokens ?? 0) * InputPerMtok * 1.25 // 5-minute cache write
        + (usage.CacheReadInputTokens ?? 0) * CacheReadPerMtok // cache read
        + usage.OutputTokens * OutputPerMtok
    ) / 1_000_000;
Console.WriteLine($"Request cost: ${cost:F6}");
// 가격 페이지의 백만 토큰당 가격, 다른 모델은 이 세 개를 바꾸세요.
const (
	inputPerMTok     = 5.00 // Claude Opus 5
	cacheReadPerMTok = 0.50 // Claude Opus 5에서 입력 가격의 0.1배, 일부 모델은 다른 배수 사용
	outputPerMTok    = 25.00
)

// ...
	client := anthropic.NewClient()

	response, err := client.Messages.New(context.TODO(), anthropic.MessageNewParams{
		Model:     anthropic.ModelClaudeOpus5,
		MaxTokens: 1024,
		Messages: []anthropic.MessageParam{
			anthropic.NewUserMessage(anthropic.NewTextBlock("Hello, Claude")),
		},
	})
	if err != nil {
		log.Fatal(err)
	}

	usage := response.Usage
	cost := (float64(usage.InputTokens)*inputPerMTok +
		float64(usage.CacheCreation.Ephemeral1hInputTokens)*inputPerMTok*2.00 + // 1-hour cache write
		float64(usage.CacheCreation.Ephemeral5mInputTokens)*inputPerMTok*1.25 + // 5-minute cache write
		float64(usage.CacheReadInputTokens)*cacheReadPerMTok + // cache read
		float64(usage.OutputTokens)*outputPerMTok) / 1_000_000
	fmt.Printf("Request cost: $%.6f\n", cost)
// 가격 페이지의 백만 토큰당 가격, 다른 모델은 이 세 개를 바꾸세요.
static final double INPUT_PER_MTOK = 5.00; // Claude Opus 5
static final double CACHE_READ_PER_MTOK = 0.50; // Claude Opus 5에서 입력 가격의 0.1배, 일부 모델은 다른 배수 사용
static final double OUTPUT_PER_MTOK = 25.00;

void main() {
    AnthropicClient client = AnthropicOkHttpClient.fromEnv();

    Message response = client.messages().create(MessageCreateParams.builder()
        .model(Model.CLAUDE_OPUS_5)
        .maxTokens(1024)
        .addUserMessage("Hello, Claude")
        .build());

    Usage usage = response.usage();
    long writes1h = usage.cacheCreation().map(CacheCreation::ephemeral1hInputTokens).orElse(0L);
    long writes5m = usage.cacheCreation().map(CacheCreation::ephemeral5mInputTokens).orElse(0L);
    double cost = (usage.inputTokens() * INPUT_PER_MTOK
        + writes1h * INPUT_PER_MTOK * 2.00 // 1-hour cache write
        + writes5m * INPUT_PER_MTOK * 1.25 // 5-minute cache write
        + usage.cacheReadInputTokens().orElse(0L) * CACHE_READ_PER_MTOK // cache read
        + usage.outputTokens() * OUTPUT_PER_MTOK) / 1_000_000;
    IO.println("Request cost: $%.6f".formatted(cost));
}
// 가격 페이지의 백만 토큰당 가격, 다른 모델은 이 세 개를 바꾸세요.
const INPUT_PER_MTOK = 5.00; // Claude Opus 5
const CACHE_READ_PER_MTOK = 0.50; // Claude Opus 5에서 입력 가격의 0.1배, 일부 모델은 다른 배수 사용
const OUTPUT_PER_MTOK = 25.00;

$client = new Client();
$response = $client->messages->create(
    model: 'claude-opus-5',
    maxTokens: 1024,
    messages: [['role' => 'user', 'content' => 'Hello, Claude']],
);
$usage = $response->usage;
$cost = (
    $usage->inputTokens * INPUT_PER_MTOK
    + ($usage->cacheCreation?->ephemeral1hInputTokens ?? 0) * INPUT_PER_MTOK * 2.00 // 1-hour cache write
    + ($usage->cacheCreation?->ephemeral5mInputTokens ?? 0) * INPUT_PER_MTOK * 1.25 // 5-minute cache write
    + ($usage->cacheReadInputTokens ?? 0) * CACHE_READ_PER_MTOK // cache read
    + $usage->outputTokens * OUTPUT_PER_MTOK
) / 1_000_000;
printf("Request cost: \$%.6f\n", $cost);
# 가격 페이지의 백만 토큰당 가격, 다른 모델은 이 세 개를 바꾸세요.
INPUT_PER_MTOK = 5.00 # Claude Opus 5
CACHE_READ_PER_MTOK = 0.50 # Claude Opus 5에서 입력 가격의 0.1배, 일부 모델은 다른 배수 사용
OUTPUT_PER_MTOK = 25.00

client = Anthropic::Client.new
response = client.messages.create(
  model: "claude-opus-5",
  max_tokens: 1024,
  messages: [{ role: "user", content: "Hello, Claude" }]
)
usage = response.usage
cost = (
  usage.input_tokens * INPUT_PER_MTOK +
  usage.cache_creation&.ephemeral_1h_input_tokens.to_i * INPUT_PER_MTOK * 2.00 + # 1-hour cache write
  usage.cache_creation&.ephemeral_5m_input_tokens.to_i * INPUT_PER_MTOK * 1.25 + # 5-minute cache write
  usage.cache_read_input_tokens.to_i * CACHE_READ_PER_MTOK + # cache read
  usage.output_tokens * OUTPUT_PER_MTOK
) / 1_000_000
puts format("Request cost: $%.6f", cost)
에이전트 루프에서 캐시 읽기 항목이 보통 다섯 중 가장 커요. 그렇지 않으면 캐싱이 켜져 있는지 확인하세요. 어드바이저 도구나 컴팩션이 활성화되면 일부 토큰은 usage.iterations에만 보고되고 최상위 합계에는 없으므로, usage.iterations에 걸쳐 합산하되 advisor_message 항목은 어드바이저 모델 요율로 가격을 매기세요.
다음 표는 시도할 순서대로 레버를 나열해요:
| 레버 | 이 실행들에서의 절약 | 품질 비용 | 지연 시간 | 자세히 보기 |
|---|---|---|---|---|
| 프롬프트 캐싱 | 에이전트 루프에서 비용을 2.7~5.3배 절감, 트리아지 실행에서 83% | 없음 | 더 빠름 | 반복 컨텍스트 캐싱 |
| 1시간 캐시 지속 시간 | 약 20턴 중 1턴이 5분~1시간 사이의 대기 뒤에 오고 1시간 초과 간격이 드물면 5분 기본값보다 저렴, 단 Claude Fable 5.1은 대기가 몇 분일 때 5분 캐시 유지가 저렴하고 대기가 1시간에 가까우면 1시간 지속 시간 승리, 대기 없음 시 기본값이 Claude Sonnet 5에서 15%, Claude Opus 5에서 11% 저렴 | 없음 | 대기 후에도 웜 유지 | 캐시 지속 시간 고르기 |
| 입력 정리 | 트리아지 실행에서 추가 5포인트 | 없음 | 중립 | 입력 및 컨텍스트 토큰 정리 |
| 작업 경계에서 오래된 도구 결과 프루닝 | 긴 트리아지 실행에서 39%(컴팩션 32%), 짧은 루프에서는 없음 | 측정된 것 없음 | 중립 | 입력 및 컨텍스트 토큰 정리 |
| 도구 검색 | 도구 정의 500개일 때 45%, GitHub MCP 서버일 때 20% | 없음 | 중립 | 입력 및 컨텍스트 토큰 정리 |
| 코드 실행을 통한 데이터 파일 | 25질문 데이터 작업에서 92% | 이득, 25개 중 25개(6개 대신) | 더 빠름 | 입력 및 컨텍스트 토큰 정리 |
| Batch API | 50% | 없음 | 24시간 내 결과 | 기다려도 되는 작업 배치 처리 |
| 현재 모델에 대한 프롬프트 감사 | 측정된 두 마이그레이션 모두 14% | 없음, 하나는 이득 | 더 빠름(도구 라운드 감소) | 현재 모델에 대한 프롬프트 감사 |
| 모델 업그레이드 | Opus 4.8→Opus 5: 해결 작업당 21% 더 비싸게 12포인트(Opus 5 low가 비용의 약 30%로 Opus 4.8 이김), Sonnet 4.6→Sonnet 5: 해결 작업당 15% 저렴, 5포인트, Fable 5→Fable 5.1: 거의 같은 점수에서 해결 작업당 43% 저렴 |
이득 | 중립 | 모델 업그레이드 |
| 낮은 effort | 지식 작업: medium 13%low 3분의 1medium 약 절반, low 약 4분의 3 |
지식 작업에서 1 |
더 빠름 | Effort 조정 |
| 실패 재실행 | 같은 통과율에서 약 절반 | 없음 | 실패하는 작업에서 두 번 실행 | 더 높은 effort에서 실패 재실행 |
| 작업 예산 | 44%~58% | 3~6포인트 | 더 빠름 | 예산 및 출력 상한 설정 |
| 더 짧은 답 요청 | 트리아지 실행에서 출력 토큰 39%, 비용 14% | 없음 | 더 빠름 | 예산 및 출력 상한 설정 |
max_tokens 올리기 |
해결 작업당 없음, 하지만 더 많은 작업 해결 | 내부 세트에서 최대 22포인트 이득, 공개 쌍에서는 없음 | 중립 | 예산 및 출력 상한 설정 |
| 어드바이저 | 성능 격차와 자문률에 따라 다름, 코딩 짝은 Opus 5 단독보다 3.5포인트, Fable 5.1 단독보다 약 2.5포인트, 차트 읽기 짝은 약 2.6배 가격으로 medium에서 어드바이저 모델 단독을 맞춤 |
작은 이득 | 작업당 약 2회 추가 호출 | 어드바이저 전략 |
| 오케스트레이터 | 프런티어 모델 대비 약 절반, 컨텍스트 창 하나 초과와 일상 꼬리 모두(후자는 Claude Fable 5로 측정) | 프런티어 모델보다 10~12포인트 낮음 | 큰 입력에서 훨씬 빠름 | 오케스트레이터 전략 |
참조된 벤치마크
참조가 달리 말하지 않는 한, 측정은 이 벤치마크들의 Anthropic 내부 실행이에요. 별도 언급이 없으면 비용은 각 벤치마크가 실행된 당시의 목록 가격 기준 USD이며, Claude Sonnet 5 수치는 입력·출력 토큰당 2달러와 10달러를 사용해요. "notional USD"로 표시된 차트는 송장이 아니라 그 요율로 각 요청의 토큰 개수를 가격을 매겨요.
- WideSearch: Wong 등, "WideSearch: Benchmarking Agentic Broad Info-Seeking," arXiv:2508.07999, 2025. 많은 행의 표 완전성과 정확성으로 평가되는 광범위 웹 연구 작업, 200문제, 구성당 3회 실행, 2026년 8월 1
2일 실행. 비용 집중 차트는 별도 20문제 실행(문제당 3회, 2026년 8월 34일)이며 요청별 청구 기록으로 비용 계산됨. - GDPval: OpenAI, "GDPval: Evaluating AI Model Performance on Real-World Economically Valuable Tasks," 2025. 작업 루브릭에 대해 평가되는 지식 작업 산출물, 공개 골드 세트의 210작업 실행(작업당 1회 시도), 2026년 8월 2일 실행. 클로드 모델이 평가하므로 절대 점수가 공개 결과와 다를 수 있음.
- SWE-bench Pro: Scale AI, "SWE-Bench Pro: Can AI Agents Solve Long-Horizon Software Engineering Tasks?", 2025. Anthropic 평가 하네스와 호환되도록 선택된 482문제 부분집합, 점수는 공개 리더보드와 비교 불가. 기본 effort의 Claude Opus 5는 2회 실행 평균, 축소 effort 설정은 1회 실행, 모두 2026년 8월 4일 실행. 에스컬레이션 수치는 그 실행들에서 작업별로 나옴:
low먼저 후 실패에 기본값 적용 시 실행 쌍 전체에서 92.5%~93.6%를 약 0.45달러에,medium먼저 시 93.8%~94.2%를 약 0.61달러에, 기본값이 자체 실패 재실행 시 94.0%를 1.06달러에, 전부 기본값 시 90.9%92.5%를 0.93달러에 해결. 이 부분집합의 비용은 고객 조직이 계량되는 방식으로 가격 책정됨(각 요청의 이전 프롬프트를 캐시 읽기로, 새 토큰을 5분 캐시 쓰기로, 실행 자체 사용 기록에서 고객 원장과 대조 확인), 8,192토큰 페이지로 캐시를 청구하는 평가 조직 자체 계량은 1.41.8배 높은 수치를 냄. 어드바이저 차트의 Claude Sonnet 5 실행자 짝은 이 부분집합의 같은 측정 시리즈에서 나옴(Sonnet+Opus 짝 2회 실행(2026년 8월 7·8일, 실행과 정확한 복제), 저effort 짝 1회(2026년 8월 8일), Claude Sonnet 5 단독 2회(77.4%, 두 Pro 행의 기준선)). 모델 업그레이드의 Claude Fable 5 포인트는 기본 effort에서 3회 실행의 평균이며, 2026년 8월 26일 실행, 같은 방식으로 가격 책정. Claude Fable 5.1 작업 예산 수치는 같은 부분집합에서 기본 effort의 예산당 1회 실행(35,000토큰에서 2회)이며, 2026년 8월 26일 실행, 같은 날 예산 없는 실행(92.1%, 작업당 1.10달러)이 기준선, 이전loweffort 세트(2026년 8월 21일)는 예산 없이 작업당 0.48달러로 88.6% 기록. 모델 비교 비교는 ... [truncated] - BrowseComp: Wei 등, "BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents," OpenAI, 2025. Effort 수치는 500문제 컷으로 설정당 1
3회, 2026년 8월 3일 실행, 기본 포인트는 2026년 7월 2627일의 두 실행을 풀링. 비용 보험 차트는 26문제 조각에서 확실히 해결되는 10문제, 위임 50회(2026년 8월 12일)와 솔로 70회(50회는 2026년 8월 23일, 20회는 2026년 7월 12~13일과 8월 1일 보관)를 사용, 기대값으로 회당 6.45달러 대 11.99달러, 위임 수치에는 약 20% 측정 대역 포함. - Agent-architecture scaling: Kim 등, "Towards a Science of Scaling Agent Systems," arXiv:2512.08296, 2025. 독립 외부 연구이며, 위임이 효과가 없을 때에 대한 발견의 방향에 대해서만 인용되고 어떤 수치에도 인용되지 않음.
- DeepWideSearch: "DeepWideSearch: Benchmarking Depth and Width in Agentic Information Seeking," arXiv:2510.20168, 2025. 220개 질문이 15개 도메인에 걸쳐 있으며 각각 많은 행 수집과 다중 홉 검색을 결합, 벤치마크의 상설 행 세트에서 측정, 구성당 3회, 2026년 8월 2일 실행(단일 워커 팀 포인트는 2026년 7월 26~27일).
- DeepResearch Bench II: Li 등, "DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Report," arXiv:2601.08536, 2026. 22개 도메인의 132개 연구 작업을 전문가 도출 이진 루브릭으로 평가, 모든 테마에 걸쳐 계층화된 50작업 부분집합에서 측정(작업당 1회, 설정당 3회), Claude Managed Agents에서 플랫폼 자체 웹 검색·가져오기 도구 사용(2026년 8월 26
27일), 어떤 구성도 거부하지 않은 33개 작업 기준으로 점수, 프로덕션 안전 분류기가 중도에 잘라낸 시도는 제거, 비용은 고객이 청구받는 것(플랫폼 요청 + 웹 검색 수수료). 점수는 각 모델이 자체 선점된 작업을 제거한 33작업 기준 평균, 모든 팔에서 깨끗한 21개 작업에서는 Claude Fable 5.1이 모든 effort 수준에서 Claude Fable 5보다 23포인트 리드 유지, 두 모델 모두 effort 전반에 평평. 캐싱 차트는 같은 요청을 모든 입력 토큰을 캐시 없는 요율로 재가격. Claude Opus 4.6이 벤치마크의 루브릭 프로토콜로 평가, 원본은 다른 평가자를 사용하고 Anthropic 평가자는 내부 스타일을 선호할 수 있음. 기본 effort의 Claude Opus 5는 같은 표면과 부분집합에서 2026년 8월 28일에 3회 실행: 원시 50작업에서 68.8%, 33작업 기준 70.8%, 21작업 세트 71.1%, 작업당 6.71달러(캐싱 없이 23.72달러), 안전 분류기가 시도를 하나도 자르지 않았으며 다른 모델이 실행된 것보다 최신 안전장치 배포 아래. - 코퍼스 결함 스윕(Corpus defect sweep): 컨텍스트 창 하나보다 큰 작업용으로 Anthropic 내부, 130개 심어진 결함과 결정적 평가가 있는 14개 공개 Python 패키지 원본의 2,160만 토큰 코퍼스, 실행 전에 프로토콜 고정 및 내부 검토, 구성당 3회. 모든 구성이 Claude Managed Agents에서 실행. 차트화된 팀 구성은 Claude Fable 5.1 코디네이터가 플랫폼 안에서 문서화된 25개 동시 Claude Sonnet 5 워커 한도로 전체 스윕을 실행한 실행(2026년 8월 30일), 세 에피소드가 추가 감사 후 F1 0.764, 0.825, 0.791(원시 0.751, 0.821, 0.781)이고 비용은 225달러, 234달러, 283달러. Claude Sonnet 5 솔로 구성은 2026년 8월 3
4일, Claude Fable 5.1 솔로 구성은 플랫폼 출시 서빙 설정 아래 2026년 8월 2425일, effort 설정당 3개 시드, 같은 코퍼스 빌드. 샌드박스 이미지에 코퍼스 일부의 설치 사본이 있었고 Claude Fable 5.1의 최종 조립 단계가 9개 에피소드 중 7개에서 그것들과 비교했으며, 그 추가 없이 재평가하면 영향받는 시드가 최대 3포인트 움직임. 절대 F1은 이 코퍼스 빌드에 특화되어 벤치마크 간 비교 불가, 구성 비교는 like-for-like. - GPQA Diamond: Rein 등, "GPQA: A Graduate-Level Google-Proof Q&A Benchmark," 2023. 198질문 Diamond 부분집합, 구성당 2회, 2026년 8월 7일, 참조 답변에 대해 모델 평가, 어드바이저 토큰은 요청당 계량. 플랫폼 안전 검사가 Sonnet과 Opus 실행자에서 생물학 질문 두 개를 거부, 그것을 제외해도 어떤 비교도 1포인트 이상 바뀌지 않음.
- DeepSWE: Datacurve, "DeepSWE: Measuring Frontier Coding Agents on Original, Long-Horizon Engineering Tasks," arXiv:2607.07946, 2026. 5개 언어에 걸친 113개 원본 작업과 프로그램 기반 검증기. 짝은 각 2회(2026년 8월 7일), 어드바이저 토큰은 요청당 계량, 어드바이저 도구 대신 클라이언트 측 어드바이저 루프를 사용하고 회계는 동일. 단일 모델 effort 스윕은 토큰 개수에서 가격 책정된 1회 실행으로, 캐시 인식 근사. 작업당 비용은 실행 총계를 113으로 나눈 것.
- 내부 에이전트 코딩 벤치마크: Anthropic 내부, 리포지토리 자체 테스트로 평가되는 370개 리포지토리 작업. API 수치는 128,000토큰 출력 상한으로 측정, 구성당 1회: 기본 effort의 Opus 5 단독 2026년 8월 9
10일, 명시적 effort 값 다섯 개의 Claude Fable 5.1 단독 2026년 8월 20일, 짝 2026년 8월 2425일. 작업당 시도 수: 짝과 Opus 단독 대조는 5회, 단일 모델 포인트는 1회, 짝은 시도당 평균 약 2회 어드바이더 자문, 비용은 시도당. Claude Code 수치는 2026년 7월 8~23일의 같은 작업 실행(구성당 1회), 비용은 근사. - 내부 리포지토리 작업 벤치마크(상한 측정): 별도 Anthropic 내부 약 130개 리포지토리 작업 세트, 2026년 8월 8~10일(Claude Opus 5)과 2026년 8월 20일(Claude Fable 5.1), 플레인 API 에이전트 루프, 작업당 1회 시도. Claude Fable 5.1 실행은 상한당 135개 작업을 기본 effort를 명시적으로 설정하고(16,384토큰 수치는 2회 실행 평균(둘 다 36.3%), 64,000과 128,000 수치는 1회(58.5%와 60.0%)). 6개 문제는 모든 실행에서 안전 거부를 받아 실패로 계산. Opus 5 16,384토큰 수치는 2회 평균, 64,000 수치는 1회(124개 작업 평가). SWE-bench Pro 상한 수치는 기본 effort의 상한당 Claude Fable 5.1 1회 실행(2026년 8월 26일)이며 참조 3의 482문제 세트에서 계층화된 100문제 부분집합, 그 점수와 비교 불가, 두 상한은 기본값에서 같은 점수. 차트의 턴당 분포는 64,000의 Opus 실행과 128,000의 Claude Fable 5.1 실행에서 나옴, Opus 턴은 어떤 것도 상한 도달 없음, Fable 5.1 턴 하나가 128,000 도달(턴의 0.46%가 16,384 초과).
- Chartography: Surge AI, "Chartography," 2026. 공개된 전체 100질문 세트, 2026년 8월 8
10일 측정, Claude Managed Agents에서 Anthropic 구현(표준 클라우드 샌드박스, 어드바이더 구성은 Managed Agents 어드바이더 사용). Claude Sonnet 4.6이 참조 평가자 대신 평가하고 벤치마크가 도구로 실행되므로, 점수는 여기서 구성 간 비교되지만 공개 리더보드와는 비교 불가. 구성당 2회 풀링, 실행 간 분포는 410포인트. 비용은 1% 미만을 추가한 샌드박스 시간을 제외. Claude Fable 5.1 솔로 실행은 2026년 8월 24일, 플랫폼 출시 서빙 설정 아래 설정당 2회, 6회 시도가 15분 세션 상한에 걸려 0점, 실행당 차트 2개는 안전 거부 후 Claude Opus 5가 답함. 저effort 실행자 + Claude Fable 5.1 어드바이더의 Claude Opus 5가 2026년 8월 30일 같은 설정 아래 두 번 실행(63.0과 67.0, 평균 65.0, 차트당 0.72달러, 어드바이더는 각 실행에서 작업의 88%에 자문, 219개 답변 중 4개는 프로덕션 안전 필터가 어드바이더 자체 답을 막은 후 Claude Opus 5에서 나옴). 이전 짝의 자문률 비교는 Messages API에서 컨테이너 도구 세트로 같은 구성을 2026년 8월 10~11일 다시 실행한 것. - 지원 데스크 프롬프트 감사 평가: 결정적 평가가 있는 44개 지원 티켓의 Anthropic 구성 세트, 2026년 8월 초 실행, 2026년 8월 8일 보고, 여섯 개 시스템 프롬프트 아래 각각 같은 깨끗한 프롬프트에 Claude Opus 4.8과 Claude Sonnet 4.6용으로 작성된 프롬프트에서 흔한 패턴 하나를 추가. 각 차트 포인트는 세 경우(이전 모델, 같은 프롬프트의 새 모델, 감사 후 새 모델) 중 하나를 여섯 프롬프트와 44 티켓에 걸쳐 평균. Opus 5 정확도 이득은 95% 신뢰 구간 3~8포인트, Sonnet 정확도 차이는 노이즈 범위 내.
- 데이터 파일 질문 세트: 공개 주류 판매 CSV의 1,862행 조각에 대한 25개 집계 질문의 Anthropic 구성 세트, pandas로 계산된 정답과 정확 매치 평가, Claude Sonnet 5와 Claude Opus 5로 사고 비활성화(인컨텍스트 팔은 기본값에서 완료 불가), 4,000토큰 출력 상한, 프롬프트 캐싱 없음, 구성당 3회, 2026년 8월 19일 실행. 파일 팔은 Files API로 CSV를 업로드하고
code_execution_20260120도구 사용. - 캐시 지속 시간 측정: 입력 및 컨텍스트 토큰 정리의 20이슈 트리아지 작업, 2026년 8월 23일, 같은 하네스로 Messages API에서 Claude Sonnet 5와 Claude Opus 5 실행, Claude Opus 5 셀은
max_tokens를 4,096으로 올림, 무작위로 고른 턴 비율 앞에 대기 삽입(없음, 5%, 10%, 그리고 두 모델 모두 모든 20이슈에서 6분, Claude Sonnet 5에서는 2분, 두 모델 모두 5이슈 부분집합에서 20분 대기, Claude Sonnet 5에서만 5이슈 부분집합에서 45분 대기). 셀당 3회, 비용은 목록 가격의 고객 청구 조직에서 각 응답의usage필드로 계산, 정확도는 같은 골드 라벨 대비. 교차점은 두 모델 모두 턴의 약 3.3%: 해당 세션의 턴별 컨텍스트 크기에서 비용 모델이 계산한 각 세션의 손익분기 몫의 중앙값, 분석의 45개 Claude Sonnet 5와 36개 Claude Opus 5 20이슈 세션 전체(전체 작업에서 모든 대기 일정, 세 캐시 설정 모두, 각 3회, 5이슈 셀은 포함 안 됨). 5% 셀은 그 드로우의 대기가 작은 프리픽스에 걸렸기 때문에 Claude Sonnet 5에서 동률. 페이지의 20분의 1 규칙은 측정된 교차점 위에 있음. Anthropic은 5분 캐시를 새로고침하는 keep-alive 요청을 비교자로만 측정. 그것들은 1시간 설정과 기껏해야 같고 모든 턴 앞에 대기가 있으면 더 비싸므로 이 두 모델에서는 사용하지 말 것, Claude Fable 5.1에서는 산식이 뒤집힘(참조 19). - 프로덕션 캐시 읽기 비율: 2026년 8월 23일로 끝나는 14일간의 집계된 자사 Claude API 사용, 직접 API 제품만, Anthropic 내부 조직 제외, 조직 식별 없음. 조직-일(organization-day)이 요청에 도구 정의와 도구 결과를 담고, 프롬프트가 평균 9개 이상의 이전 도구 호출을 보유하며, 캐싱을 사용하고, 그런 요청을 최소 10개 만들면 에이전트 루프로 계산(API에 대화 식별자가 없으므로 대화 길이를 대신함): 106,487개 조직에 걸친 303,003 조직-일, 모든 입력 토큰의 중앙값 캐시 읽기 비율 84.2%, 상위 사분위 91.7%. 유스 케이스 라벨(조직의 선언된 유스 케이스, 아니면 분류된 것)은 그 조직-일의 74%와 토큰의 99%를 덮고, 코딩 조직이 에이전트 입력 토큰의 87%를 공급하며 중앙값 88.5%(이전 도구 호출 25개 이상이면 90.9%)를 읽고 상위 사분위 93.4%, 코딩 조직-일의 약 72%가 80% 이상, 지원·연구·데이터 에이전트는 84%~85%를 읽음. 조직-일 상위 십분위는 코딩에서 95.9% 이상, 지원·연구·데이터·기타 에이전트에서 94.2%~94.8%를 읽음. 이전 도구 호출 25개 이상에서의 요청 수준 분할은 6시간 샘플에서 나옴: 코딩 92% 읽기, 7% 쓰기, 1% 미만 캐시 없음. 대부분 작은 라벨 없는 조직은 중앙값 11%를 읽음. 도구 정의가 없는 조직-일은 중앙값 34.6%를 읽음. 같은 창에서 조직-일을 평가하지 않고 10개 이상 요청의 대화를 재구성하는 독립 쿼리는 중앙값을 90.2%로 둠, 차이는 범위 문제이지 데이터 문제가 아님.
- 컴팩션 시점 측정: 입력 및 컨텍스트 토큰 정리의 트리아지 에이전트 긴 변형, 2026년 8월 24일, 5분 캐시로 Claude Sonnet 5 실행, 목록 가격의 사용 필드에서 비용, 팔당 세션 5개: 전체 기본 effort의 변경 없음 팔(세션당 0.81달러), 그리고 저effort로 시작해 캐시를 깨는 동일한 두 변경(기본 effort로 전환과 도구 하나 추가)을 요청 12와 17에서 세션 중간에 하거나, 첫 컴팩션 후 첫 요청에서 함께 하는 두 팔(0.75달러). 2026년 8월 25일 실행된 6세션 네 번째 팔은 첫 컴팩션을 촉발한 요청에서 같은 두 변경(세션당 0.92달러): 그 요청의 요약화 통과가 읽기 대신 81,000토큰 컨텍스트를 캐시에 써서 그 통과가 0.21달러였고 경계 팔의 같은 통과 0.04달러와 대비. 세션은 프롬프트가 80,000토큰 컴팩션 트리거를 넘은 후 요청 21
25에서 처음 컴팩션(21개 세션 중 16개가 요청 22)되었고, 변경 없는 세션 두 개는 끝 근처에서 두 번째 컴팩션. 경계 팔이 변경 없음 팔보다 낮은 총액은 변경 전 저effort 요청과 그 두 번째 컴팩션을 반영한 것이지 캐싱 때문이 아님(두 팔의 재쓰기 비용 차이는 1센트 미만). 세션 중간 팔은 세션당 캐시 재쓰기 0.23달러를 냈고, 세션 중간 팔과 경계 팔의 차이는 0.20달러(95% 신뢰 구간 0.110.29). 세션 중간 세션 하나는 컴팩션 후 모델이 검색 도구를 잘못 호출해 빈 결과를 얻어 저렴(0.82달러)하게 실행됐고 포함되며, 그것 없이는 팔 평균 0.98달러. 정확도는 2026년 8월 24일 팔 각각에서 20개 라벨 중 평균 14.2, 8월 25일 팔에서 14.7, 캐시 읽기는 변경 없음에서 프롬프트 토큰의 91%, 세션 중간 85%, 경계 91%, 변경 시 86% ... [truncated] - Claude Fable 5.1의 캐시 지속 시간 측정: 참조 16과 같은 20이슈 트리아지 작업과 하네스, 2026년 8월 23일과 26일, Claude Fable 5.1 출시 스냅샷을 출시 가격(입력 10달러, 5분 쓰기 12.50달러, 1시간 쓰기 20달러, 캐시 읽기 0.25달러, 출력 백만 토큰당 50달러)으로, 일정당 세 설정: 5분 캐시, 1시간 캐시, 그리고 유휴 시간 4분마다 변하지 않은 프리픽스에
max_tokens: 0요청으로 따뜻하게 유지되는 5분 캐시(8월 23일 실행은max_tokens: 1로 핑, 모든 8월 26일 핑은 캐시를 새로고침하고 출력 청구 없음). 일정: 대기 없음, 턴의 10%, 모든 20이슈에서 모든 턴 6분, 5이슈 부분집합에서 45분 대기, 셀당 3회, 비용은 목록 가격의 각 응답usage필드로 계산, 정확도는 같은 골드 라벨 대비(20개 중 정확 라벨 12~17). 8월 26일의 5분·1시간·keep-alive 설정별 세션당 평균: 대기 없음 2.42달러, 3.09달러, 2.29달러, 10% 대기 4.50달러, 2.96달러, 2.36달러, 모든 턴 22.89달러, 3.01달러, 2.62달러, 8월 23일 셀은 6% 내에서 일치. 45분 수치(5이슈 세션당 1.68달러, 0.59달러, 0.71달러)는 캐시 청구 사고가 그날 첫 셀을 망친 후 8월 26일의 깨끗한 재실행에서 나옴, 8월 23일 실행은 1.67달러, 0.58달러, 0.70달러. 5분과 1시간 설정의 교차점은 참조 16과 같은 측정인 턴의 3.1%. - Terminal-Bench 3: 공개 터미널 에이전트 벤치마크의 74개 작업, Claude Managed Agents에서 평가 하네스가 각 작업의 컨테이너에서 실행하는 셸과 파일 편집기라는 두 커스텀 도구로 플랫폼 내장 도구 대신, 그 외에는 외부 계정용 플랫폼 기본 설정으로,
higheffort에서 모델당 2회, 2026년 8월 2728일. 점수는 모델당 148개 시도에 대한 원시 통과율, 단일 실행은 511포인트 흔들림. 비용은 고객이 목록 가격으로 청구받을 것, 5분 캐시 수명으로 실행 사용 기록에서 요청별 재가격. Claude Opus 4.7은 148개 시도 중 11개를 출력 상한에서 끝냄.