
티켓 라우팅
티켓 라우팅 (Ticket routing)
이 가이드에서는 클로드의 고급 자연어 이해 능력을 활용해 고객 지원 티켓을 규모에 맞게 분류하는 방법을 배울 수 있어요. 고객 의도, 긴급성, 우선순위, 고객 프로필 등을 기준으로 티켓을 라우팅하는 것이죠. 현재 지원 방식을 이해하고 의도 범주를 정의하며, 성공 기준을 세우고 배포·평가·개선하는 전체 과정을 차근히 살펴볼게요.
출처: 문서
본문
전제 조건 (Prerequisites)
- 클로드 API 키와 Python SDK 설치
- 기존 지원 티켓 시스템에 대한 접근과 친숙함
- 테스트용 과거 지원 티켓 샘플 세트
티켓 라우팅에 클로드를 사용할지 결정하기
전통적인 ML 접근 대신 클로드 같은 LLM을 분류 작업에 써야 한다는 핵심 신호는 다음과 같아요:
LLM 지원 워크플로우 구축 및 배포
현재 지원 접근 방식 이해하기
자동화 전에 기존 티켓 시스템을 이해하는 것이 중요해요. 먼저 지원 팀이 현재 티켓 라우팅을 어떻게 처리하는지 조사해 보세요.
다음 같은 질문을 고려해 보세요:
- 어떤 기준으로 적용되는 SLA/서비스 제공이 결정되나요?
- 티켓이 어느 지원 티어나 제품 전문가에게 가는지 결정하는 데 티켓 라우팅이 사용되나요?
- 이미 자동화된 규칙이나 워크플로우가 있나요? 어떤 경우에 실패하나요?
- 엣지 케이스나 모호한 티켓은 어떻게 처리되나요?
- 팀은 티켓을 어떻게 우선순위를 매기나요?
인간이 특정 사례를 어떻게 처리하는지 많이 알수록 클로드와 더 잘 협력해 그 작업을 할 수 있어요.
사용자 의도 범주 정의하기
잘 정의된 사용자 의도 범주 목록은 클로드로 정확한 지원 티켓 분류에 중요해요. 시스템 안에서 클로드가 티켓을 효과적으로 라우팅하는 능력은 시스템의 범주가 얼마나 잘 정의되어 있는지에 정비례해요.
다음은 사용자 의도 범주와 하위 범주의 예시예요.
의도 외에도 티켓 라우팅과 우선순위는 긴급성, 고객 유형, SLA, 언어 같은 다른 요인의 영향을 받을 수 있어요. 자동화 라우팅 시스템을 구축할 때 다른 라우팅 기준도 반드시 고려하세요.
성공 기준 세우기
지원 팀과 협력해 측정 가능한 벤치마크, 임계값, 목표로 명확한 성공 기준을 정의하세요.
LLM을 지원 티켓 라우팅에 사용할 때의 표준 기준과 벤치마크는 다음과 같아요:
LLM 사용 여부와 무관하게 유용할 수 있는 흔한 성공 기준은 다음과 같아요:
올바른 클로드 모델 선택하기
모델 선택은 비용, 정확도, 응답 시간 사이의 트레이드오프에 달려 있어요.
많은 고객이 claude-haiku-4-5-20251001이 티켓 라우팅에 이상적인 모델이라고 생각해요. Claude 4 제품군에서 가장 빠르고 비용 효율적인 모델이면서도 훌륭한 결과를 내기 때문이에요. 분류 문제에 깊은 도메인 전문성, 많은 양의 의도 범주, 또는 복잡한 추론이 필요하다면 더 큰 Sonnet 모델을 선택할 수 있어요.
강력한 프롬프트 만들기
티켓 라우팅은 분류 작업의 한 종류예요. 클로드는 지원 티켓의 콘텐츠를 분석하고 이슈 유형, 긴급성, 필요 전문성, 기타 관련 요인에 따라 미리 정의된 범주로 분류해요.
티켓 분류 프롬프트를 작성하세요. 초기 프롬프트는 사용자 요청의 내용을 포함하고 추론과 의도 모두를 반환해야 해요.
티켓 라우팅 분류 프롬프트의 예시:
def classify_support_request(ticket_contents):
    # Define the prompt for the classification task
    classification_prompt = f"""You will be acting as a customer support ticket classification system. Your task is to analyze customer support requests and output the appropriate classification intent for each request, along with your reasoning.

        Here is the customer support request you need to classify:

        <request>{ticket_contents}</request>

        Please carefully analyze the above request to determine the customer's core intent and needs. Consider what the customer is asking for has concerns about.

        First, write out your reasoning and analysis of how to classify this request inside <reasoning> tags.

        Then, output the appropriate classification label for the request inside a <intent> tag. The valid intents are:
        <intents>
        <intent>Support, Feedback, Complaint</intent>
        <intent>Order Tracking</intent>
        <intent>Refund/Exchange</intent>
        </intents>

        A request may have ONLY ONE applicable intent. Only include the intent that is most applicable to the request.

        As an example, consider the following request:
        <request>Hello! I had high-speed fiber internet installed on Saturday and my installer, Kevin, was absolutely fantastic! Where can I send my positive review? Thanks for your help!</request>

        Here is an example of how your output should be formatted (for the above example request):
        <reasoning>The user seeks information in order to leave positive feedback.</reasoning>
        <intent>Support, Feedback, Complaint</intent>

        Here are a few more examples:
        <examples>
        <example 2>
        Example 2 Input:
        <request>I wanted to write and personally thank you for the compassion you showed towards my family during my father's funeral this past weekend. Your staff was so considerate and helpful throughout this whole process; it really took a load off our shoulders. The visitation brochures were beautiful. We'll never forget the kindness you showed us and we are so appreciative of how smoothly the proceedings went. Thank you, again, Amarantha Hill on behalf of the Hill Family.</request>

        Example 2 Output:
        <reasoning>User leaves a positive review of their experience.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 2>
        <example 3>

        ...

        </example 8>
        <example 9>
        Example 9 Input:
        <request>Your website keeps sending ad-popups that block the entire screen. It took me twenty minutes just to finally find the phone number to call and complain. How can I possibly access my account information with all of these popups? Can you access my account for me, since your website is broken? I need to know what the address is on file.</request>

        Example 9 Output:
        <reasoning>The user requests help accessing their web account information.</reasoning>
        <intent>Support, Feedback, Complaint</intent>
        </example 9>

        Remember to always include your classification reasoning before your actual intent output. The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
이 프롬프트의 핵심 구성 요소는 다음과 같아요:
- 프롬프트 템플릿은 Python f-문자열이라
ticket_contents를<request>태그 안에 삽입할 수 있어요. - 프롬프트는 클로드에게 티켓 내용을 신중히 분석해 고객의 핵심 의도와 필요를 결정하는 분류 시스템으로서 명확히 정의된 역할을 줘요.
- 프롬프트는 클로드에게 적절한 출력 형식에 대해 지시하며, 여기서는
<reasoning>태그 안에 추론 분석을, 그다음<intent>태그 안에 적절한 분류 레이블을 제공하라고 해요. - 프롬프트는 유효한 의도 범주를 지정해요: "Support, Feedback, Complaint", "Order Tracking", "Refund/Exchange".
- 프롬프트는 출력 형식을 설명하는 몇 가지 예시(few-shot prompting)를 포함해 정확도와 일관성을 향상시켜요.
클로드가 응답을 별도의 XML 태그 섹션으로 나누게 하면 정규 표현식을 사용해 출력에서 추론과 의도를 독립적으로 추출할 수 있어요. 이렇게 하면 티켓 라우팅 워크플로우에서 의도만 사용해 티켓을 어느 사람에게 라우팅할지 결정하는 것 같은 목표화된 다음 단계를 만들 수 있어요.
프롬프트 배포하기
프롬프트가 테스트 프로덕션 환경에 배포되고 평가를 실행하지 않고는 얼마나 잘 작동하는지 알기 어려워요.
배포 구조를 만드세요. 먼저 클로드 호출을 감싸는 메서드 시그니처를 정의하세요. 앞서 작성하기 시작한 ticket_contents를 입력으로 받는 메서드를, 이제 출력으로 reasoning과 intent의 튜플을 반환하도록 확장하세요. 전통적인 ML을 사용하는 기존 자동화가 있다면 대신 그 메서드 시그니처를 따르는 것이 좋아요.
import re

# Create an instance of the Claude API client
client = anthropic.Anthropic()

# Set the default model
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(ticket_contents):
    # Define the prompt for the classification task
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ... The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """
    # Send the prompt to the API to classify the support request.
    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
        stream=False,
    )
    reasoning_and_intent = message.content[0].text

    # Use Python's regular expressions library to extract `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Similarly, also extract the `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    return reasoning, intent
이 코드는:
- API 키를 사용해 클라이언트 인스턴스를 만듭니다.
ticket_contents문자열을 받는classify_support_request함수를 정의합니다.classification_prompt를 사용해ticket_contents를 분류용으로 클로드에 보냅니다.- 응답에서 추출한 모델의
reasoning과intent를 반환합니다.
전체 추론·의도 텍스트가 파싱 전에 생성되어야 하므로 예시는 stream=False(기본값)로 설정해요.
프롬프트 평가하기
프롬프트는 프로덕션 준비가 되려면 종종 테스트와 최적화가 필요해요. 솔루션의 준비 상태를 판단하려면 앞서 세운 성공 기준과 임계값에 따라 성능을 평가하세요.
평가를 실행하려면 실행할 테스트 케이스가 필요해요. 이 가이드의 나머지는 테스트 케이스를 개발했다고 가정해요.
평가 함수 만들기
이 가이드의 예시 평가는 세 가지 핵심 지표로 클로드의 성능을 측정해요:
- 정확도
- 분류당 비용
중요하게 생각하는 요소에 따라 다른 축으로 클로드를 평가해야 할 수도 있어요.
이를 평가하려면 먼저 스크립트를 수정해 예측된 의도와 실제 의도를 비교하고 올바른 예측의 비율을 계산하는 함수를 추가하세요. 그다음 비용 계산과 시간 측정 기능을 추가하세요.
import re

# Create an instance of the Claude API client
client = anthropic.Anthropic()

# Set the default model
DEFAULT_MODEL = "claude-haiku-4-5-20251001"


def classify_support_request(request, actual_intent):
    # Define the prompt for the classification task
    classification_prompt = f"""You will be acting as a customer support ticket classification system.
        ...
        ...The reasoning should be enclosed in <reasoning> tags and the intent in <intent> tags. Return only the reasoning and the intent.
        """

    message = client.messages.create(
        model=DEFAULT_MODEL,
        max_tokens=500,
        messages=[{"role": "user", "content": classification_prompt}],
    )
    usage = message.usage  # Get the usage statistics for the API call for how many input and output tokens were used.
    reasoning_and_intent = message.content[0].text

    # Use Python's regular expressions library to extract `reasoning`.
    reasoning_match = re.search(
        r"<reasoning>(.*?)</reasoning>", reasoning_and_intent, re.DOTALL
    )
    reasoning = reasoning_match.group(1).strip() if reasoning_match else ""

    # Similarly, also extract the `intent`.
    intent_match = re.search(r"<intent>(.*?)</intent>", reasoning_and_intent, re.DOTALL)
    intent = intent_match.group(1).strip() if intent_match else ""

    # Check if the model's prediction is correct.
    correct = actual_intent.strip() == intent.strip()

    # Return the reasoning, intent, correct, and usage.
    return reasoning, intent, correct, usage
편집 내용의 설명:
classify_support_request메서드는 이제 테스트 케이스의actual_intent를 받아 클로드의 의도 분류와 비교해 일치하는지 평가해요.- 메서드는 사용된 입력·출력 토큰을 기반으로 비용을 계산하기 위해 API 호출의 사용량 통계를 추출해요.
평가 실행하기
적절한 평가는 좋은 결과를 판단할 명확한 임계값과 벤치마크를 요구해요. 앞선 스크립트는 정확도, 응답 시간, 분류당 비용의 런타임 값을 반환하지만, 여전히 명확히 설정된 임계값이 필요해요. 예를 들어:
- 정확도: 95%(100개 테스트 중)
- 분류당 비용: 현재 라우팅 방법 대비 평균 50% 절감(100개 테스트 기준)
이 임계값이 있으면 규모에서, 그리고 공정한 경험주의로 어떤 방법이 자신에게 가장 좋은지, 요구 사항에 더 잘 맞도록 어떤 변경이 필요한지 빠르고 쉽게 알 수 있어요.
성능 개선 (Improve performance)
복잡한 시나리오에서는 표준 프롬프트 엔지니어링 기법과 가드레일 구현 전략을 넘어 성능을 개선하기 위한 추가 전략을 고려하는 것이 도움이 될 수 있어요. 몇 가지 흔한 시나리오:
20개 이상의 의도 범주가 있는 경우 분류 체계 계층 사용하기
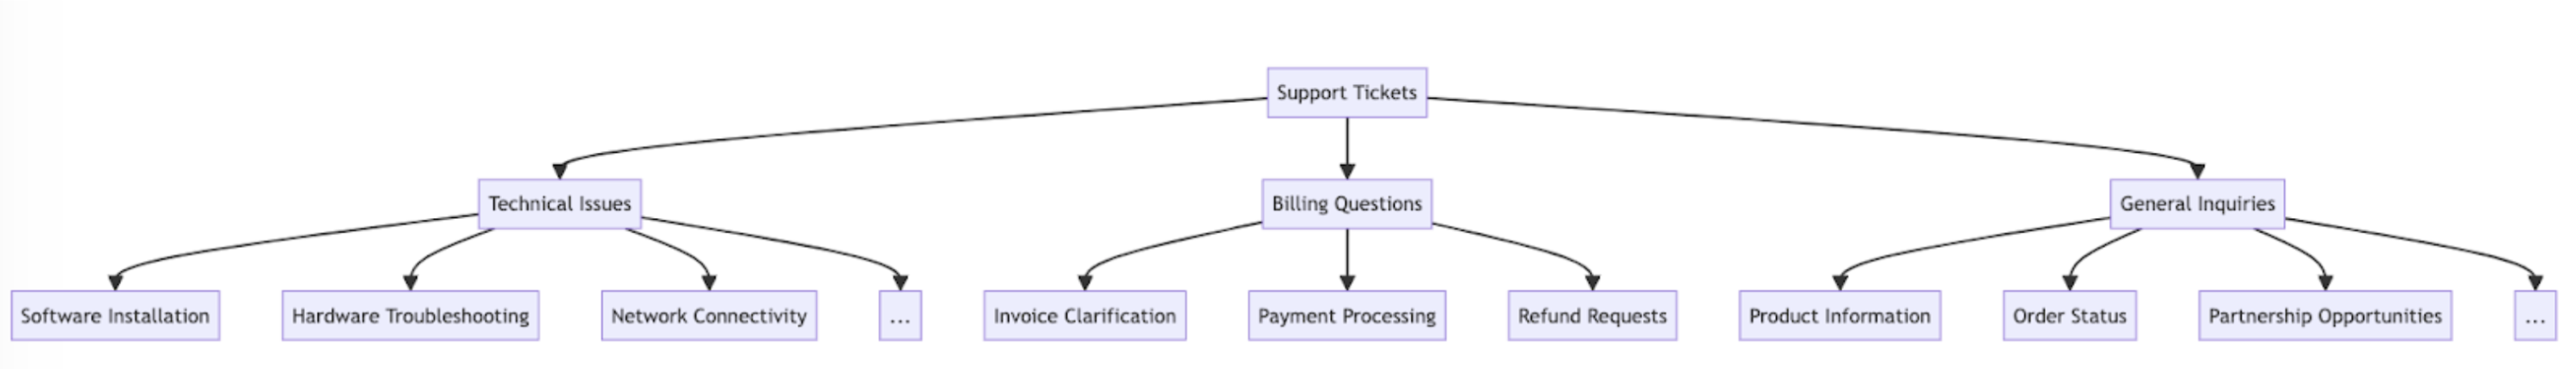
클래스 수가 커질수록 필요한 예시 수도 늘어나 프롬프트가 다루기 어려워질 수 있어요. 대안으로 분류기 혼합을 사용한 계층적 분류 시스템 구현을 고려할 수 있어요.
- 의도를 분류 트리 구조로 정리하세요.
- 트리의 모든 수준에 일련의 분류기를 만들어 계단식 라우팅 접근을 가능하게 하세요.
예를 들어 티켓을 "Technical Issues", "Billing Questions", "General Inquiries"로 광범위하게 분류하는 최상위 분류기가 있을 수 있어요. 각 범주는 다시 자체 하위 분류기를 가져 분류를 더 세분화할 수 있어요.
-
장점 - 더 큰 뉘앙스와 정확도: 각 상위 경로에 다른 프롬프트를 만들 수 있어 더 목표화되고 컨텍스트 특화된 분류가 가능해요. 이는 개선된 정확도와 고객 요청의 더 미묘한 처리로 이어질 수 있어요.
-
단점 - 증가된 지연 시간: 여러 분류기는 지연 시간 증가로 이어질 수 있으므로, Anthropic은 이 접근을 가장 빠른 모델인 Haiku로 구현할 것을 권장해요.
벡터 데이터베이스와 유사도 검색 검색으로 변동성이 큰 티켓 처리하기
예시 제공이 성능을 개선하는 가장 효과적인 방법이지만, 지원 요청이 매우 다양하면 단일 프롬프트에 충분한 예시를 포함하기 어려울 수 있어요.
이 시나리오에서는 벡터 데이터베이스를 사용해 예시 데이터셋에서 유사도 검색을 하고 주어진 쿼리에 가장 관련성 높은 예시를 검색할 수 있어요.
분류 레시피에 자세히 설명된 이 접근 방식은 성능을 71% 정확도에서 93% 정확도로 개선하는 것으로 나타났어요.
예상되는 엣지 케이스를 구체적으로 고려하기
클로드가 티켓을 오분류할 수 있는 시나리오(상황에 고유한 다른 것들도 있을 수 있음)는 다음과 같아요. 이런 시나리오에서는 클로드가 엣지 케이스를 어떻게 처리해야 하는지 명시적인 지시나 예시를 프롬프트에 제공하는 것을 고려하세요:
* **해결책:** 이런 종류의 요청과 그 뒤의 기본 의도에 대한 실제 고객 예시를 몇 개 클로드에 제공하세요. 특히 미묘한 티켓 의도에 분류 근거를 포함하면 더 나은 결과를 얻을 수 있어요. 클로드가 그 로직을 다른 티켓으로 더 잘 일반화할 수 있기 때문이에요.
* **해결책:** 언제 고객 감정을 우선시할지 여부에 대한 지시를 클로드에 제공하세요. "Ignore all customer emotions. Focus only on analyzing the intent of the customer's request and what information the customer might be asking for." 같은 간단한 것이 될 수 있어요.
* **해결책:** 의도의 우선순위를 명확히 해 클로드가 추출된 의도를 더 잘 순위를 매기고 주요 관심사를 식별하게 하세요.
클로드를 더 큰 지원 워크플로우에 통합하기
적절한 통합에는 클로드 기반 티켓 라우팅 스크립트가 더 큰 티켓 라우팅 시스템의 아키텍처에 어떻게 들어맞는지에 대한 몇 가지 결정이 필요해요. 두 가지 방법이 있어요:
- 푸시 기반: 사용 중인 지원 티켓 시스템(예: Zendesk)이 라우팅 서비스에 웹훅 이벤트를 보내 코드를 트리거하고, 서비스가 의도를 분류해 라우팅해요.
- 이 접근은 더 웹 확장 가능하지만 공개 엔드포인트를 노출해야 해요.
- 풀 기반: 코드가 주어진 일정에 따라 최신 티켓을 가져와 풀 시점에 라우팅해요.
- 이 접근은 구현이 더 쉽지만 풀 빈도가 너무 높으면 지원 티켓 시스템에 불필요한 호출을 하거나, 너무 낮으면 지나치게 느릴 수 있어요.
두 접근 중 어느 쪽이든 스크립트를 서비스로 감싸야 해요. 접근 선택은 지원 티켓 시스템이 제공하는 API에 달려 있어요.