
스킬 작성 모범 사례
스킬 작성 모범 사례 (Skill authoring best practices)
좋은 스킬은 간결하고, 잘 구조화되어 있으며, 실제 사용으로 검증돼요. 이 가이드는 클로드가 효과적으로 발견하고 사용할 수 있는 스킬을 작성하는 데 도움이 되는 실용적인 작성 결정들을 제공해요. 스킬이 어떻게 작동하는지에 대한 개념적 배경은 스킬 개요를 참고하세요.
출처: 문서
본문
핵심 원칙 (Core principles)
간결함이 핵심
컨텍스트 창은 공공재와 같아요. 스킬은 컨텍스트 창을 클로드가 알아야 할 다른 모든 것과 공유해요:
- 시스템 프롬프트
- 대화 이력
- 다른 스킬의 메타데이터
- 당신의 실제 요청
스킬의 모든 토큰이 즉각적인 비용을 가지는 것은 아니에요. 시작 시 모든 스킬의 메타데이터(이름과 설명)만 미리 로드돼요. 클로드는 스킬이 관련해질 때만 SKILL.md를 읽고, 필요할 때만 추가 파일을 읽어요. 하지만 SKILL.md에서 간결함은 여전히 중요해요. 클로드가 로드한 다음에는 모든 토큰이 대화 이력과 다른 컨텍스트와 경쟁하니까요.
기본 가정: 클로드는 이미 매우 똑똑해요
클로드가 아직 모르는 컨텍스트만 추가하세요. 각 정보 조각에 이의를 제기해 보세요:
- "클로드가 정말 이 설명을 필요로 할까?"
- "클로드가 이것을 안다고 가정할 수 있을까?"
- "이 문단이 토큰 비용을 정당화하나?"
좋은 예시: 간결함 (약 50토큰):
## Extract PDF text

Use pdfplumber for text extraction:

```python
import pdfplumber

with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```
나쁜 예시: 너무 장황함 (약 150토큰):
## Extract PDF text

PDF (Portable Document Format) files are a common file format that contains
text, images, and other content. To extract text from a PDF, you'll need to
use a library. There are many libraries available for PDF processing, but
pdfplumber is recommended because it's easy to use and handles most cases well.
First, you'll need to install it using pip. Then you can use the code below...
간결한 버전은 클로드가 PDF와 라이브러리 작동 방식에 대한 정보를 이미 가지고 있다고 가정해요.
적절한 자유도를 설정하기
작업의 취약성과 변동성에 특정성을 맞추세요.
높은 자유도 (텍스트 기반 지시):
다음 경우에 사용:
- 여러 접근이 유효한 경우
- 결정이 컨텍스트에 의존하는 경우
- 휴리스틱이 접근을 안내하는 경우
예시:
## Code review process

1. Analyze the code structure and organization
2. Check for potential bugs or edge cases
3. Suggest improvements for readability and maintainability
4. Verify adherence to project conventions
중간 자유도 (파라미터가 있는 의사코드나 스크립트):
다음 경우에 사용:
- 선호 패턴이 있는 경우
- 어느 정도 변동이 허용되는 경우
- 구성이 동작에 영향을 주는 경우
예시:
## Generate report

Use this template and customize as needed:

```python
def generate_report(data, format="markdown", include_charts=True):
    # Process data
    # Generate output in specified format
    # Optionally include visualizations
```
낮은 자유도 (파라미터가 거의 또는 전혀 없는 특정 스크립트):
다음 경우에 사용:
- 작업이 취약하고 오류가 나기 쉬운 경우
- 일관성이 중요한 경우
- 특정 순서를 따라야 하는 경우
예시:
## Database migration

Run exactly this script:

```bash
python scripts/migrate.py --verify --backup
```

Do not modify the command or add additional flags.
비유: 클로드를 경로를 탐색하는 로봇으로 생각해 보세요:
- 양쪽에 절벽이 있는 좁은 다리: 앞으로 가는 안전한 길은 하나뿐이에요. 특정 가드레일과 정확한 지시를 제공하세요(낮은 자유도). 예: 정확한 순서로 실행해야 하는 데이터베이스 마이그레이션.
- 위험이 없는 열린 들판: 성공으로 가는 길은 많아요. 일반적인 방향을 주고 클로드가 최선의 경로를 찾도록 신뢰하세요(높은 자유도). 예: 컨텍스트가 최선의 접근을 결정하는 코드 리뷰.
사용할 모든 모델로 테스트하기
스킬은 모델에 대한 추가 역할을 하므로 효과는 기반 모델에 따라 달라져요. 사용할 계획인 모든 모델로 스킬을 테스트하세요.
모델별 테스트 고려 사항:
- Claude Haiku (빠르고 경제적): 스킬이 충분한 안내를 제공하나요?
- Claude Sonnet (균형): 스킬이 명확하고 효율적인가요?
- Claude Opus (강력한 추론): 스킬이 과도하게 설명하지 않나요?
Opus에 완벽하게 맞는 것이 Haiku에는 더 많은 세부 사항이 필요할 수 있어요. 여러 모델에서 스킬을 사용할 계획이라면 모두와 잘 작동하는 지시를 목표로 하세요.
스킬 구조 (Skill structure)
name:
- 최대 64자
- 소문자, 숫자, 하이픈만 포함
- XML 태그 포함 불가
- 예약어 포함 불가: "anthropic", "claude"
description:
- 비어 있지 않아야 함
- 최대 1,024자
- XML 태그 포함 불가
- 스킬이 무엇을 하는지와 언제 사용해야 하는지 설명해야 함
완전한 스킬 구조 세부 사항은 스킬 개요를 참고하세요.
명명 규칙 (Naming conventions)
스킬을 더 쉽게 참조하고 논의하게 일관된 명명 패턴을 사용하세요. 스킬 이름에 **동명사 형태(동사 + -ing)**를 사용하는 것을 고려해 보세요. 스킬이 제공하는 활동이나 능력을 명확히 설명하니까요.
name 필드는 소문자, 숫자, 하이픈만 사용해야 함을 기억하세요.
좋은 명명 예시 (동명사 형태):
processing-pdfsanalyzing-spreadsheetsmanaging-databasestesting-codewriting-documentation
허용 가능한 대안:
- 명사구:
pdf-processing,spreadsheet-analysis - 동작 중심:
process-pdfs,analyze-spreadsheets
피해야 할 것:
- 모호한 이름:
helper,utils,tools - 지나치게 일반적인 것:
documents,data,files - 예약어:
anthropic-helper,claude-tools - 스킬 컬렉션 내 일관성 없는 패턴
일관된 명명은 다음을 쉽게 해요:
- 문서와 대화에서 스킬 참조
- 한눈에 스킬이 무엇을 하는지 이해
- 여러 스킬 조직 및 검색
- 전문적이고 응집력 있는 스킬 라이브러리 유지
효과적인 설명 작성하기
description 필드는 스킬 발견을 가능하게 하며 스킬이 무엇을 하는지와 언제 사용해야 하는지를 모두 포함해야 해요.
- 좋음: "Processes Excel files and generates reports"
- 피할 것: "I can help you process Excel files"
- 피할 것: "You can use this to process Excel files"
구체적이고 핵심 용어를 포함하세요. 스킬이 무엇을 하는지와 언제 사용해야 하는지의 특정 트리거/컨텍스트를 모두 포함하세요.
각 스킬에는 정확히 하나의 description 필드가 있어요. 설명은 스킬 선택에 중요해요. 클로드는 잠재적으로 100개 이상의 사용 가능한 스킬 중 올바른 스킬을 고르는 데 설명을 사용해요. 설명은 클로드가 이 스킬을 언제 선택해야 하는지 알 수 있을 만큼 충분한 세부 사항을 제공해야 하며, SKILL.md의 나머지가 구현 세부 사항을 제공해요.
효과적인 예시:
PDF 처리 스킬:
description: Extract text and tables from PDF files, fill forms, merge documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.
Excel 분석 스킬:
description: Analyze Excel spreadsheets, create pivot tables, generate charts. Use when analyzing Excel files, spreadsheets, tabular data, or .xlsx files.
Git 커밋 도우미 스킬:
description: Generate descriptive commit messages by analyzing git diffs. Use when the user asks for help writing commit messages or reviewing staged changes.
이런 모호한 설명은 피하세요:
description: Helps with documents
description: Processes data
description: Does stuff with files
점진적 공개 패턴 (Progressive disclosure patterns)
SKILL.md는 온보딩 가이드의 목차처럼 필요할 때 상세 자료를 가리키는 개요 역할을 해요. 점진적 공개가 어떻게 작동하는지에 대한 설명은 개요의 스킬이 작동하는 방식을 참고하세요.
실용적 지침:
- 최적 성능을 위해 SKILL.md 본문을 500줄 미만으로 유지하세요
- 이 한도에 가까워지면 콘텐츠를 별도 파일로 나누세요
- 다음 패턴을 사용해 지시, 코드, 리소스를 효과적으로 조직하세요
시각적 개요: 단순에서 복잡으로
기본 스킬은 메타데이터와 지시를 담은 SKILL.md 파일 하나로 시작해요:
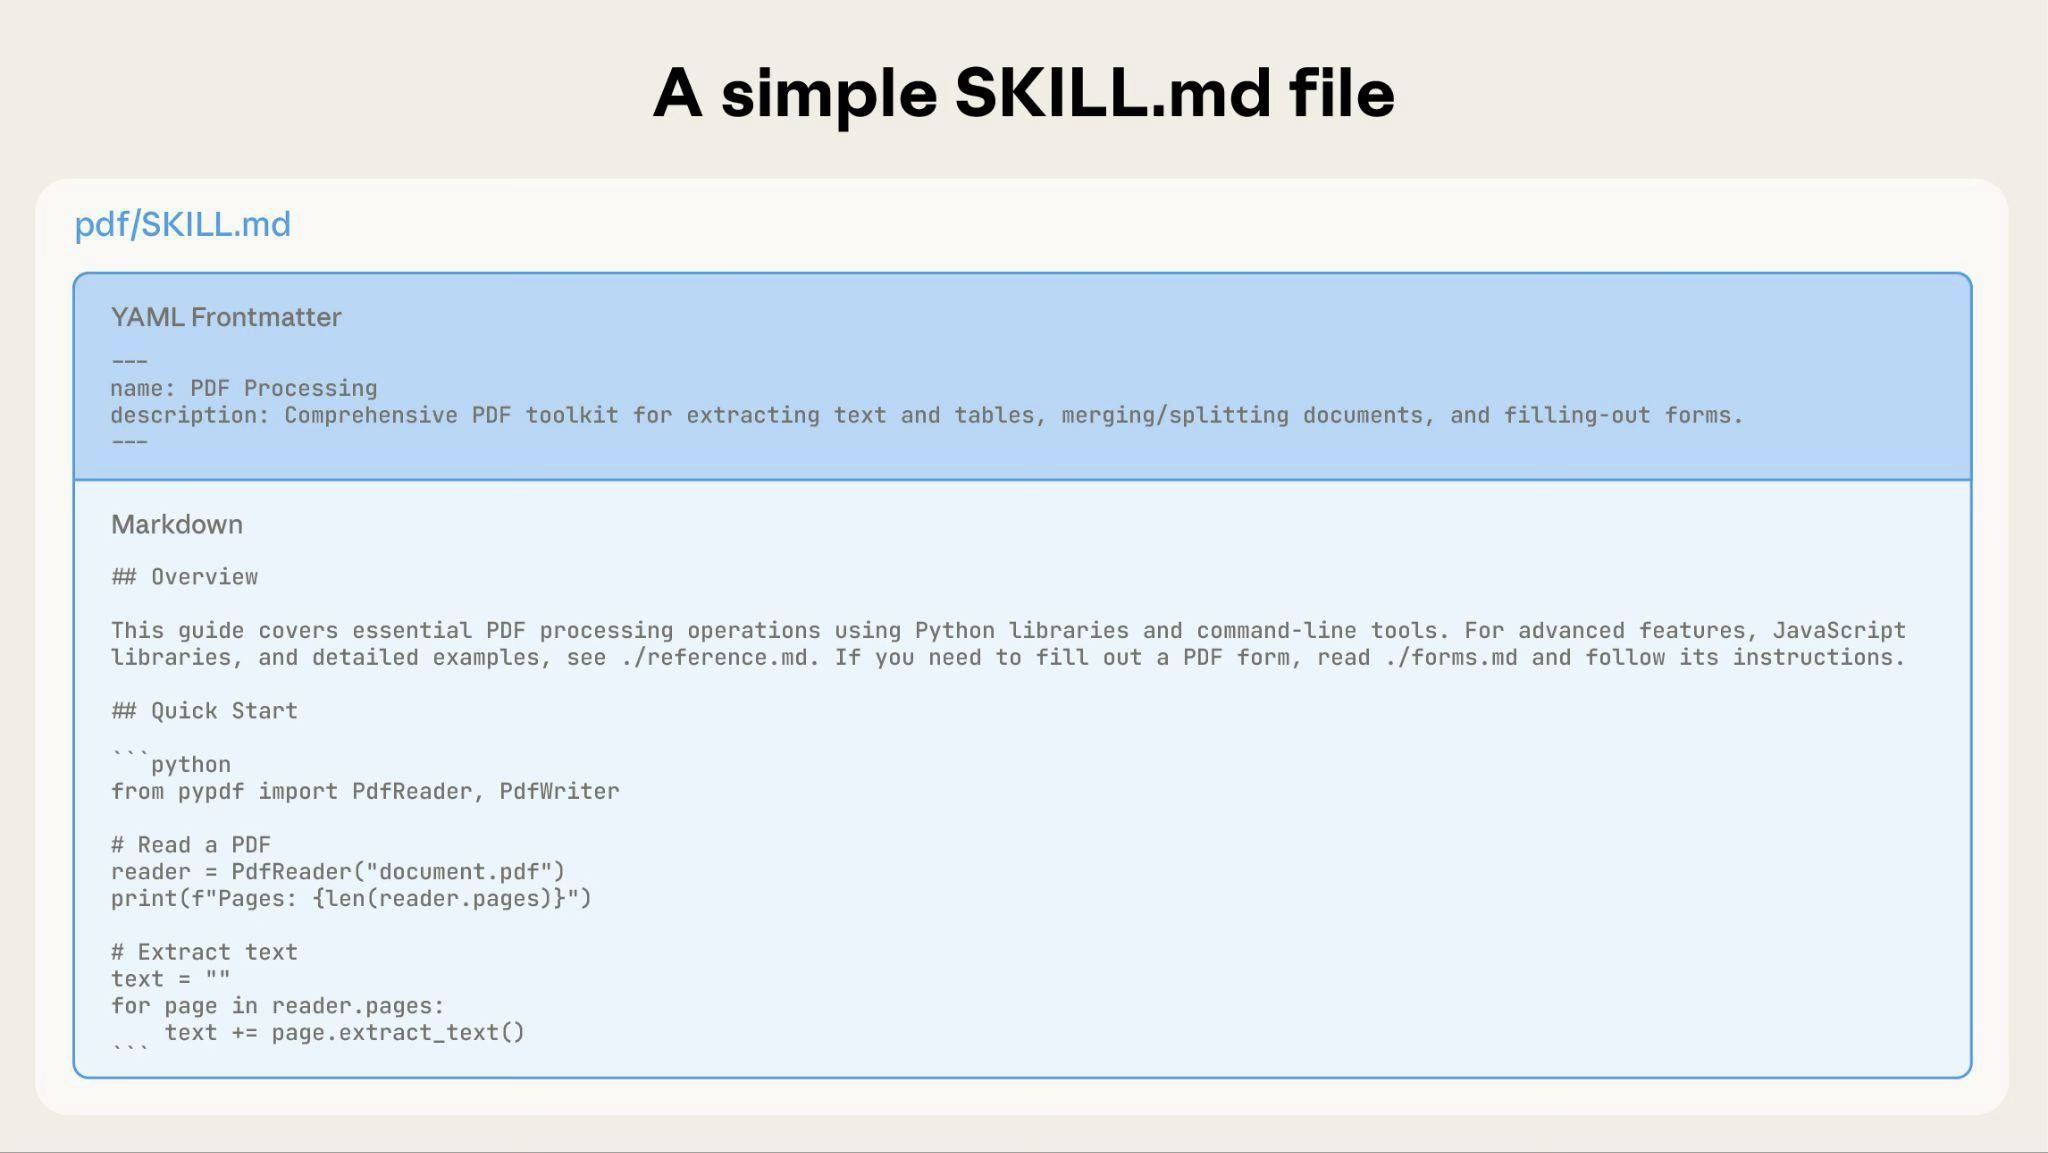
스킬이 커지면 클로드가 필요할 때만 로드하는 추가 콘텐츠를 번들할 수 있어요:
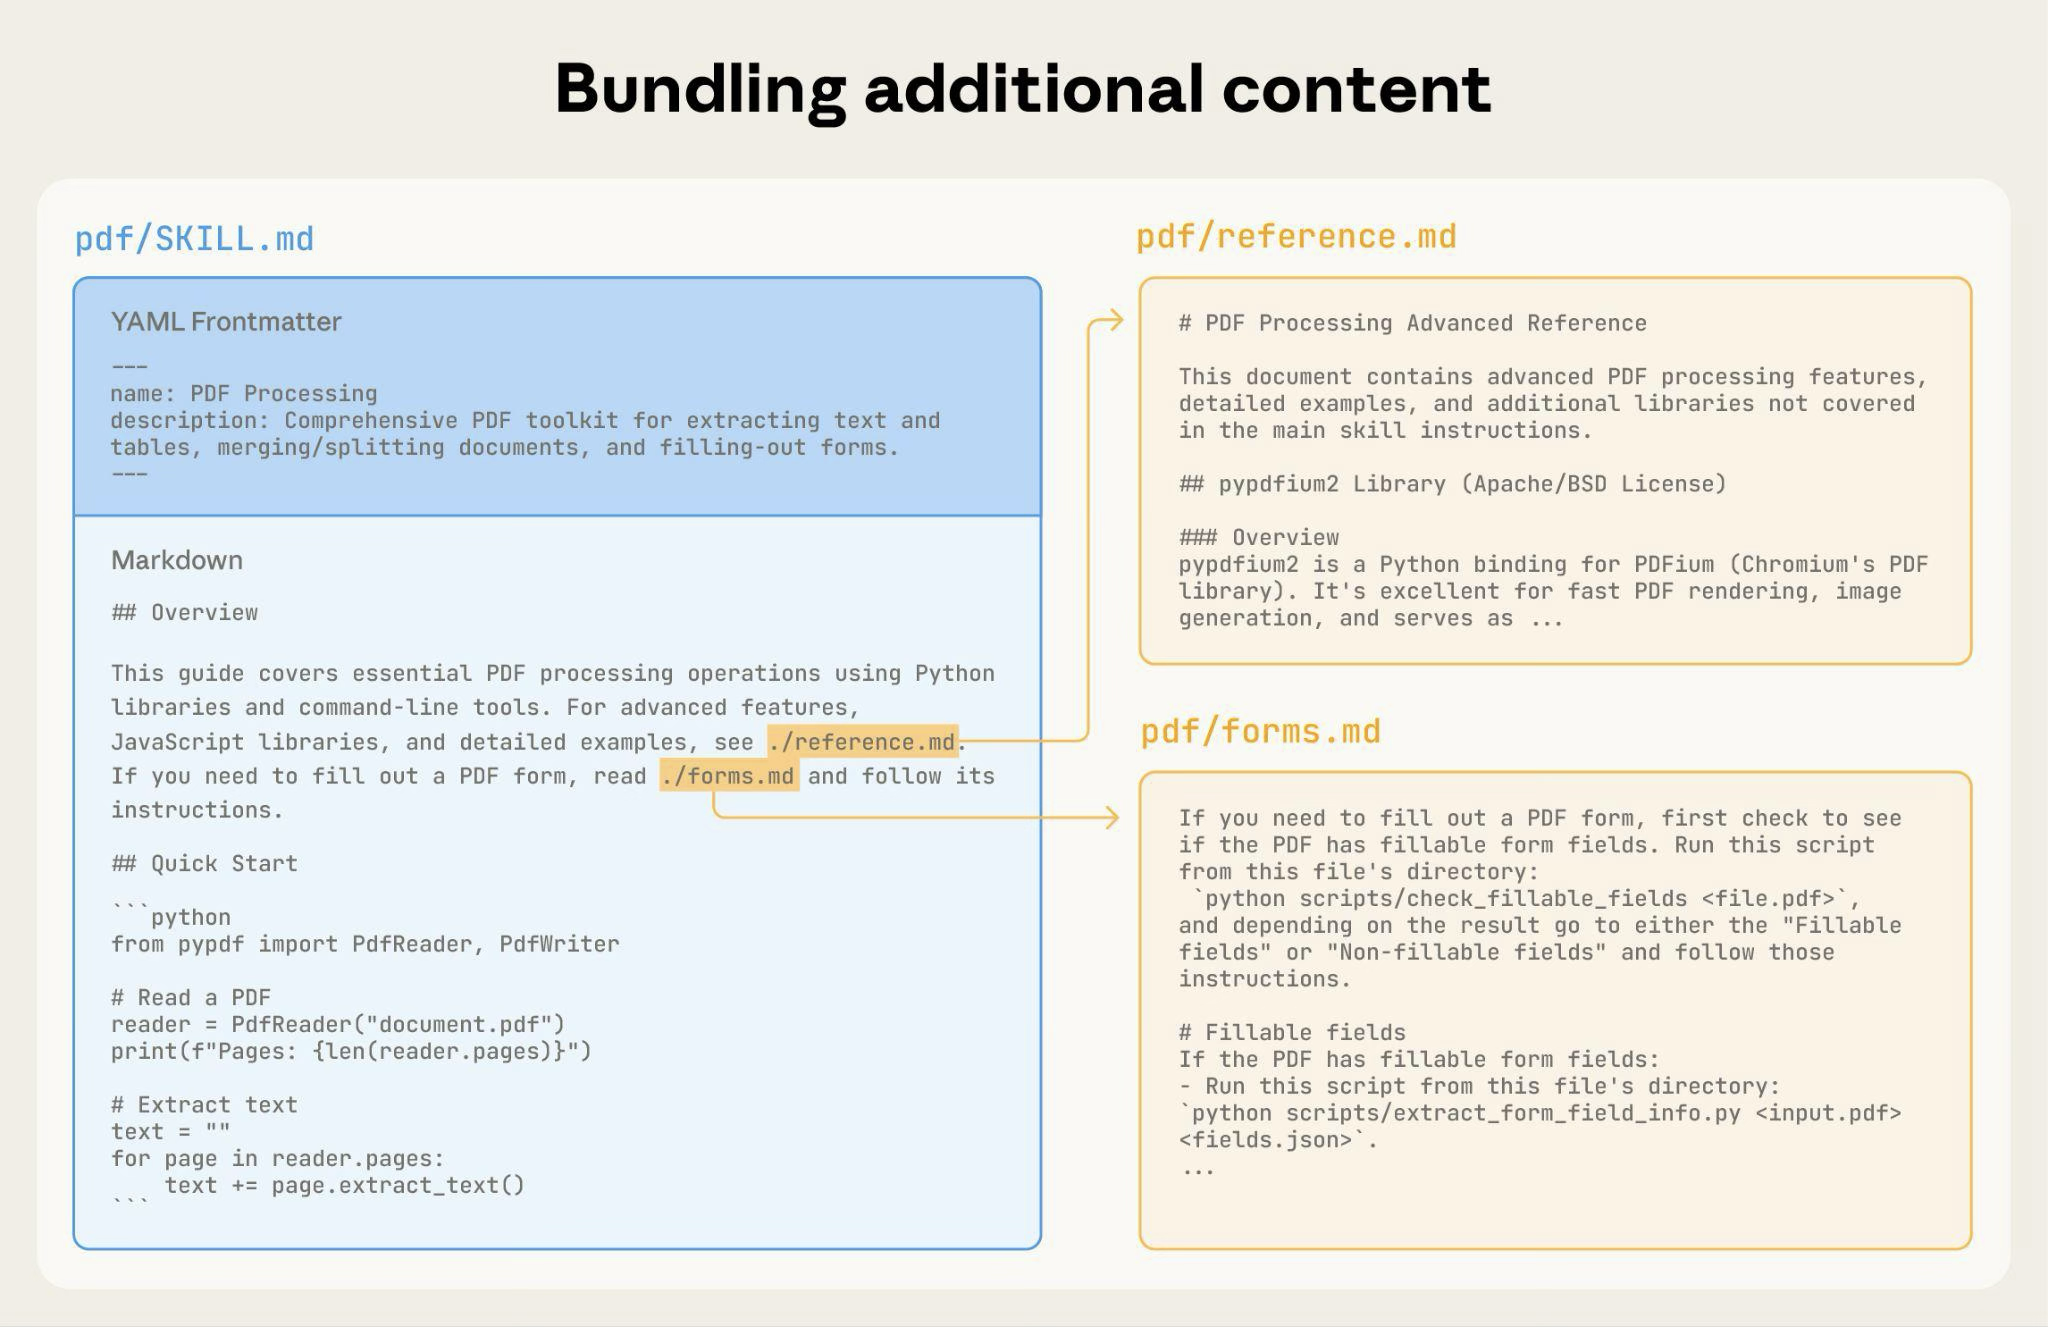
완전한 스킬 디렉터리 구조는 이렇게 보일 수 있어요:
-
pdf/-
SKILL.md: 주 지시 (발동 시 로드) -
FORMS.md: 양식 작성 가이드 (필요할 때 로드) -
reference.md: API 참조 (필요할 때 로드) -
examples.md: 사용 예시 (필요할 때 로드) -
scripts/analyze_form.py: 유틸리티 스크립트 (실행, 로드 아님)fill_form.py: 양식 작성 스크립트validate.py: 검증 스크립트
-
패턴 1: 참조가 있는 고수준 가이드
---
name: pdf-processing
description: Extracts text and tables from PDF files, fills forms, and merges documents. Use when working with PDF files or when the user mentions PDFs, forms, or document extraction.
---

# PDF Processing

## Quick start

Extract text with pdfplumber:
```python
import pdfplumber
with pdfplumber.open("file.pdf") as pdf:
    text = pdf.pages[0].extract_text()
```

## Advanced features

**Form filling**: See [FORMS.md](FORMS.md) for complete guide
**API reference**: See [REFERENCE.md](REFERENCE.md) for all methods
**Examples**: See [EXAMPLES.md](EXAMPLES.md) for common patterns
클로드는 FORMS.md, REFERENCE.md, EXAMPLES.md를 필요할 때만 로드해요.
패턴 2: 도메인별 조직
여러 도메인을 가진 스킬의 경우 무관한 컨텍스트를 로드하지 않도록 도메인별로 콘텐츠를 조직하세요. 사용자가 판매 지표에 대해 물으면 클로드는 재무나 마케팅 데이터가 아니라 판매 관련 스키마만 읽어야 해요. 이렇게 하면 토큰 사용을 낮추고 컨텍스트를 집중 유지해요.
-
bigquery-skill/-
SKILL.md(개요 및 탐색) -
reference/finance.md(매출, 청구 지표)sales.md(기회, 파이프라인)product.md(API 사용, 기능)marketing.md(캠페인, 어트리뷰션)
-
# BigQuery Data Analysis

## Available datasets

**Finance**: Revenue, ARR, billing → See [reference/finance.md](reference/finance.md)
**Sales**: Opportunities, pipeline, accounts → See [reference/sales.md](reference/sales.md)
**Product**: API usage, features, adoption → See [reference/product.md](reference/product.md)
**Marketing**: Campaigns, attribution, email → See [reference/marketing.md](reference/marketing.md)

## Quick search

Find specific metrics using grep:

```bash
grep -i "revenue" reference/finance.md
grep -i "pipeline" reference/sales.md
grep -i "api usage" reference/product.md
```
패턴 3: 조건부 세부 사항
기본 콘텐츠를 보여주고 고급 콘텐츠로 연결하세요:
# DOCX Processing

## Creating documents

Use docx-js for new documents. See [DOCX-JS.md](DOCX-JS.md).

## Editing documents

For simple edits, modify the XML directly.

**For tracked changes**: See [REDLINING.md](REDLINING.md)
**For OOXML details**: See [OOXML.md](OOXML.md)
클로드는 사용자가 그 기능을 필요로 할 때만 REDLINING.md나 OOXML.md를 읽어요.
깊게 중첩된 참조 피하기
클로드는 다른 참조 파일에서 참조된 파일을 부분적으로 읽을 수 있어요. 중첩 참조를 만나면 클로드는 전체 파일을 읽는 대신 head -100 같은 명령으로 내용을 미리 볼 수 있고, 이는 불완전한 정보로 이어져요.
SKILL.md에서 한 단계 깊이로 참조를 유지하세요. 모든 참조 파일은 SKILL.md에서 직접 연결되어 클로드가 필요할 때 완전한 파일을 읽도록 보장해야 해요.
나쁜 예시: 너무 깊음:
# SKILL.md
See [advanced.md](advanced.md)...

# advanced.md
See [details.md](details.md)...

# details.md
Here's the actual information...
좋은 예시: 한 단계 깊이:
# SKILL.md

**Basic usage**: [instructions in SKILL.md]
**Advanced features**: See [advanced.md](advanced.md)
**API reference**: See [reference.md](reference.md)
**Examples**: See [examples.md](examples.md)
더 긴 참조 파일을 목차로 구조화하기
100줄보다 긴 참조 파일에는 상단에 목차를 포함하세요. 이렇게 하면 클로드가 부분 읽기로 미리 볼 때도 사용 가능한 정보의 전체 범위를 볼 수 있게 해요.
예시:
# API Reference

## Contents
- Authentication and setup
- Core methods (create, read, update, delete)
- Advanced features (batch operations, webhooks)
- Error handling patterns
- Code examples

## Authentication and setup
...
...
Core methods
...
클로드는 그다음 전체 파일을 읽거나 필요에 따라 특정 섹션으로 이동할 수 있어요.

이 파일시스템 기반 아키텍처가 점진적 공개를 어떻게 가능하게 하는지에 대한 자세한 내용은 이 가이드 뒷부분의 [런타임 환경](https://platform.claude.com/docs/en/agents-and-tools/agent-skills/best-practices#runtime-environment) 섹션을 참고하세요.

## 워크플로우와 피드백 루프 (Workflows and feedback loops)

### 복잡한 작업에는 워크플로우 사용하기

복잡한 작업을 명확하고 순차적인 단계로 나누세요. 특히 복잡한 워크플로우의 경우 클로드가 응답에 복사해 진행하면서 체크할 수 있는 체크리스트를 제공하세요.

**예시 1: 연구 종합 워크플로우** (코드 없는 스킬용):

````markdown
## Research synthesis workflow

Copy this checklist and track your progress:
Research Progress:
- Step 1: Read all source documents
- Step 2: Identify key themes
- Step 3: Cross-reference claims
- Step 4: Create structured summary
- Step 5: Verify citations
**Step 1: Read all source documents**

Review each document in the `sources/` directory. Note the main arguments and supporting evidence.

**Step 2: Identify key themes**

Look for patterns across sources. What themes appear repeatedly? Where do sources agree or disagree?

**Step 3: Cross-reference claims**

For each major claim, verify it appears in the source material. Note which source supports each point.

**Step 4: Create structured summary**

Organize findings by theme. Include:
- Main claim
- Supporting evidence from sources
- Conflicting viewpoints (if any)

**Step 5: Verify citations**

Check that every claim references the correct source document. If citations are incomplete, return to Step 3.
이 예시는 워크플로우가 코드가 필요 없는 분석 작업에 어떻게 적용되는지 보여줘요. 체크리스트 패턴은 복잡하고 다단계인 어떤 프로세스에도 작동해요.
예시 2: PDF 양식 작성 워크플로우 (코드 있는 스킬용):
## PDF form filling workflow

Copy this checklist and check off items as you complete them:

```
Task Progress:
- [ ] Step 1: Analyze the form (run analyze_form.py)
- [ ] Step 2: Create field mapping (edit fields.json)
- [ ] Step 3: Validate mapping (run validate_fields.py)
- [ ] Step 4: Fill the form (run fill_form.py)
- [ ] Step 5: Verify output (run verify_output.py)
```

**Step 1: Analyze the form**

Run: `python scripts/analyze_form.py input.pdf`

This extracts form fields and their locations, saving to `fields.json`.

**Step 2: Create field mapping**

Edit `fields.json` to add values for each field.

**Step 3: Validate mapping**

Run: `python scripts/validate_fields.py fields.json`

Fix any validation errors before continuing.

**Step 4: Fill the form**

Run: `python scripts/fill_form.py input.pdf fields.json output.pdf`

**Step 5: Verify output**

Run: `python scripts/verify_output.py output.pdf`

If verification fails, return to Step 2.
명확한 단계는 클로드가 중요 검증을 건너뛰는 것을 방지해요. 체크리스트는 클로드와 당신 모두가 다단계 워크플로우를 통한 진행을 추적하는 데 도움을 줘요.
피드백 루프 구현하기
흔한 패턴: 유효성 검사기 실행 → 오류 수정 → 반복
이 패턴은 출력 품질을 크게 개선해요.
예시 1: 스타일 가이드 준수 (코드 없는 스킬용):
## Content review process

1. Draft your content following the guidelines in STYLE_GUIDE.md
2. Review against the checklist:
   - Check terminology consistency
   - Verify examples follow the standard format
   - Confirm all required sections are present
3. If issues found:
   - Note each issue with specific section reference
   - Revise the content
   - Review the checklist again
4. Only proceed when all requirements are met
5. Finalize and save the document
이는 스크립트 대신 참조 문서를 사용하는 검증 루프 패턴을 보여줘요. "검증자"는 STYLE_GUIDE.md이며, 클로드는 읽고 비교해 검사를 수행해요.
예시 2: 문서 편집 프로세스 (코드 있는 스킬용):
## Document editing process

1. Make your edits to `word/document.xml`
2. **Validate immediately**: `python ooxml/scripts/validate.py unpacked_dir/`
3. If validation fails:
   - Review the error message carefully
   - Fix the issues in the XML
   - Run validation again
4. **Only proceed when validation passes**
5. Rebuild: `python ooxml/scripts/pack.py unpacked_dir/ output.docx`
6. Test the output document
검증 루프는 오류를 일찍 잡아요.
콘텐츠 지침 (Content guidelines)
시간에 민감한 정보 피하기
곧 낡게 될 정보를 포함하지 마세요:
나쁜 예시: 시간에 민감함 (틀려질 것):
If you're doing this before August 2025, use the old API.
After August 2025, use the new API.
좋은 예시 ("old patterns" 섹션 사용):
## Current method

Use the v2 API endpoint: `api.example.com/v2/messages`

## Old patterns

<details>
<summary>Legacy v1 API (deprecated 2025-08)</summary>

The v1 API used: `api.example.com/v1/messages`

This endpoint is no longer supported.
</details>
old patterns 섹션은 메인 콘텐츠를 어지럽히지 않고 역사적 맥락을 제공해요.
일관된 용어 사용하기
하나의 용어를 골라 스킬 전체에서 사용하세요:
좋음 - 일관적:
- 항상 "API endpoint"
- 항상 "field"
- 항상 "extract"
나쁨 - 비일관적:
- "API endpoint", "URL", "API route", "path" 혼용
- "field", "box", "element", "control" 혼용
- "extract", "pull", "get", "retrieve" 혼용
일관성은 클로드가 지시를 파싱하고 따르는 데 도움을 줘요.
일반적인 패턴 (Common patterns)
템플릿 패턴
출력 형식에 대한 템플릿을 제공하세요. 필요에 따라 엄격함 수준을 맞추세요.
엄격한 요구사항의 경우 (API 응답이나 데이터 형식 등):
## Report structure

ALWAYS use this exact template structure:

```markdown
# [Analysis Title]

## Executive summary
[One-paragraph overview of key findings]

## Key findings
- Finding 1 with supporting data
- Finding 2 with supporting data
- Finding 3 with supporting data

## Recommendations
1. Specific actionable recommendation
2. Specific actionable recommendation
```
유연한 지침의 경우 (적응이 유용할 때):
## Report structure

Here is a sensible default format, but use your best judgment based on the analysis:

```markdown
# [Analysis Title]

## Executive summary
[Overview]

## Key findings
[Adapt sections based on what you discover]

## Recommendations
[Tailor to the specific context]
```

Adjust sections as needed for the specific analysis type.
예시 패턴
출력 품질이 예시를 보는 데 달려 있는 스킬의 경우 일반 프롬프팅에서처럼 입력/출력 쌍을 제공하세요:
## Commit message format

Generate commit messages following these examples:

**Example 1:**
Input: Added user authentication with JWT tokens
Output:
```
feat(auth): implement JWT-based authentication

Add login endpoint and token validation middleware
```

**Example 2:**
Input: Fixed bug where dates displayed incorrectly in reports
Output:
```
fix(reports): correct date formatting in timezone conversion

Use UTC timestamps consistently across report generation
```

**Example 3:**
Input: Updated dependencies and refactored error handling
Output:
```
chore: update dependencies and refactor error handling

- Upgrade lodash to 4.17.21
- Standardize error response format across endpoints
```

Follow this style: type(scope): brief description, then detailed explanation.
예시는 설명만으로는 전달하기 어려운 원하는 스타일과 세부 수준을 클로드에게 더 명확하게 전달해요.
조건부 워크플로우 패턴
의사 결정 지점을 통해 클로드를 안내하세요:
## Document modification workflow

1. Determine the modification type:

   **Creating new content?** → Follow "Creation workflow" below
   **Editing existing content?** → Follow "Editing workflow" below

2. Creation workflow:
   - Use docx-js library
   - Build document from scratch
   - Export to .docx format

3. Editing workflow:
   - Unpack existing document
   - Modify XML directly
   - Validate after each change
   - Repack when complete
평가와 반복 (Evaluation and iteration)
먼저 평가 구축하기
광범위한 문서를 작성하기 전에 평가를 만드세요. 이렇게 하면 상상된 문제를 문서화하는 대신 스킬이 실제 문제를 해결하도록 보장해요.
평가 주도 개발:
- 격차 식별: 스킬 없이 대표 작업에서 클로드를 실행하세요. 특정 실패나 누락된 컨텍스트를 문서화하세요
- 평가 만들기: 이 격차를 테스트할 세 가지 시나리오를 구축하세요
- 기준선 설정: 스킬 없이 클로드의 성능을 측정하세요
- 최소 지시 작성: 격차를 해결하고 평가를 통과할 만큼의 콘텐츠를 만드세요
- 반복: 평가를 실행하고 기준선과 비교하며 다듬으세요
이 접근 방식은 실현되지 않을지도 모르는 요구 사항을 예상하는 대신 실제 문제를 해결하고 있는지 보장해요.
평가 구조:
{
  "skills": ["pdf-processing"],
  "query": "Extract all text from this PDF file and save it to output.txt",
  "files": ["test-files/document.pdf"],
  "expected_behavior": [
    "Successfully reads the PDF file using an appropriate PDF processing library or command-line tool",
    "Extracts text content from all pages in the document without missing any pages",
    "Saves the extracted text to a file named output.txt in a clear, readable format"
  ]
}
클로드와 함께 스킬을 반복적으로 개발하기
가장 효과적인 스킬 개발 프로세스는 클로드 자신을 수반해요. 클로드의 한 인스턴스("Claude A")와 협력해 다른 인스턴스("Claude B")가 사용하는 스킬을 만들어요. Claude A는 지시를 설계하고 다듬는 데 도움을 주고, Claude B는 실제 작업에서 테스트해요. 클로드 모델은 효과적인 에이전트 지시를 작성하는 방법과 에이전트가 필요한 정보를 모두 이해하기 때문에 이렇게 작동해요.
새 스킬 만들기:
-
스킬 없이 작업 완료: 일반 프롬프팅으로 Claude A와 문제를 해결하세요. 작업하는 동안 자연스럽게 컨텍스트를 제공하고, 선호를 설명하고, 절차적 지식을 공유하게 돼요. 반복적으로 제공하는 정보를 주목하세요.
-
재사용 가능한 패턴 식별: 작업을 완료한 후 유사한 미래 작업에 유용할 컨텍스트가 무엇이었는지 식별하세요.
예시: BigQuery 분석을 진행했다면 테이블 이름, 필드 정의, 필터링 규칙("항상 테스트 계정 제외" 등), 흔한 쿼리 패턴을 제공했을 수 있어요.
-
Claude A에게 스킬 만들기를 요청: "Create a Skill that captures this BigQuery analysis pattern we just used. Include the table schemas, naming conventions, and the rule about filtering test accounts."
클로드 모델은 스킬 형식과 구조를 본래 이해해요. 스킬 만들기에 클로드의 도움을 받기 위해 특별한 시스템 프롬프트나 "writing skills" 스킬이 필요 없어요. 클로드에게 스킬을 만들라고 하면 적절한 프론트매터와 본문 콘텐츠가 있는 올바르게 구조화된 SKILL.md 콘텐츠를 생성해요. -
간결함 검토: Claude A가 불필요한 설명을 추가하지 않았는지 확인하세요. "Remove the explanation about what win rate means - Claude already knows that."라고 물어보세요.
-
정보 아키텍처 개선: Claude A에게 콘텐츠를 더 효과적으로 조직해 달라고 요청하세요. 예: "Organize this so the table schema is in a separate reference file. We might add more tables later."
-
유사한 작업 테스트: 관련 유스 케이스에서 Claude B(스킬이 로드된 새 인스턴스)와 스킬을 사용하세요. Claude B가 올바른 정보를 찾고, 규칙을 정확히 적용하며, 작업을 성공적으로 처리하는지 관찰하세요.
-
관찰 기반으로 반복: Claude B가 어려움을 겪거나 무언가를 놓치면 구체적인 내용을 가지고 Claude A로 돌아가세요: "When Claude used this Skill, it forgot to filter by date for Q4. Should we add a section about date filtering patterns?"
기존 스킬 반복:
스킬을 개선할 때도 같은 계층적 패턴이 계속돼요. 다음을 번갈아 가며 수행해요:
- Claude A와 작업 (스킬을 다듬는 데 도움을 주는 전문가)
- Claude B로 테스트 (스킬을 사용해 실제 작업을 수행하는 에이전트)
- Claude B의 동작 관찰 및 통찰을 Claude A로 가져오기
-
실제 워크플로우에서 스킬 사용: Claude B(스킬 로드)에게 테스트 시나리오가 아닌 실제 작업을 주세요
-
Claude B의 동작 관찰: 어려워하는 곳, 성공하는 곳, 예상치 못한 선택을 하는 곳을 기록하세요
예시 관찰: "When I asked Claude B for a regional sales report, it wrote the query but forgot to filter out test accounts, even though the Skill mentions this rule."
-
개선을 위해 Claude A로 복귀: 현재 SKILL.md를 공유하고 관찰한 것을 설명하세요. "I noticed Claude B forgot to filter test accounts when I asked for a regional report. The Skill mentions filtering, but maybe it's not prominent enough?"라고 물어보세요.
-
Claude A의 제안 검토: Claude A는 규칙을 더 눈에 띄게 만들도록 재구성하거나, "always filter" 대신 "MUST filter" 같은 더 강한 표현을 사용하거나, 워크플로우 섹션을 재구성하는 것을 제안할 수 있어요.
-
변경 적용 및 테스트: Claude A의 개선으로 스킬을 업데이트하고 유사한 요청으로 Claude B와 다시 테스트하세요
-
사용에 따라 반복: 새 시나리오를 만나면서 이 관찰-다듬기-테스트 주기를 계속하세요. 각 반복은 가정이 아닌 실제 에이전트 동작을 기반으로 스킬을 개선해요.
팀 피드백 수집:
- 동료와 스킬을 공유하고 사용을 관찰하세요
- 물어보세요: 스킬이 예상대로 활성화되나요? 지시가 명확한가요? 무엇이 빠졌나요?
- 자체 사용 패턴의 격차를 해결하기 위해 피드백을 통합하세요
이 접근이 왜 작동하나: Claude A는 에이전트 요구를 이해하고, 당신은 도메인 전문성을 제공하며, Claude B는 실제 사용을 통해 격차를 드러내고, 반복적 개선은 가정이 아닌 관찰된 동작을 기반으로 스킬을 향상시켜요.
클로드가 스킬을 탐색하는 방법 관찰하기
스킬을 반복하면서 클로드가 실제로 스킬을 어떻게 사용하는지 주의를 기울이세요. 다음을 지켜보세요:
- 예상치 못한 탐색 경로: 클로드가 예상하지 못한 순서로 파일을 읽나요? 이는 구조가 생각만큼 직관적이지 않다는 신호일 수 있어요
- 놓친 연결: 클로드가 중요 파일에 대한 참조를 따르지 못하나요? 링크를 더 명시적이거나 눈에 띄게 해야 할 수 있어요
- 특정 섹션 과의존: 클로드가 같은 파일을 반복해서 읽으면 그 콘텐츠를 메인 SKILL.md에 넣어야 하는지 고려하세요
- 무시된 콘텐츠: 클로드가 번들 파일에 절대 접근하지 않으면 불필요하거나 주 지시에서 신호가 약할 수 있어요
가정이 아닌 관찰을 기반으로 반복하세요. 스킬 메타데이터의 'name'과 'description'은 특히 중요해요. 클로드는 현재 작업에 응답해 스킬을 발동시킬지 결정할 때 이것을 사용해요. 스킬이 무엇을 하고 언제 사용해야 하는지 명확히 설명하는지 확인하세요.
피해야 할 안티 패턴 (Anti-patterns to avoid)
Windows 스타일 경로 피하기
Windows에서도 파일 경로에 항상 앞 슬래시를 사용하세요:
- ✓ 좋음:
scripts/helper.py,reference/guide.md - ✗ 피할 것:
scripts\helper.py,reference\guide.md
Unix 스타일 경로는 모든 플랫폼에서 작동하는 반면, Windows 스타일 경로는 Unix 시스템에서 오류를 일으켜요.
너무 많은 옵션 제공 피하기
필요하지 않다면 여러 접근을 제시하지 마세요:
**나쁜 예시: 선택지가 너무 많음** (혼란스러움):
"You can use pypdf, or pdfplumber, or PyMuPDF, or pdf2image, or..."

**좋은 예시: 기본값 제공** (탈출구 포함):
"Use pdfplumber for text extraction:
```python
import pdfplumber
```

For scanned PDFs requiring OCR, use pdf2image with pytesseract instead."
고급: 실행 가능한 코드가 있는 스킬
다음 섹션은 실행 가능한 스크립트를 포함하는 스킬에 초점을 맞춰요. 스킬이 마크다운 지시만 사용한다면 효과적인 스킬 체크리스트로 건너뛰세요.
해결하세요, 미루지 마세요
스킬용 스크립트를 작성할 때 오류 조건을 클로드에게 미루지 말고 처리하세요.
좋은 예시: 오류를 명시적으로 처리:
def process_file(path):
    """Process a file, creating it if it doesn't exist."""
    try:
        with open(path) as f:
            return f.read()
    except FileNotFoundError:
        # Create file with default content instead of failing
        print(f"File {path} not found, creating default")
        with open(path, "w") as f:
            f.write("")
        return ""
    except PermissionError:
        # Provide alternative instead of failing
        print(f"Cannot access {path}, using default")
        return ""
나쁜 예시: 클로드에게 미룸:
def process_file(path):
    # Just fail and let Claude figure it out
    return open(path).read()
구성 파라미터도 "부두 상수(voodoo constants)"를 피하도록(Ousterhout의 법칙) 정당화되고 문서화되어야 해요. 올바른 값을 모른다면 클로드가 어떻게 결정할까요?
좋은 예시: 자기 문서화:
# HTTP requests typically complete within 30 seconds
# Longer timeout accounts for slow connections
REQUEST_TIMEOUT = 30

# Three retries balances reliability vs speed
# Most intermittent failures resolve by the second retry
MAX_RETRIES = 3
나쁜 예시: 마법의 숫자:
TIMEOUT = 47  # Why 47?
RETRIES = 5  # Why 5?
유틸리티 스크립트 제공하기
클로드가 스크립트를 작성할 수 있더라도 사전 제작된 스크립트는 이점을 제공해요:
유틸리티 스크립트의 이점:
- 생성된 코드보다 더 신뢰할 수 있음
- 토큰 절약 (코드를 컨텍스트에 포함할 필요 없음)
- 시간 절약 (코드 생성 불필요)
- 사용 전반에 걸쳐 일관성 보장
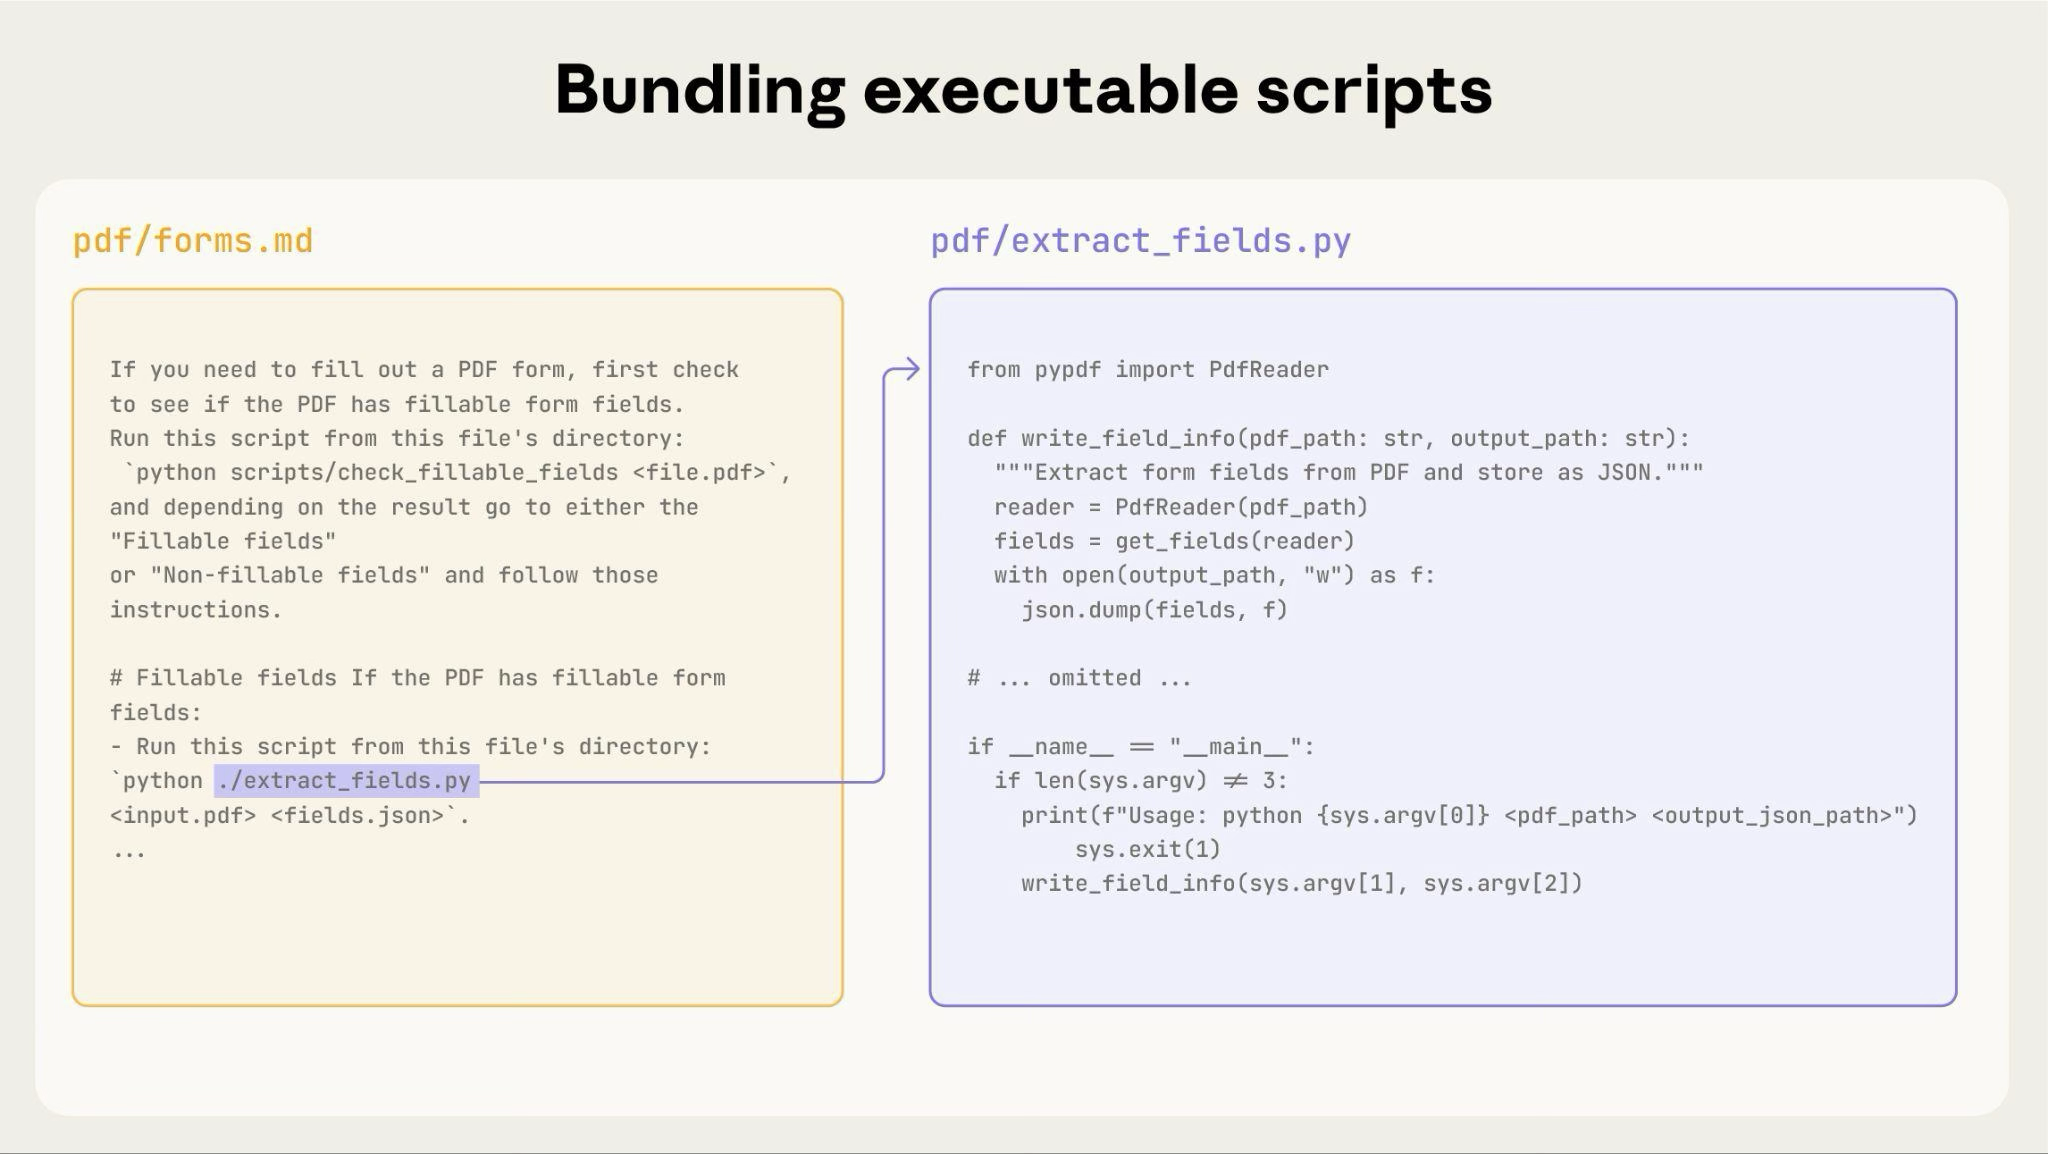
앞선 다이어그램은 실행 가능한 스크립트가 지시 파일과 어떻게 나란히 작동하는지 보여줘요. 지시 파일(forms.md)이 스크립트를 참조하고, 클로드는 내용을 컨텍스트에 로드하지 않고 실행할 수 있어요.
중요한 구분: 지시에서 클로드가 해야 할 것을 명확히 하세요:
- 스크립트 실행 (가장 흔함): "Run
analyze_form.pyto extract fields" - 참조로 읽기 (복잡한 로직용): "See
analyze_form.pyfor the field extraction algorithm"
대부분의 유틸리티 스크립트에서는 더 신뢰할 수 있고 효율적이므로 실행이 선호돼요. 스크립트 실행이 어떻게 작동하는지에 대한 내용은 다음 런타임 환경 섹션을 참고하세요.
예시:
## Utility scripts

**analyze_form.py**: Extract all form fields from PDF

```bash
python scripts/analyze_form.py input.pdf > fields.json
```

Output format:
```json
{
  "field_name": {"type": "text", "x": 100, "y": 200},
  "signature": {"type": "sig", "x": 150, "y": 500}
}
```

**validate_boxes.py**: Check for overlapping bounding boxes

```bash
python scripts/validate_boxes.py fields.json
# Returns: "OK" or lists conflicts
```

**fill_form.py**: Apply field values to PDF

```bash
python scripts/fill_form.py input.pdf fields.json output.pdf
```
시각적 분석 사용하기
입력을 이미지로 렌더링할 수 있으면 클로드가 분석하게 하세요:
## Form layout analysis

1. Convert PDF to images:
   ```bash
   python scripts/pdf_to_images.py form.pdf
   ```

2. Analyze each page image to identify form fields
3. Claude can see field locations and types visually
클로드의 비전 능력은 레이아웃과 구조를 분석하는 데 도움이 돼요.
검증 가능한 중간 출력 만들기
클로드가 복잡하고 개방적인 작업을 수행할 때 실수를 할 수 있어요. "계획-검증-실행" 패턴은 클로드가 구조화된 형식으로 먼저 계획을 만들고, 실행 전에 스크립트로 그 계획을 검증하게 함으로써 오류를 일찍 잡아요.
예시: 스프레드시트를 기반으로 PDF의 50개 양식 필드를 업데이트하도록 클로드에게 요청하는 것을 상상해 보세요. 검증 없이 클로드는 존재하지 않는 필드를 참조하고, 충돌하는 값을 만들고, 필수 필드를 놓치거나, 업데이트를 잘못 적용할 수 있어요.
해결책: 앞서 보여준 워크플로우 패턴(PDF 양식 작성)을 사용하되, 변경을 적용하기 전에 검증되는 중간 changes.json 파일을 추가하세요. 워크플로우는 다음과 같이 됩니다: 분석 → 계획 파일 만들기 → 계획 검증 → 실행 → 확인.
이 패턴이 작동하는 이유:
- 오류를 일찍 잡음: 검증이 변경 적용 전에 문제를 찾아요
- 기계 검증 가능: 스크립트가 객관적 검증을 제공해요
- 가역적 계획: 클로드는 원본을 건드리지 않고 계획을 반복할 수 있어요
- 명확한 디버깅: 오류 메시지가 특정 문제를 가리켜요
언제 사용: 배치 작업, 파괴적 변경, 복잡한 검증 규칙, 고위험 작업.
구현 팁: "Field 'signature_date' not found. Available fields: customer_name, order_total, signature_date_signed" 같은 특정 오류 메시지로 검증 스크립트를 자세히 만들어 클로드가 문제를 고치게 도와주세요.
의존성 패키징
스킬은 플랫폼 특화 제한이 있는 코드 실행 환경에서 실행돼요:
- claude.ai: npm과 PyPI에서 패키지를 설치하고 GitHub 리포지토리에서 가져올 수 있어요
- Claude API: 네트워크 접근이 없고 런타임 패키지 설치가 없어요
SKILL.md에 필요한 패키지를 나열하고 코드 실행 도구 문서에서 사용 가능한지 확인하세요.
런타임 환경
스킬은 파일시스템 접근, bash 명령, 코드 실행 능력이 있는 코드 실행 환경에서 실행돼요. 이 아키텍처에 대한 개념적 설명은 개요의 스킬 아키텍처를 참고하세요.
이것이 작성에 미치는 영향:
클로드가 스킬에 접근하는 방식:
- 메타데이터 사전 로드: 시작 시 모든 스킬의 YAML 프론트매터에서 이름과 설명이 시스템 프롬프트에 로드돼요
- 파일 주문형 읽기: 클로드는 필요할 때 bash Read 도구로 파일시스템에서 SKILL.md와 다른 파일에 접근해요
- 스크립트 효율적 실행: 유틸리티 스크립트는 전체 내용을 컨텍스트에 로드하지 않고 bash로 실행할 수 있어요. 스크립트의 출력만 토큰을 소비해요
- 큰 파일에 컨텍스트 비용 없음: 참조 파일, 데이터, 문서는 실제로 읽기 전까지 컨텍스트 토큰을 소비하지 않아요
-
파일 경로가 중요: 클로드는 스킬 디렉터리를 파일시스템처럼 탐색해요. 백슬래시(
reference/guide.md)가 아닌 앞 슬래시를 사용하세요 -
파일을 설명적으로 명명: 콘텐츠를 나타내는 이름을 사용하세요:
doc2.md가 아니라form_validation_rules.md -
발견을 위해 조직: 도메인이나 기능별로 디렉터리를 구조화하세요
- 좋음:
reference/finance.md,reference/sales.md - 나쁨:
docs/file1.md,docs/file2.md
- 좋음:
-
포괄적 리소스 번들: 완전한 API 문서, 광범위한 예시, 대규모 데이터셋 포함, 접근 전까지 컨텍스트 비용 없음
-
결정적 작업에는 스크립트 선호: 검증 코드를 클로드가 생성하도록 요청하는 대신
validate_form.py를 작성하세요 -
실행 의도를 명확히:
- "Run
analyze_form.pyto extract fields" (실행) - "See
analyze_form.pyfor the extraction algorithm" (참조로 읽기)
- "Run
-
파일 접근 패턴 테스트: 실제 요청으로 테스트해 클로드가 디렉터리 구조를 탐색할 수 있는지 확인하세요
예시:
-
bigquery-skill/-
SKILL.md(개요, 참조 파일 가리킴) -
reference/finance.md(매출 지표)sales.md(파이프라인 데이터)product.md(사용 분석)
-
사용자가 매출에 대해 물으면 클로드는 SKILL.md를 읽고 reference/finance.md 참조를 보고 bash로 그 파일만 읽어요. sales.md와 product.md 파일은 파일시스템에 남아 필요할 때까지 컨텍스트 토큰을 0개 소비해요. 이 파일시스템 기반 모델이 점진적 공개를 가능하게 해요. 클로드는 정확히 각 작업에 필요한 것을 탐색하고 선택적으로 로드할 수 있어요.
기술 아키텍처에 대한 완전한 세부 사항은 스킬 개요의 스킬이 작동하는 방식을 참고하세요.
MCP 도구 참조
스킬이 MCP(Model Context Protocol) 도구를 사용한다면 "tool not found" 오류를 피하기 위해 항상 정규화된(fully qualified) 도구 이름을 사용하세요.
형식: ServerName:tool_name
예시:
Use the BigQuery:bigquery_schema tool to retrieve table schemas.
Use the GitHub:create_issue tool to create issues.
여기서:
BigQuery와GitHub는 MCP 서버 이름bigquery_schema와create_issue는 그 서버 안의 도구 이름
서버 접두사 없이는 클로드가 도구를 찾지 못할 수 있어요. 특히 여러 MCP 서버가 사용 가능할 때요.
도구가 설치되어 있다고 가정하지 않기
패키지가 사용 가능하다고 가정하지 마세요:
**나쁜 예시: 설치 가정**:

"Use the pdf library to process the file."

**좋은 예시: 의존성 명시**:

"Install required package: `pip install pypdf`

Then use it:
```python
from pypdf import PdfReader
reader = PdfReader("file.pdf")
```"
기술 노트 (Technical notes)
YAML 프론트매터 요구 사항
SKILL.md 프론트매터는 특정 검증 규칙이 있는 name과 description 필드를 요구해요:
name: 최대 64자, 소문자/숫자/하이픈만, XML 태그 없음, 예약어 없음description: 최대 1,024자, 비어 있지 않음, XML 태그 없음
완전한 구조 세부 사항은 스킬 개요를 참고하세요.
토큰 예산 (Token budgets)
최적 성능을 위해 SKILL.md 본문을 500줄 미만으로 유지하세요. 콘텐츠가 이를 넘으면 앞서 설명한 점진적 공개 패턴을 사용해 별도 파일로 나누세요. 아키텍처 세부 사항은 스킬 개요를 참고하세요.
효과적인 스킬 체크리스트 (Checklist for effective Skills)
스킬을 공유하기 전에 다음을 확인하세요:
핵심 품질 (Core quality)
- 설명이 구체적이고 핵심 용어를 포함
- 설명이 스킬이 무엇을 하는지와 언제 사용해야 하는지를 모두 포함
- SKILL.md 본문이 500줄 미만
- 추가 세부 사항이 별도 파일에 있음(필요 시)
- 시간에 민감한 정보 없음(또는 "old patterns" 섹션에)
- 전체에 일관된 용어 사용
- 예시가 추상적이지 않고 구체적
- 파일 참조가 한 단계 깊이
- 점진적 공개를 적절히 사용
- 워크플로우에 명확한 단계가 있음
코드와 스크립트 (Code and scripts)
- 스크립트가 클로드에게 미루는 대신 문제를 해결
- 오류 처리가 명시적이고 유용
- "부두 상수" 없음(모든 값 정당화됨)
- 필요한 패키지가 지시에 나열되고 사용 가능한지 검증됨
- 스크립트에 명확한 문서가 있음
- Windows 스타일 경로 없음(모두 앞 슬래시)
- 중요 작업에 검증/확인 단계
- 품질에 중요한 작업에 피드백 루프 포함
테스트 (Testing)
- 최소 3개의 평가가 생성됨
- Haiku, Sonnet, Opus로 테스트됨
- 실제 사용 시나리오로 테스트됨
- 팀 피드백 통합됨(해당 시)