
실험 분석하기
실험 분석하기
이 페이지는 LangSmith에서 실험을 다룰 때 필요한 기본 작업들을 설명해요. 단일 실험 분석부터 기준선 설정, 실험 이름 변경까지 핵심적인 것들을 하나씩 살펴볼게요.
출처: 문서
본문
이 페이지에서는 LangSmith에서 실험을 작업할 때 필요한 몇 가지 핵심 작업을 설명합니다:
- 단일 실험 분석: 실험 결과를 보고 해석하고, 열을 커스터마이즈하고, 데이터를 필터링하고, 런을 비교합니다.
- Experiments 탭 뷰에서 기준선 설정: 능가하고 싶은 데이터셋에 대한 기준선(baseline)을 설정합니다.
- Experiments 탭 뷰에서 모델, 프롬프트, 도구로 필터링 및 그룹화: Experiments 탭 뷰에서 Models, Prompts, Tools 열을 사용해 실험을 필터링하고 그룹화합니다.
- 실험 결과를 CSV로 다운로드: 외부 분석과 공유를 위해 실험 데이터를 내보냅니다.
- 실험 이름 변경: Playground와 실험 뷰 모두에서 실험 이름을 업데이트합니다.
단일 실험 분석
실험을 실행한 후 LangSmith의 실험 뷰를 사용해 결과를 분석하고 실험 성능에 대한 인사이트를 얻을 수 있습니다.
실험 뷰 열기
실험 뷰를 열려면,
- Dataset & Experiments 페이지에서 관련 데이터셋을 선택하면 Experiments 탭 뷰가 열립니다.
- 보려는 실험의 행을 클릭합니다.
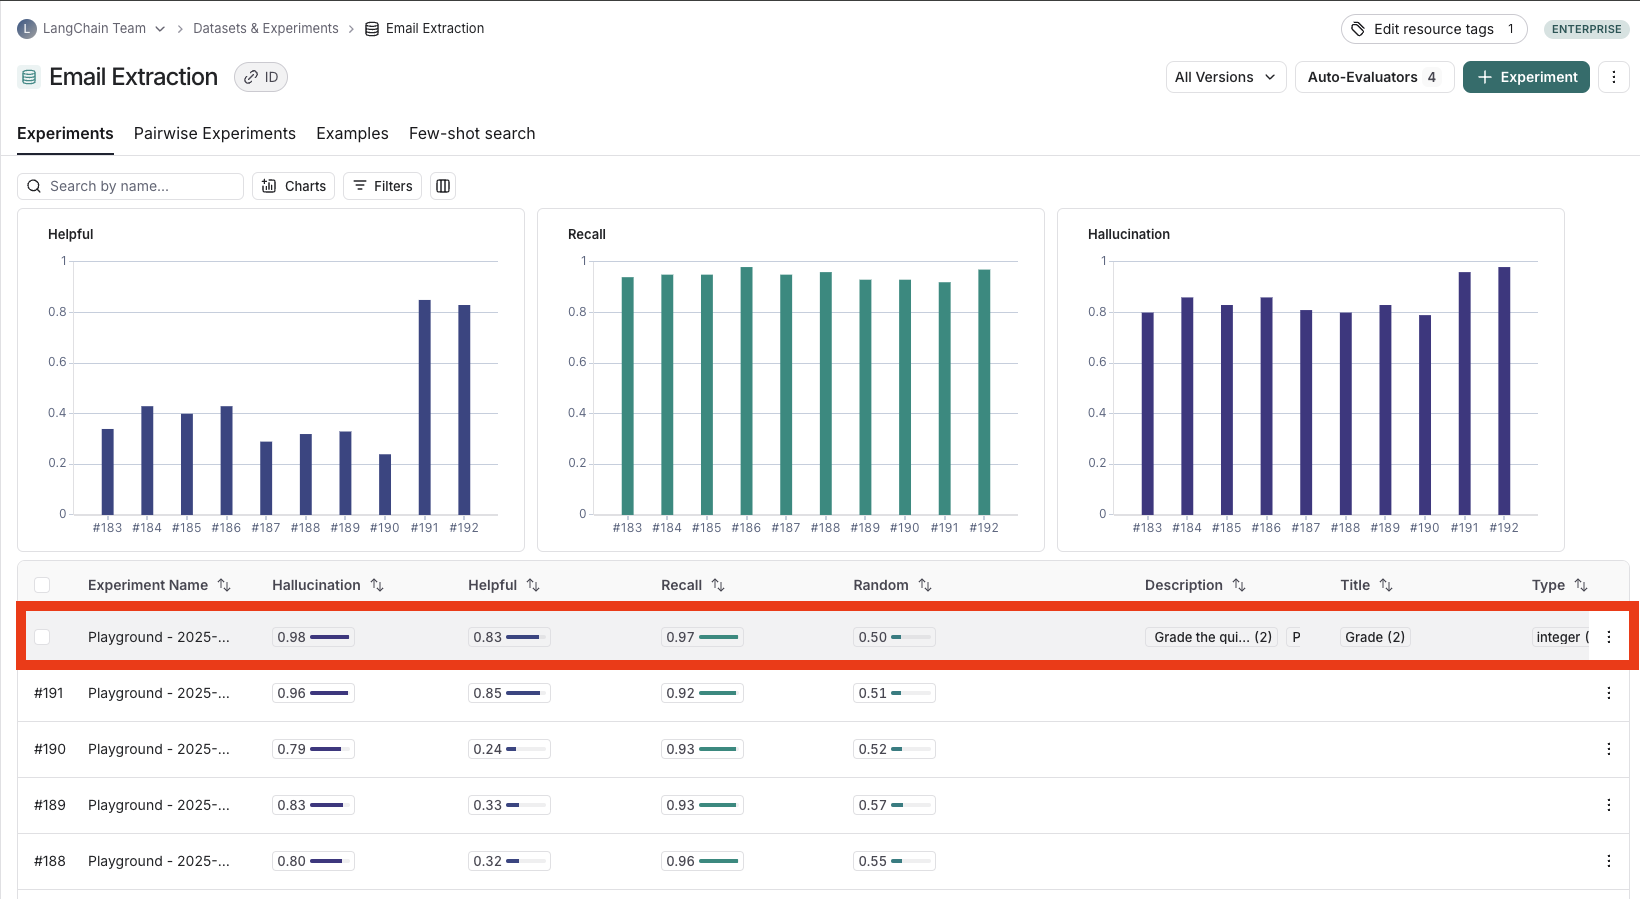
실험 결과 보기
열 커스터마이즈
기본적으로 실험 뷰는 데이터셋의 각 예제에 대한 입력, 출력, 기준 출력과 함께, 평가의 피드백 점수와 비용, 토큰 수, 지연 시간, 상태 같은 실험 메트릭을 보여줍니다.
뷰 오른쪽 상단의 Columns 아이콘을 클릭해 열을 커스터마이즈하면 실험 결과를 더 쉽게 해석할 수 있습니다:
- 입력, 출력, 기준 출력의 필드를 별도의 열로 분리할 수 있습니다. 입력/출력/기준 출력이 길고 중요 필드를 표면화하고 싶을 때 특히 유용합니다.
- 열을 숨기고 순서를 바꿔 분석에 집중된 뷰를 만들 수 있습니다.
- 피드백 점수의 소수 자릿수를 제어할 수 있습니다. 기본적으로 LangSmith는 숫자 피드백 점수를 소수점 2자리로 표시하지만, 소수점 6자리까지 커스터마이즈할 수 있습니다.
- Heat Map 임계값을 실험의 숫자 피드백 점수에 대해 높음/중간/낮음으로 설정할 수 있습니다. 이는 점수 칩이 빨간색 또는 초록색으로 렌더링되는 임계값에 영향을 줍니다:
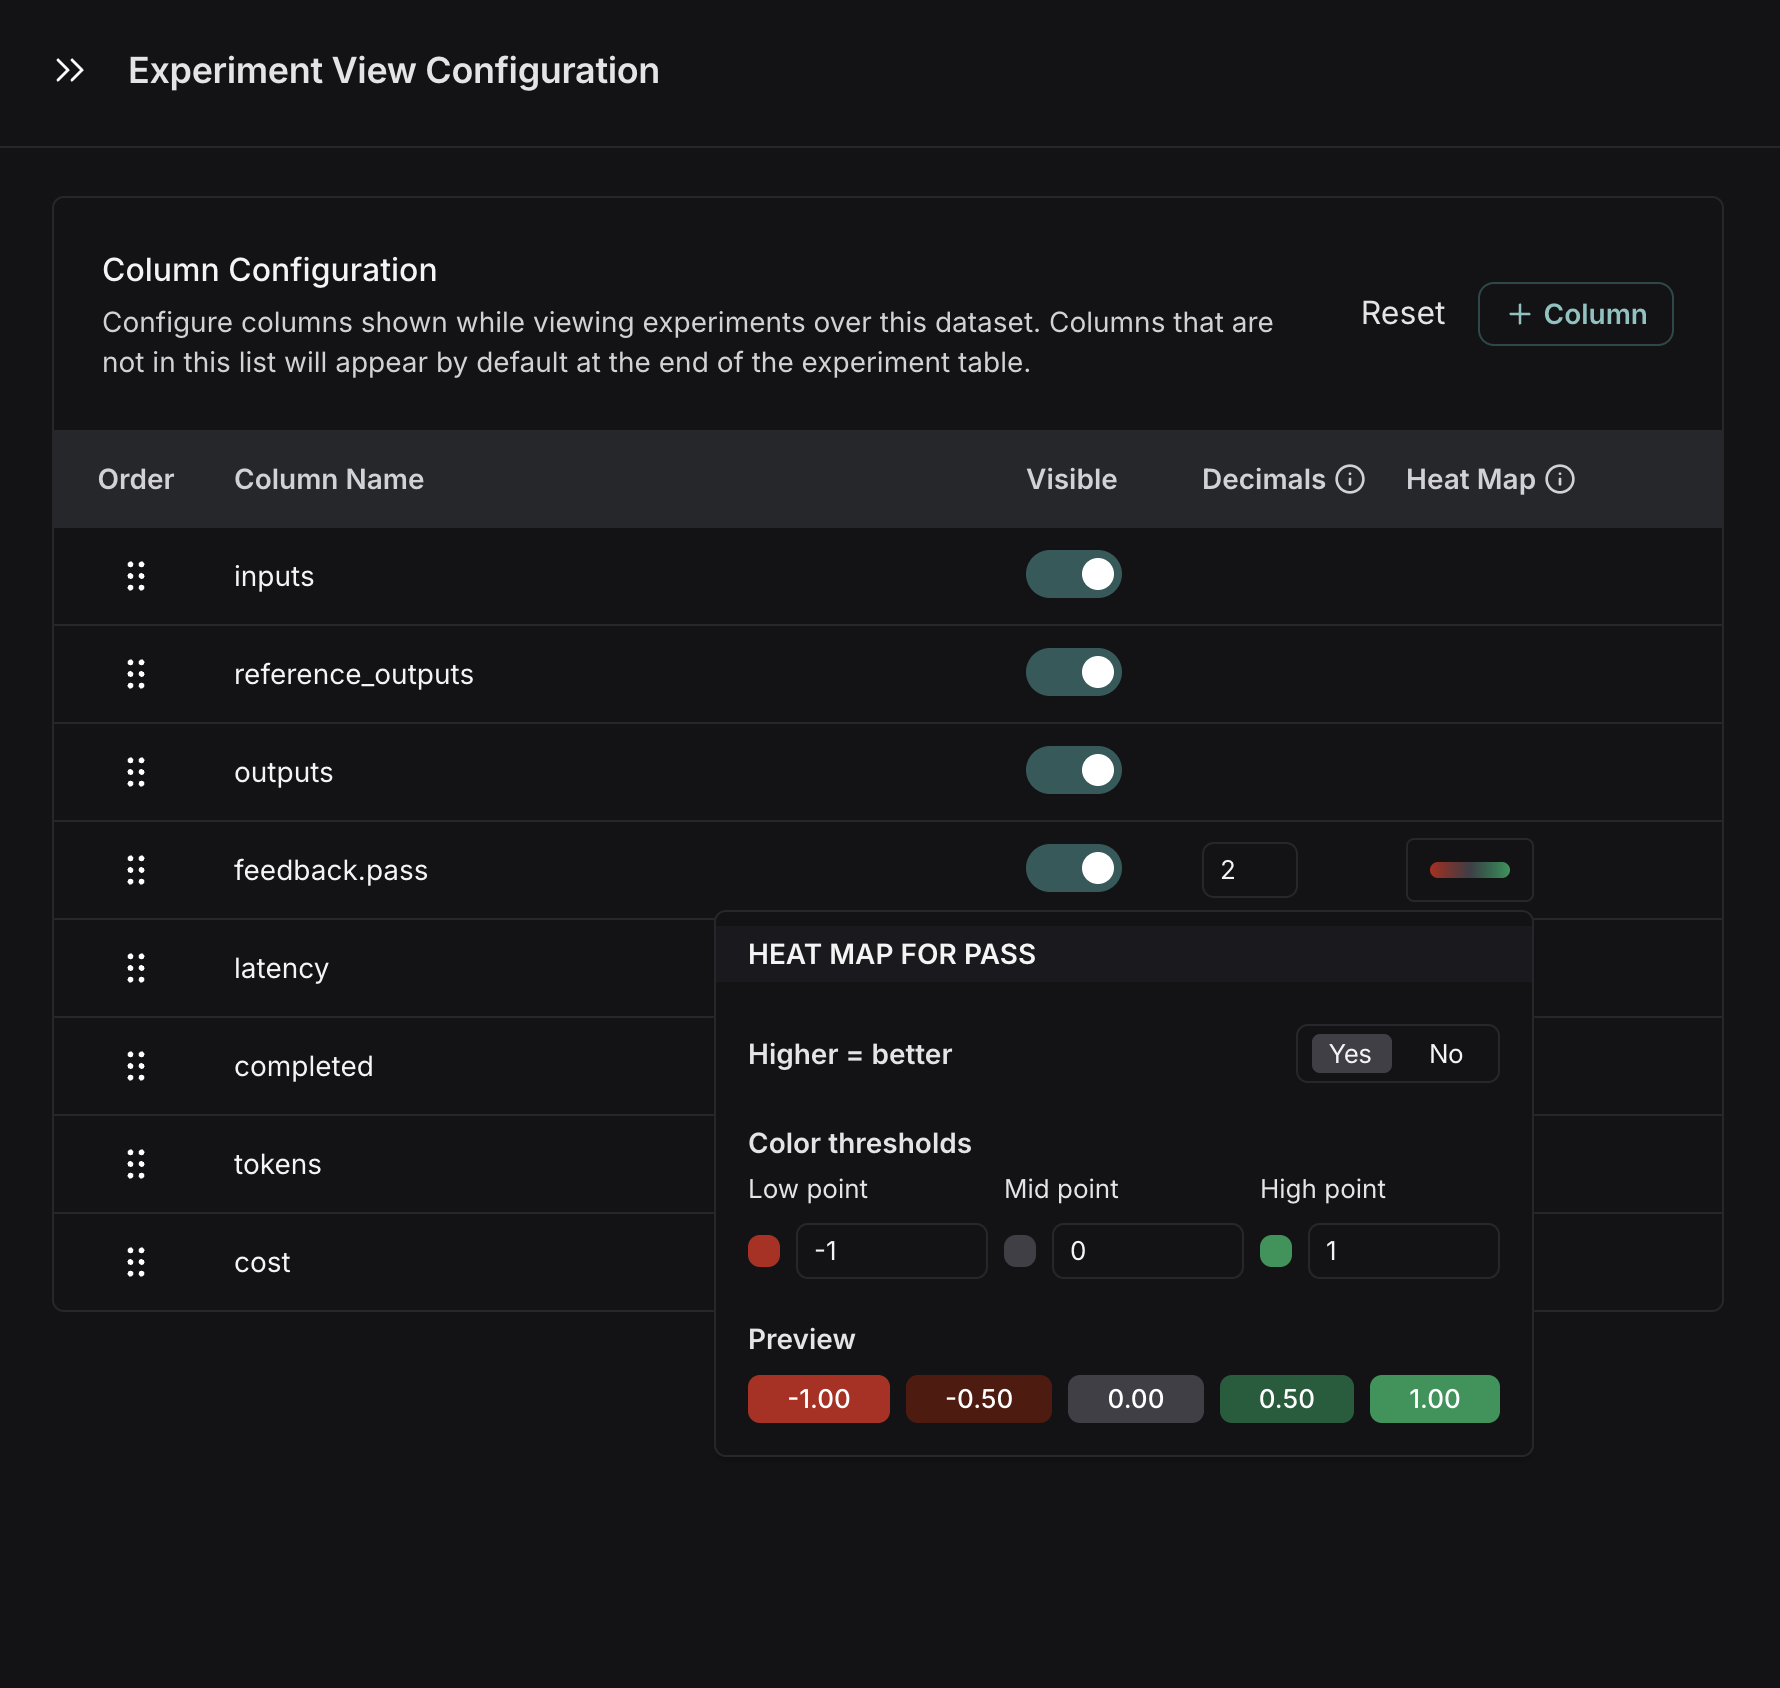
팁: 데이터셋 전체에 대한 기본 구성을 설정하거나, 설정을 일시적으로 자신에게만 저장할 수 있습니다.
정렬 및 필터링
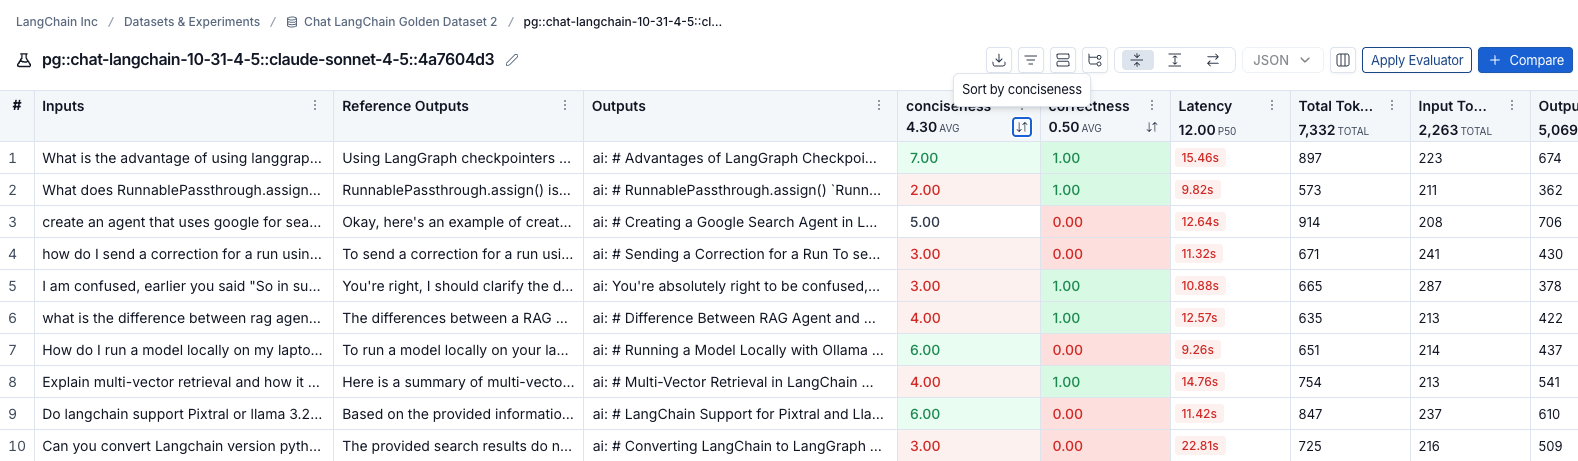
피드백 점수로 행을 정렬하려면 열 헤더의 Sort by 아이콘을 클릭합니다.
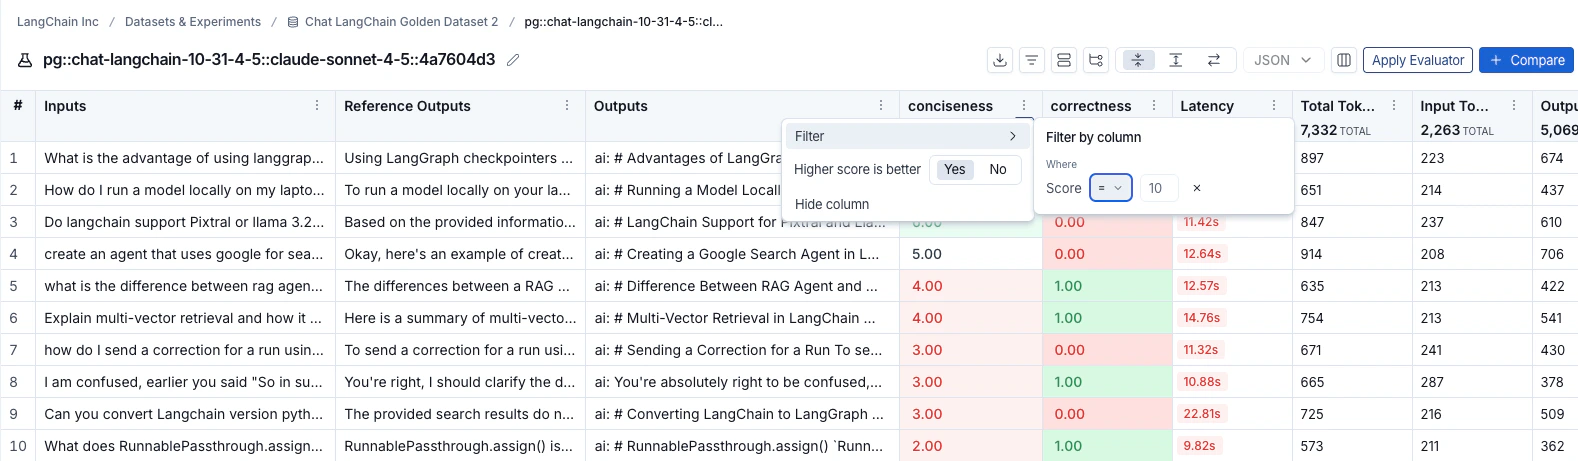
행을 필터링하려면 열 헤더의 아이콘을 클릭하고 필터 설정을 구성합니다.
테이블 뷰
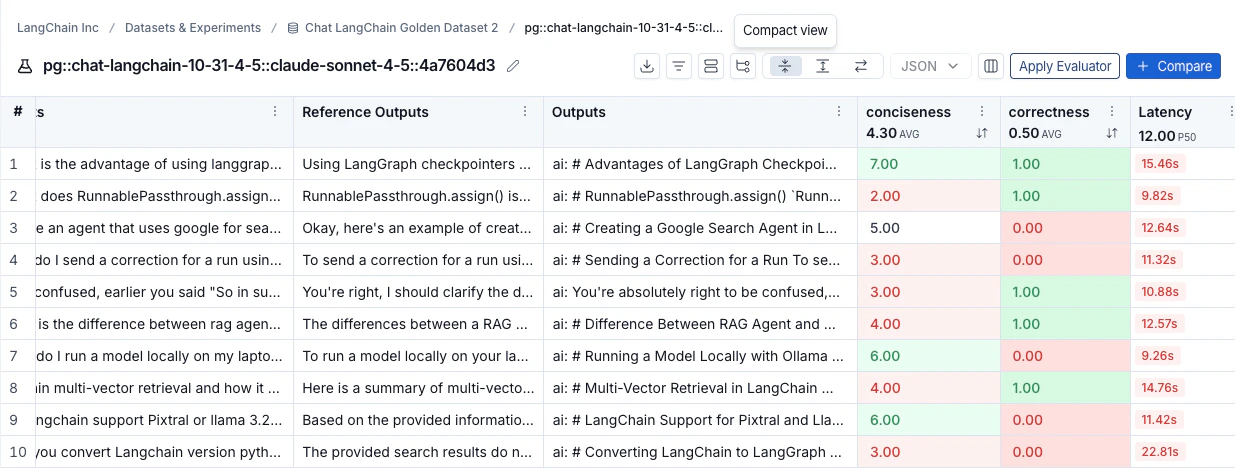
실험 뷰 오른쪽 상단의 세 가지 테이블 뷰 아이콘 중 하나를 선택합니다:
- Compact: 각 런을 단일 행으로 표시해 점수 비교를 빠르게 합니다.
- Full: 각 런의 전체 출력을 보여줍니다.
- Diff: 각 런의 기준 출력과 출력 사이의 텍스트 차이를 보여줍니다.
트레이스 보기
실험 뷰에서 아무 행이나 클릭하면 세부 정보 패널이 열리며, 해당 런의 트레이스와 피드백, 입력, 출력, 속성을 보여줍니다.
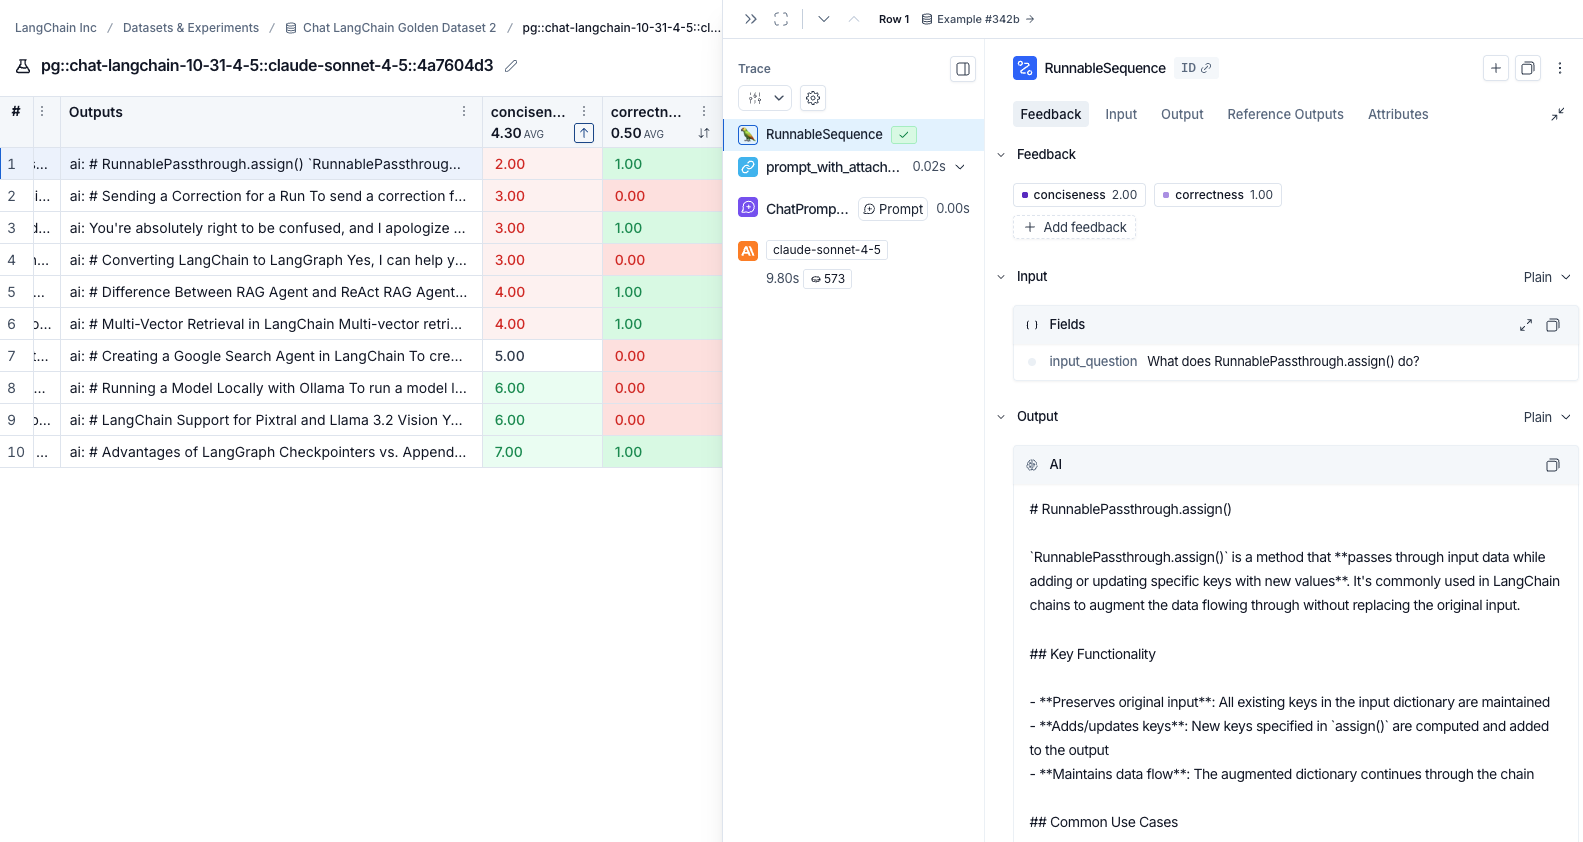
전체 트레이싱 프로젝트를 보려면 실험 뷰 오른쪽 상단의 View Project 아이콘을 클릭합니다.
평가기 런 보기
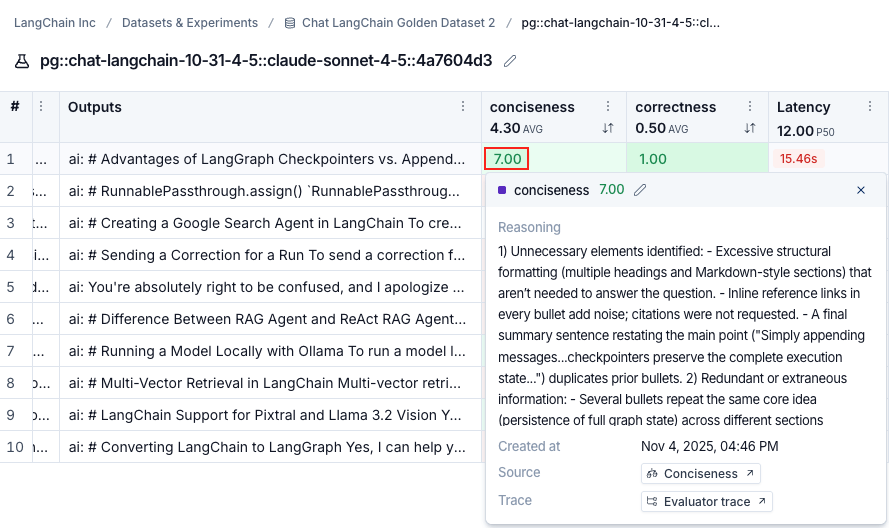
평가기 점수 위에 마우스를 올리면 해당 평가기 런에 대한 추가 세부 정보를 볼 수 있습니다. LLM-as-a-judge 평가기의 경우 Source 링크를 클릭해 사용된 프롬프트를 보거나, Evaluator trace를 클릭해 새 브라우저 탭에서 트레이스를 열 수 있습니다. 반복(repetitions)이 있는 실험의 경우 집계된 평균 점수를 클릭해 모든 개별 런에 대한 링크를 볼 수 있습니다.
실험 진행 상황 추적
Playground나 SDK에서 실행한 실험의 경우, 실험 헤더의 진행 표시줄이 완료 상태를 실시간으로 추적합니다. 실험 테이블의 Progress 열에도 동일한 진행 상황이 나타납니다. 진행 상황은 런과 평가 상태를 모두 반영합니다. 진행 표시줄 위에 마우스를 올리면 완료된 런 수와 평가된 런 수를 볼 수 있습니다.
참고: SDK를 통해 실행한 실험의 진행 상황 추적에는 다음이 필요합니다:
- Python:
langsmith>=0.8.16- TypeScript:
langsmith>=0.7.8
메타데이터로 결과 그룹화
예제에 메타데이터를 추가해 분류하고 정리할 수 있습니다. 예를 들어 질문-응답 데이터셋에서 사실 정확성을 평가한다면, 메타데이터에 각 질문이 속한 과목 영역을 포함할 수 있습니다. 메타데이터는 UI를 통해 또는 SDK를 통해 추가할 수 있습니다.
메타데이터로 결과를 분석하려면 실험 뷰 오른쪽 상단의 Group by 아이콘을 사용하고 원하는 메타데이터 키를 선택합니다. 그러면 각 메타데이터 그룹에 대한 평균 피드백 점수, 지연 시간, 총 토큰 수, 비용이 표시됩니다.
참고: 2025년 2월 20일 이후에 생성된 실험에서만 예제 메타데이터로 그룹화할 수 있습니다. 그 이전의 실험은 메타데이터가 실험 트레이스 자체에 있을 경우에만 여전히 그룹화할 수 있습니다.
반복 (Repetitions)
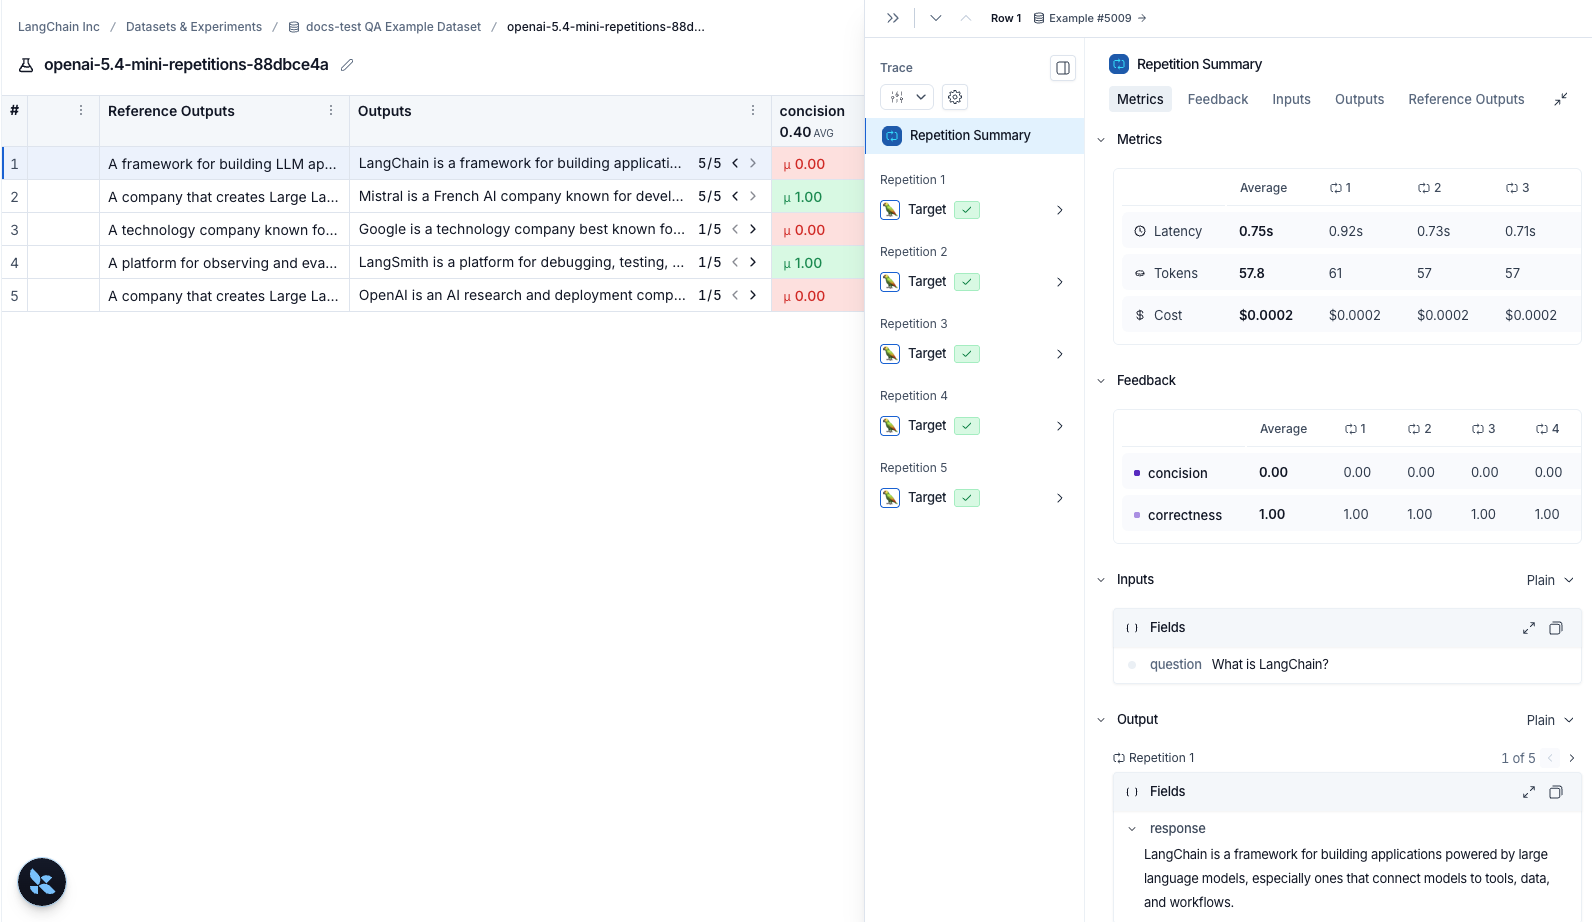
실험을 반복으로 실행했다면 아무 행이나 클릭해 세부 정보 패널을 엽니다. Repetition Summary에는 메트릭 표, 모든 피드백 점수가 표시되고, 출력을 전환하거나 트레이스와 함께 개별 반복을 볼 수 있습니다.
다른 실험과 비교
실험 뷰 오른쪽 상단에서 비교할 다른 실험을 선택할 수 있습니다. 그러면 두 실험이 어떻게 비교되는지 볼 수 있는 비교 뷰가 열립니다. 비교 뷰에 대해 자세히 알아보려면 실험 결과 비교 방법을 참고하세요.
Experiments 탭 뷰에서 기준선 설정
수십 개의 테스트를 실행할 수 있지만, 보통 능가하려는 특정 벤치마크가 있습니다. 기준선을 설정하면 결과를 이 참조점에 고정할 수 있어, 복잡한 실험 목록에서 개선이나 회귀를 식별할 수 있습니다.
기준선을 지정하면 다음을 할 수 있습니다:
- 참조 강조: 가장 성능이 좋은 런을 명시적으로 표시해, 반복하는 동안 Experiments 탭 뷰 상단에 유지되게 합니다.
- 즉시 diff 보기: 모든 실험의 성능 차이를 자동으로 볼 수 있어, 수동으로 나란히 선택할 필요가 없을 수 있습니다.
- 평가 가속화: 새 반복이 현재 성능 기준을 충족하거나 초과하는지 신속하게 판단할 수 있습니다.
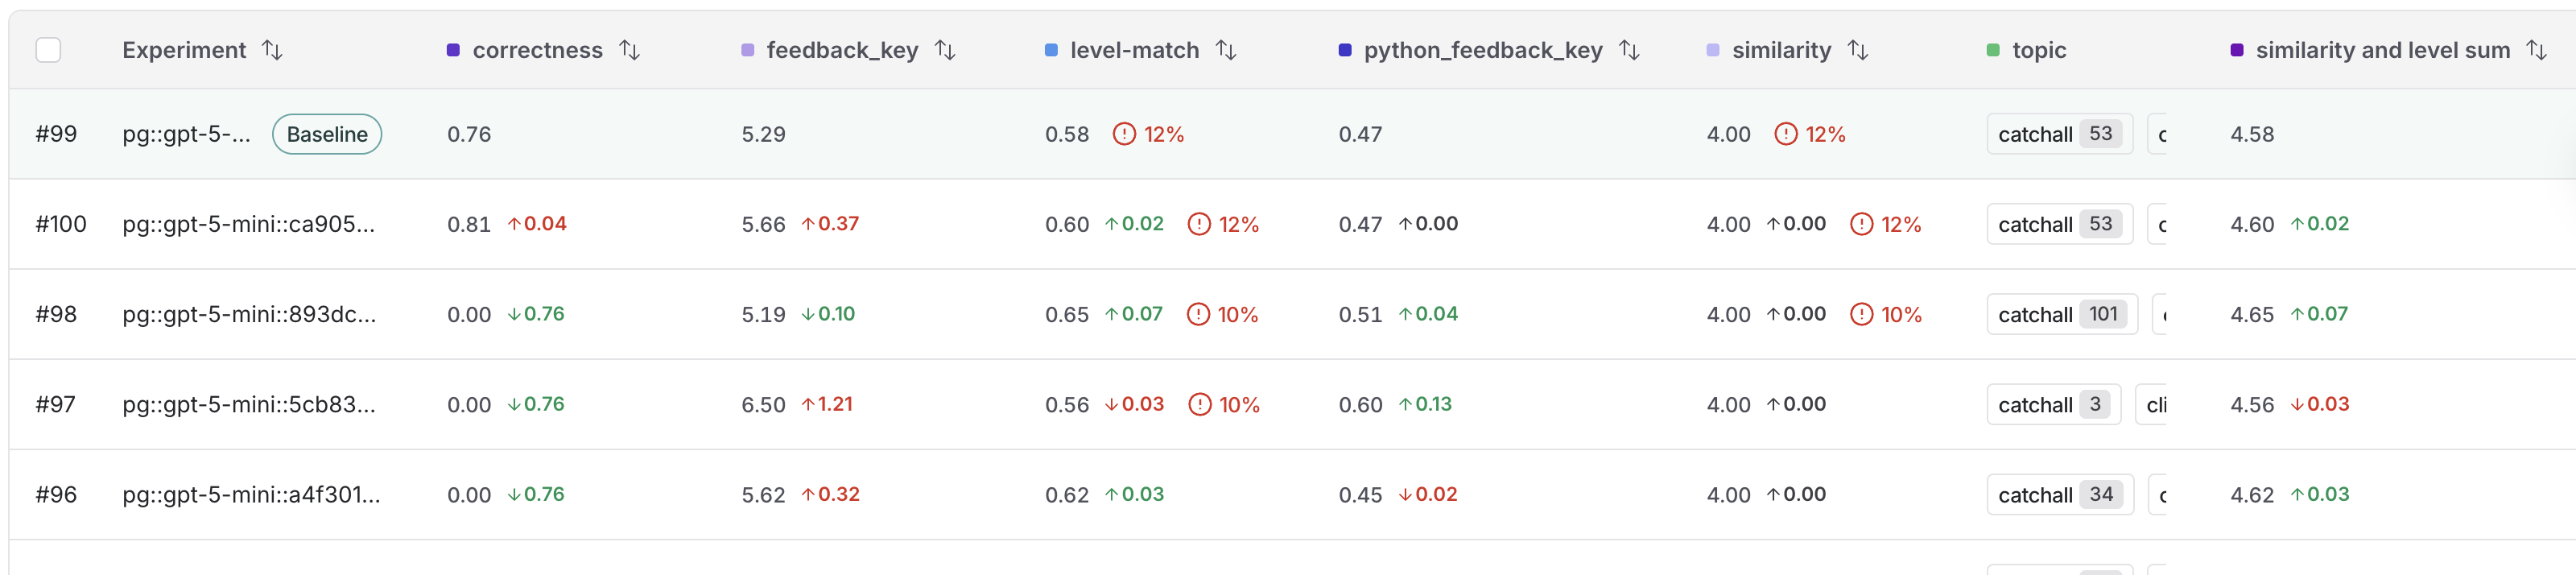
데이터셋에 대한 기준선을 설정하려면:
- LangSmith UI에서 왼쪽 메뉴의 Datasets & Experiments 옵션으로 이동합니다.
- 테이블에서 작업할 데이터셋을 선택합니다.
- Experiments 탭 뷰에서 실험 행 위에 마우스를 올리면 행 오른쪽 끝의 Set baseline 버튼이 나타납니다. 클릭해 기준선 실험을 선택합니다.
기준선 실험은 테이블 상단에 고정되고 이름 옆에 Baseline 태그가 표시됩니다. 실험이 기준선으로 설정되면 테이블은 각 열에 대해 각 실험의 점수를 기준선 대비로 표시합니다. 비교를 위해 여러 실험을 선택할 때 기준선 실험이 비교할 기본 소스 실험이 됩니다.
Experiments 탭 뷰에서 모델, 프롬프트, 도구로 필터링 및 그룹화
실험 테이블에는 각 실험에 사용된 모델, 프롬프트, 도구를 보여주는 Models, Prompts, Tools 열이 포함되어 있어, 한눈에 런 사이에서 무엇이 바뀌었는지 이해하기 쉽습니다.
이 열들은 Playground에서 실험을 실행할 때 자동으로 채워집니다. SDK를 통해 실험을 실행할 때는 models, prompts, tools 키가 있는 metadata 객체를 evaluate()에 전달하세요:
results = client.evaluate(
    target,
    data="my-dataset",
    evaluators=[...],
    metadata={
        "models": "openai:gpt-5.4-mini",
        "prompts": ["my-org/my-prompt:abc12345"],
        "tools": [{"name": "web_search", "description": "Search the web for information"}],
    },
)
메타데이터를 사용한 예시는 LLM 애플리케이션 평가 방법을 참고하세요.
이 열들은 데이터셋의 실험 중 하나 이상이 해당 필드를 설정한 경우에만 나타납니다. 채워지면 이 열의 값을 클릭해 실험을 필터링하거나 그룹화할 수 있습니다.
또한 Experiments 탭 뷰 왼쪽 상단에서 모델, 모델 제공자, 프롬프트, 프롬프트 커밋, 도구 및 기타 실험 메타데이터로 필터링하고 그룹화할 수 있습니다.
실험 결과를 CSV로 다운로드
LangSmith는 외부 분석과 공유를 위해 실험 결과를 CSV 파일로 다운로드할 수 있게 합니다. 실험 뷰 오른쪽 상단의 Download as CSV 아이콘을 클릭하세요.
참고: CSV 내보내기는 실험 뷰에서 적용한 열 커스터마이즈, 정렬, 필터링과 관계없이 항상 모든 열을 포함합니다. 열 표시 설정은 화면 표시에만 영향을 주며 다운로드된 파일에는 반영되지 않습니다.
참고: 실험 결과 다운로드에는 5,000행 제한이 있습니다.
실험 이름 변경
참고: 실험 이름은 워크스페이스마다 고유해야 합니다.
LangSmith UI에서 다음 위치에서 실험 이름을 변경할 수 있습니다:
-
실험 뷰: 실험 이름 옆의 연필 아이콘을 사용해 실험 이름을 변경합니다.
-
Playground:
pg::prompt-name::model::uuid형식(예:pg::gpt-5.4-mini::897ee630)의 기본 이름이 자동으로 할당됩니다. 실험을 실행한 직후 Playground 테이블 헤더에서 이름을 편집해 변경할 수 있습니다.
더 알아보기
- 실험 결과 비교는 Compare experiment results 문서를 참고하세요.
- 평가 방법 전반은 Evaluate an LLM application 문서를 확인해 보세요.