
챗봇 평가하기
챗봇 평가하기
이 가이드에서는 챗봇에 대한 평가를 설정할 거예요. 이를 통해 데이터 집합에서 애플리케이션이 얼마나 잘 작동하는지 측정할 수 있어요. 이 통찰력을 빠르고 안정적으로 얻을 수 있다면 자신 있게 반복할 수 있어요.
높은 수준에서 이 튜토리얼에서 다음을 할 거예요:
- 성능을 측정할 초기 골든 데이터셋 생성
- 성능 측정에 사용할 지표 정의
- 몇 가지 다른 프롬프트나 모델에 대해 평가 실행
- 결과 수동 비교
- 시간 경과에 따른 결과 추적
- CI/CD에서 실행될 자동화된 테스트 설정
LangSmith가 지원하는 평가 워크플로에 대한 자세한 내용은 how-to 가이드를 참조하거나, evaluate와 그 비동기 버전인 aevaluate에 대한 참조 문서를 확인해요.
다룰 내용이 많으니 시작해 볼게요!
출처: 문서
본문
설정
먼저 이 튜토리얼에 필요한 의존성을 설치해요. 여기서는 OpenAI를 사용하지만, LangSmith는 어떤 모델과도 사용할 수 있어요:
uv add langsmith openai
그리고 LangSmith 트레이싱을 활성화하도록 환경 변수를 설정해요:
export LANGSMITH_TRACING="true"
export LANGSMITH_API_KEY="<Your LangSmith API key>"
export OPENAI_API_KEY="<Your OpenAI API key>"
데이터셋 생성
애플리케이션을 테스트하고 평가할 준비를 할 때 첫 단계는 평가할 데이터 포인트를 정의하는 것이에요. 여기서 고려할 몇 가지 측면이 있어요:
- 각 데이터 포인트의 스키마는 무엇이어야 하는가?
- 데이터 포인트를 몇 개나 모아야 하는가?
- 데이터 포인트를 어떻게 모아야 하는가?
스키마: 각 데이터 포인트는 최소한 애플리케이션에 대한 입력으로 구성되어야 해요. 가능하다면 기대 출력을 정의하는 것도 매우 유용한데, 이는 제대로 작동하는 애플리케이션이 출력해야 한다고 기대하는 것을 나타내요. 완벽한 출력을 정의할 수 없는 경우도 종종 있는데, 괜찮아요! 평가는 반복적인 과정이에요. 각 예제에 대해 더 많은 정보(예: RAG에서 가져와야 할 기대 문서, 또는 에이전트가 취해야 할 기대 단계)를 정의하고 싶을 수도 있어요. LangSmith 데이터셋은 매우 유연하며 임의의 스키마 정의를 허용해요.
몇 개: 얼마나 모아야 하는지에 대한 정해진 규칙은 없어요. 핵심은 방어하고 싶은 엣지 케이스에 대한 적절한 범위를 확보하는 것이에요. 10-50개의 예제만으로도 많은 가치를 얻을 수 있어요! 처음에 많은 수를 확보하는 것에 대해 걱정하지 마세요 — 언제든지(그리고 해야 하듯이) 시간이 지나면서 추가할 수 있어요!
어떻게 얻을지: 이것이 아마 가장 까다로운 부분이에요. 데이터셋을 모으고 싶다는 것을 알게 되면... 실제로 어떻게 시작할까요? 새 프로젝트를 시작하는 대부분의 팀은 처음 10-20개의 데이터 포인트를 수동으로 수집하는 것으로 시작하는 것을 봤어요. 이러한 데이터 포인트로 시작한 후, 데이터셋은 일반적으로 살아있는 구조물이 되어 시간이 지나면서 성장해요. 실제 사용자가 애플리케이션을 어떻게 사용하는지 보고, 존재하는 문제점을 확인한 다음, 그 데이터 포인트 중 일부를 이 집합으로 옮기는 방식으로 성장해요. 데이터셋을 보강하는 데 사용할 수 있는 합성 데이터 생성 같은 방법도 있어요. 처음에는 그것들을 고민하지 말고 손으로 ~10-20개의 예제를 라벨링할 것을 권장해요.
데이터셋을 확보한 후에는 LangSmith에 업로드하는 몇 가지 방법이 있어요. 이 튜토리얼에서는 클라이언트를 사용하지만, UI를 통해 업로드하거나 UI에서 만들 수도 있어요.
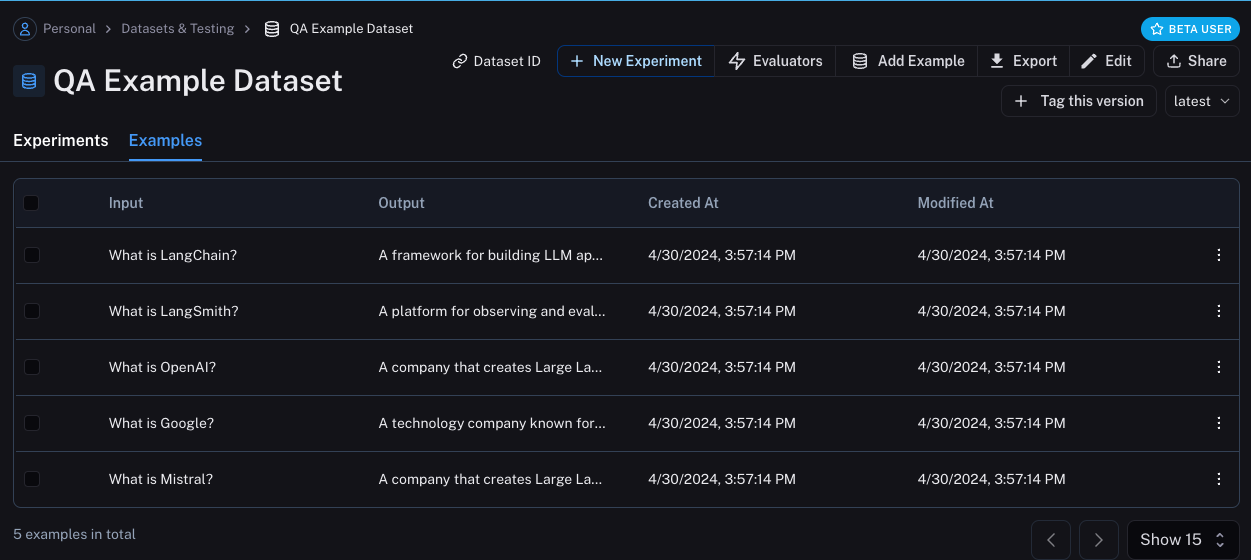
이 튜토리얼에서는 평가할 5개의 데이터 포인트를 만들 거예요. 질문-답변 애플리케이션을 평가할 것이며, 입력은 질문, 출력은 답변이 될 거예요. 질문-답변 애플리케이션이므로 기대 답변을 정의할 수 있어요. 이 데이터셋을 만들어 LangSmith에 업로드하는 방법을 보여줄게요!
from langsmith import Client

client = Client()

# Define dataset: these are your test cases
dataset_name = "QA Example Dataset"
dataset = client.create_dataset(dataset_name)

client.create_examples(
    dataset_id=dataset.id,
    examples=[
        {
            "inputs": {"question": "What is LangChain?"},
            "outputs": {"answer": "A framework for building LLM applications"},
        },
        {
            "inputs": {"question": "What is LangSmith?"},
            "outputs": {"answer": "A platform for observing and evaluating LLM applications"},
        },
        {
            "inputs": {"question": "What is OpenAI?"},
            "outputs": {"answer": "A company that creates Large Language Models"},
        },
        {
            "inputs": {"question": "What is Google?"},
            "outputs": {"answer": "A technology company known for search"},
        },
        {
            "inputs": {"question": "What is Mistral?"},
            "outputs": {"answer": "A company that creates Large Language Models"},
        }
    ]
)
이제 LangSmith UI로 가서 Datasets & Testing 페이지에서 QA Example Dataset을 찾으면, 클릭했을 때 5개의 새 예제가 보일 거예요.
지표 정의
데이터셋을 만든 후에는 응답을 평가할 몇 가지 지표를 정의할 수 있어요. 기대 답변이 있으므로 평가의 일부로 그것과 비교할 수 있어요. 하지만 우리 애플리케이션이 그 정확한 답변을 출력하길 기대하지는 않고, 비슷한 무언가를 출력하길 기대해요. 이로 인해 평가가 조금 더 까다로워져요.
정확성을 평가하는 것 외에도 답변이 짧고 간결한지도 확인해 볼게요. 이것은 조금 더 쉬워요 — 응답 길이를 측정하는 간단한 Python 함수를 정의할 수 있어요.
이 두 가지 지표를 정의해 보겠어요.
첫 번째는 LLM을 사용해 출력이 (기대 출력에 비해) 올바른지 판단할 거예요. 이러한 LLM-as-a-judge는 단순 함수로 측정하기엔 너무 복잡한 경우에 비교적 흔해요. 여기서 평가에 사용할 자체 프롬프트와 LLM을 정의할 수 있어요:
import openai
from langsmith import wrappers

openai_client = wrappers.wrap_openai(openai.OpenAI())

eval_instructions = "You are an expert professor specialized in grading students' answers to questions."

def correctness(inputs: dict, outputs: dict, reference_outputs: dict) -> bool:
    user_content = f"""You are grading the following question:
{inputs['question']}
Here is the real answer:
{reference_outputs['answer']}
You are grading the following predicted answer:
{outputs['response']}
Respond with CORRECT or INCORRECT:
Grade:"""
    response = openai_client.chat.completions.create(
        model="gpt-5.4-mini",
        temperature=0,
        messages=[
            {"role": "system", "content": eval_instructions},
            {"role": "user", "content": user_content},
        ],
    ).choices[0].message.content
    return response == "CORRECT"
응답 길이를 평가하는 것은 훨씬 쉬워요! 실제 출력이 기대 결과 길이의 2배 미만인지 확인하는 간단한 함수를 정의하면 돼요.
def concision(outputs: dict, reference_outputs: dict) -> bool:
    return int(len(outputs["response"]) < 2 * len(reference_outputs["answer"]))
평가 실행
좋아요! 이제 평가를 어떻게 실행할까요? 데이터셋과 평가기가 있으니 남은 것은 애플리케이션뿐이에요! 응답 방법에 대한 지침이 담긴 시스템 메시지만 있고 그것을 LLM에 전달하는 간단한 애플리케이션을 만들 거예요. OpenAI SDK를 직접 사용해 만들겠어요:
default_instructions = "Respond to the users question in a short, concise manner (one short sentence)."

def my_app(question: str, model: str = "gpt-5.4-mini", instructions: str = default_instructions) -> str:
    return openai_client.chat.completions.create(
        model=model,
        temperature=0,
        messages=[
            {"role": "system", "content": instructions},
            {"role": "user", "content": question},
        ],
    ).choices[0].message.content
이것을 LangSmith 평가를 통해 실행하기 전에, 데이터셋의 입력 키를 호출하려는 함수에 매핑하고 함수의 출력을 기대하는 출력 키에 매핑하는 간단한 래퍼를 정의해야 해요.
def ls_target(inputs: str) -> dict:
    return {"response": my_app(inputs["question"])}
좋아요! 이제 평가를 실행할 준비가 됐어요. 해 봅시다!
experiment_results = client.evaluate(
    ls_target, # Your AI system
    data=dataset_name, # The data to predict and grade over
    evaluators=[concision, correctness], # The evaluators to score the results
    experiment_prefix="openai-4o-mini", # A prefix for your experiment names to easily identify them
)
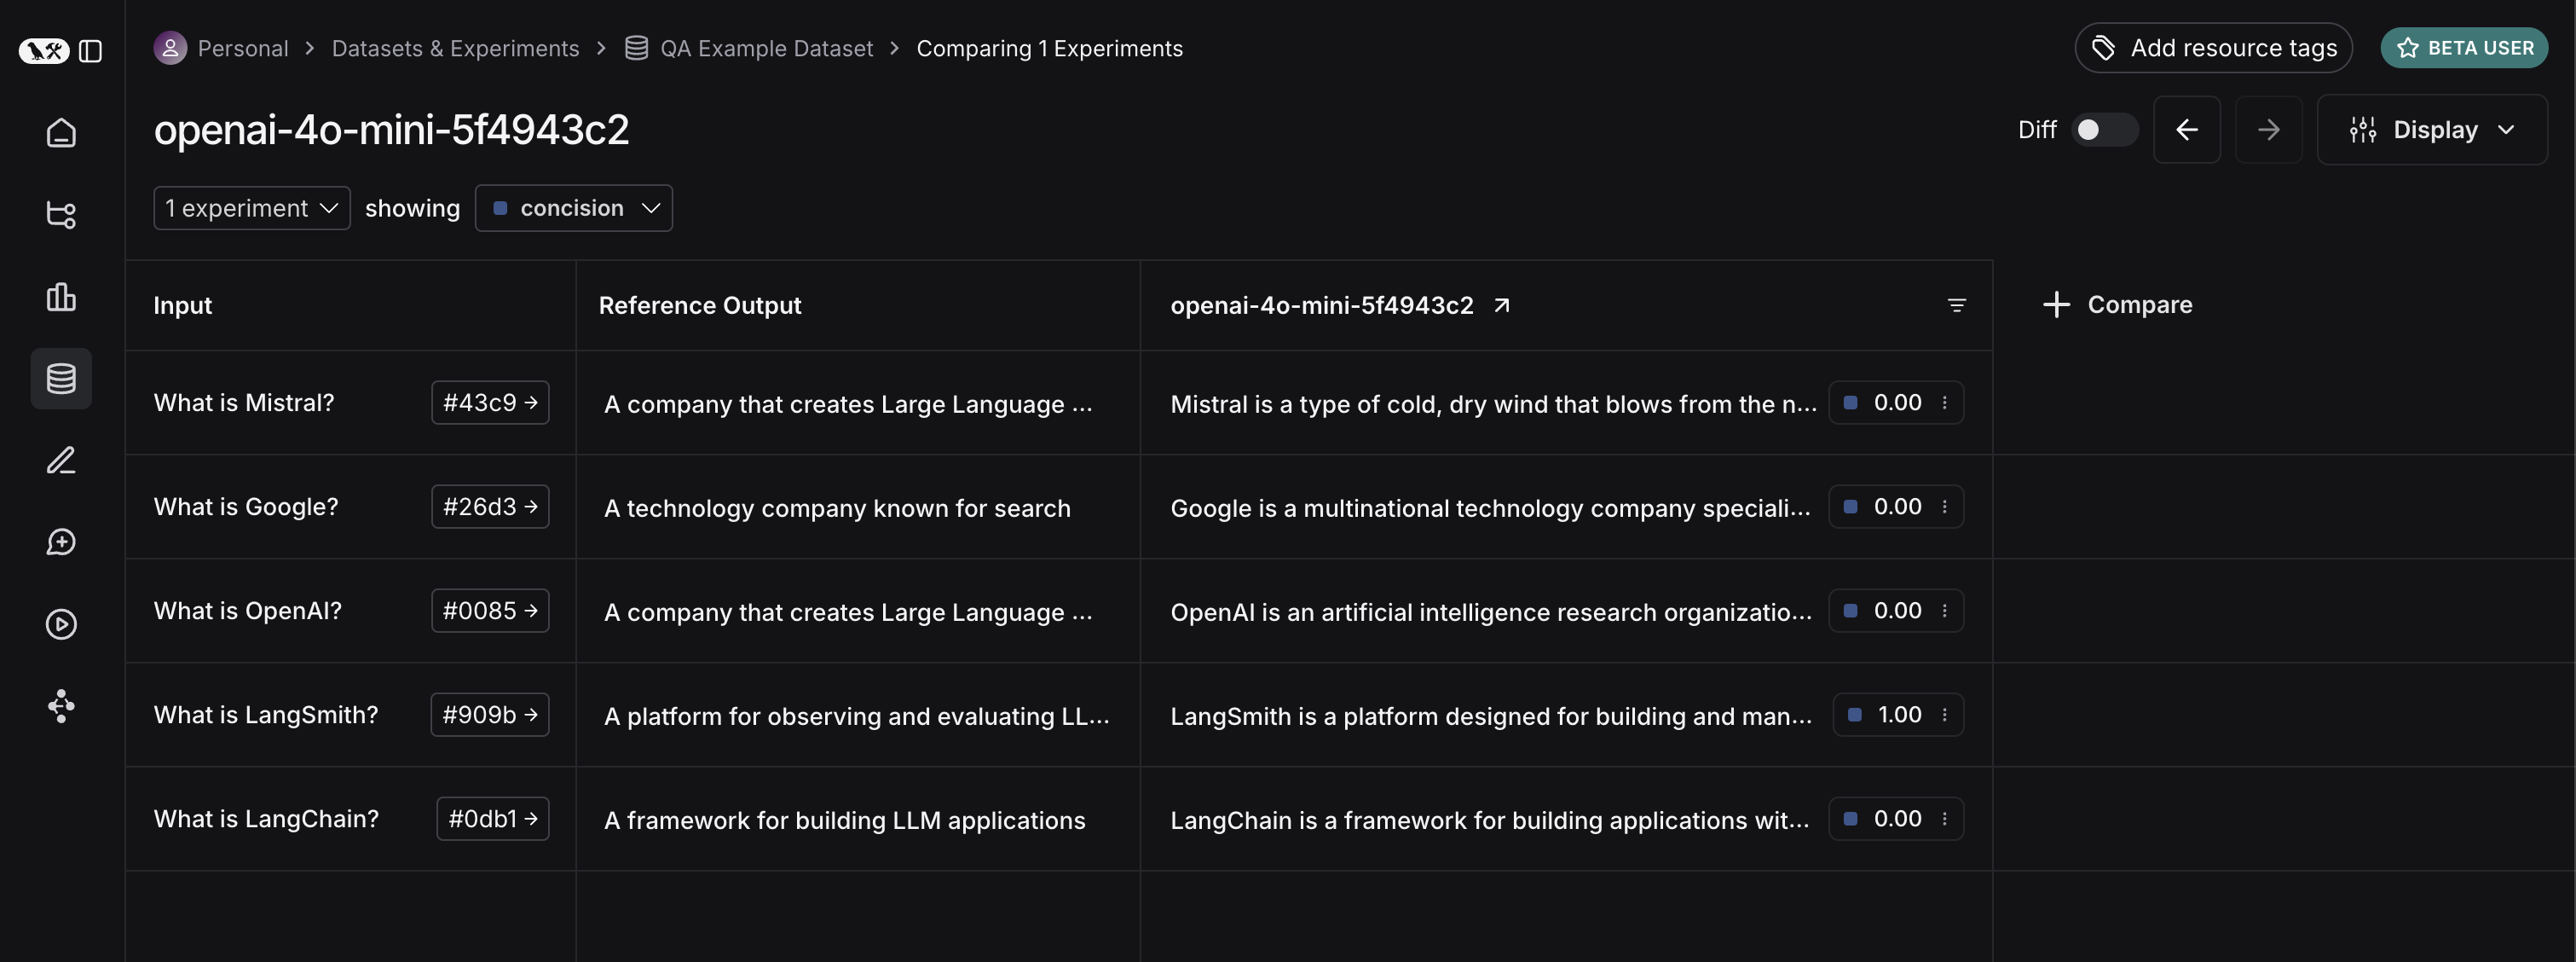
그러면 URL이 출력돼요. 클릭하면 우리 평가 결과를 볼 수 있어요!
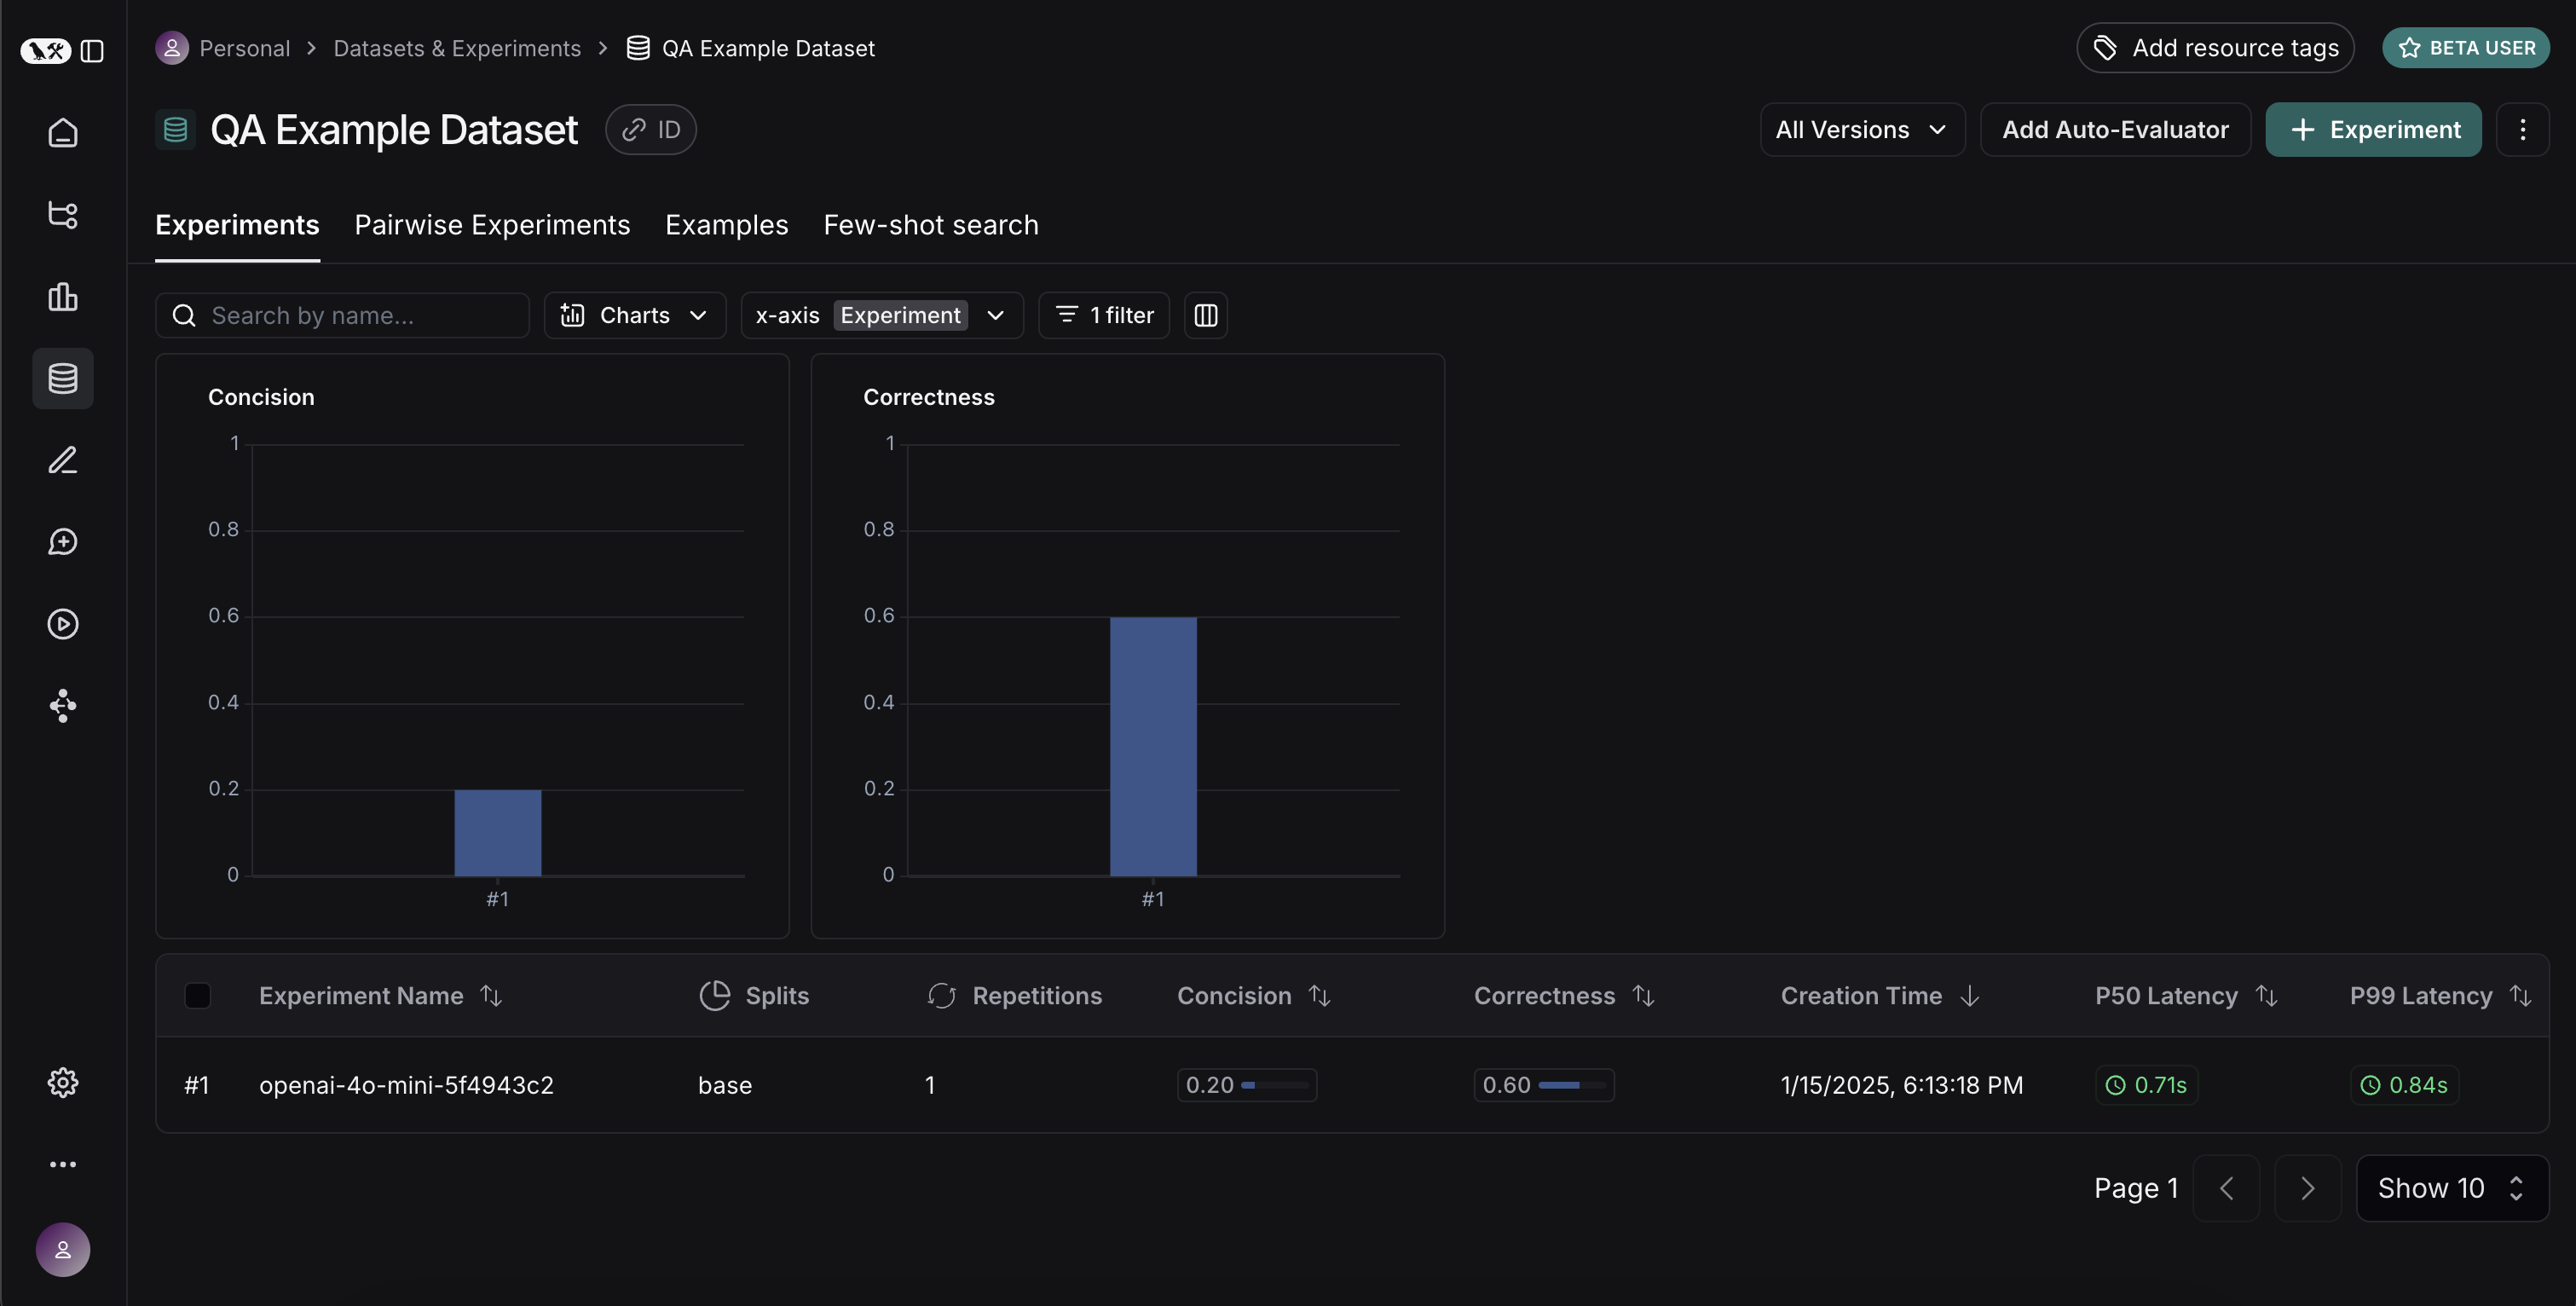
데이터셋 페이지로 돌아가 Experiments 탭을 선택하면, 우리의 한 번 실행에 대한 요약을 볼 수 있어요!
이제 다른 모델로 시도해 볼게요! gpt-4-turbo를 써 볼게요.
def ls_target_v2(inputs: str) -> dict:
    return {"response": my_app(inputs["question"], model="gpt-4-turbo")}

experiment_results = client.evaluate(
    ls_target_v2,
    data=dataset_name,
    evaluators=[concision, correctness],
    experiment_prefix="openai-4-turbo",
)
이제 GPT-4를 사용하면서 답변이 짧아야 한다는 요구사항을 좀 더 엄격하게 하도록 프롬프트도 업데이트해 볼게요.
instructions_v3 = "Respond to the users question in a short, concise manner (one short sentence). Do NOT use more than ten words."

def ls_target_v3(inputs: str) -> dict:
    response = my_app(
        inputs["question"],
        model="gpt-4-turbo",
        instructions=instructions_v3
    )
    return {"response": response}

experiment_results = client.evaluate(
    ls_target_v3,
    data=dataset_name,
    evaluators=[concision, correctness],
    experiment_prefix="strict-openai-4-turbo",
)
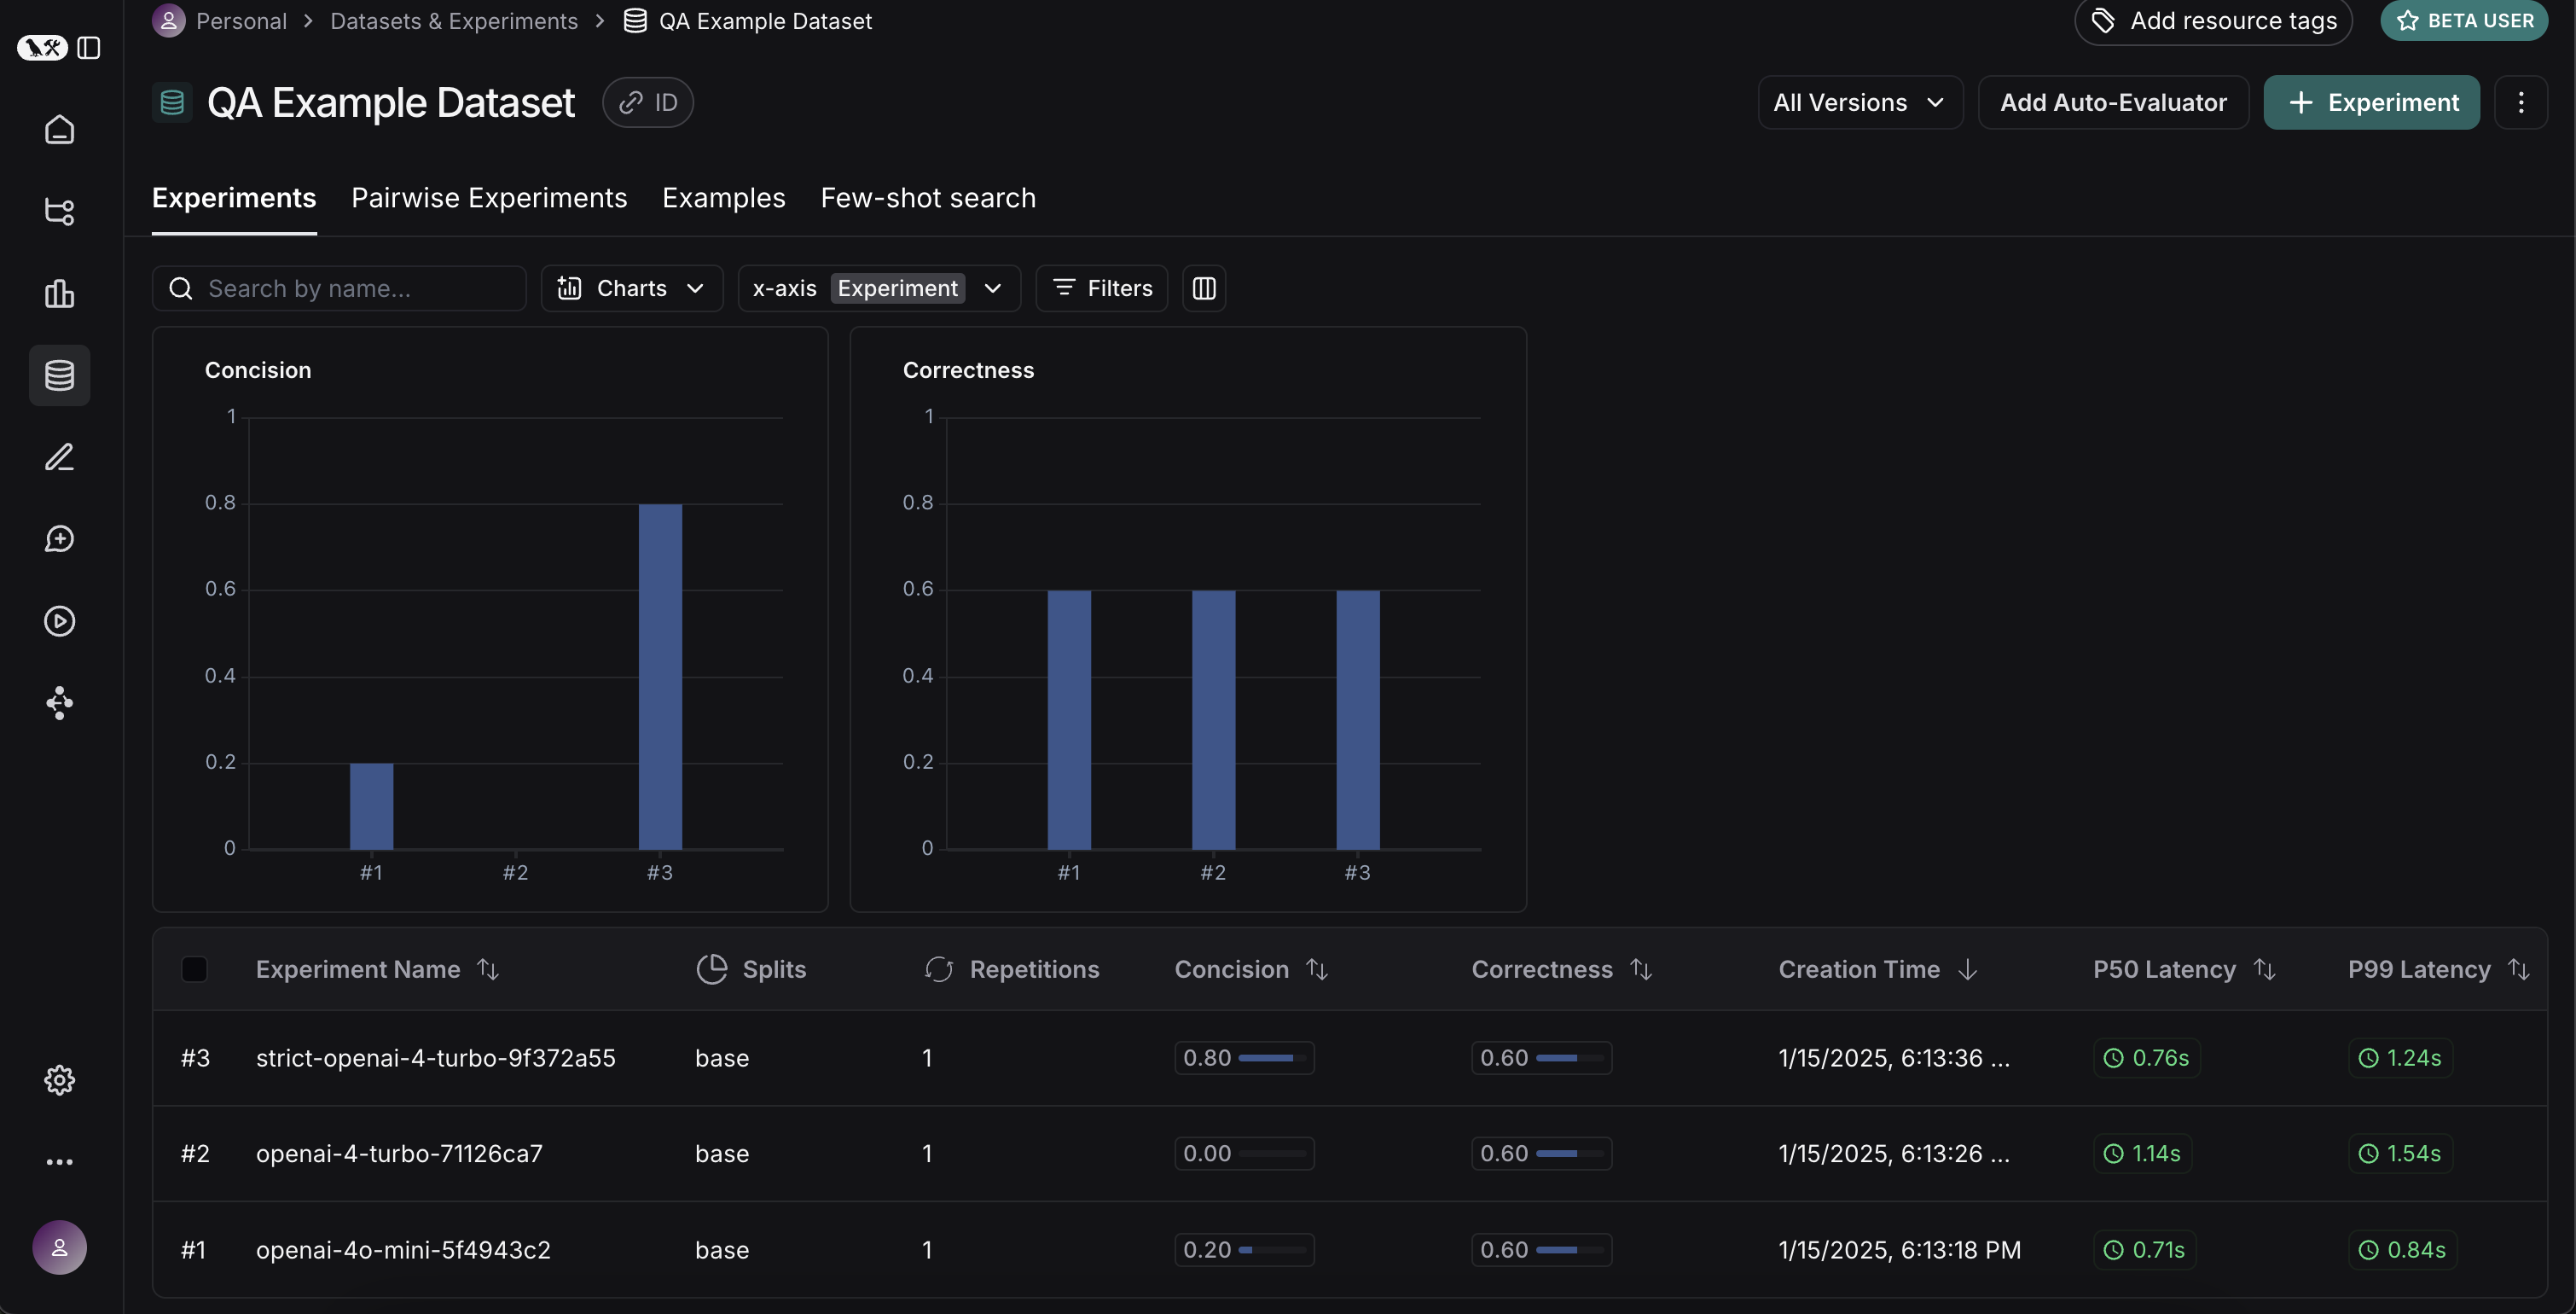
데이터셋 페이지의 Experiments 탭으로 돌아가면 세 번의 실행이 모두 표시되는 것을 볼 수 있어요!
결과 비교
좋아요, 우리는 세 번의 다른 실행을 평가했어요. 하지만 결과를 어떻게 비교할까요? 첫 번째 방법은 Experiments 탭에서 실행들을 보는 것이에요. 그러면 각 실행의 지표를 높은 수준에서 볼 수 있어요:
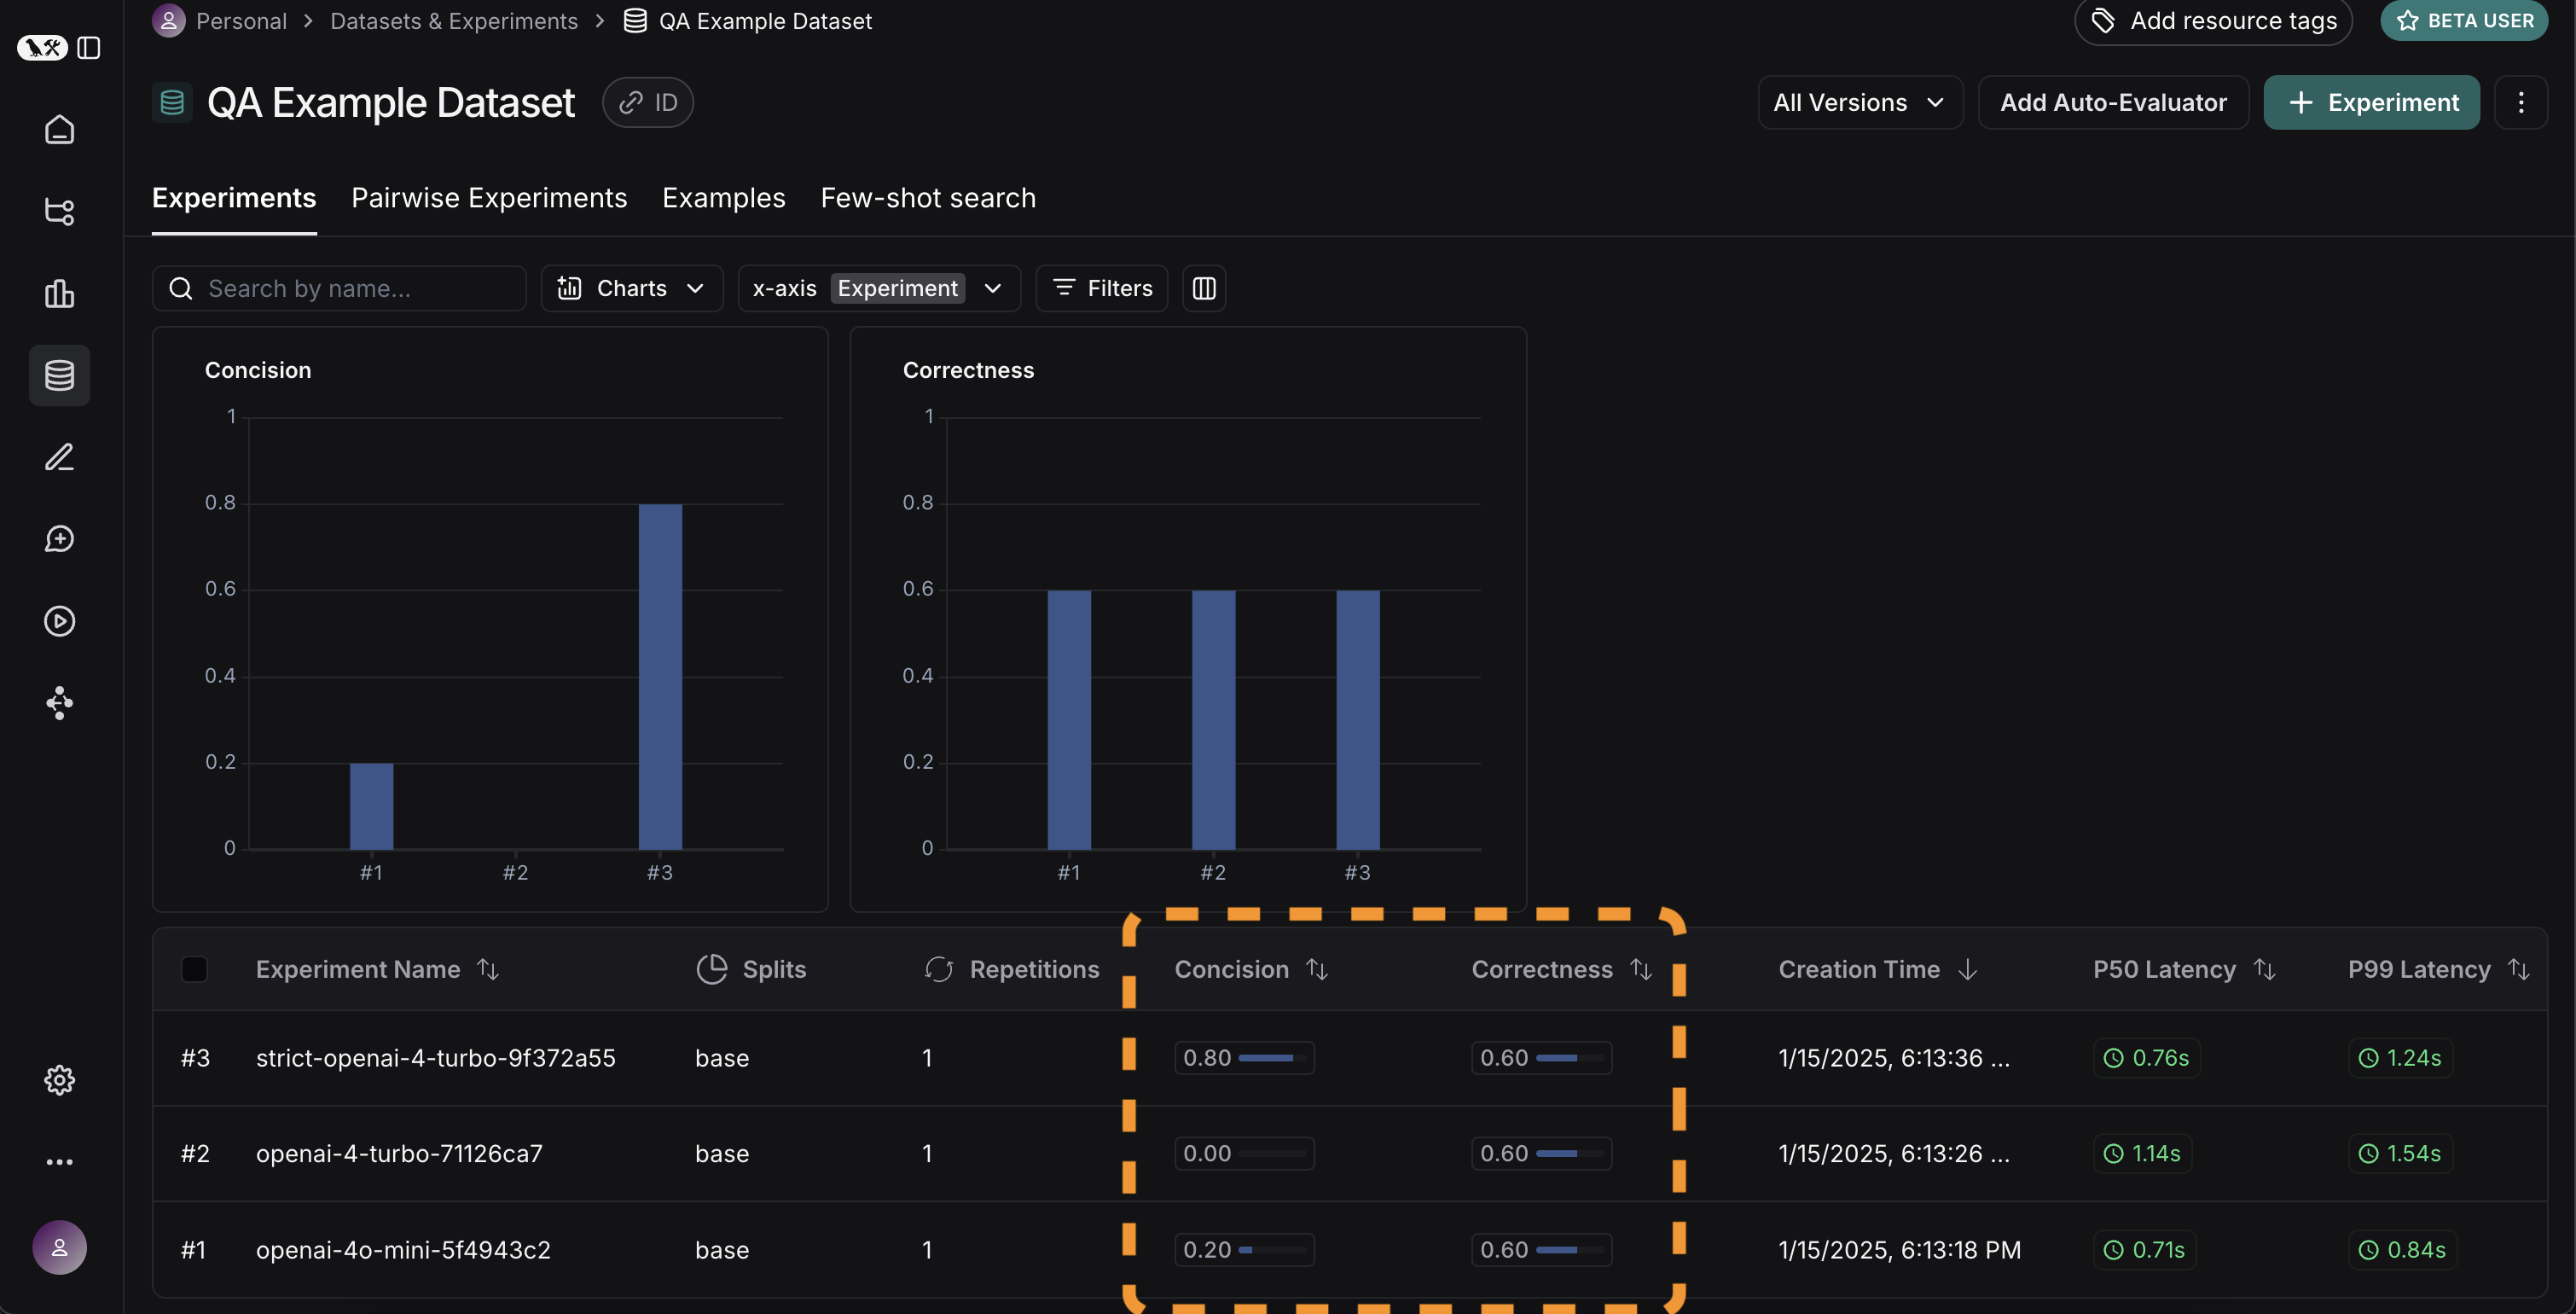
GPT-4가 GPT-3.5보다 회사가 무엇인지 아는 데 더 낫고, 엄격한 프롬프트가 길이를 줄이는 데 크게 도움이 됐다는 것을 알 수 있어요. 하지만 더 자세히 탐색하고 싶다면 어떨까요?
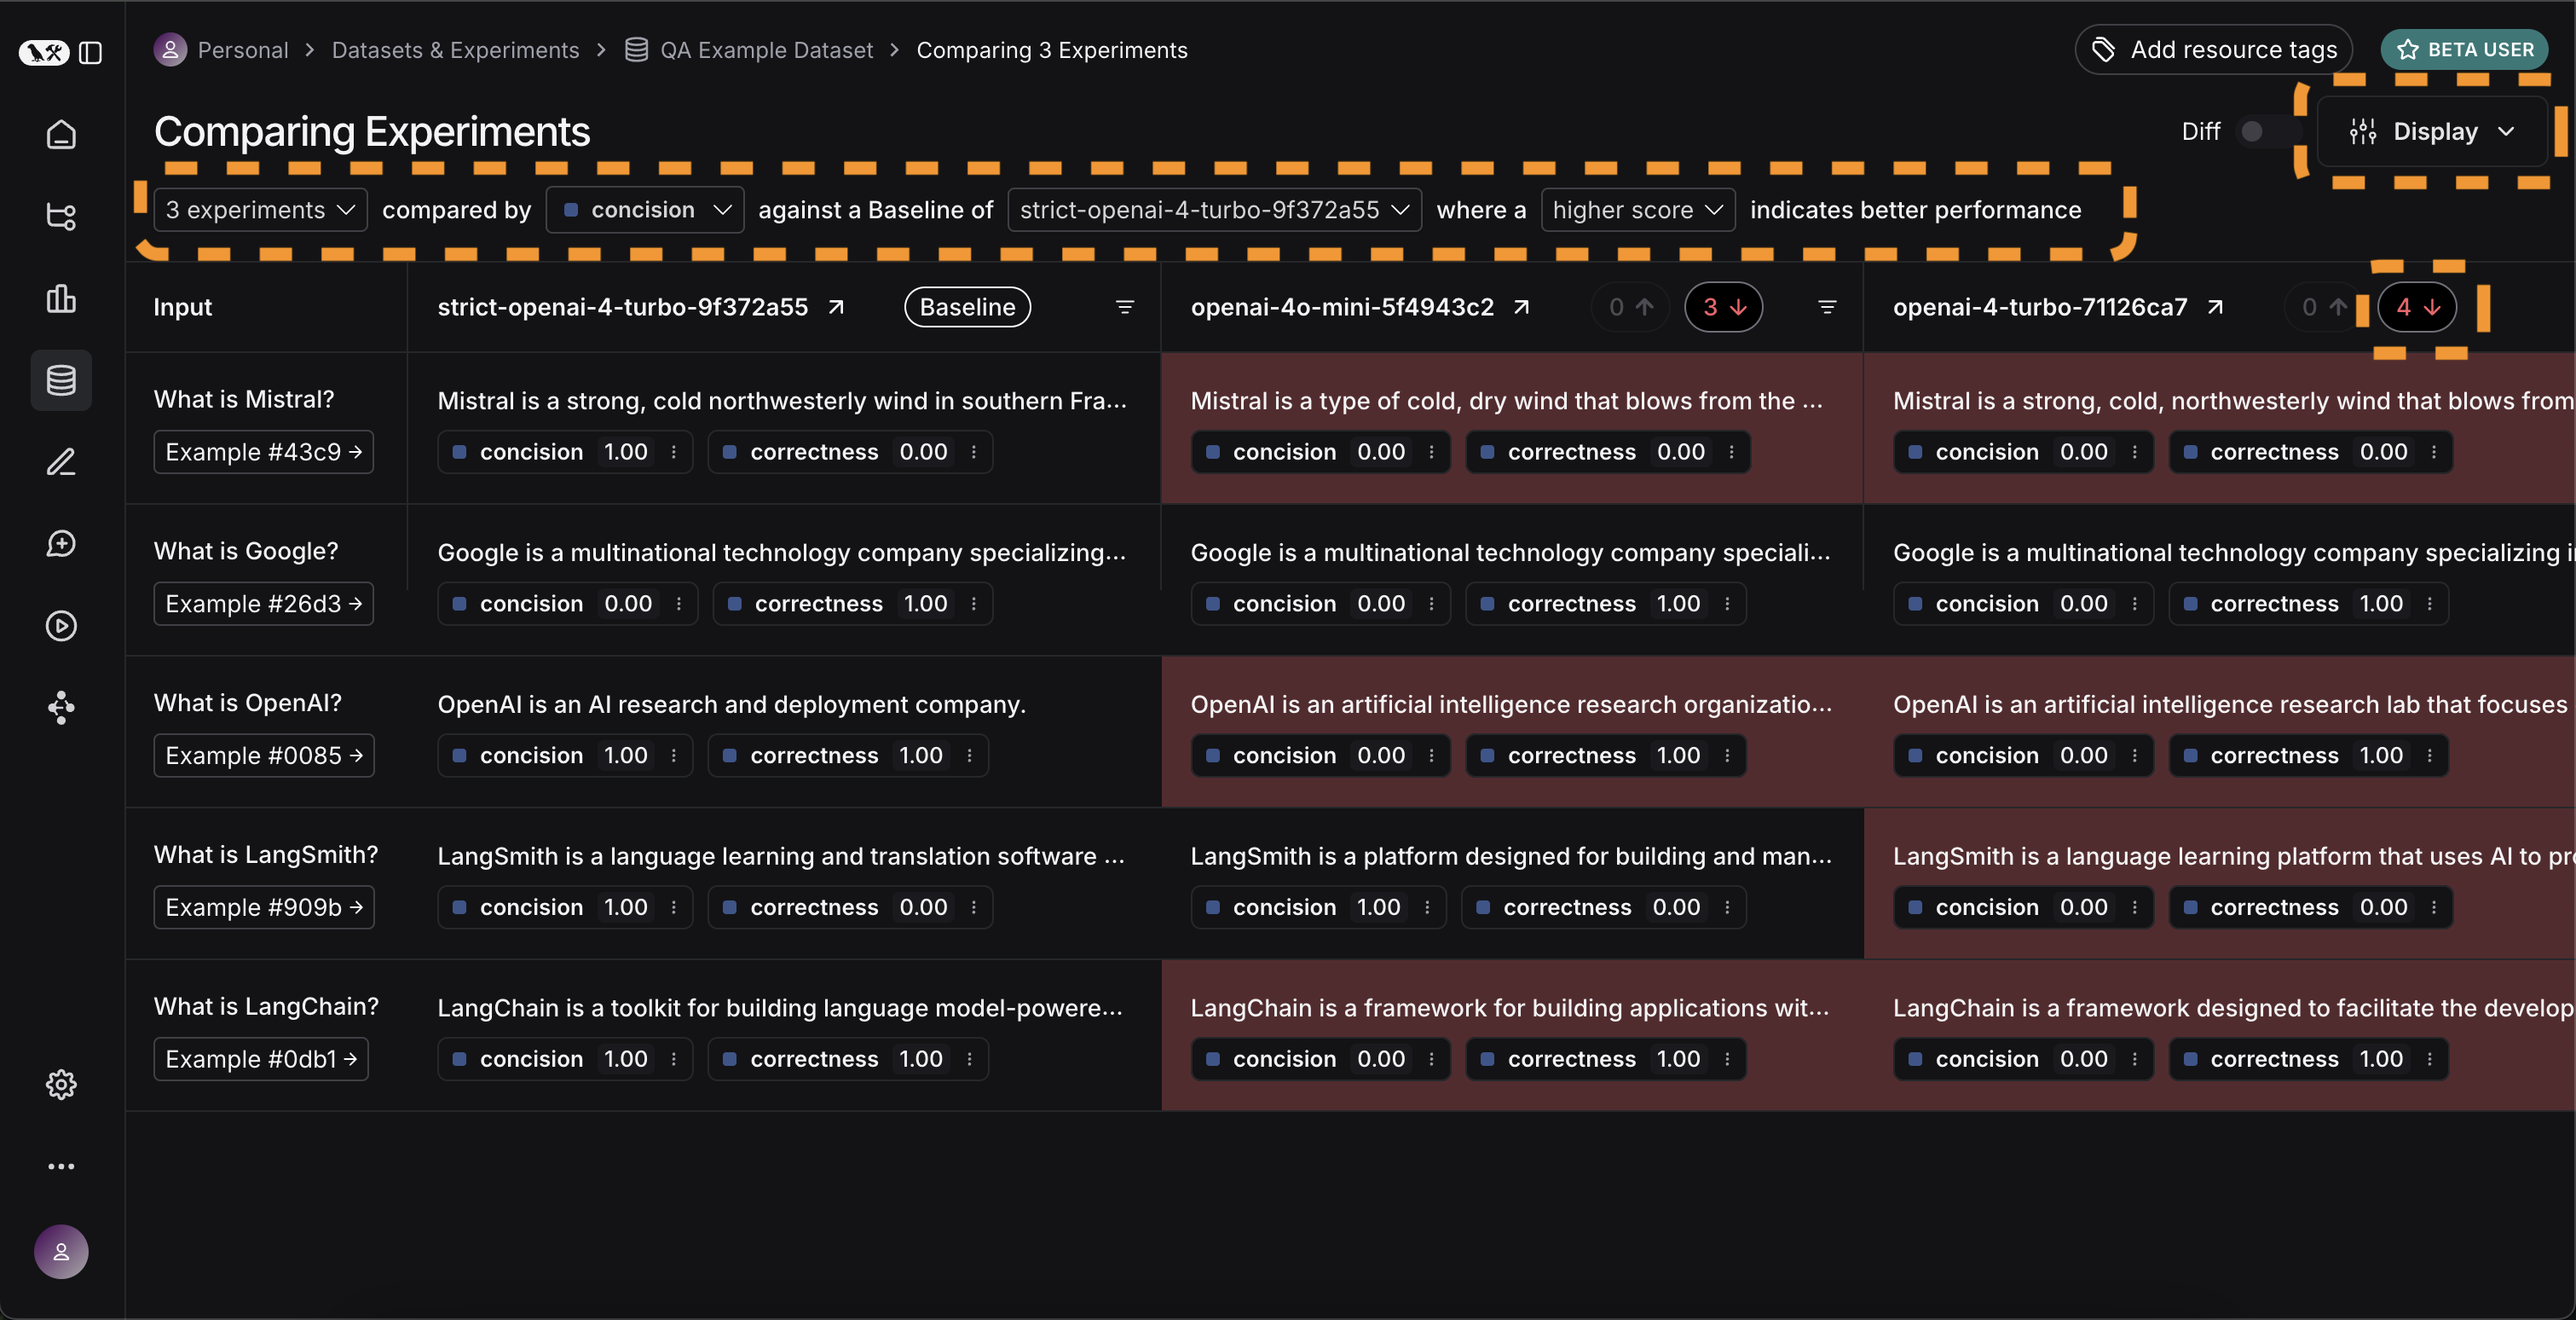
그렇게 하려면 비교하려는 모든 실행(이 경우 세 개 모두)을 선택하고 비교 보기에서 열 수 있어요. 세 테스트가 나란히 즉시 보여요. 일부 셀에는 색상이 칠해져 있는데, 이는 특정 기준에 비해 특정 지표의 회귀를 보여주는 것이에요. 기준과 지표에 대한 기본값을 자동으로 선택하지만, 직접 변경할 수 있어요. Display 컨트롤을 사용해 볼 열과 지표를 선택할 수도 있어요. 또한 상단의 아이콘을 클릭해 개선/회귀가 있는 실행만 보도록 자동으로 필터링할 수 있어요.
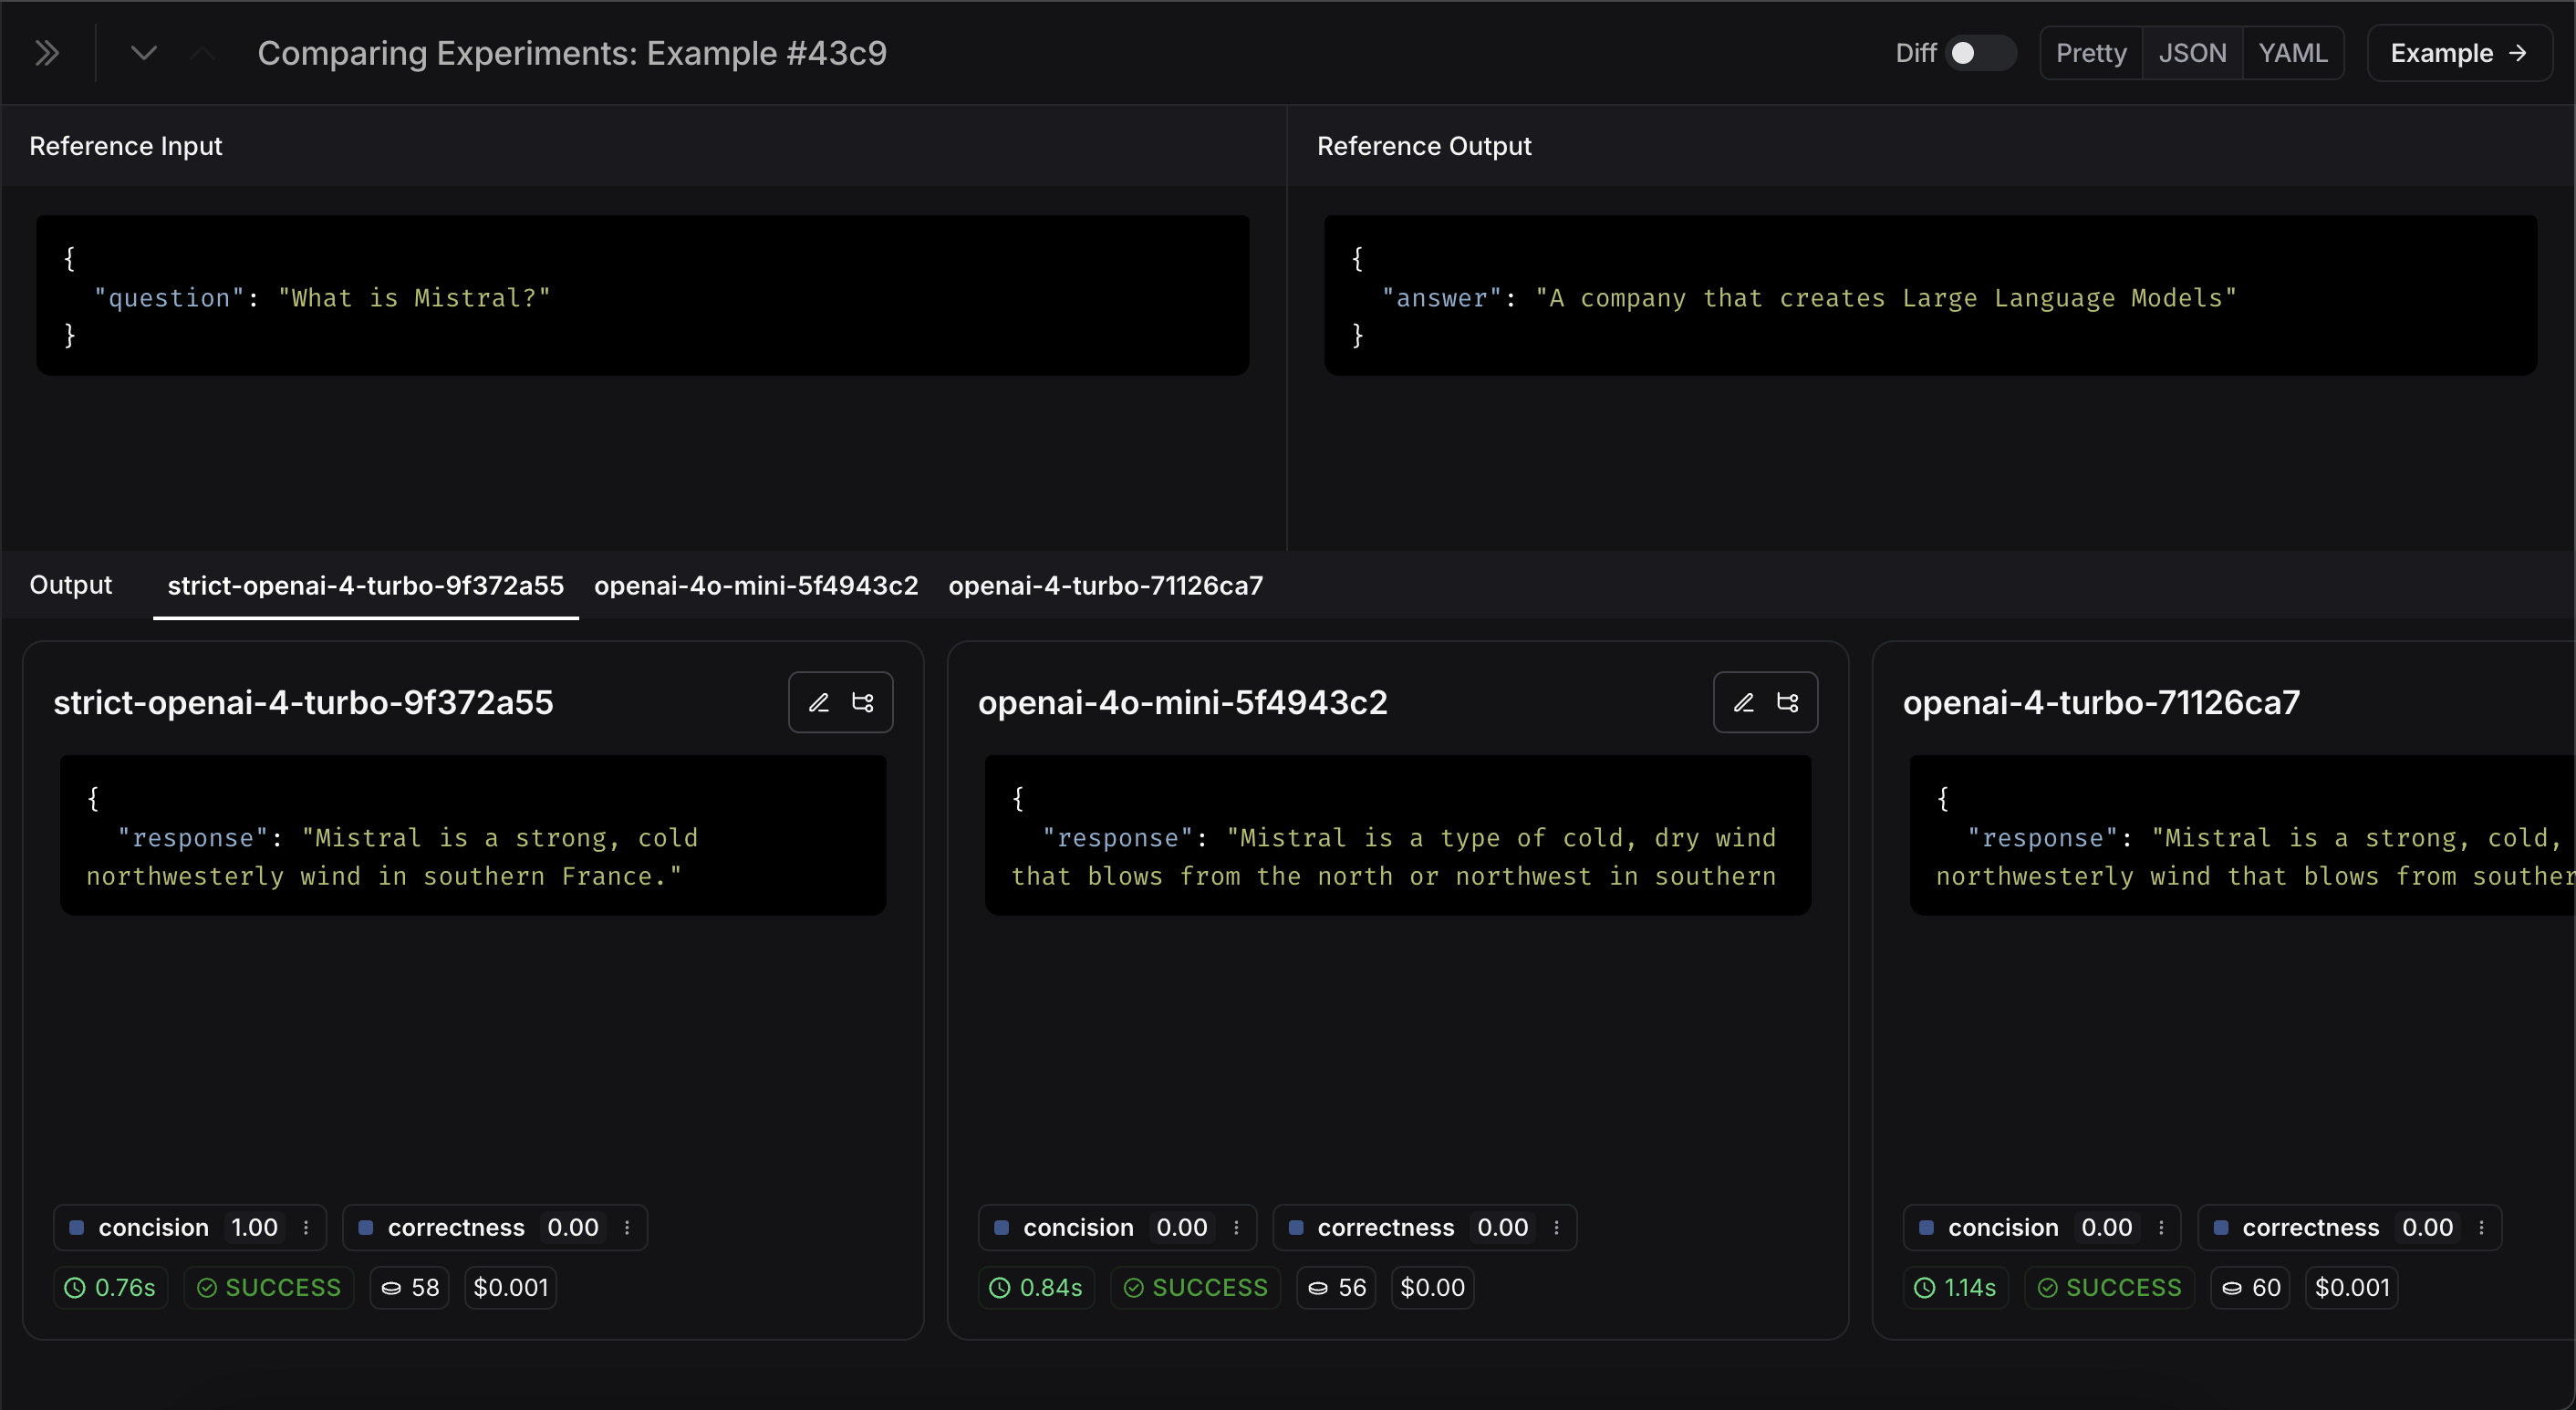
더 많은 정보를 보려면, 행 위에 마우스를 올리면 나타나는 Expand 버튼을 선택해 더 상세한 정보가 있는 사이드 패널을 열 수도 있어요:
CI/CD에서 실행되는 자동화 테스트 설정
한 번 실행하는 방식으로 실행했으니, 자동화된 방식으로 실행되도록 설정할 수 있어요. pytest 파일로 포함해 CI/CD에서 실행하기만 하면 비교적 쉽게 할 수 있어요. 그 일부로 결과를 기록하거나 통과 여부를 결정할 기준을 설정할 수 있어요. 예를 들어 생성된 응답의 80% 이상이 항상 length 검사를 통과하도록 보장하려면 다음과 같은 테스트로 설정할 수 있어요:
def test_length_score() -> None:
    """Test that the length score is at least 80%."""
    experiment_results = evaluate(
        ls_target, # Your AI system
        data=dataset_name, # The data to predict and grade over
        evaluators=[concision, correctness], # The evaluators to score the results
    )
    # This will be cleaned up in the next release:
    feedback = client.list_feedback(
        run_ids=[r.id for r in client.list_runs(project_name=experiment_results.experiment_name)],
        feedback_key="concision"
    )
    scores = [f.score for f in feedback]
    assert sum(scores) / len(scores) >= 0.8, "Aggregate score should be at least .8"
시간 경과에 따른 결과 추적
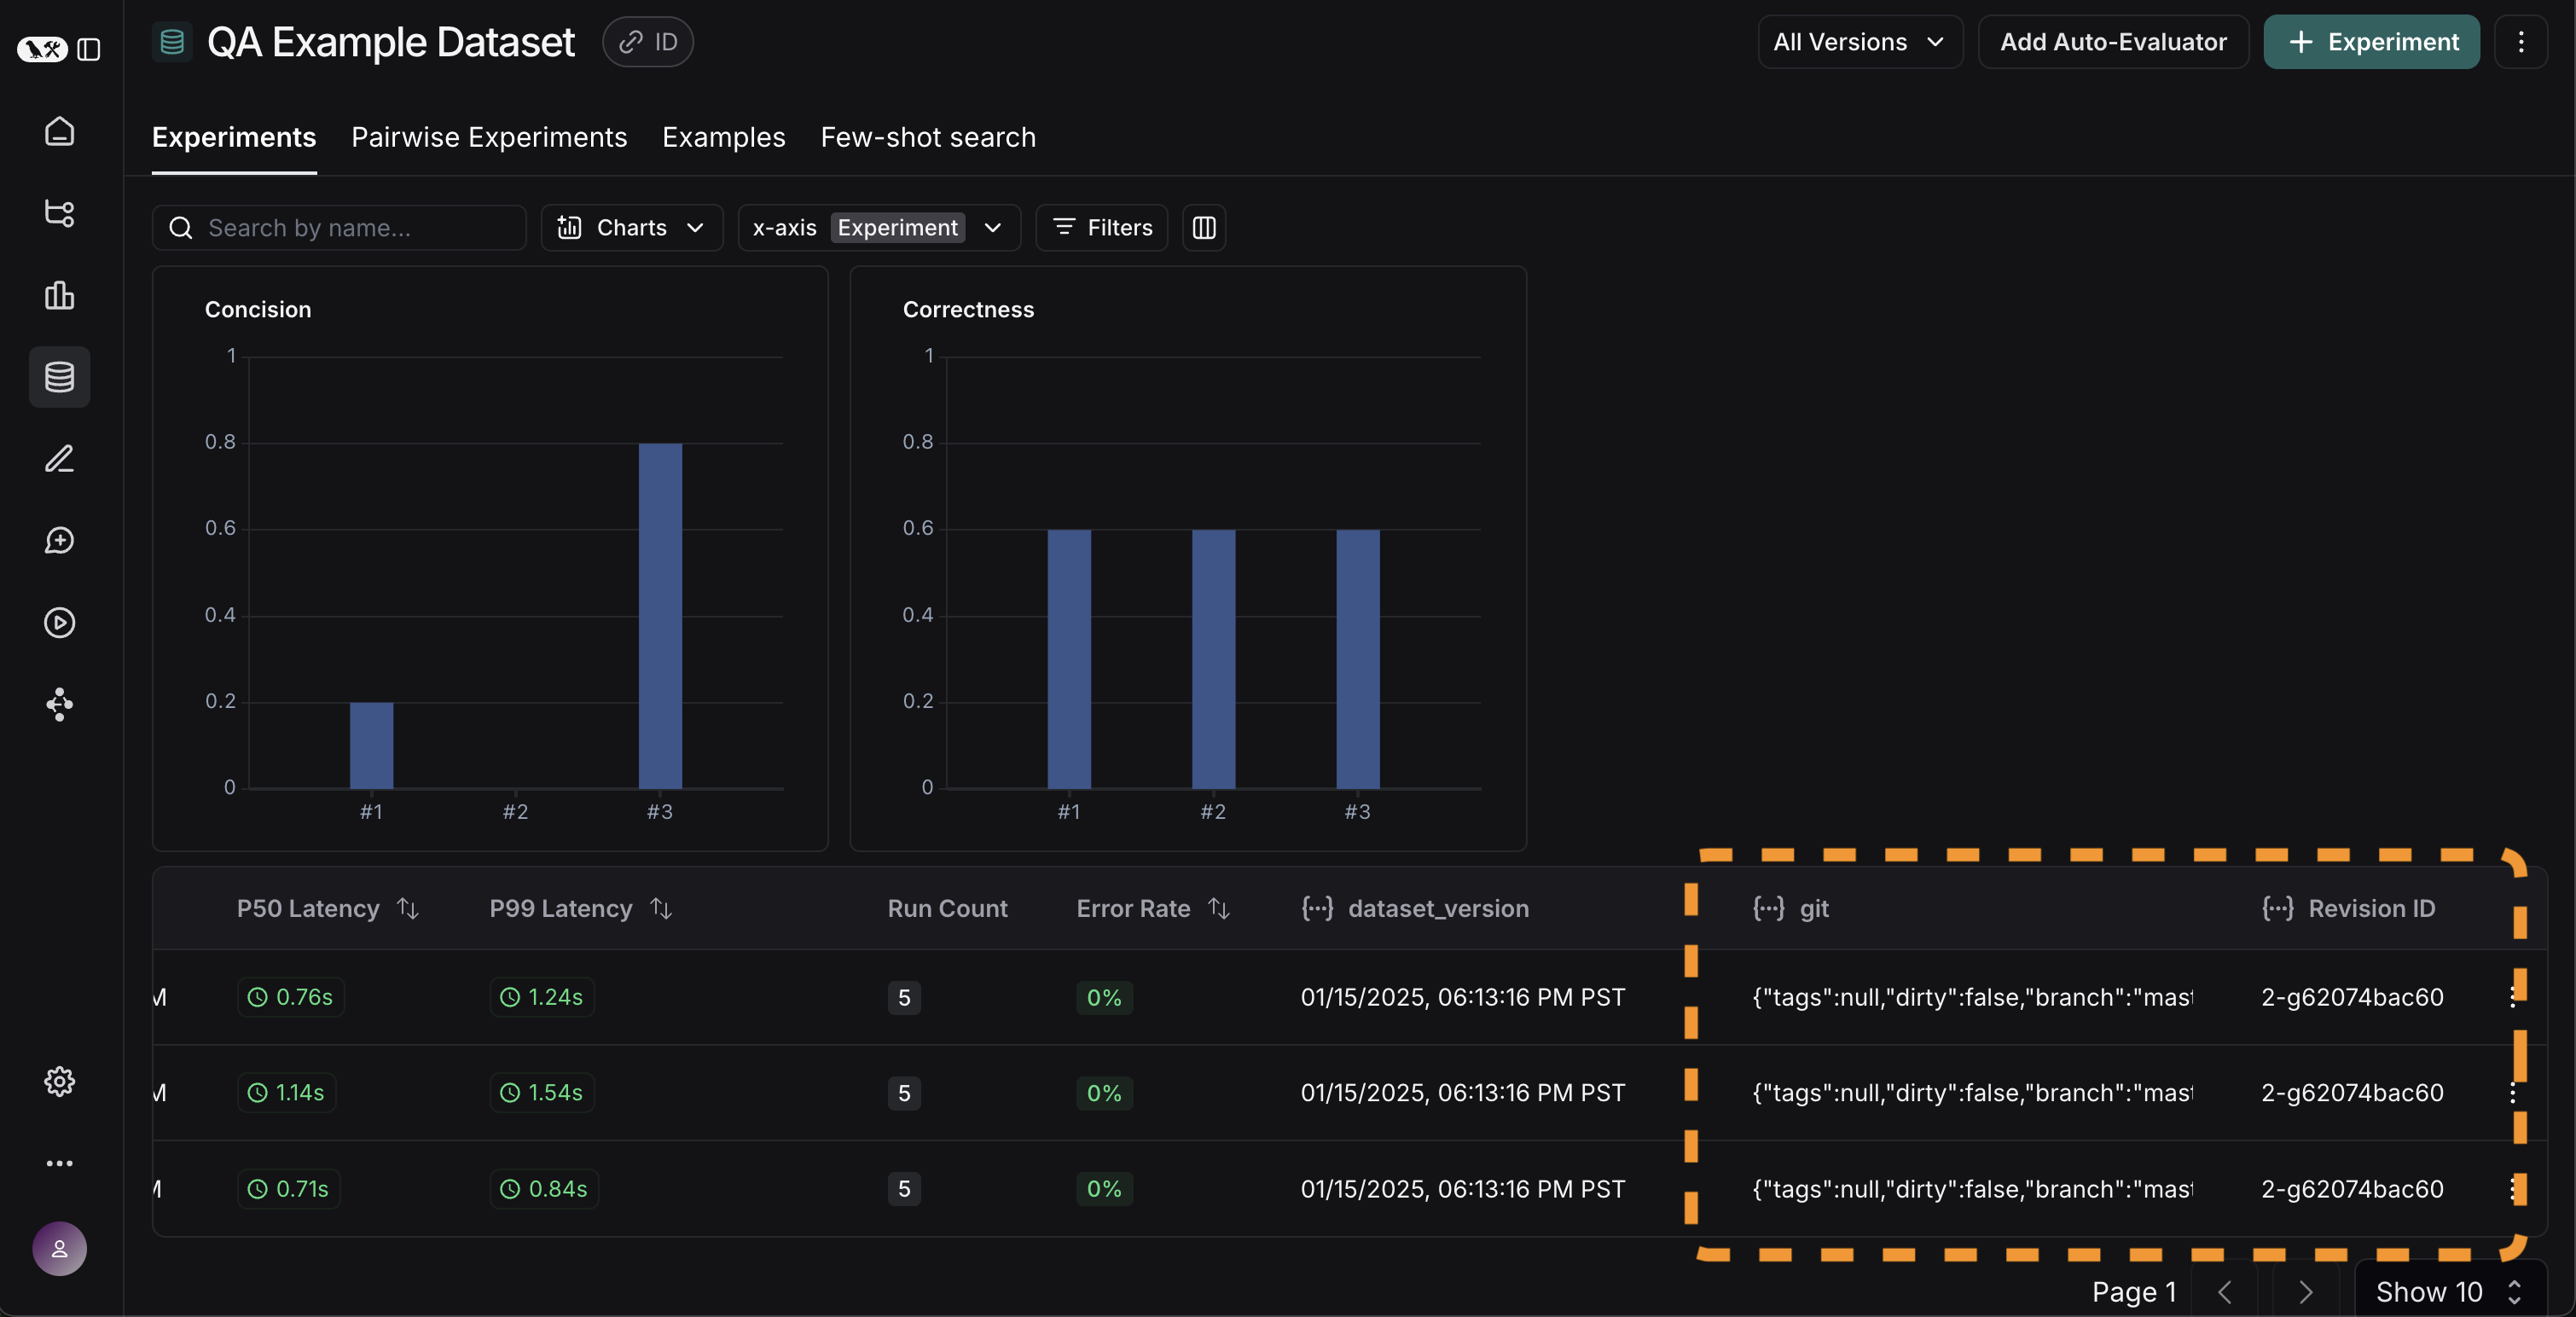
이제 이러한 실험을 자동화된 방식으로 실행하고 있으니, 시간 경과에 따른 결과를 추적하고 싶어요. 데이터셋 페이지의 전체 Experiments 탭에서 할 수 있어요. 기본적으로 평가 지표를 시간 경과에 따라 표시해요(빨간색으로 강조). 또한 git 지표를 자동으로 추적해 코드의 브랜치와 쉽게 연결할 수 있어요(노란색으로 강조).
결론
이 튜토리얼은 여기까지예요!
초기 테스트 집합 생성, 몇 가지 평가 지표 정의, 실험 실행, 수동 비교, CI/CD 설정, 시간 경과에 따른 결과 추적 방법을 다뤘어요. 이것은 자신 있게 반복하는 데 도움이 돼요.
이것은 시작일 뿐이에요. 앞서 언급했듯이 평가는 지속적인 과정이에요. 예를 들어 평가하려는 데이터 포인트는 시간이 지나면서 계속 바뀔 가능성이 높아요. 탐색하고 싶은 많은 유형의 평가기가 있어요. 자세한 내용은 how-to 가이드를 확인해요.
또한 데이터를 평가하는 다른 방법이 있어요(예: 프로덕션 데이터를 평가할 수 있음) — 이 "오프라인" 방식과 달라요. 온라인 평가에 대한 자세한 내용은 LLM-as-a-judge 온라인 평가기 설정을 확인해요.
참조 코드
Application code
openai_client = wrappers.wrap_openai(openai.OpenAI())
default_instructions = "Respond to the users question in a short, concise manner (one short sentence)."
def my_app(question: str, model: str = "gpt-5.4-mini", instructions: str = default_instructions) -> str: return openai_client.chat.completions.create( model=model, temperature=0, messages=[ {"role": "system", "content": instructions}, {"role": "user", "content": question}, ], ).choices[0].message.content
client = Client()
Define dataset: these are your test cases
dataset_name = "QA Example Dataset" dataset = client.create_dataset(dataset_name)
client.create_examples( dataset_id=dataset.id, examples=[ { "inputs": {"question": "What is LangChain?"}, "outputs": {"answer": "A framework for building LLM applications"}, }, { "inputs": {"question": "What is LangSmith?"}, "outputs": {"answer": "A platform for observing and evaluating LLM applications"}, }, { "inputs": {"question": "What is OpenAI?"}, "outputs": {"answer": "A company that creates Large Language Models"}, }, { "inputs": {"question": "What is Google?"}, "outputs": {"answer": "A technology company known for search"}, }, { "inputs": {"question": "What is Mistral?"}, "outputs": {"answer": "A company that creates Large Language Models"}, } ] )
Define evaluators
eval_instructions = "You are an expert professor specialized in grading students' answers to questions."
def correctness(inputs: dict, outputs: dict, reference_outputs: dict) -> bool: user_content = f"""You are grading the following question: {inputs['question']} Here is the real answer: {reference_outputs['answer']} You are grading the following predicted answer: {outputs['response']} Respond with CORRECT or INCORRECT: Grade:""" response = openai_client.chat.completions.create( model="gpt-5.4-mini", temperature=0, messages=[ {"role": "system", "content": eval_instructions}, {"role": "user", "content": user_content}, ], ).choices[0].message.content return response == "CORRECT"
def concision(outputs: dict, reference_outputs: dict) -> bool: return int(len(outputs["response"]) < 2 * len(reference_outputs["answer"]))
Run evaluations
def ls_target(inputs: str) -> dict: return {"response": my_app(inputs["question"])}
experiment_results_v1 = client.evaluate( ls_target, # Your AI system data=dataset_name, # The data to predict and grade over evaluators=[concision, correctness], # The evaluators to score the results experiment_prefix="openai-4o-mini", # A prefix for your experiment names to easily identify them )
def ls_target_v2(inputs: str) -> dict: return {"response": my_app(inputs["question"], model="gpt-4-turbo")}
experiment_results_v2 = client.evaluate( ls_target_v2, data=dataset_name, evaluators=[concision, correctness], experiment_prefix="openai-4-turbo", )
instructions_v3 = "Respond to the users question in a short, concise manner (one short sentence). Do NOT use more than ten words."
def ls_target_v3(inputs: str) -> dict: response = my_app( inputs["question"], model="gpt-4-turbo", instructions=instructions_v3 ) return {"response": response}
experiment_results_v3 = client.evaluate( ls_target_v3, data=dataset_name, evaluators=[concision, correctness], experiment_prefix="strict-openai-4-turbo", )
</Accordion>

## 더 알아보기 (Learn more)

- [평가 how-to 가이드](/langsmith/evaluation)
- [LLM-as-a-judge 온라인 평가기](/langsmith/online-evaluations-llm-as-judge)
- [평가 개념](/langsmith/evaluation-concepts)