
GPT Actions로 데이터 검색하기
GPT Actions로 데이터 검색하기
GPT 안에서 액션이 수행하는 가장 흔한 작업 중 하나가 데이터 검색이에요. 다양한 유형의 검색 연동에서 고려해야 할 사항들을 담은 가이드랍니다.
출처: 문서
본문
GPT 안의 액션이 할 수 있는 가장 흔한 작업 중 하나는 데이터 검색이에요. 액션은 다음과 같은 일을 할 수 있어요:
- 키워드 검색에 기반해 데이터를 가져오도록 API에 접근
- 구조화된 쿼리에 기반해 레코드를 가져오도록 관계형 데이터베이스에 접근
- 의미 검색(semantic search)에 기반해 텍스트 청크를 가져오도록 벡터 데이터베이스에 접근
이 가이드에서는 다양한 유형의 검색 연동에서 특히 고려해야 할 사항들을 살펴볼 거예요.
API를 통한 데이터 검색
많은 조직이 중요한 데이터를 저장하기 위해 제3자 소프트웨어에 의존해요. 고객 데이터는 Salesforce, 지원 데이터는 Zendesk, 내부 프로세스 데이터는 Confluence, 비즈니스 문서는 Google Drive라고 생각해 보세요. 이러한 제공자들은 대부분 외부 시스템이 정보를 검색하고 가져올 수 있게 해주는 REST API를 제공해요.
제공자의 REST API와 연동하는 액션을 만들 때는 먼저 기존 문서를 검토하는 것부터 시작해 주세요. 몇 가지를 확인해야 해요:
- 검색 메서드 (Retrieval methods)
- Search - 제공자마다 검색 의미론(semantics)이 다르지만, 일반적으로 키워드나 쿼리 문자열을 받아 일치하는 문서 목록을 반환하는 메서드가 필요해요. 예시는 Google Drive의
file.list메서드를 참고하세요. - Get - 일치하는 문서를 찾았으면 그 문서를 가져올 방법이 필요해요. 예시는 Google Drive의
file.get메서드를 참고하세요.
- Search - 제공자마다 검색 의미론(semantics)이 다르지만, 일반적으로 키워드나 쿼리 문자열을 받아 일치하는 문서 목록을 반환하는 메서드가 필요해요. 예시는 Google Drive의
- 인증 방식 (Authentication scheme)
- 예를 들어, Google Drive는 OAuth를 사용해 사용자를 인증하고, 사용자가 이용할 수 있는 파일만 검색에 노출되도록 보장해요.
- OpenAPI 스펙 (OpenAPI spec)
- 일부 제공자는 액션에 바로 가져올 수 있는 OpenAPI 스펙 문서를 제공해요. 예시는 Zendesk를 참고하세요.
- GPT가 접근하지 않을 메서드에 대한 참조는 제거하는 것이 좋아요. 그러면 GPT가 수행할 수 있는 액션이 제한되거든요.
- OpenAPI 스펙 문서를 제공하지 않는 제공자의 경우, OpenAI가 만든 ActionsGPT를 사용해 직접 만들 수 있어요.
- 일부 제공자는 액션에 바로 가져올 수 있는 OpenAPI 스펙 문서를 제공해요. 예시는 Zendesk를 참고하세요.
목표는 GPT가 액션을 사용해 사용자의 프롬프트와 관련된 맥락이 담긴 문서를 검색하고 가져오도록 하는 거예요. GPT는 여러분의 지침에 따라 제공된 search와 get 메서드를 사용해 이 목표를 달성해요.
관계형 데이터베이스를 통한 데이터 검색
조직은 비즈니스와 관련된 다양한 레코드를 저장하기 위해 관계형 데이터베이스를 사용해요. 이러한 레코드는 GPT 응답을 개선하는 데 도움이 되는 유용한 맥락을 담을 수 있어요. 예를 들어, 사용자가 보험 청구 상태를 이해하도록 돕는 GPT를 만든다고 가정해 봐요. GPT가 청구 번호를 기반으로 관계형 데이터베이스에서 청구건을 조회할 수 있다면, 사용자에게 훨씬 더 유용해질 거예요.
관계형 데이터베이스와 연동하는 액션을 만들 때 유의할 점이 몇 가지 있어요:
- REST API의 가용성
- 많은 관계형 데이터베이스는 쿼리 처리를 위한 REST API를 네이티브로 노출하지 않아요. 그런 경우 GPT와 데이터베이스 사이에 놓일 미들웨어를 직접 만들거나 구매해야 할 수 있어요.
- 이 미들웨어는 다음을 수행해야 해요:
- 정형화된 쿼리 문자열을 받고
- 그 쿼리 문자열을 데이터베이스에 전달하며
- 반환된 레코드를 요청자에게 응답해요
- 공개 인터넷에서의 접근성
- 공개 인터넷에서 접근하도록 설계된 API와 달리, 관계형 데이터베이스는 전통적으로 조직 내부 애플리케이션 인프라 안에서 사용하도록 설계돼 있어요. GPT는 OpenAI 인프라에서 호스팅되므로, 노출하는 API가 방화벽 밖에서도 접근 가능한지 확인해야 해요.
- 복잡한 쿼리 문자열
- 관계형 데이터베이스는 SQL 같은 정형 쿼리 문법을 사용해 관련 레코드를 가져와요. 즉, 어떤 쿼리 문법이 지원되는지 GPT에 추가 지침을 제공해야 한다는 뜻이에요. 좋은 소식은 GPT가 대개 사용자 입력을 바탕으로 정형 쿼리를 아주 잘 생성한다는 점이에요.
- 데이터베이스 권한
- 데이터베이스는 사용자 수준 권한을 지원하지만, 최종 사용자가 데이터베이스에 직접 접근할 권한을 가지지는 못할 가능성이 커요. 서비스 계정을 사용해 접근을 제공하려면 서비스 계정에 읽기 전용 권한을 부여하는 것을 고려해 보세요. 그러면 기존 데이터를 실수로 덮어쓰거나 삭제하는 일을 피할 수 있어요.
목표는 GPT가 사용자 프롬프트와 관련된 정형 쿼리를 작성하고, 액션을 통해 그 쿼리를 제출한 뒤, 반환된 레코드를 사용해 응답을 보강하도록 하는 거예요.
벡터 데이터베이스를 통한 데이터 검색
GPT에 가장 관련성 높은 검색 결과를 갖추고 싶다면, 위에서 설명한 의미 검색을 지원하는 벡터 데이터베이스와 GPT를 연동하는 것을 고려해 볼 수 있어요. 시장에는 관리형 및 자체 호스팅 솔루션이 많이 있는데, 부분 목록은 여기에서 확인할 수 있어요.
벡터 데이터베이스와 연동하는 액션을 만들 때 유의할 점이 몇 가지 있어요:
- REST API의 가용성
- 많은 관계형 데이터베이스는 쿼리 처리를 위한 REST API를 네이티브로 노출하지 않아요. 그런 경우 GPT와 데이터베이스 사이에 놓일 미들웨어를 직접 만들거나 구매해야 할 수 있어요(미들웨어에 대한 자세한 내용은 아래 참고).
- 공개 인터넷에서의 접근성
- 공개 인터넷에서 접근하도록 설계된 API와 달리, 관계형 데이터베이스는 전통적으로 조직 내부 애플리케이션 인프라 안에서 사용하도록 설계돼 있어요. GPT는 OpenAI 인프라에서 호스팅되므로, 노출하는 API가 방화벽 밖에서도 접근 가능한지 확인해야 해요.
- 쿼리 임베딩 (Query embedding)
- 위에서 언급했듯 벡터 데이터베이스는 일반적으로 쿼리 입력으로 (평문이 아닌) 벡터 임베딩을 받아요. 즉, 쿼리 입력을 벡터 데이터베이스에 제출하기 전에 임베딩 API를 사용해 벡터 임베딩으로 변환해야 해요. 이 변환은 REST API 게이트웨이에서 처리하는 것이 가장 좋아요. 그러면 GPT가 평문 쿼리 문자열을 제출할 수 있거든요.
- 데이터베이스 권한
- 벡터 데이터베이스는 전체 문서가 아니라 텍스트 청크를 저장하므로, 원본 소스 문서에 존재했을 수 있는 사용자 권한을 유지하기 어려울 수 있어요. 여러분의 GPT에 접근할 수 있는 모든 사용자는 데이터베이스의 모든 텍스트 청크에 접근할 수 있다는 점을 기억하고 그에 맞게 계획하세요.
벡터 데이터베이스를 위한 미들웨어
위에서 설명했듯, 벡터 데이터베이스를 위한 미들웨어는 일반적으로 두 가지 일을 해요:
- REST API를 통해 벡터 데이터베이스에 대한 접근을 노출하고
- 평문 쿼리 문자열을 벡터 임베딩으로 변환해요
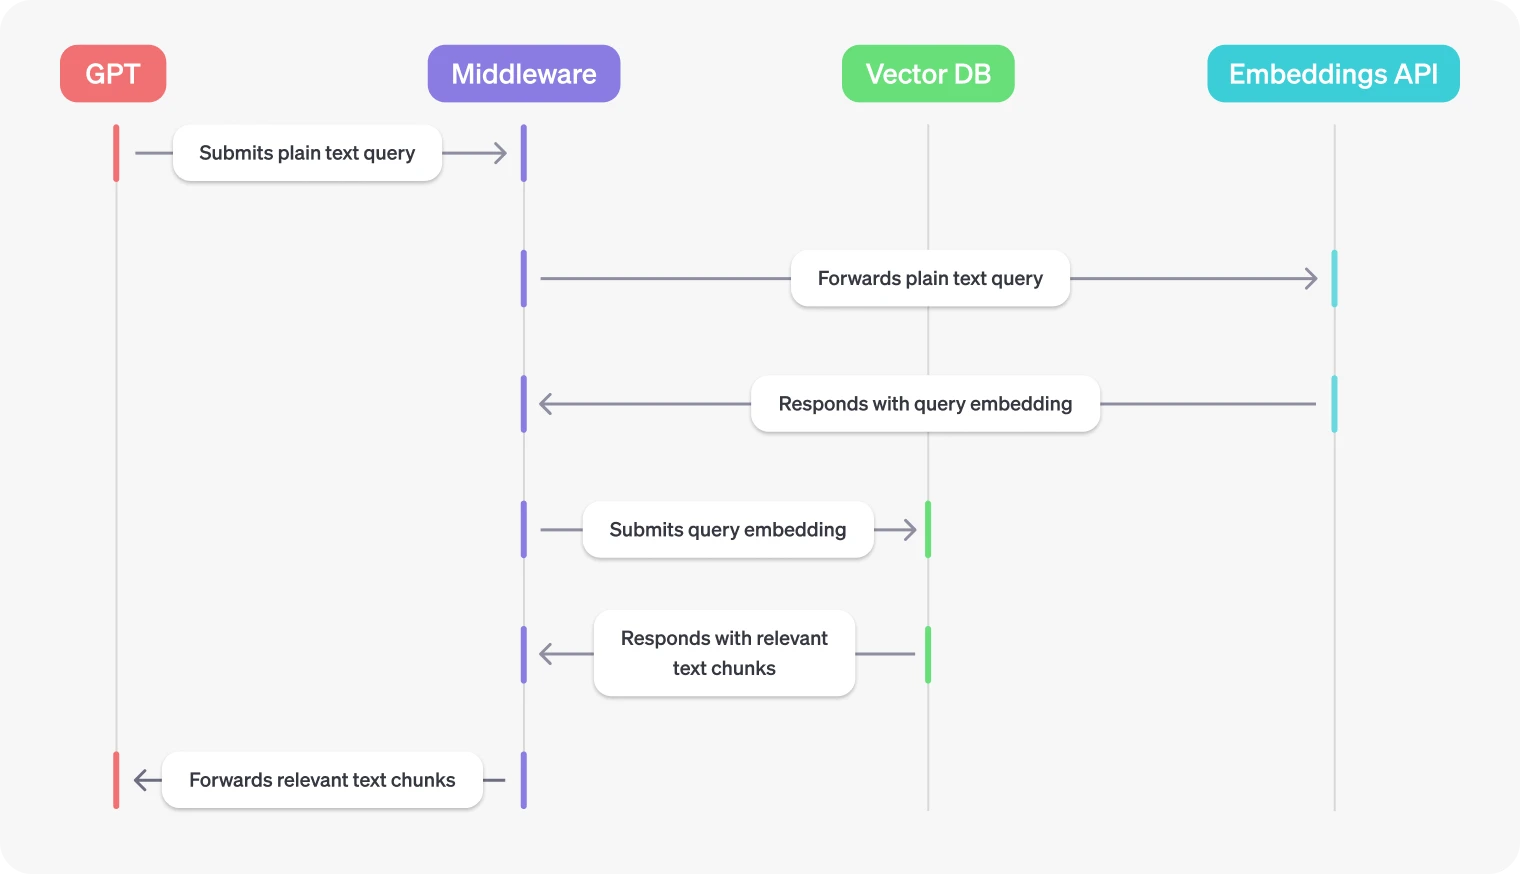
목표는 GPT가 의미 검색을 발동하도록 벡터 데이터베이스에 관련 쿼리를 제출하고, 반환된 텍스트 청크를 사용해 응답을 보강하도록 하는 거예요.
더 알아보기 (Learn more)
관련 문서: GPT Actions 시작하기와 GPT Actions 라이브러리를 참고하세요.