
LLM 정확성 최적화
LLM 정확성 최적화 (Optimizing LLM Accuracy)
LLM으로 최대 정확성과 일관된 동작을 얻는 방법을 정리한 백서예요. 프롬프트 엔지니어링, 검색 증강 생성(RAG), fine-tuning 같은 방법을 탐구하고, 각 기법을 언제 어떻게 쓰는지, 어떤 함정이 있는지 보여드릴게요.
출처: 문서
본문
LLM 최적화는 어렵다
스타트업과 엔터프라이즈의 많은 개발자와 협력해 보니, 최적화가 어려운 이유는 일관되게 이 때문이에요.
- 정확성 최적화를 어떻게 시작할지 모르기 때문
- 어떤 최적화 방법을 언제 써야 할지 모르기 때문
- 프로덕션에 어느 정도의 정확성이면 충분한지 모르기 때문
이 백서는 LLM을 정확성과 동작 면에서 최적화하는 정신적 모델을 제공해요. 프롬프트 엔지니어링, 검색 증강 생성(RAG), fine-tuning 같은 방법을 탐구하고, 각 기법을 언제 어떻게 쓸지 강조하며, 몇 가지 함정을 공유해요.
읽으면서 이 원칙을 여러분의 특정 사용 사례에서 정확성이 무엇을 뜻하는지와 연결해 보세요. 자명해 보일 수 있지만, 인간이 고쳐야 하는 나쁜 카피를 만드는 것과 고객에게 $100 대신 $1000을 환불하는 것은 다르다는 차이가 있어요. LLM 정확성 논의에 들어갈 때는 LLM의 실패가 얼마나 비용이 들고, 성공이 얼마나 절약·벌어들이는지 대략적인 그림을 갖고 들어가야 해요. 이것은 마지막에 프로덕션에서 "좋은 충분한" 정확성이 얼마인지 다룰 때 다시 살펴볼 거예요.
LLM 최적화 컨텍스트
많은 최적화 "how-to" 가이드는 그것을 단순한 선형 흐름으로 그려요. 프롬프트 엔지니어링으로 시작하고, RAG로, 그다음 fine-tuning으로 옮겨가는 식이에요. 하지만 대개 그렇지 않아요. 이들은 서로 다른 것을 해결하는 레버이고, 올바른 방향으로 최적화하려면 올바른 레버를 당겨야 해요.
LLM 최적화를 행렬로 보는 것이 유용해요.

전형적인 LLM 작업은 왼쪽 아래 모서리의 프롬프트 엔지니어링에서 시작해, 테스트·학습·평가로 기준선을 얻어요. 기준선 예시를 검토하고 왜 틀렸는지 평가한 뒤, 우리는 레버 중 하나를 당길 수 있어요.
- 컨텍스트 최적화: 1) 모델이 학습 세트에 없어 컨텍스트 지식이 없거나, 2) 지식이 낡았거나, 3) 독점 정보에 대한 지식이 필요할 때 컨텍스트를 최적화해야 해요. 이 축은 응답 정확성을 최대화해요.
- LLM 최적화: 1) 모델이 잘못된 형식으로 일관되지 않은 결과를 만들거나, 2) 발화의 톤·스타일이 맞지 않거나, 3) 추론이 일관되게 따르지 않을 때 LLM을 최적화해야 해요. 이 축은 동작의 일관성을 최대화해요.
실제로 이것은 일련의 최적화 단계가 되는데, 평가 → 최적화 가설 → 적용 → 평가 → 다음 단계 재평가로 진행돼요. 비교적 전형적인 최적화 흐름의 예시:
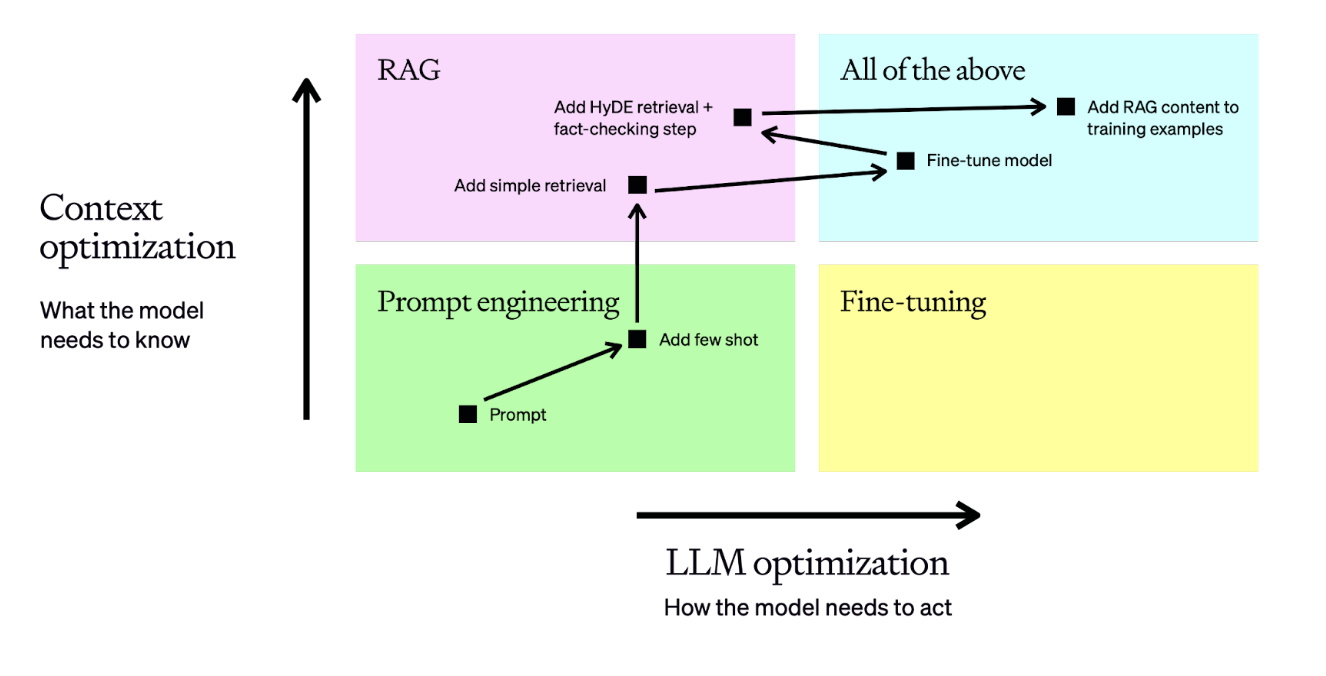
이 예시에서는 다음을 수행해요.
- 프롬프트로 시작해 성능 평가
- 정적 few-shot 예시 추가 — 결과의 일관성 개선 기대
- 검색 단계 추가 — 질문에 따라 few-shot 예시를 동적으로 가져와 각 입력에 관련 컨텍스트를 보장해 성능 향상
- 50개 이상 예시의 데이터셋 준비 후 모델 fine-tuning — 일관성 증가
- 검색 조정 + 환각 발견용 사실 확인 단계 추가 — 더 높은 정확성 달성
- 강화된 RAG 입력을 포함한 새 학습 예시로 fine-tuned 모델 재학습
이것은 까다로운 비즈니스 문제에 대한 비교적 전형적인 최적화 파이프라인이에요. 더 관련 있는 컨텍스트가 필요한지, 모델의 더 일관된 동작이 필요한지 결정하는 데 도움이 돼요. 결정을 내리면 최적화의 첫 단계로 어떤 레버를 당길지 알 수 있어요.
이제 정신적 모델이 있으니, 이 모든 영역에 행동하는 방법을 살펴볼게요. 왼쪽 아래 모서리의 프롬프트 엔지니어링부터 시작할게요.
프롬프트 엔지니어링
프롬프트 엔지니어링은 보통 가장 좋은 시작점이에요. 요약, 번역, 코드 생성 같은 사용 사례에서는 제로샷 접근이 프로덕션 수준의 정확성·일관성에 도달할 수 있으므로 종종 필요한 유일한 방법이에요.
이는 정확성이 사용 사례에서 무엇을 뜻하는지 정의하게 하기 때문이에요. 입력을 제공하는 가장 기본적인 수준에서 시작하므로, 출력이 기대와 일치하는지 판단할 수 있어야 해요. 원하는 것이 아니라면 그 **이유(why)**가 이후 최적화를 이끌 것을 보여줄 거예요.
이를 위해 항상 단순한 프롬프트와 기대 출력을 염두에 두고 시작한 뒤, 컨텍스트, 지시, 예시를 추가하며 원하는 것을 줄 때까지 프롬프트를 최적화해야 해요.
최적화
프롬프트를 최적화하려면 대부분 프롬프트 엔지니어링 가이드의 전략에 기대요. 각 전략은 컨텍스트, LLM, 또는 둘 다 조정하는 데 도움이 돼요.
| 전략 | 컨텍스트 최적화 | LLM 최적화 |
|---|---|---|
| 명확한 지시 작성 | X | |
| 복잡한 작업을 단순 하위 작업으로 나누기 | X | X |
| GPT에 "생각"할 시간 주기 | X | |
| 변경을 체계적으로 테스트 | X | X |
| 참조 텍스트 제공 | X | |
| 외부 도구 사용 | X |
이것들은 시각화하기 약간 어려울 수 있으니, 실용적 예시로 테스트해 보는 예를 살펴볼게요. gpt-4-turbo로 아이슬란드어 문장을 교정해 보겠어요.
언어 교정을 위한 프롬프트 엔지니어링
아이슬란드어 오류 말뭉치에는 오류가 있는 아이슬란드어 문장과 그 교정 버전의 조합이 있어요. 기준선 GPT-4 모델로 이 작업을 해결하려 시도하고, 다른 최적화 기법을 적용해 성능을 개선할 수 있는지 볼게요.
아이슬란드어 문장이 주어지면 모델이 교정 버전을 반환하길 원해요. BLEU 점수로 번역의 상대 품질을 측정할게요.
예시: system "다음 문장에는 오류가 있을 수 있는 아이슬란드어 문장이 포함돼 있습니다. 가능한 한 적은 단어 변경으로 이 오류를 교정하세요." → user/assistant 쌍, BLEU 1.0.
GPT-4로 예시 없이 첫 시도를 하면 꽤 잘 수행하며 BLEU 점수 62를 얻어요. 이제 몇 개의 few-shot 예시를 추가해, 말로 설명하는 대신 보여주며 우리가 찾는 스타일을 가르칠 수 있는지 볼게요.
SYSTEM: The following sentences contain Icelandic sentences which may include errors. Please correct these errors using as few word changes as possible.

# Examples
USER: "Stofnendurnir séu margir og eru fulltrúar hennar frá Englandi, Grikklandi, Rússlandi, Svíþjóð og fleiri löndum Evrópu."
ASSISTANT: "Hann segir að stofnendur leynireglunnar séu margir og að fulltrúar hennar séu frá Englandi, Grikklandi, Rússlandi, Svíþjóð og fleiri löndum Evrópu."

USER: [input user query here]
전체 번역 품질이 좋아져 BLEU 점수가 **70(+8%)**로 개선돼요. 이는 꽤 좋고, 작업의 예시를 주는 것이 모델이 배우는 데 도움이 된다는 것을 보여줘요.
이는 우리가 최적화해야 할 것이 모델의 동작이라는 것을 말해줘요. 문제를 푸는 데 필요한 지식을 이미 갖고 있으므로, 더 많은 예시를 제공하는 것이 필요한 최적화일 수 있어요.
나중에 이 작업으로 더 고급 최적화 방법을 테스트하기 위해 이것을 다시 살펴볼게요.
프롬프트 엔지니어링이 좋은 시작점이고, 올바른 조정 방법으로 성능을 꽤 멀리 끌어올릴 수 있다는 것을 봤어요.
하지만 프롬프트 엔지니어링의 가장 큰 문제는 자주 확장되지 않는다는 것이에요. 컨텍스트에 콘텐츠를 추가하는 것보다 더 넓은 범위의 문제를 처리하도록 동적 컨텍스트를 공급해야 하거나, few-shot 예시로 달성할 수 있는 것보다 더 일관된 동작이 필요해요.
긴 컨텍스트 모델은 프롬프트 엔지니어링이 더 확장되게 해요. 하지만 복잡한 지시가 있는 매우 큰 프롬프트에 걸쳐 모델이 주의를 유지하기 어려울 수 있으니, 항상 긴 컨텍스트 모델을 다른 컨텍스트 크기에서의 평가와 짝지어 lost in the middle이 되지 않게 해야 해요. "Lost in the middle"은 LLM이 한 번에 주어진 모든 토큰에 동일한 주의를 기울일 수 없다는 것을 다루는 용어예요. 이는 정보를 겉보기엔 무작위로 놓칠 수 있게 해요. 긴 컨텍스트를 쓰지 말라는 뜻은 아니고, 철저한 평가와 짝지어야 한다는 뜻이에요. 오픈소스 기여자 Greg Kamradt가 Needle in A Haystack (NITA)라는 유용한 평가를 만들었는데, 긴 컨텍스트 문서의 다양한 깊이에 정보를 숨기고 검색 품질을 평가해요. 이는 긴 컨텍스트의 문제를 보여줘요. 모든 것을 컨텍스트에 던질 수 있는 훨씬 단순한 검색 과정을 약속하지만, 정확성을 희생해요.
그래서 프롬프트 엔지니어링을 정말 얼마나 멀리 끌어올릴 수 있을까요? 답은 상황에 따라 다르고, 결정하는 방법은 평가를 통해서라는 거예요.
평가
이것이 좋은 프롬프트와 평가 질문·ground truth 답변 세트가 이 단계의 최고 산출물인 이유예요. 20개 이상의 질문·답변이 있고 실패의 세부 사항을 조사했으며 왜 발생하는지 가설이 있다면, 더 고급 최적화 방법에 나갈 올바른 기준선을 갖춘 거예요.
더 정교한 최적화 방법으로 넘어가기 전에, 반복을 가속화하기 위해 이 평가를 자동화하는 것도 고려할 가치가 있어요. 효과적인 걸 본 일반적인 관행:
- ROUGE나 BERTScore 같은 접근 사용 — 손가락질하는 대략적 판단 제공. 인간 검토자와 그렇게 밀접히 상관되지 않지만, 반복이 모델 출력을 얼마나 바꿨는지 빠르고 효과적으로 측정할 수 있어요.
- G-Eval 백서에서 개요처럼 GPT-4를 평가자로 사용 — LLM에 스코어카드를 주어 출력을 최대한 객관적으로 평가하게 함.
이것들을 더 깊이 파고 싶다면 이 cookbook을 확인하세요. 실제로 모두를 안내해요.
도구 이해하기
프롬프트 엔지니어링을 했고, eval 세트가 있고, 모델이 여전히 필요한 일을 하지 않는다고 해요. 가장 중요한 다음 단계는 어디서 실패하는지 진단하고 어떤 도구가 개선에 가장 좋은지 정하는 거예요.
기본 프레임워크는 다음과 같아요.
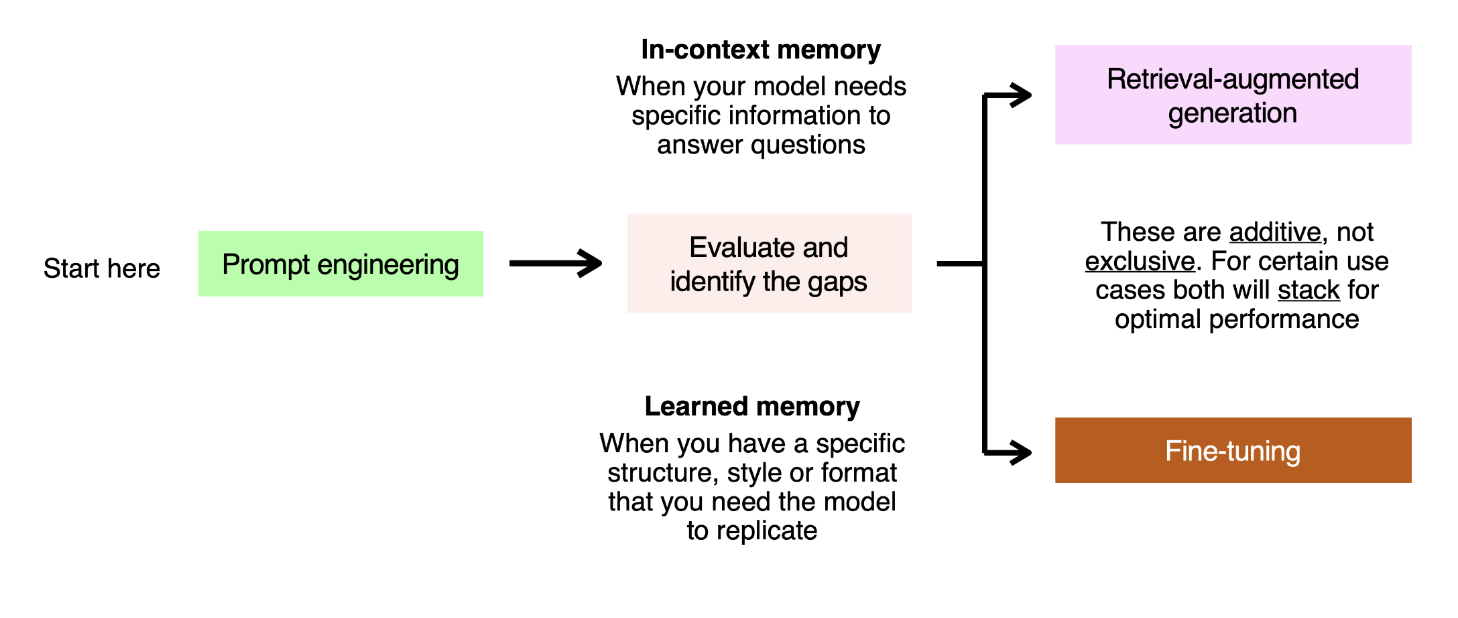
각 실패한 평가 질문을 인컨텍스트(in-context) 또는 학습된(learned) 기억 문제로 볼 수 있어요. 비유로 시험을 친다고 상상해 보세요. 올바른 답을 얻기 위해 확실히 하는 두 가지 방법이 있어요.
- 지난 6개월간 수업을 들어 특정 개념이 어떻게 작동하는지의 많은 반복 예시를 보는 것. 이것은 학습된 기억이에요. LLM에서는 기대하는 프롬프트·응답의 예시를 보여주고 모델이 그것에서 배우게 하여 해결해요.
- 교과서를 옆에 두고 질문에 답할 올바른 정보를 찾아보는 것. 이것은 인컨텍스트 기억이에요. LLM에서는 관련 정보를 컨텍스트 창에 채워 해결하는데, 프롬프트 엔지니어링으로 정적으로, 또는 RAG로 산업적으로 해요.
이 두 최적화 방법은 배타적이지 않고 더해져요. 서로 쌓이고, 일부 사용 사례는 최적 성능을 위해 함께 사용해야 해요.
단기 기억 문제를 마주한다고 가정해 봅시다. 이를 위해 RAG를 써서 해결할게요.
검색 증강 생성 (RAG)
RAG는 답을 Generating하기 전에 LLM의 프롬프트를 Augment할 콘텐츠를 Retrieving하는 과정이에요. 작업을 풀기 위해 모델에 도메인 특정 컨텍스트 접근을 주는 데 쓰여요.
RAG는 LLM의 정확성·일관성을 높이는 매우 귀중한 도구예요. OpenAI의 가장 큰 고객 배포 중 상당수가 프롬프트 엔지니어링과 RAG만으로 이뤄졌어요.
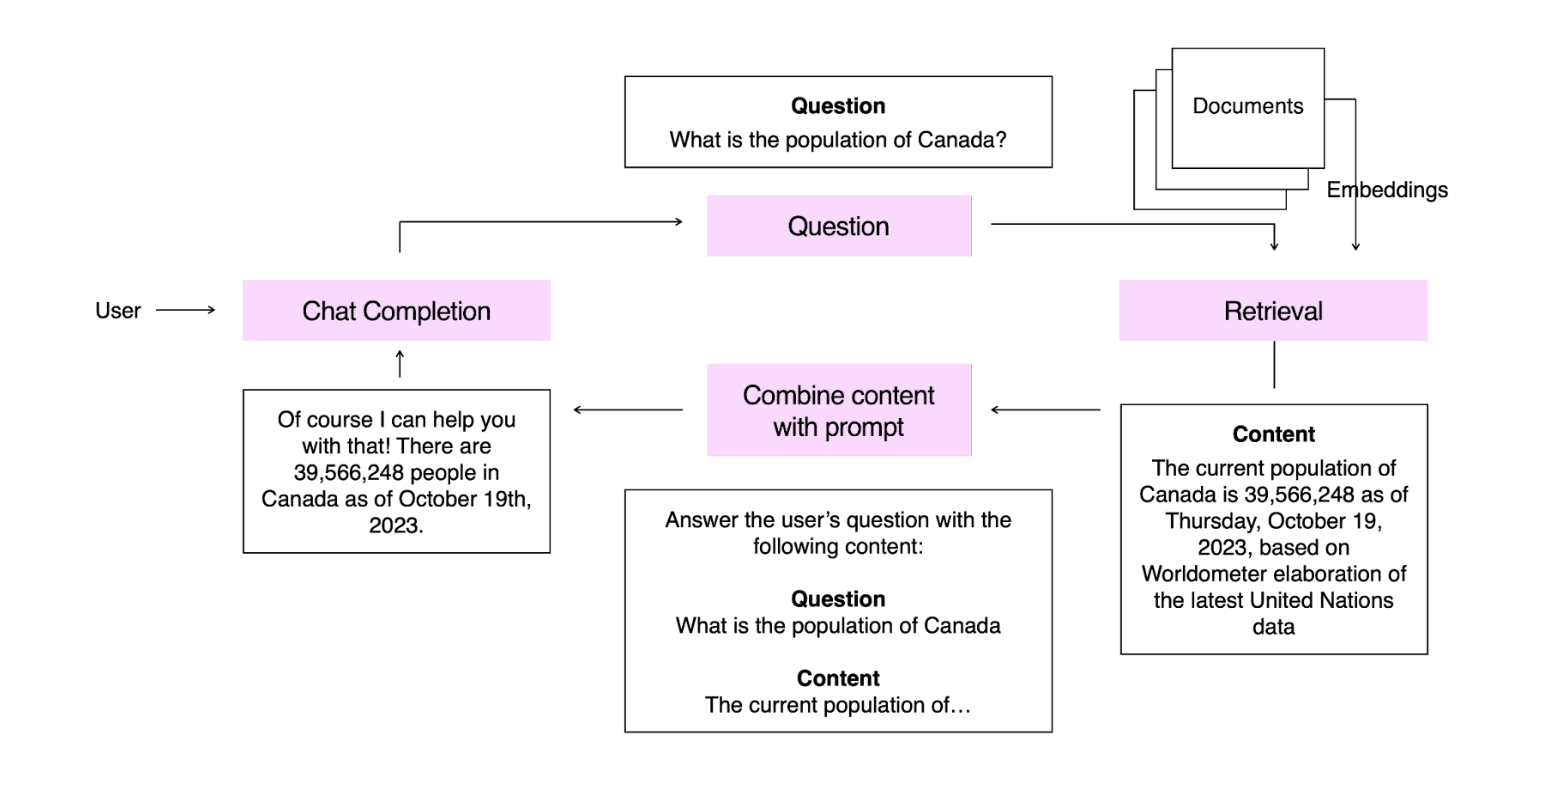
이 예시에서는 통계 지식 베이스를 임베딩했어요. 사용자가 질문하면 그 질문을 임베딩하고 지식 베이스에서 가장 관련 있는 콘텐츠를 찾아요. 이것이 모델에 제시되고, 모델이 질문에 답해요.
RAG 애플리케이션은 최적화해야 할 새 축, 검색(retrieval)을 도입해요. RAG가 작동하려면 모델에 올바른 컨텍스트를 주고, 모델이 올바르게 답하는지 평가해야 해요. RAG 평가를 생각하는 간단한 방법으로 격자로 표현할게요.
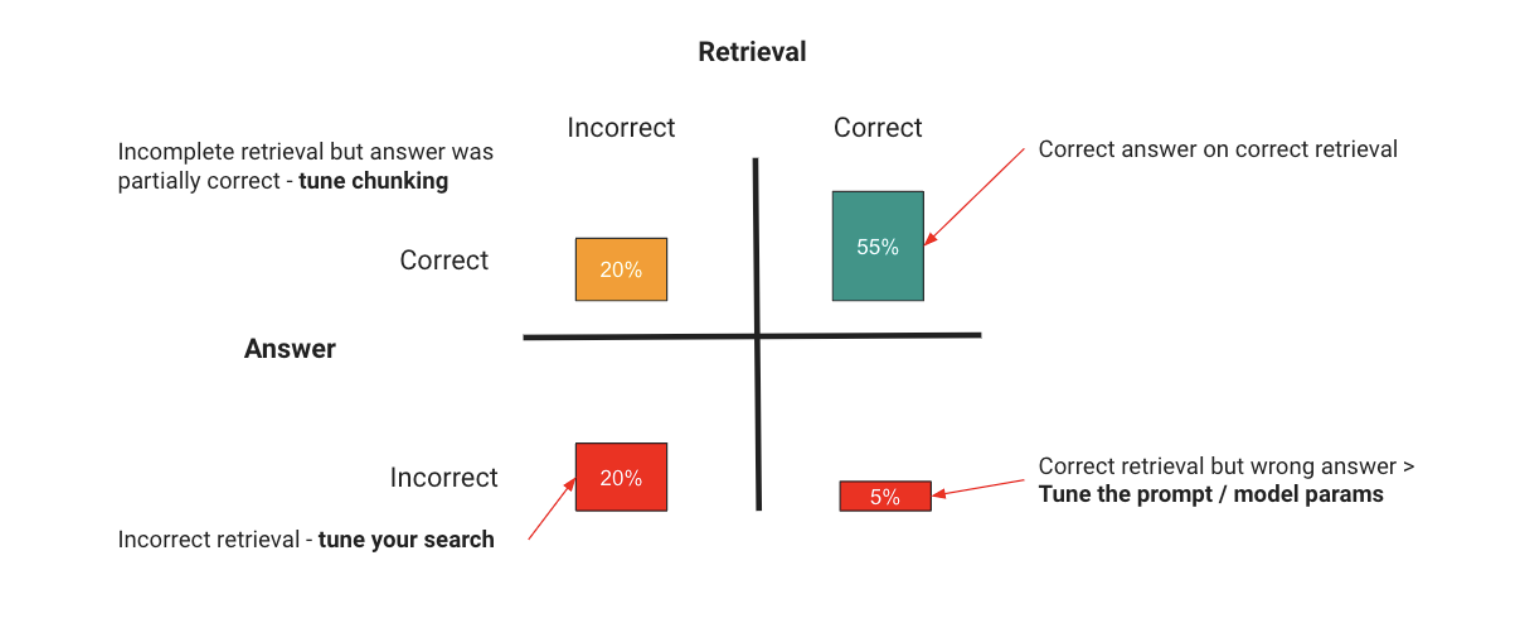
RAG 애플리케이션이 무너질 수 있는 두 영역이 있어요.
| 영역 | 문제 | 해결 |
|---|---|---|
| 검색 | 잘못된 컨텍스트를 제공하면 모델이 답할 수 없거나, 너무 많은 무관한 컨텍스트를 제공해 실제 정보를 묻히고 환각을 유발할 수 있어요. | 검색 최적화. 올바른 결과를 반환하도록 검색 조정, 노이즈를 덜 포함하도록 검색 조정, 각 검색 결과에 더 많은 정보 제공. 이것들은 단지 예시이고, LlamaIndex·LangChain 같은 라이브러리가 여기 튜닝에 많은 접근을 제공하므로 RAG 튜닝은 그 자체로 하나의 산업이에요. |
| LLM | 모델이 올바른 컨텍스트를 받아도 잘못된 일을 할 수 있어요. | 모델이 쓰는 지시·방법을 개선하는 프롬프트 엔지니어링, 그리고 예시를 보여주는 것이 정확성을 높이면 fine-tuning 추가. |
여기서 핵심은 처음 정신적 모델과 원칙이 같다는 거예요. 평가로 무엇이 잘못됐는지 찾고, 최적화 단계로 고치는 것이에요. RAG의 유일한 차이는 이제 고려할 검색 축이 있다는 거예요.
유용하지만 RAG는 인컨텍스트 학습 문제만 해결해요. 많은 사용 사례의 문제는 LLM이 작업을 배워 일관되고 안정적으로 수행하는 것일 거예요. 이 문제는 fine-tuning으로 돌립니다.
Fine-tuning
학습된 기억 문제를 풀기 위해 많은 개발자가 더 작고 도메인 특정한 데이터셋으로 LLM의 학습 과정을 계속해 특정 작업에 최적화해요. 이 과정을 fine-tuning이라고 해요.
Fine-tuning은 보통 두 가지 이유 중 하나로 수행돼요.
- 특정 작업에서 모델 정확성 개선: 그 작업이 올바르게 수행되는 많은 예시를 보여주며 학습된 기억 문제를 풀기 위해 작업 특정 데이터로 모델을 학습.
- 모델 효율성 개선: 더 적은 토큰이나 더 작은 모델로 같은 정확성 달성.
Fine-tuning 과정은 학습 예시 데이터셋 준비로 시작하는데, 이는 가장 중요한 단계예요. fine-tuning 예시가 모델이 실제 세계에서 볼 것을 정확히 대표해야 하기 때문이에요.
많은 고객이 프롬프트 베이킹(prompt baking) 과정을 쓰는데, 파일럿 동안 프롬프트 입력·출력을 광범위하게 로그해요. 이 로그를 현실적인 예시로 효과적인 학습 세트로 가지치기할 수 있어요.
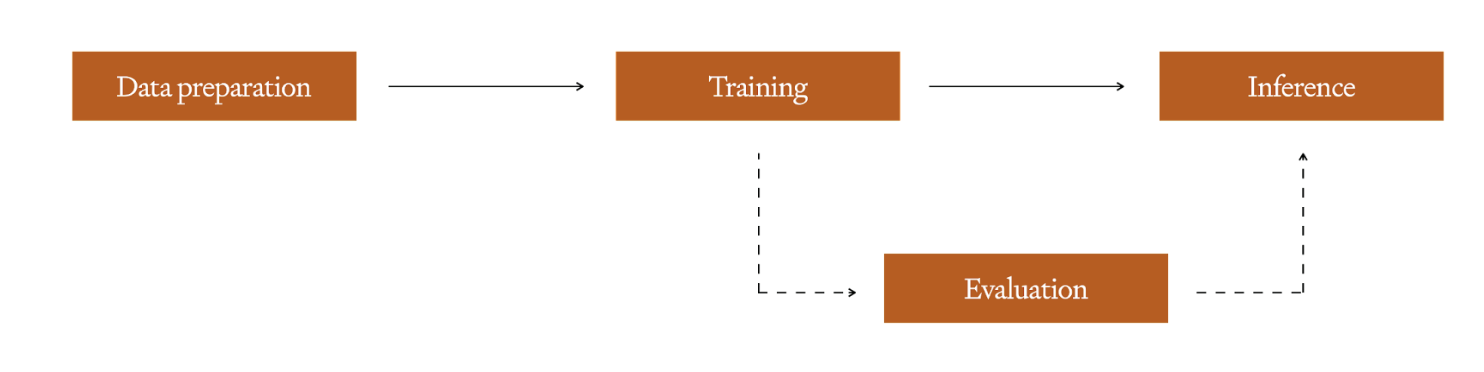
이 깨끗한 세트가 있으면 학습 실행으로 fine-tuned 모델을 학습할 수 있어요. 학습에 쓰는 플랫폼·프레임워크에 따라 다른 ML 모델처럼 조정할 하이퍼파라미터가 있을 수 있어요. 과적합 감지를 위해 학습 후 평가에 쓸 홀드아웃 세트를 유지하는 것을 항상 권장해요. 좋은 학습 세트 구성 팁은 fine-tuning 문서의 지침을 확인하세요. 학습이 완료되면 새 fine-tuned 모델을 인퍼런스에 쓸 수 있어요.
Fine-tuning 최적화에 관해 OpenAI의 모델 커스터마이징 제품에서 관찰한 모범 사례에 집중할게요. 하지만 이 원칙은 다른 제공자·OSS 제공물에도 성립해야 해요. 여기 지켜야 할 핵심 관행:
- 프롬프트 엔지니어링으로 시작: 기준선으로 쓸 수 있는 프롬프트 엔지니어링의 견고한 평가 세트 보유. 기본 프롬프트에 자신감이 생길 때까지 저투자 접근 가능.
- 작게 시작하고 품질에 집중: 파운데이션 모델 위에 fine-tuning할 때 학습 데이터 품질이 양보다 중요. 50개 이상 예시로 시작해 평가하고, 아직 정확성 요구에 도달하지 않았고 잘못된 답을 유발하는 문제가 컨텍스트가 아니라 일관성·동작 때문이라면 학습 세트 크기를 늘림.
- 예시가 대표적이게: 가장 흔한 함정 중 하나는 비대표적 학습 데이터로, fine-tuning에 쓰는 예시가 프로덕션에서 LLM이 보는 것과 형식·형태가 미묘하게 다른 경우예요. 예를 들어 RAG 앱이면 RAG 예시를 넣고 모델을 fine-tuning해 컨텍스트를 제로샷으로 쓰는 법이 아니라 사용법을 배우게 해요.
위 전부
이 기법들은 서로 쌓여요. 초기 evals가 컨텍스트와 동작 모두 문제를 보여준다면 프로덕션 솔루션에 fine-tuning + RAG를 둘 다 낼 가능성이 커요. 이것은 괜찮고, 두 접근의 약점을 균형 잡기 위해 쌓여요. 주요 이점:
- fine-tuning으로 프롬프트 엔지니어링에 쓰는 토큰을 최소화 — 지시와 few-shot 예시를 많은 학습 예시로 대체해 모델에 일관된 동작을 심음.
- 광범위한 fine-tuning으로 복잡한 동작 교육
- RAG로 컨텍스트 주입 — 더 최신 콘텐츠나 사용 사례에 필요한 특수 컨텍스트.
이 도구들을 언어 번역 개선에 사용
위에 쓴 아이슬란드어 교정 예시를 계속 확장할게요. 다음 접근을 테스트할게요.
- 원래 가설은 이것이 동작 최적화 문제라는 것이었으므로 첫 단계로 모델 fine-tuning. 여기서 gpt-3.5-turbo와 gpt-4 둘 다 시도.
- RAG도 시도 — 이 경우 관련 예시가 추가 컨텍스트를 줘 모델이 문제를 푸는 데 도움이 될 수 있다는 가설이지만, 낮은 확신의 최적화.
Fine-tuning
사용 사례에 fine-tuning하기 위해 위 few-shot 예시와 유사한 1000개 예시 데이터셋을 사용할게요.
# One training example
SYSTEM: The following sentences contain Icelandic sentences which may include errors. Please correct these errors using as few word changes as possible.
USER: "Hið sameinaða fyrirtæki verður einn af stærstu bílaframleiðendum í heiminum."
ASSISTANT: "Hið sameinaða fyrirtæki verður einn af stærstu bílaframleiðendum heims."
이 1000개 예시로 gpt-3.5-turbo와 gpt-4 fine-tuned 모델 둘 다 학습하고 검증 세트에서 평가를 다시 실행해요. 이는 가설을 확증했어요. 둘 다 의미 있는 성능 향상을 얻었고, 심지어 3.5 모델도 few-shot gpt-4를 8점 능가했어요.
| 실행 | 방법 | BLEU 점수 |
|---|---|---|
| 1 | gpt-4 zero-shot | 62 |
| 2 | gpt-4 3개의 few-shot 예시 | 70 |
| 3 | gpt-3.5-turbo 1000개 예시 fine-tuned | 78 |
| 4 | gpt-4 1000개 예시 fine-tuned | 87 |
좋아요, 이것은 우리 사용 사례에 프로덕션 수준 정확성처럼 보이기 시작해요. 하지만 파이프라인에서 인컨텍스트 학습을 위해 프롬프트에 관련 RAG 예시를 추가해 성능을 조금 더 짜낼 수 있는지 테스트해 봅시다.
RAG + Fine-tuning
최종 최적화는 학습·검증 세트 밖의 1000개 예시를 임베딩해 벡터 데이터베이스에 넣는 것이에요. 그런 다음 gpt-4 fine-tuned 모델로 추가 테스트를 실행했는데, 다소 놀라운 결과가 나왔어요.
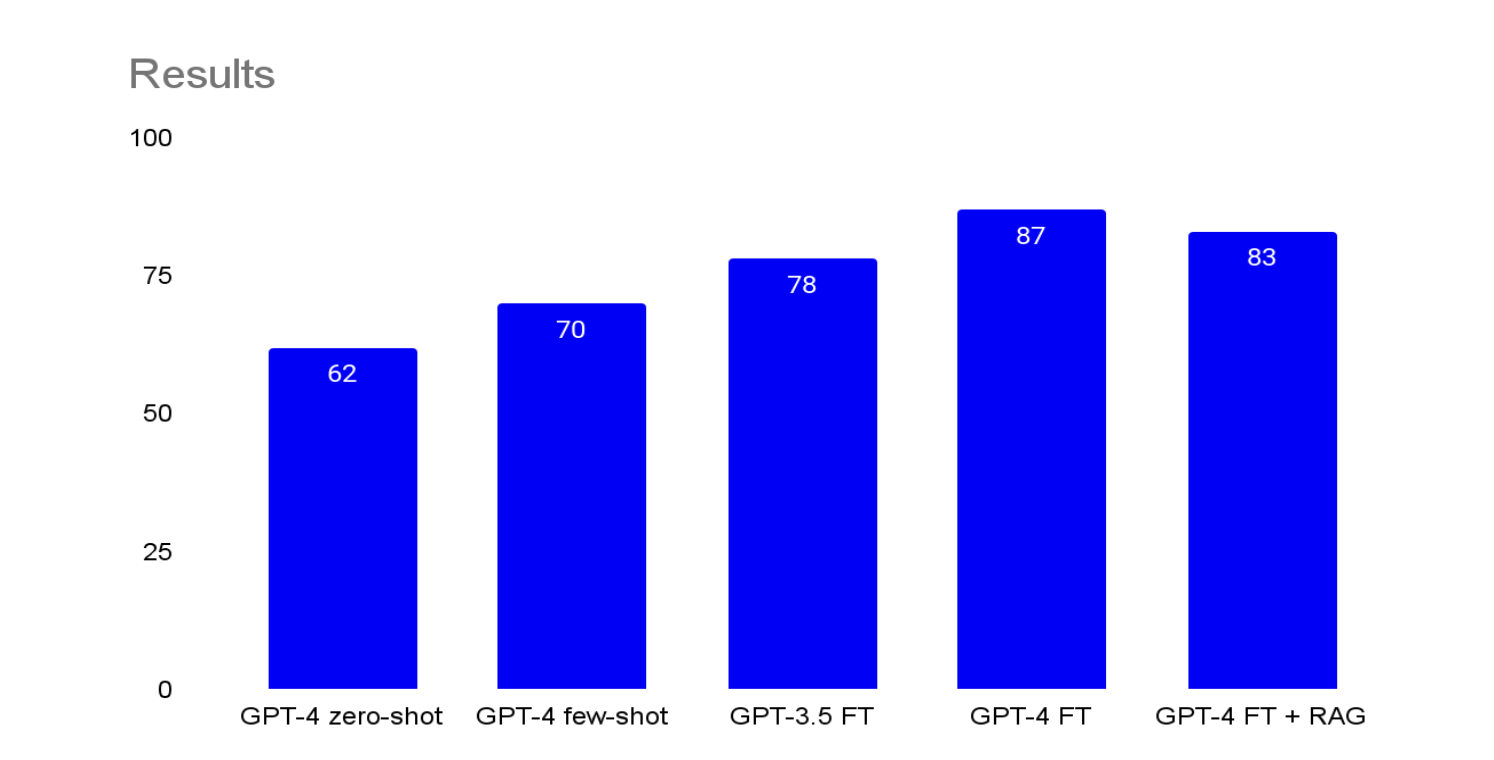 tuning 방법별 BLEU 점수 (100점 만점)
RAG는 실제로 정확성을 낮춰 GPT-4 fine-tuned 모델에서 4점 떨어져 83이 됐어요.
이것은 올바른 작업에 올바른 최적화 도구를 쓴다는 점을 보여줘요. 각각 우리가 평가와 반복 변경으로 관리하는 이점과 위험이 있어요. evals에서 관찰한 동작과 이 질문에 대해 아는 것으로부터, 이것은 추가 컨텍스트가 반드시 모델에 도움이 되지 않는 동작 최적화 문제라는 것을 알았어요. 이것은 실제로 입증됐는데, RAG는 fine-tuning으로 작업을 효과적으로 배웠을 때 추가 노이즈를 줘 모델을 혼란시켰어요.
이제 프로덕션 준비 가까이 와야 하는 모델이 있고, 더 최적화하고 싶다면 더 넓은 다양성·양의 학습 예시를 고려할 수 있어요.
이제 RAG와 fine-tuning, 각각이 언제 적절한지 이해하게 됐을 거예요. 이 도구들로 마지막으로 감사할 것은, 도입한 뒤 반복 속도에 트레이드오프가 있다는 점이에요.
- RAG는 LLM 동작뿐 아니라 검색도 조정해야 해요.
- fine-tuning은 추가 튜닝 시 fine-tuning 과정을 다시 실행하고 학습·검증 세트를 관리해야 해요.
둘 다 시간이 걸리고 복잡한 과정일 수 있어, LLM 애플리케이션이 더 복잡해지면서 회귀 문제를 도입할 수 있어요. 이 백서에서 하나만 가져간다면, 더 복잡한 RAG나 fine-tuning에 손대기 전에 기본 방법으로 가능한 한 많은 정확성을 짜내는 거예요. 정확성 목표를 목적에 두고, RAG + FT가 가장 정교해 보인다고 그것으로 뛰지 마세요.
프로덕션에 "좋은 충분한" 정확성은 얼마인가
정확성 튜닝은 LLM과의 끝없는 싸움이 될 수 있어요. 기성 방법으로 99.999% 정확성에 도달할 가능성은 낮아요. 이 섹션은 언제가 정확성에 충분인지, LLM을 프로덕션에 올리는 데 어떻게 편안해지고 배포할 솔루션의 위험을 어떻게 관리하는지에 관한 거예요.
이것을 비즈니스와 기술 컨텍스트 둘 다로 생각하는 것이 도움이 돼요. 둘 다 관리하는 높은 수준의 접근을 설명하고, 고객 서비스 헬프데스크 사용 사례로 두 경우의 위험을 어떻게 관리하는지 설명할게요.
비즈니스
규칙 기반이나 전통적 ML 시스템, 아니면 인간의 비교적 확실성 이후에 비즈니스가 LLM을 신뢰하는 것은 어려울 수 있어요. 실패가 개방형이고 예측 불가능한 시스템은 조화시키기 어려운 원이에요.
여기서 성공한 걸 본 접근은 고객 서비스 사용 사례였어요. 우리는 다음을 했어요.
먼저 주요 성공·실패 사례를 식별하고 추정 비용을 배정해요. 이는 파일럿 성능을 바탕으로 솔루션이 절약하거나 비용이 들 가능성이 무엇인지 명확히 말하게 해줘요.
- 예를 들어 이전에 인간이 해결하던 사례를 AI가 해결하면 $20 절약.
- 사람이 하면 안 되는데 인간에게 에스컬레이션되면 $40 비용.
- 최악의 경우 고객이 AI에 너무 답답해 이탈(churn)하면 $1000 비용. 5% 사례에서 발생한다고 가정.
| 이벤트 | 값 | 사례 수 | 총 값 |
|---|---|---|---|
| AI 성공 | +20 | 815 | $16,300 |
| AI 실패 (에스컬레이션) | -40 | 175.75 | $7,030 |
| AI 실패 (이탈) | -1000 | 9.25 | $9,250 |
| 결과 | +20 | ||
| 손익분기 정확성 | 81.5% |
우리가 한 다른 것은 이 과정 주변의 경험적 통계를 측정해 솔루션의 거시적 영향을 측정하는 도움을 준 것이에요. 다시 고객 서비스를 쓰면, 이럴 수 있어요.
- 순수 인간 상호작용 vs AI의 CSAT 점수
- 소급 검토된 사례의 인간 vs AI 결정 정확성
- 인간 vs AI의 해결까지 시간
고객 서비스 예시에서 이것은 명확한 데이터를 얻기 위해 몇 번의 파일럿 후 두 가지 핵심 결정을 내리는 데 도움이 됐어요.
- LLM 솔루션이 원한 것보다 인간에게 더 많이 에스컬레이션해도 기존 솔루션보다 막대한 운영 비용 절약을 만들었어요. 따라서 그 15%가 주로 조기 에스컬레이션이라면 85%의 정확성도 괜찮을 수 있어요.
- 사기 사례가 잘못 해결되는 것처럼 실패 비용이 매우 높은 곳에서는 인간이 주도하고 AI가 어시스턴트로 기능하기로 결정했어요. 이 경우 결정 정확성 통계가 완전 자율성에 편안하지 않다는 판단을 내리게 했어요.
기술
기술적 측면은 더 명확해요. 비즈니스가 기대하는 가치와 잘못될 수 있는 것의 비용에 대해 명확해졌으니, 사용자 경험을 방해하지 않는 방식으로 실패를 우아하게 처리하는 솔루션을 만드는 것이 여러분의 역할이에요.
고객 서비스 예시로 한 번 더 설명할게요. 의도를 결정하는 데 85% 정확한 모델이 있다고 가정해요. 기술 팀으로서 잘못된 15%의 영향을 최소화하는 몇 가지 방법:
- 모델을 프롬프트 엔지니어링해 확신이 없으면 고객에게 더 많은 정보를 요청하게 할 수 있어요. 첫 시도 정확성은 떨어질 수 있지만 의도 결정에 2번의 기회가 주어지면 더 정확할 수 있어요.
- 2차 어시스턴트에 의도 결정 단계로 되돌려보낼 옵션을 줄 수 있어요. 일부 추가 사용자 지연을 희생해 UX가 자기 치유하는 방법을 다시 제공해요.
- 의도가 불명확하면 인간에게 핸드오프하도록 모델을 프롬프트 엔지니어링할 수 있어요. 단기적으로는 일부 운영 절약이 줄지만 장기적으로 고객 이탈 위험을 상쇄할 수 있어요.
그 결정들은 우리 UX로 들어가는데, 더 높은 정확성을 희생해 느려지거나, 위 비즈니스 섹션의 비용 모델에 반영되는 더 많은 인간 개입으로 이어져요.
이제 비즈니스 현실에 근거한 정확성 목표 설정에 관련된 비즈니스·기술 결정을 분해하는 접근이 생겼어요.
이것을 앞으로 가져가기
이것은 LLM 정확성을 최대화하는 것, 이를 달성하는 데 쓸 도구, 프로덕션에서 어디까지가 충분인지 결정하는 접근에 대한 높은 수준의 정신적 모델이에요. 일관되게 프로덕션에 도달하는 데 필요한 프레임워크와 도구가 생겼고, 이 방법으로 다른 사람이 이룬 것에 영감을 받고 싶다면 Morgan Stanley나 Klarna 같은 고객 스토리를 확인하세요. 이 기법을 활용하면 무엇을 이룰 수 있는지 보여줘요.
행운을 빌어요. 여러분이 이것으로 무엇을 만들지 기대돼요!
더 알아보기 (Learn more)
관련 문서: 프롬프트 엔지니어링, 모델 최적화, Evals 가이드를 함께 보면 좋아요.