
지연 시간 최적화
지연 시간 최적화 (Latency optimization)
이 가이드는 광범위한 LLM 관련 사용 사례에서 지연 시간을 개선하는 데 적용할 수 있는 핵심 원칙들을 다뤄요. 이 기법들은 프로덕션 애플리케이션을 만든 다양한 고객·개발자와의 작업에서 나온 것이므로, 세밀한 워크플로든 종단 간 채팅 애플리케이션이든 무엇을 만들든 적용돼요.
출처: 문서
본문
개별 기법이 많지만, 이 가이드는 지연 시간 개선 접근의 상위 분류를 나타내는 일곱 가지 원칙으로 묶었어요.
마지막에는 예시를 통해 어떻게 적용하는지 살펴볼게요.
일곱 가지 원칙
- 토큰을 더 빠르게 처리하세요.
- 더 적은 토큰을 생성하세요.
- 입력 토큰을 더 적게 사용하세요.
- 요청을 더 적게 만드세요.
- 병렬화하세요.
- 사용자가 덜 기다리게 하세요.
- LLM을 기본값으로 두지 마세요.
토큰을 더 빠르게 처리하기
인퍼런스 속도는 지연 시간을 다룰 때 가장 먼저 떠오르는 것이겠지만(곧 알게 되겠지만 훨씬 유일한 것은 아니에요), LLM이 토큰을 처리하는 실제 속도를 말하며 종종 TPM(분당 토큰)이나 TPS(초당 토큰)로 측정해요.
인퍼런스 속도에 영향을 주는 주요 요인은 모델 크기예요. 작은 모델은 보통 더 빠르고(저렴하고) 올바르게 사용하면 큰 모델을 능가할 수도 있어요. 작은 모델로 고품질 성능을 유지하려면:
- 더 길고 상세한 프롬프트 사용,
- (더 많은) few-shot 예시 추가,
- fine-tuning / distillation을 시도할 수 있어요.
또한 Predicted outputs 같은 인퍼런스 최적화를 쓸 수 있어요. Predicted outputs는 코드 편집 작업처럼 출력의 대부분을 미리 알 때 생성의 지연 시간을 크게 줄여줘요. 모델에 예측을 주면 LLM은 동일하게 유지될 콘텐츠보다 실제 변경에 더 집중할 수 있어요.
인퍼런스 속도에 영향을 주는 다른 요인은 사용 가능한 컴퓨트 양과 사용하는 추가 인퍼런스 최적화예요.
대부분 이런 요인을 직접 바꿀 수는 없지만, 궁금하고 인프라를 어느 정도 제어할 수 있다면 더 빠른 하드웨어나 더 낮은 포화도로 엔진을 실행하는 것이 약간의 TPM 향상을 줄 수 있어요. 그리고 깊이 파고들고 싶다면 이 가이드 범위를 넘어서는 다양한 인퍼런스 최적화도 있어요.
더 적은 토큰 생성하기
토큰 생성은 LLM을 쓸 때 거의 항상 가장 지연 시간이 큰 단계예요. 일반적 경험칙으로 출력 토큰을 50% 줄이면 지연 시간도 약 50% 줄어들 수 있어요. 출력 크기를 줄이는 방법은 출력 유형에 따라 달라져요.
자연어를 생성한다면 모델에 더 간결하게 하라고("20단어 미만" 또는 "간단히") 요청하는 게 도움이 될 수 있어요. few-shot 예시나 fine-tuning으로 모델에게 더 짧은 응답을 가르칠 수도 있어요.
구조화된 출력을 생성한다면 가능한 한 출력 구문을 최소화하세요. 함수 이름을 줄이고, 명명된 인자를 생략하고, 파라미터를 통합하는 식이에요.
마지막으로 흔하진 않지만 max_tokens나 stop_tokens로 생성을 일찍 끝낼 수도 있어요.
기억하세요: 출력 토큰 하나의 절약은 (밀리)초 하나의 이득이에요!
입력 토큰 더 적게 사용하기
입력 토큰 수를 줄이면 지연 시간이 낮아지긴 하지만, 보통 그게 큰 요인은 아니에요. 프롬프트를 50% 줄여도 지연 시간 개선은 1–5%에 그칠 수 있어요. 정말 거대한 컨텍스트(문서, 이미지)를 다루는 게 아니라면 다른 곳에 에너지를 쓰는 게 나을 수 있어요.
그렇더라도 정말 거대한 컨텍스트를 다루거나(또는 모든 옵션을 소진했는데 성능을 끝까지 짜내고 싶다면) 다음 기법으로 입력 토큰을 줄일 수 있어요.
- 모델 fine-tuning, 긴 지시·예시의 필요를 대체.
- 컨텍스트 입력 필터링, RAG 결과 가지치기, HTML 정리 등.
- 공유 프롬프트 접두사 최대화, 동적 부분(예: RAG 결과와 히스토리)을 프롬프트 뒤쪽에 두기. 이렇게 하면 요청이 대부분 LLM 제공자가 쓰는 KV cache에 더 친화적이 되고 각 요청에서 처리되는 입력 토큰이 줄어요.
프롬프트 캐싱이 어떻게 작동하는지 문서를 확인해 보세요.
요청 더 적게 만들기
요청을 할 때마다 왕복 지연 시간이 발생하고, 이는 쌓일 수 있어요.
LLM이 수행할 순차적 단계가 있다면 단계마다 요청을 하나씩 쏘는 대신 단일 프롬프트에 넣고 단일 응답으로 모두 받는 것을 고려하세요. 추가 왕복 지연 시간을 피하고, 여러 응답 처리의 복잡성도 줄일 수 있어요.
이를 위한 한 가지 방법은 결합된 프롬프트에서 단계를 번호 목록으로 모으고, 모델에 JSON 객체의 명명된 필드로 결과를 반환하라고 요청하는 거예요. 이렇게 하면 각 결과를 파싱하고 참조할 수 있어요.
병렬화하기
LLM으로 여러 단계를 수행할 때 병렬 처리는 강력할 수 있어요.
단계가 엄격하게 순차적이지 않다면 병렬 호출로 쪼갤 수 있어요. 셔츠 두 장은 한 장과 똑같은 시간에 마릅니다.
단계가 엄격하게 순차적이라면 그래도 **추측 실행(speculative execution)**을 활용할 수 있어요. 이는 한 결과가 다른 결과보다 가능성 높은 분류 단계(예: moderation)에서 특히 효과적이에요.
- 1단계와 2단계를 동시에 시작하세요 (예: 입력 moderation과 스토리 생성).
- 1단계 결과를 검증하세요.
- 결과가 예상과 다르면 2단계를 취소하세요 (필요하면 재시도).
1단계 추측이 맞다면 기본적으로 추가 지연 시간 없이 실행한 셈이에요!
사용자가 덜 기다리게 하기
기다리는 것과 진행이 일어나는 것을 지켜보는 것 사이에는 엄청난 차이가 있어요. 사용자가 후자를 경험하게 하세요. 몇 가지 기법:
- 스트리밍: 가장 효과적인 방법으로, 기다리는 시간을 1초 이하로 줄여요. (각 응답이 끝날 때까지 아무것도 안 보였다면 ChatGPT는 꽤 다르게 느껴질 거예요.)
- 청킹: 출력이 사용자에게 보여지기 전에 추가 처리(moderation, 번역)가 필요하다면 한꺼번에 처리하는 대신 청크 단위로 처리하는 걸 고려하세요. 백엔드로 스트리밍한 뒤 처리된 청크를 프론트엔드로 보내는 방식으로요.
- 단계 보여주기: 여러 단계를 밟거나 도구를 쓰면 사용자에게 그걸 표시하세요. 실제 진행 상황을 더 많이 보여줄수록 좋아요.
- 로딩 상태: 스피너와 진행 바가 큰 도움이 돼요.
단계 보여주기·로딩 상태가 대개 심리적 효과인 반면, 스트리밍·청킹은 앱+사용자 시스템을 고려하면 실제로 전체 지연 시간을 줄여요. 사용자가 응답을 더 일찍 다 읽게 되니까요.
LLM을 기본값으로 두지 마세요
언어 모델은 강력하고 다재다능해서, 더 빠른 고전적 방법이 더 적절한 경우에도 쓰이는 때가 있어요. 그런 경우를 찾아내면 지연 시간을 크게 줄일 수 있어요. 다음 예시를 고려해 보세요.
- 하드코딩: 출력이 매우 제약적이라면 생성에 LLM이 필요 없을 수 있어요. 작업 확인, 거절 메시지, 표준 입력 요청은 모두 하드코딩하기 좋은 후보예요. (각각에 대해 몇 가지 변형을 만드는 옛날 방식도 쓸 수 있어요.)
- 사전 계산: 입력이 제약적이면(예: 카테고리 선택) 여러 응답을 미리 생성해 두고 같은 응답을 사용자에게 두 번 보여주지 않기만 하면 돼요.
- UI 활용: 요약 지표, 리포트, 검색 결과는 때로 LLM 생성 텍스트보다 클래식한 맞춤 UI 컴포넌트로 전달하는 게 나아요.
- 전통적 최적화 기법: LLM 애플리케이션도 여전히 애플리케이션이에요. 이진 탐색, 캐싱, 해시 맵, 런타임 복잡성은 언어 모델의 세계에서도 여전히 유용해요.
예시
이제 샘플 애플리케이션을 보고 잠재적 지연 시간 최적화를 식별하고 해결책을 제안해 볼게요.
실제 프로덕션 애플리케이션에서 영감을 받은 가상의 고객 서비스 봇을 분석할 거예요. 아키텍처와 프롬프트 섹션이 배경을 설정하고, 분석과 최적화 섹션이 지연 시간 최적화 과정을 다룰 거예요.
이 예시가 모든 원칙을 다루지 않는 것처럼, 실제 사용 사례도 모든 기법을 적용할 필요는 없어요.
아키텍처와 프롬프트
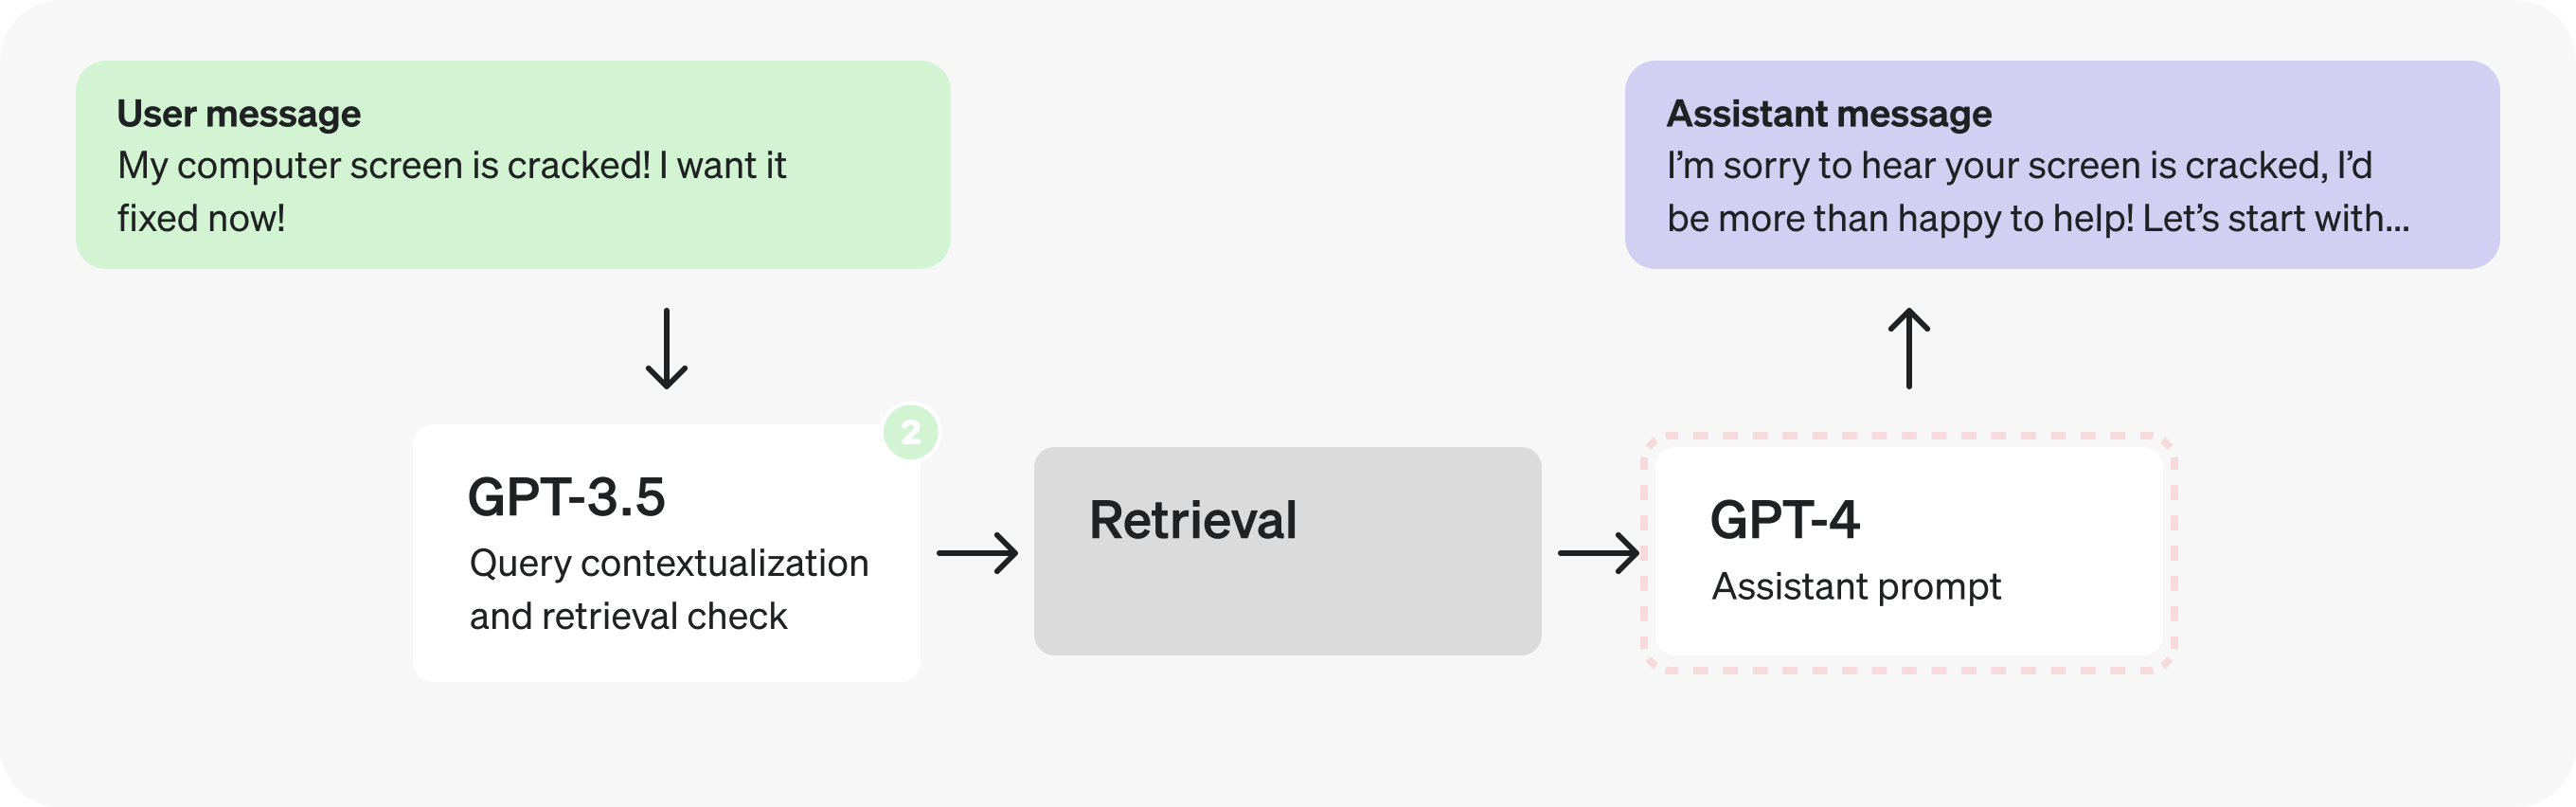
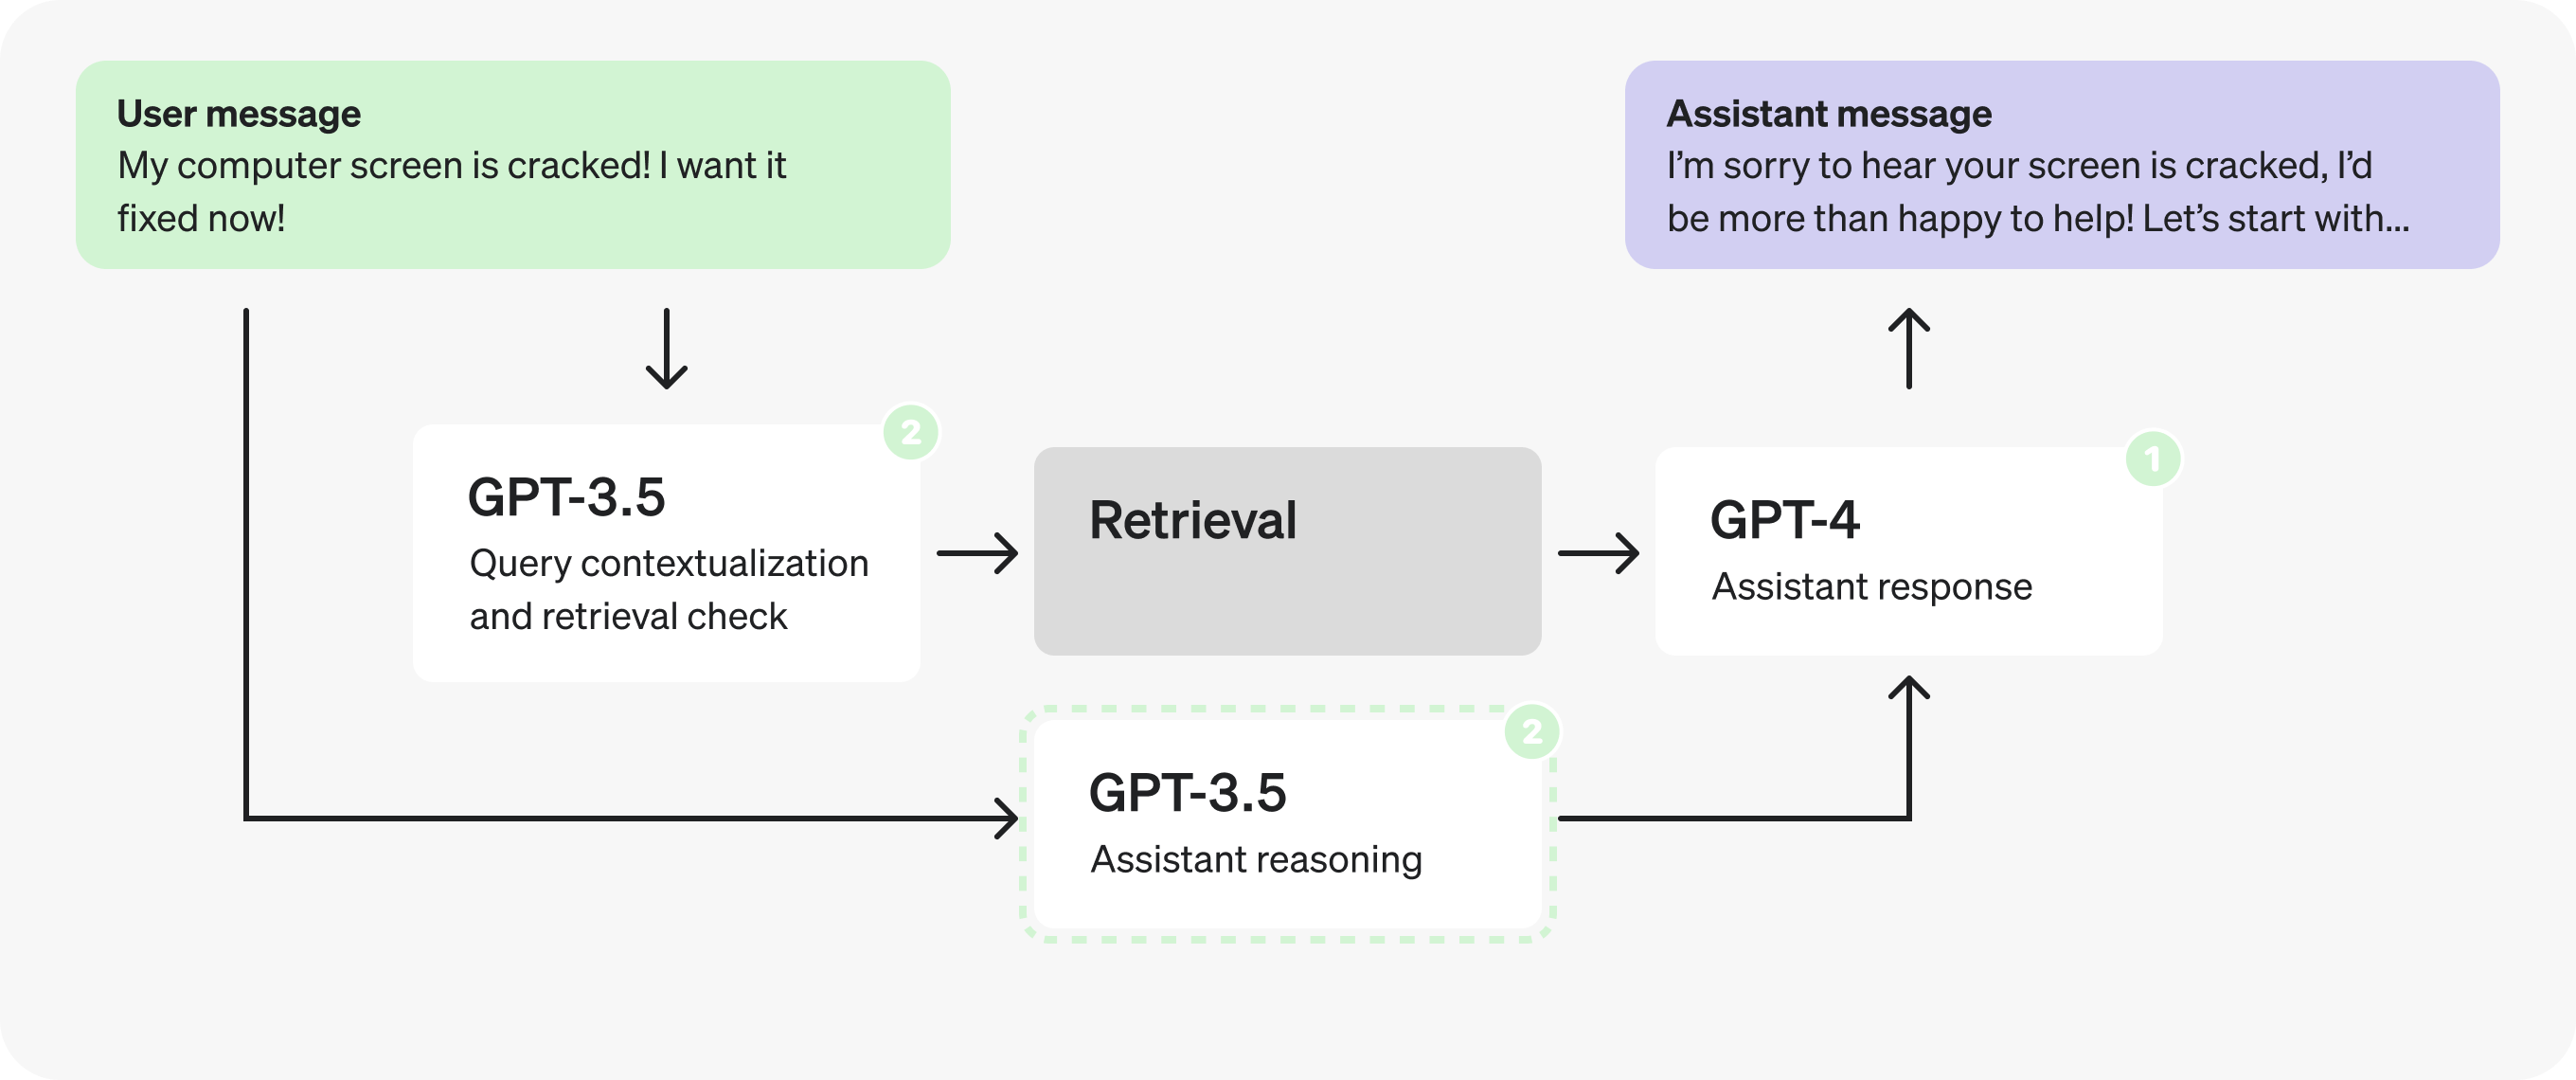
다음은 가상의 고객 서비스 봇의 초기 아키텍처예요. 우리가 바꿀 대상이에요.
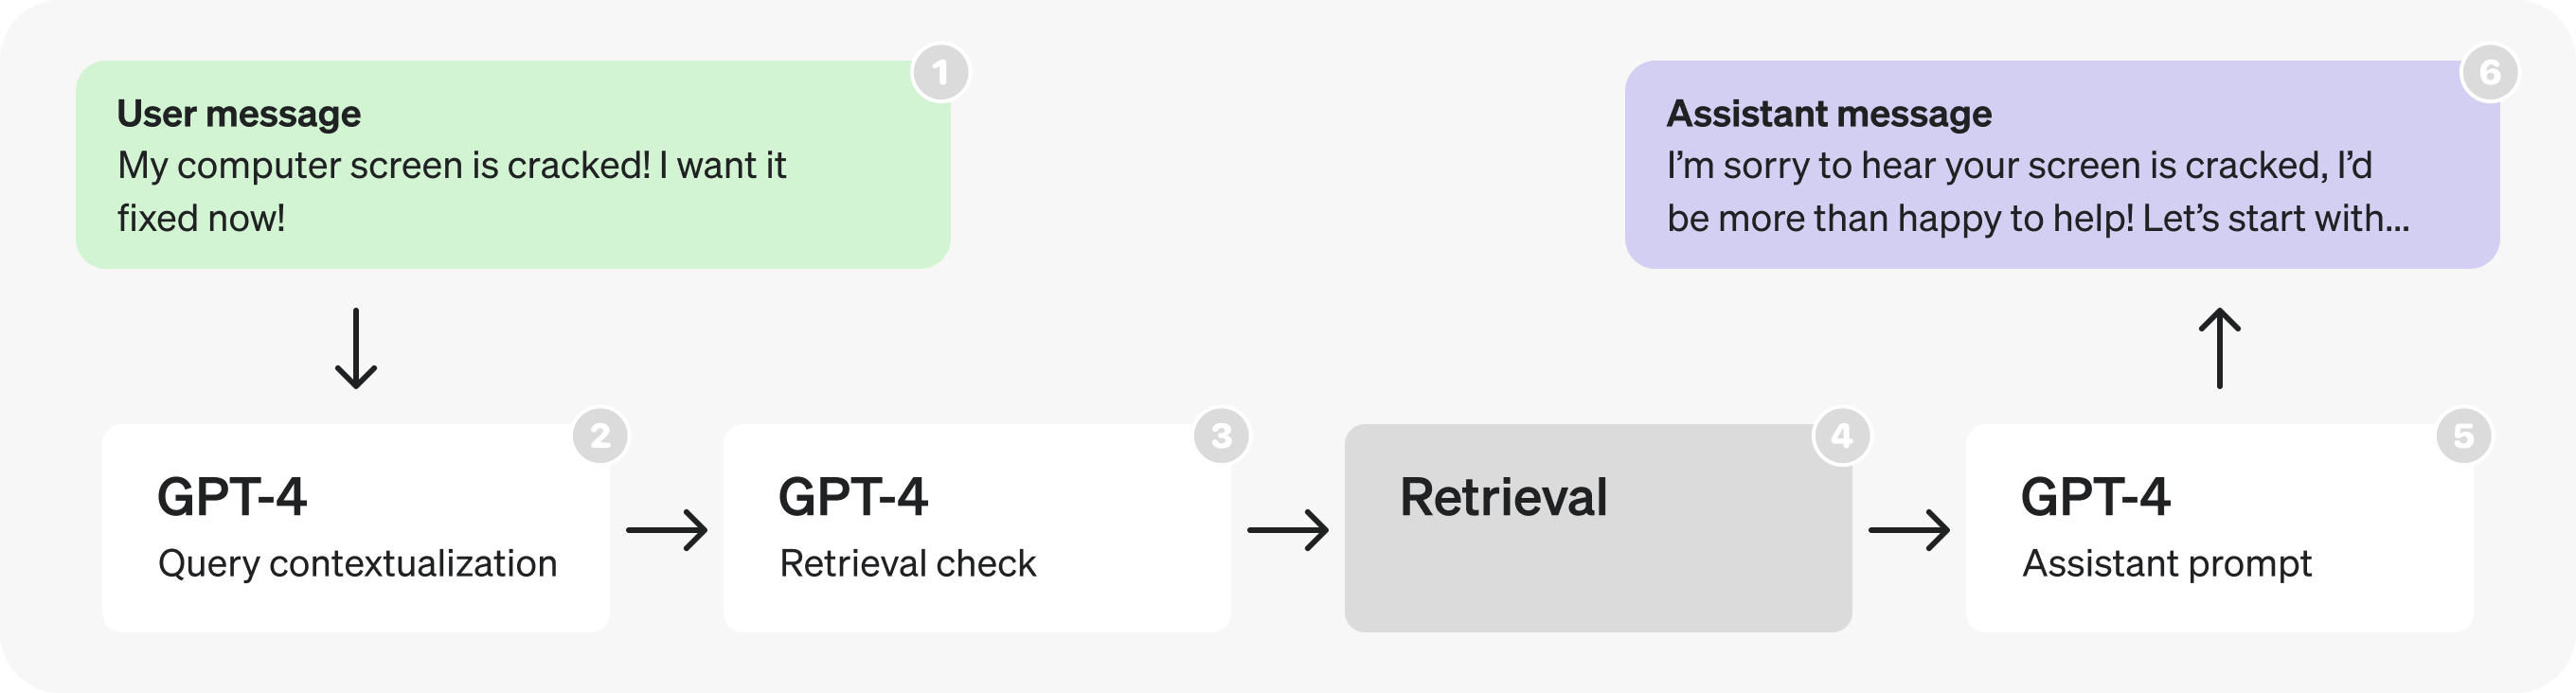
높은 수준에서 다이어그램 흐름은 다음 프로세스를 설명해요.
- 사용자가 진행 중인 대화의 일부로 메시지를 보냅니다.
- 마지막 메시지가 **자립형 쿼리(self-contained query)**로 변환됩니다 (프롬프트 예시 참고).
- 해당 쿼리에 답하려면 (가져온) 추가 정보가 필요한지 판단합니다.
- **검색(retrieval)**을 수행해 검색 결과를 만듭니다.
- 어시스턴트가 사용자 쿼리와 검색 결과를 추론하고 응답을 생성합니다.
- 응답이 사용자에게 돌아갑니다.
다음은 다이어그램의 각 부분에서 쓰는 프롬프트예요. 여전히 가상이고 단순화됐지만, 프로덕션 애플리케이션에서 찾을 수 있는 것과 같은 구조와 표현으로 작성됐어요.
"[user input here]" 같은 플레이스홀더는 런타임에 실제 데이터로 대체될 동적 부분을 나타내요.
쿼리 컨텍스트화 프롬프트
사용자 쿼리를 자립형 검색 쿼리로 다시 씁니다.
SYSTEM: Given the previous conversation, re-write the last user query so it contains
all necessary context.

# Example
History: [{user: "What is your return policy?"},{assistant: "..."}]
User Query: "How long does it cover?"
Response: "How long does the return policy cover?"

# Conversation
[last 3 messages of conversation]

# User Query
[last user query]

USER: [JSON-formatted input conversation here]
검색 필요 여부 판단 프롬프트
쿼리에 답하려면 검색을 수행해야 하는지 판단합니다.
SYSTEM: Given a user query, determine whether it requires doing a realtime lookup to
respond to.

# Examples
User Query: "How can I return this item after 30 days?"
Response: "true"

User Query: "Thank you!"
Response: "false"

USER: [input user query here]
어시스턴트 프롬프트
사용자 대화와 관련 가져온 정보가 주어졌을 때, 사전 정의된 일련의 단계로 추론해 최종 응답을 생성하는 JSON의 필드를 채웁니다.
SYSTEM: You are a helpful customer service bot.

Use the result JSON to reason about each user query - use the retrieved context.

# Example

User: "My computer screen is cracked! I want it fixed now!!!"

Assistant Response:
{
  "message_is_conversation_continuation": "True",
  "number_of_messages_in_conversation_so_far": "1",
  "user_sentiment": "Aggravated",
  "query_type": "Hardware Issue",
  "response_tone": "Validating and solution-oriented",
  "response_requirements": "Propose options for repair or replacement.",
  "user_requesting_to_talk_to_human": "False",
  "enough_information_in_context": "True",
  "response": "..."
}

USER: # Relevant Information
` ` `
[retrieved context]
` ` `

USER: [input user query here]
분석과 최적화
파트 1: 검색 프롬프트 살펴보기
아키텍처를 보면 가장 먼저 눈에 띄는 것은 연속적인 GPT-4 호출이에요. 이는 잠재적 비효율을 암시하며, 종종 단일 호출이나 병렬 호출로 대체될 수 있어요.
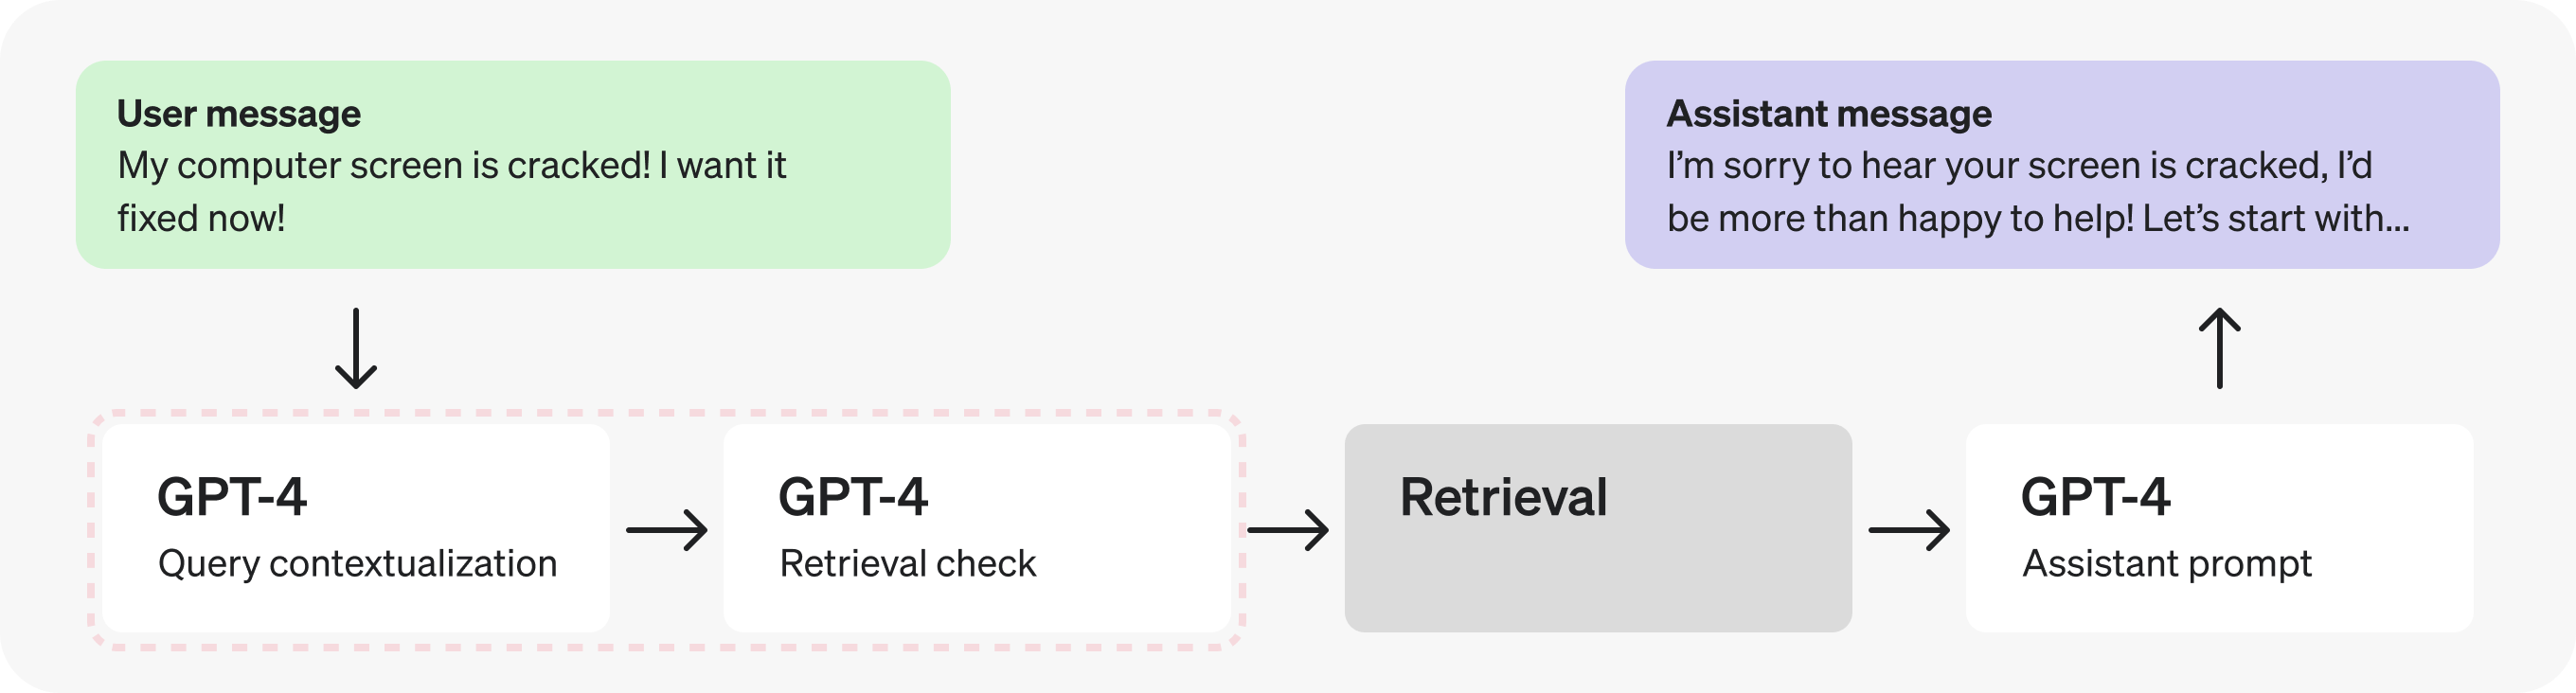
이 경우 검색 필요 판단에는 컨텍스트화된 쿼리가 필요하므로 요청을 더 적게 만들기 위해 단일 프롬프트로 결합해 봅시다.
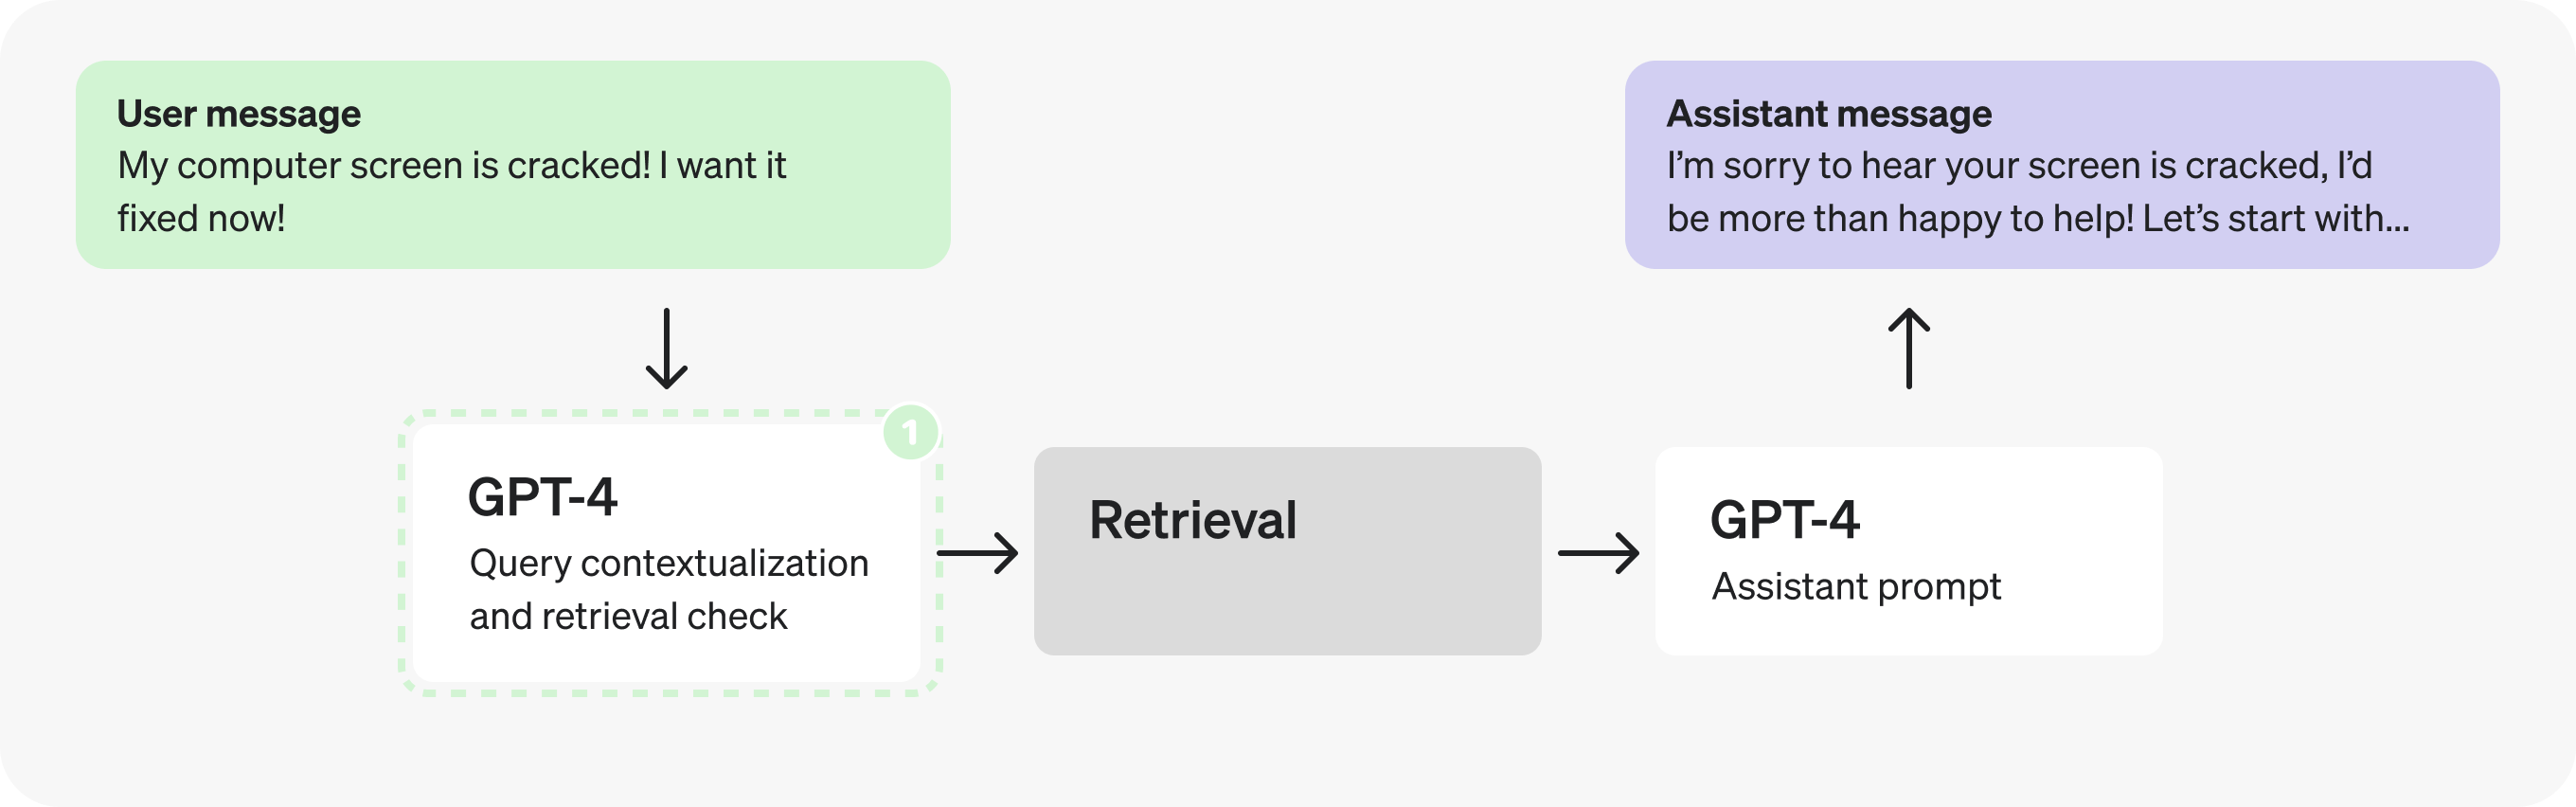
결합된 쿼리 컨텍스트화·검색 필요 판단 프롬프트
무엇이 바뀌었나요? 이전에는 쿼리를 다시 쓰는 프롬프트와 검색이 필요한지 판단하는 프롬프트가 따로 있었어요. 이제 이 결합 프롬프트가 둘 다 해요. 특히 프롬프트 첫 줄의 업데이트된 지시와 업데이트된 출력 JSON을 주목하세요.
{
  query: "[contextualized query]",
  retrieval: "[true/false - whether retrieval is required]",
}
combined_query = {
  query: "[contextualized query]",
  retrieval: "[true/false - whether retrieval is required]"
}

puts(combined_query)
SYSTEM: Given the previous conversation, re-write the last user query so it contains
all necessary context. Then, determine whether the full request requires doing a
realtime lookup to respond to.

Respond in the following form:
{
  query:"[contextualized query]",
  retrieval:"[true/false - whether retrieval is required]"
}

# Examples

History: [{user: "What is your return policy?"},{assistant: "..."}]
User Query: "How long does it cover?"
Response: {query: "How long does the return policy cover?", retrieval: "true"}

History: [{user: "How can I return this item after 30 days?"},{assistant: "..."}]
User Query: "Thank you!"
Response: {query: "Thank you!", retrieval: "false"}

# Conversation
[last 3 messages of conversation]

# User Query
[last user query]

USER: [JSON-formatted input conversation here]
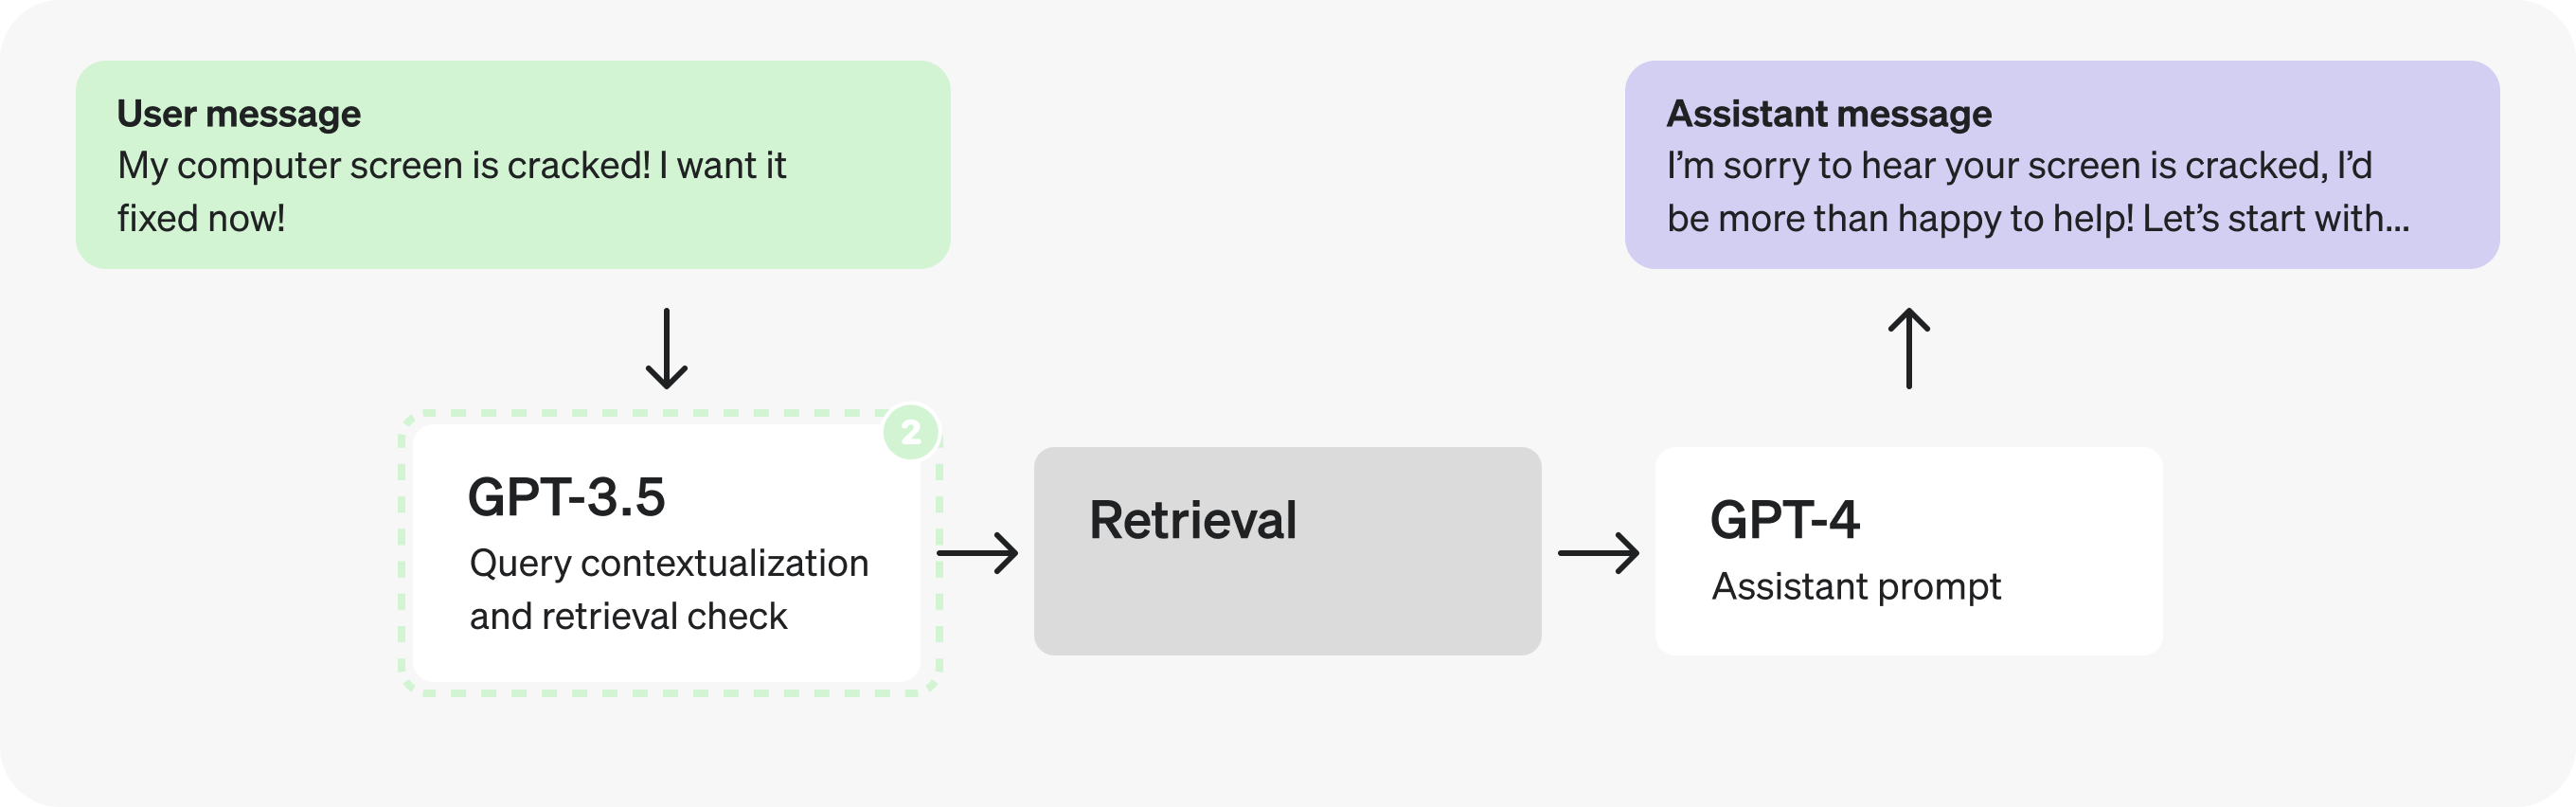
사실 컨텍스트 추가와 검색 필요 판단은 간단하고 잘 정의된 작업이므로, 더 작고 fine-tuned된 모델을 쓸 수 있을 거예요. GPT-3.5로 바꾸면 토큰을 더 빠르게 처리할 수 있어요.
파트 2: 어시스턴트 프롬프트 분석
이제 어시스턴트 프롬프트에 주목해 봅시다. JSON 필드를 채우며 많은 별개 단계가 일어나는 것 같아요. 이는 병렬화의 기회를 암시할 수 있어요.
하지만 JSON에서 추론 단계를 쪼개면 응답이 더 나빠진다는 것을 테스트로 발견했다고 가정해 봅시다. 그래서 다른 해결책을 탐색해야 해요.
GPT-4 대신 fine-tuned GPT-3.5를 쓸 수 있을까요? 아마 가능해요. 하지만 일반적으로 어시스턴트의 개방형 응답은 GPT-4에 맡기는 것이 더 넓은 사례 범위를 처리할 수 있어 좋아요. 그렇더라도 추론 단계 자체를 보면 모두 GPT-4 수준 추론이 필요한 것은 아닐 수 있어요. 잘 정의되고 범위가 제한적이라 fine-tuning의 좋은 후보가 될 수 있어요.
{
  message_is_conversation_continuation: "True", // <-
  number_of_messages_in_conversation_so_far: "1", // <-
  user_sentiment: "Aggravated", // <-
  query_type: "Hardware Issue", // <-
  response_tone: "Validating and solution-oriented", // <-
  response_requirements: "Propose options for repair or replacement.", // <-
  user_requesting_to_talk_to_human: "False", // <-
  enough_information_in_context: "True", // <-
  response: "...", // X -- benefits from GPT-4
}
assistant_response = {
  message_is_conversation_continuation: "True", # <-
  number_of_messages_in_conversation_so_far: "1", # <-
  user_sentiment: "Aggravated", # <-
  query_type: "Hardware Issue", # <-
  response_tone: "Validating and solution-oriented", # <-
  response_requirements: "Propose options for repair or replacement.", # <-
  user_requesting_to_talk_to_human: "False", # <-
  enough_information_in_context: "True", # <-
  response: "..." # X -- benefits from GPT-4
}

puts(assistant_response)
이것은 트레이드오프의 가능성을 열어요. 이것을 GPT-4가 완전히 생성하는 단일 요청으로 유지할까요, 아니면 두 개의 순차 요청으로 쪼개 최종 응답을 제외한 전부에 GPT-3.5를 사용할까요? 여기 상충하는 원칙이 있어요. 첫 옵션은 요청을 더 적게 만들기를 가능하게 하지만, 두 번째는 토큰을 더 빠르게 처리하게 할 수 있어요.
대부분의 최적화 트레이드오프처럼 답은 세부 사항에 달려 있어요. 예를 들면:
response와 다른 필드의 토큰 비율.- 대부분 필드를 더 빨리 처리함으로 인한 평균 지연 시간 감소.
- 요청 하나 대신 두 개를 하는 데서 오는 평균 지연 시간 증가.
결론은 경우마다 다르고, 가장 좋은 판단 방법은 프로덕션 예시로 테스트하는 거예요. 이 경우 테스트가 프롬프트를 둘로 쪼개 토큰을 더 빠르게 처리하는 것이 유리함을 보여줬다고 가정해 봅시다.
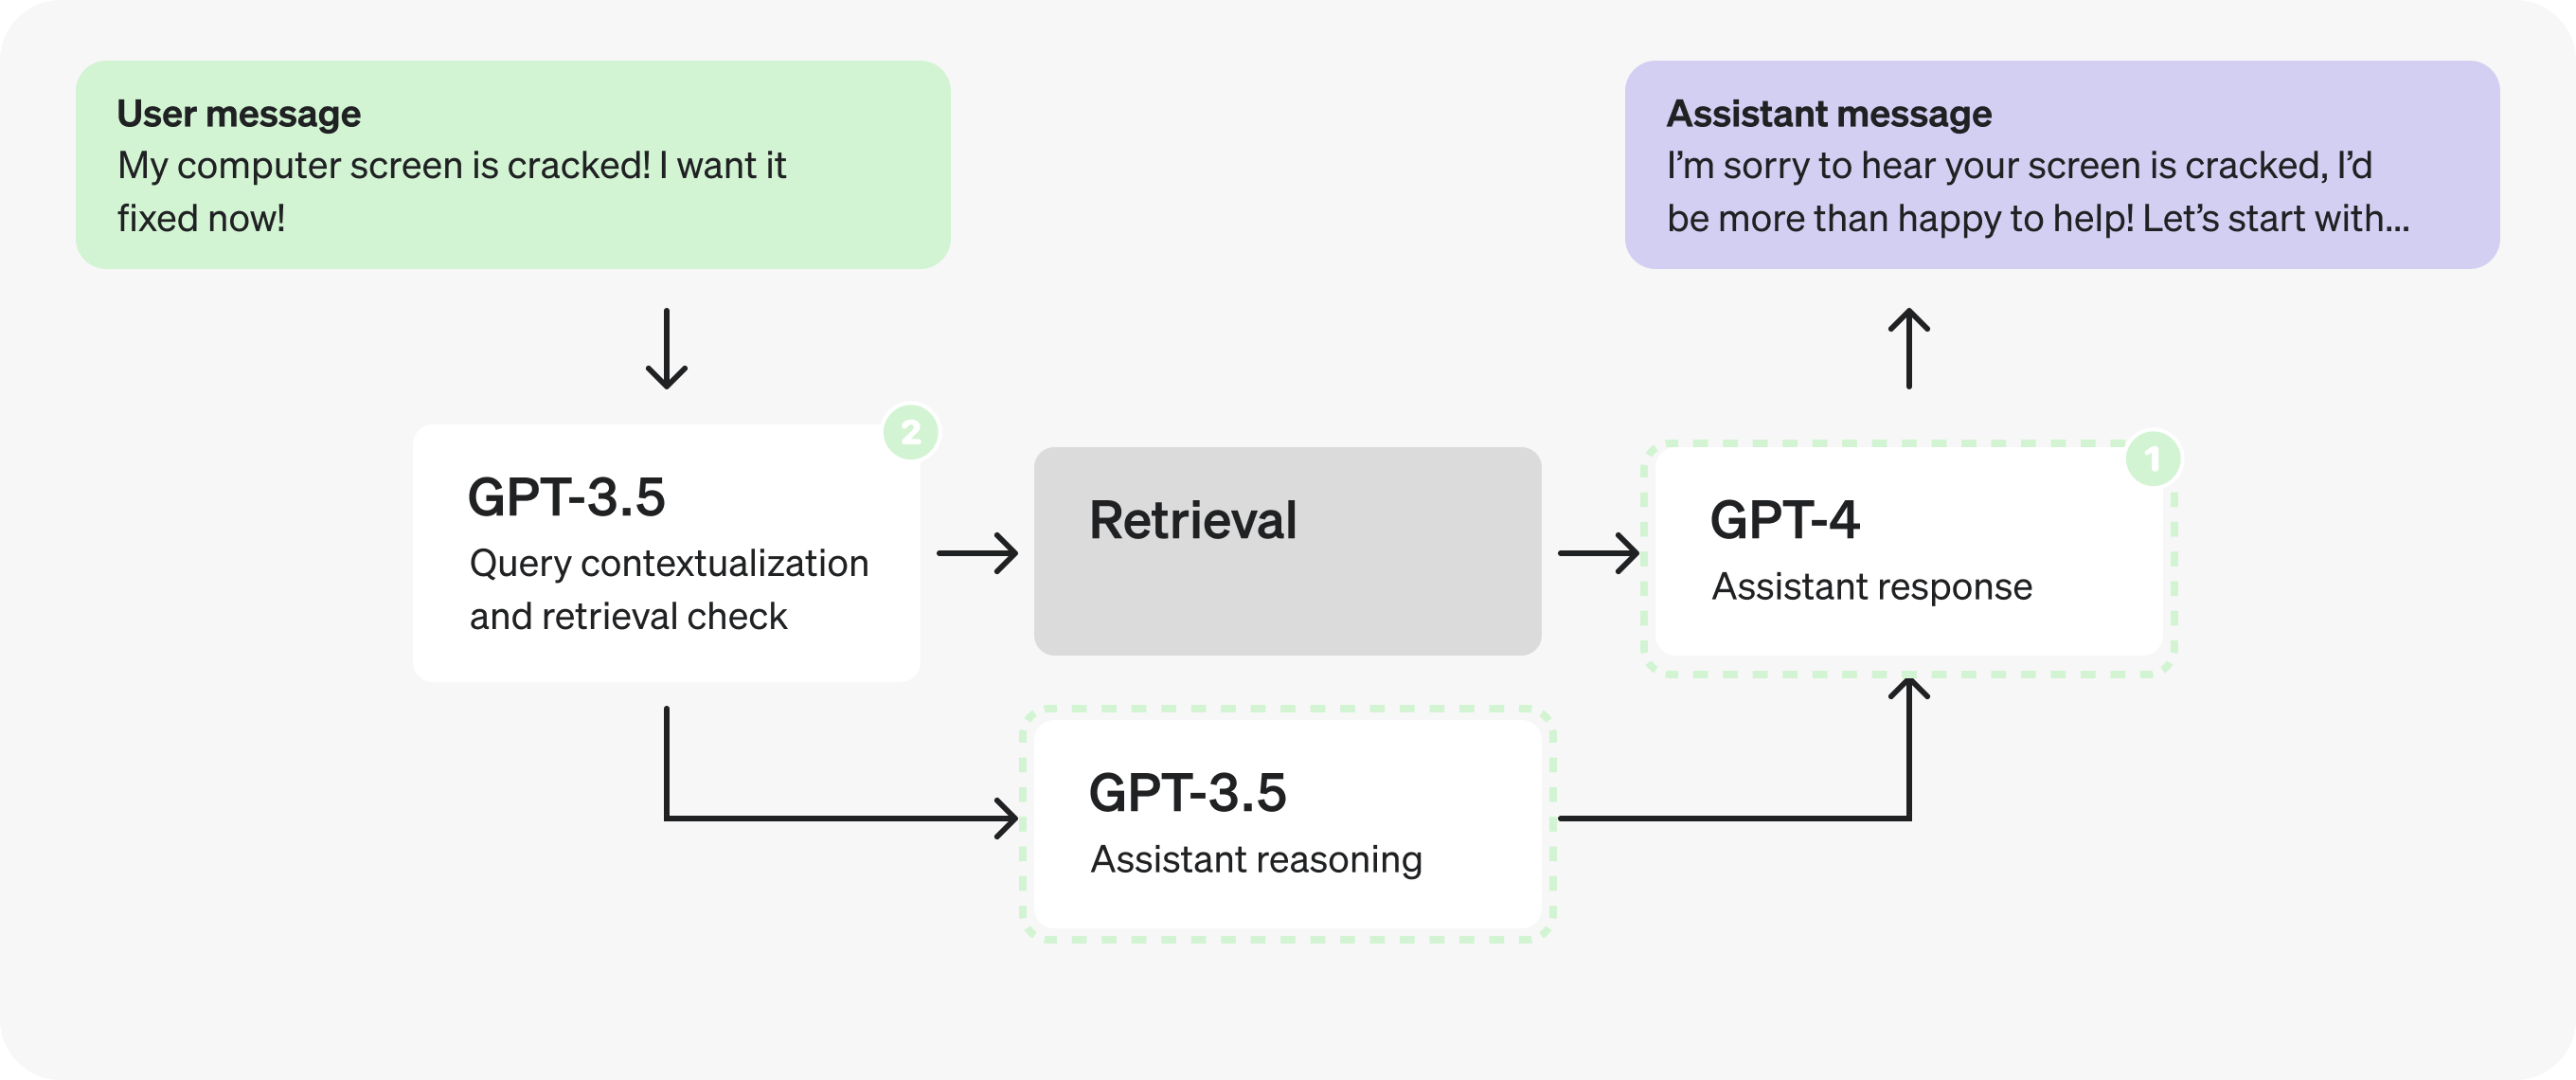
참고: 가져온 컨텍스트를 두 새 프롬프트에 모두 전달하지 않도록 두 번째 프롬프트에 response와 enough_information_in_context를 함께 묶을 거예요.
어시스턴트 프롬프트 - 추론
이 프롬프트는 GPT-3.5에 전달되며 선택된 예시로 fine-tune할 수 있어요.
무엇이 바뀌었나요? "enough_information_in_context"와 "response" 필드가 제거됐고, 검색 결과가 더 이상 이 프롬프트에 로드되지 않아요.
SYSTEM: You are a helpful customer service bot.

Based on the previous conversation, respond in a JSON to determine the required
fields.

# Example

User: "My freaking computer screen is cracked!"

Assistant Response:
{
  "message_is_conversation_continuation": "True",
  "number_of_messages_in_conversation_so_far": "1",
  "user_sentiment": "Aggravated",
  "query_type": "Hardware Issue",
  "response_tone": "Validating and solution-oriented",
  "response_requirements": "Propose options for repair or replacement.",
  "user_requesting_to_talk_to_human": "False",
}
어시스턴트 프롬프트 - 응답
이 프롬프트는 GPT-4가 처리하며 이전 프롬프트에서 결정된 추론 단계와 검색 결과를 받아요.
무엇이 바뀌었나요? "enough_information_in_context"와 "response"를 제외한 모든 단계가 제거됐어요. 추가로, 이전에 출력으로 채우던 JSON이 이 프롬프트에 전달돼요.
SYSTEM: You are a helpful customer service bot.

Use the retrieved context, as well as these pre-classified fields, to respond to
the user's query.

# Reasoning Fields
` ` `
[reasoning json determined in previous GPT-3.5 call]
` ` `

# Example

User: "My freaking computer screen is cracked!"

Assistant Response:
{
  "enough_information_in_context": "True",
  "response": "..."
}

USER: # Relevant Information
` ` `
[retrieved context]
` ` `
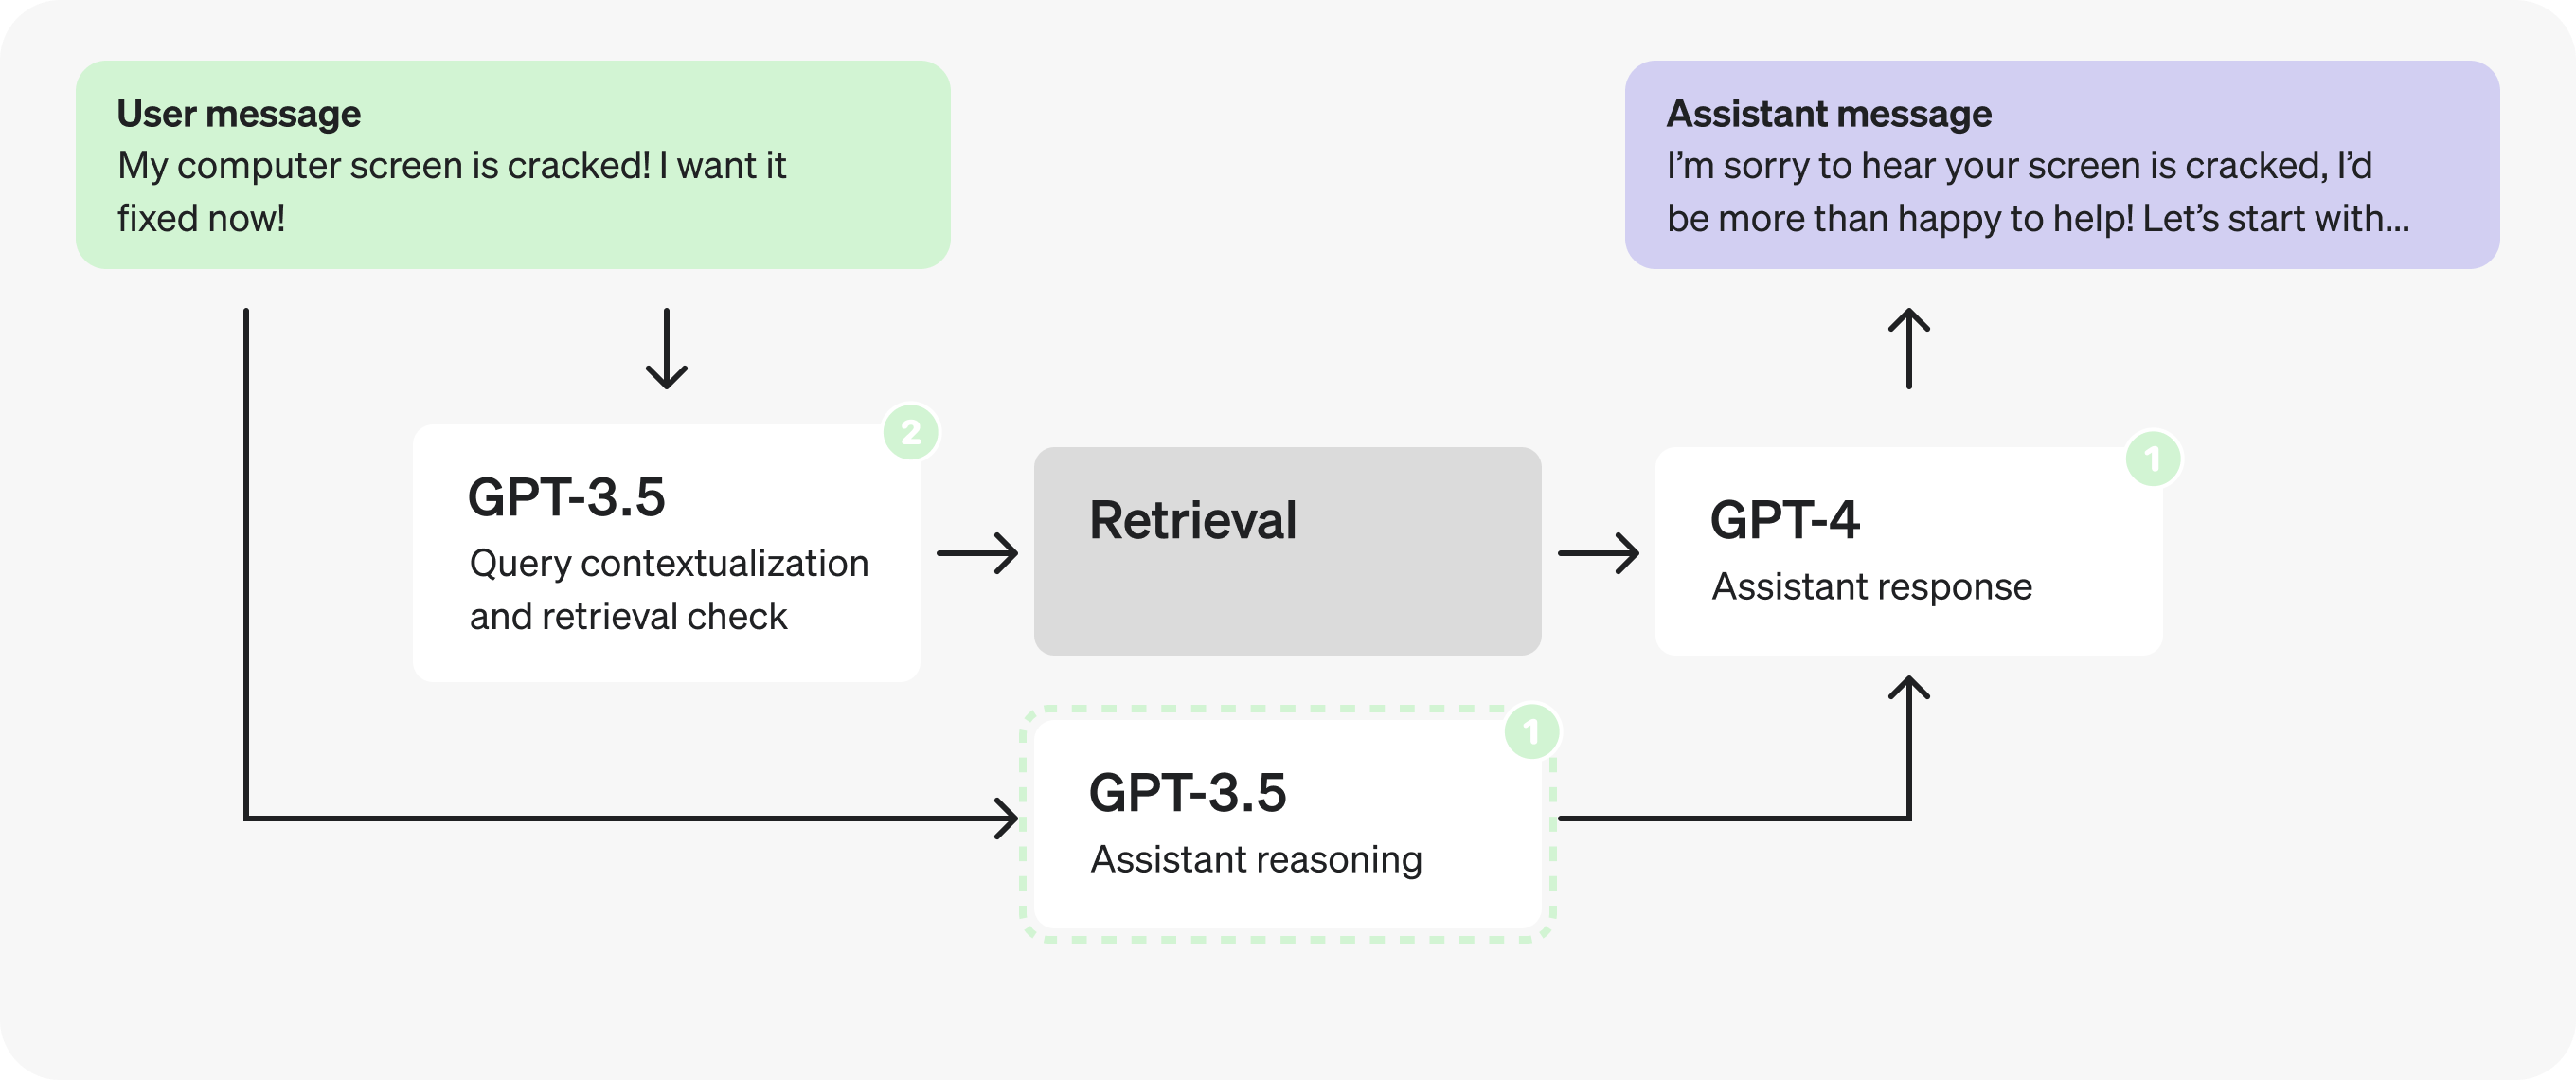
사실 이제 추론 프롬프트가 가져온 컨텍스트에 의존하지 않으므로 병렬화해서 검색 프롬프트와 동시에 쏠 수 있어요.
파트 3: 구조화된 출력 최적화
추론 프롬프트를 다시 살펴봅시다.
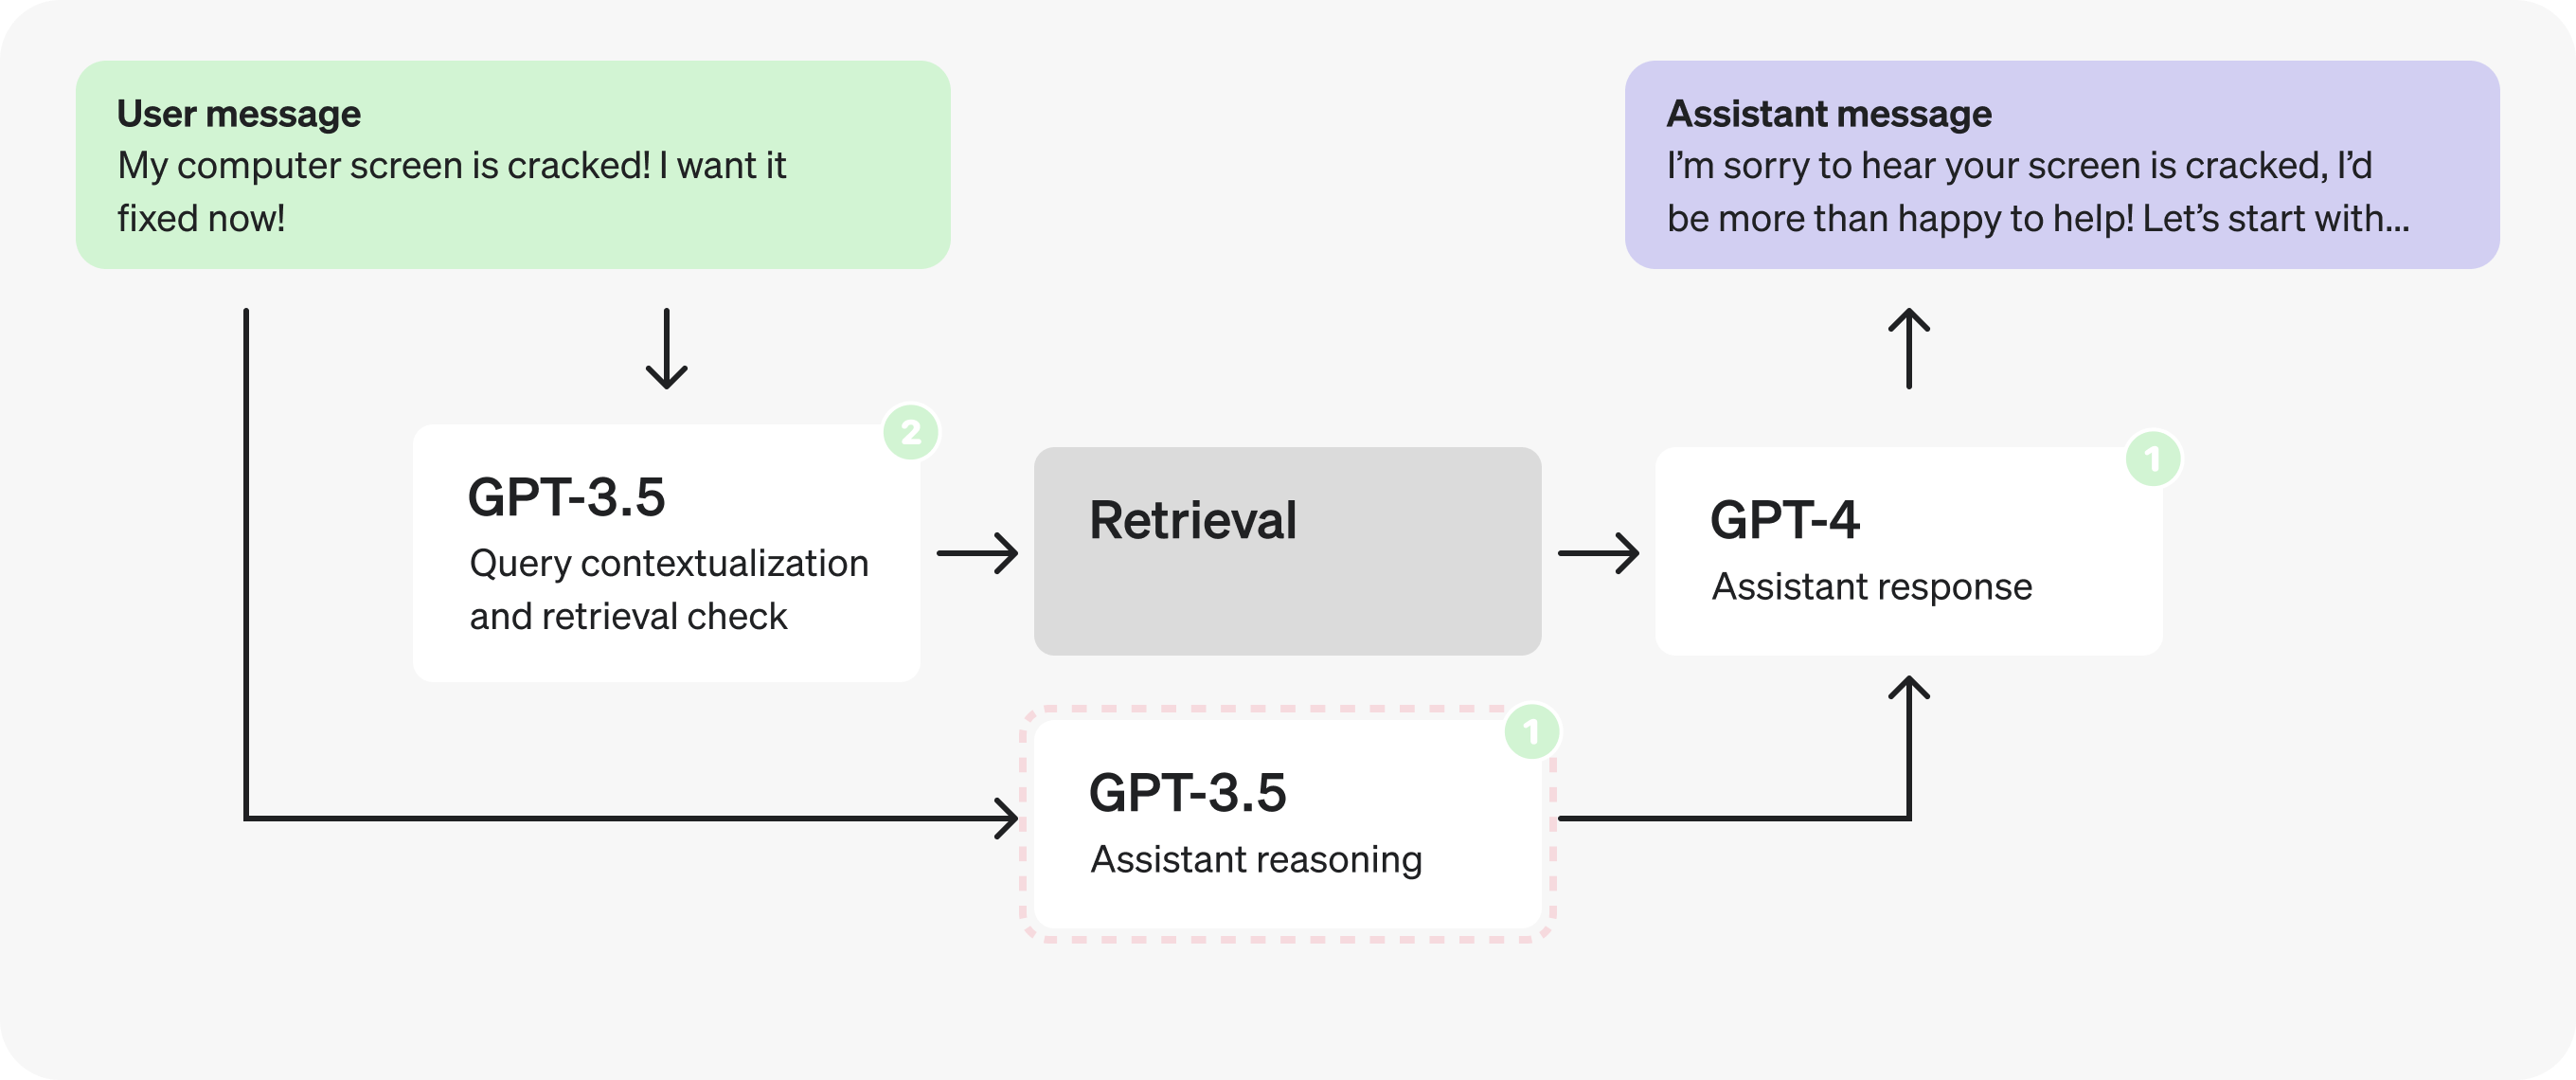
추론 JSON을 자세히 보면 필드 이름 자체가 꽤 긴 것을 알 수 있어요.
{
  message_is_conversation_continuation: "True", // <-
  number_of_messages_in_conversation_so_far: "1", // <-
  user_sentiment: "Aggravated", // <-
  query_type: "Hardware Issue", // <-
  response_tone: "Validating and solution-oriented", // <-
  response_requirements: "Propose options for repair or replacement.", // <-
  user_requesting_to_talk_to_human: "False", // <-
}
reasoning = {
  message_is_conversation_continuation: "True", # <-
  number_of_messages_in_conversation_so_far: "1", # <-
  user_sentiment: "Aggravated", # <-
  query_type: "Hardware Issue", # <-
  response_tone: "Validating and solution-oriented", # <-
  response_requirements: "Propose options for repair or replacement.", # <-
  user_requesting_to_talk_to_human: "False" # <-
}

puts(reasoning)
필드 이름을 짧게 하고 설명을 주석으로 옮기면 더 적은 토큰을 생성할 수 있어요.
{
  cont: "True", // whether last message is a continuation
  n_msg: "1", // number of messages in the continued conversation
  tone_in: "Aggravated", // sentiment of user query
  type: "Hardware Issue", // type of the user query
  tone_out: "Validating and solution-oriented", // desired tone for response
  reqs: "Propose options for repair or replacement.", // response requirements
  human: "False", // whether user is expressing want to talk to human
}
reasoning = {
  cont: "True", # whether last message is a continuation
  n_msg: "1", # number of messages in the continued conversation
  tone_in: "Aggravated", # sentiment of user query
  type: "Hardware Issue", # type of the user query
  tone_out: "Validating and solution-oriented", # desired tone for response
  reqs: "Propose options for repair or replacement.", # response requirements
  human: "False" # whether user wants to talk to a human
}

puts(reasoning)
이 작은 변경으로 19개의 출력 토큰이 제거됐어요. GPT-3.5에서는 몇 밀리초 개선에 그칠 수 있지만, GPT-4에서는 최대 1초까지 줄일 수 있어요.
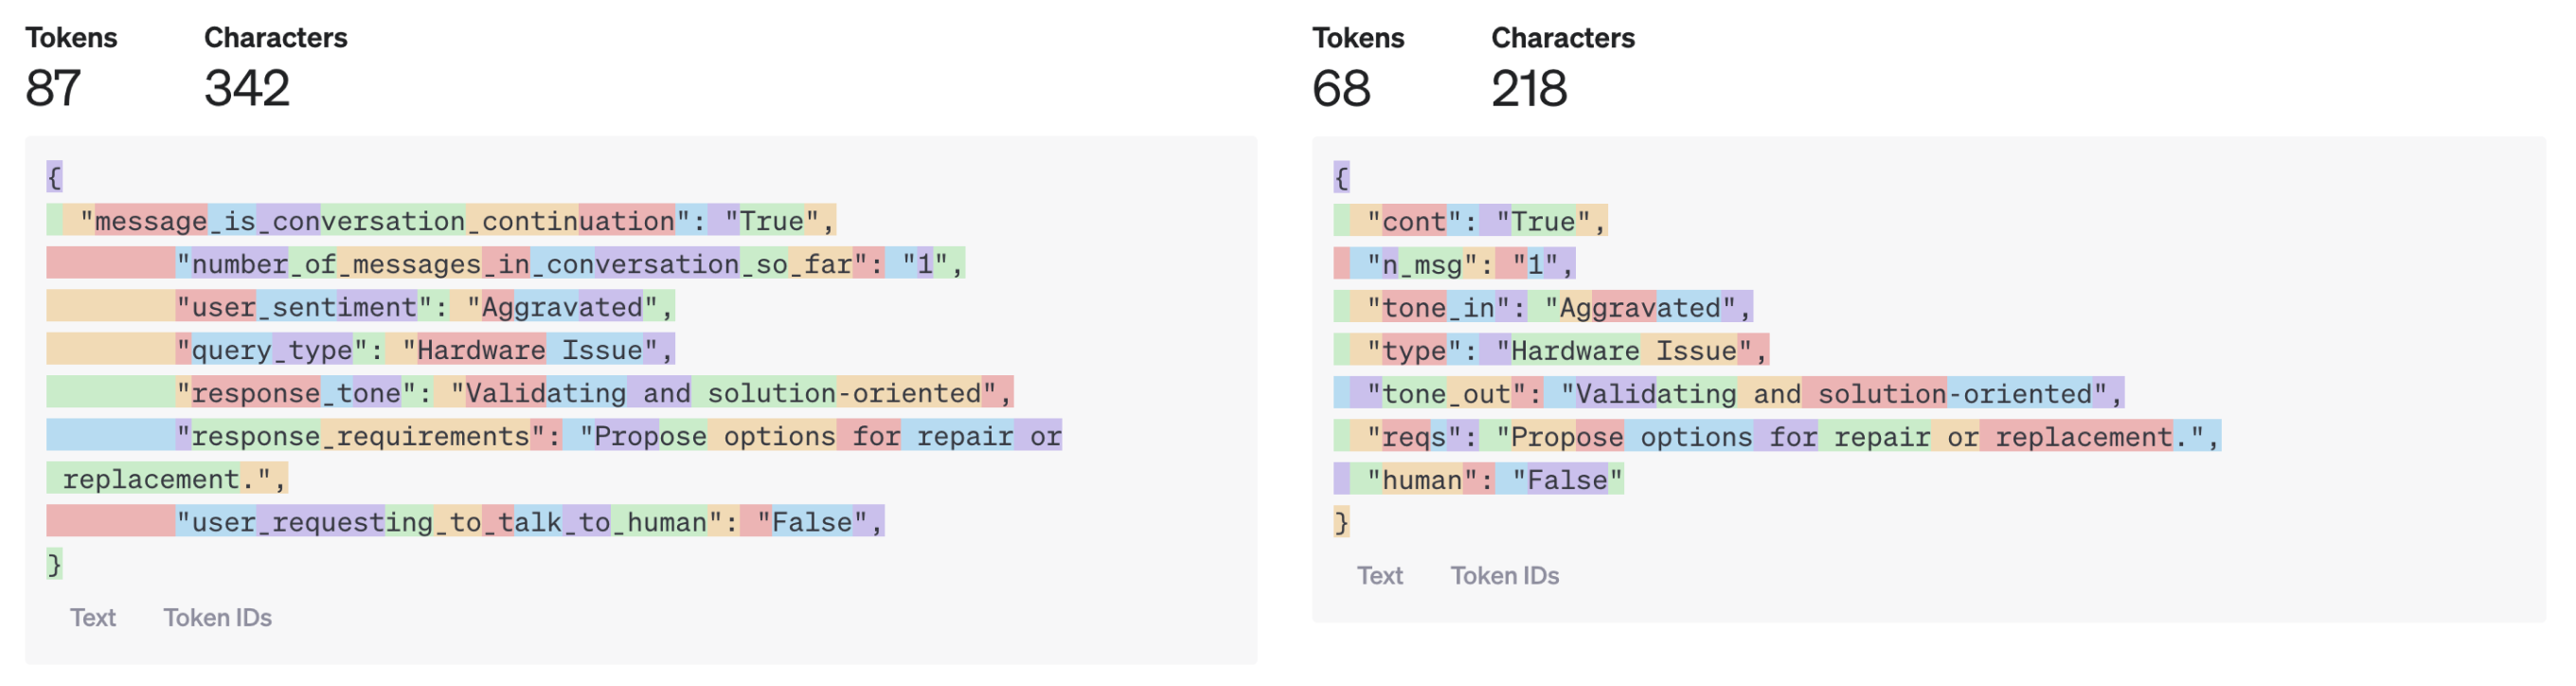
이것이 더 큰 모델 출력에는 상당한 영향을 줄 수 있다고 상상할 수 있을 거예요.
더 나아가 JSON 필드에 단일 문자를 쓰거나 모든 걸 배열에 넣을 수도 있지만, 이는 응답 품질을 해치기 시작할 수 있어요. 가장 좋은 방법은 역시 테스트를 통해 아는 거예요.
예시 정리
고객 서비스 봇 예시에서 구현한 최적화를 검토해 봅시다.
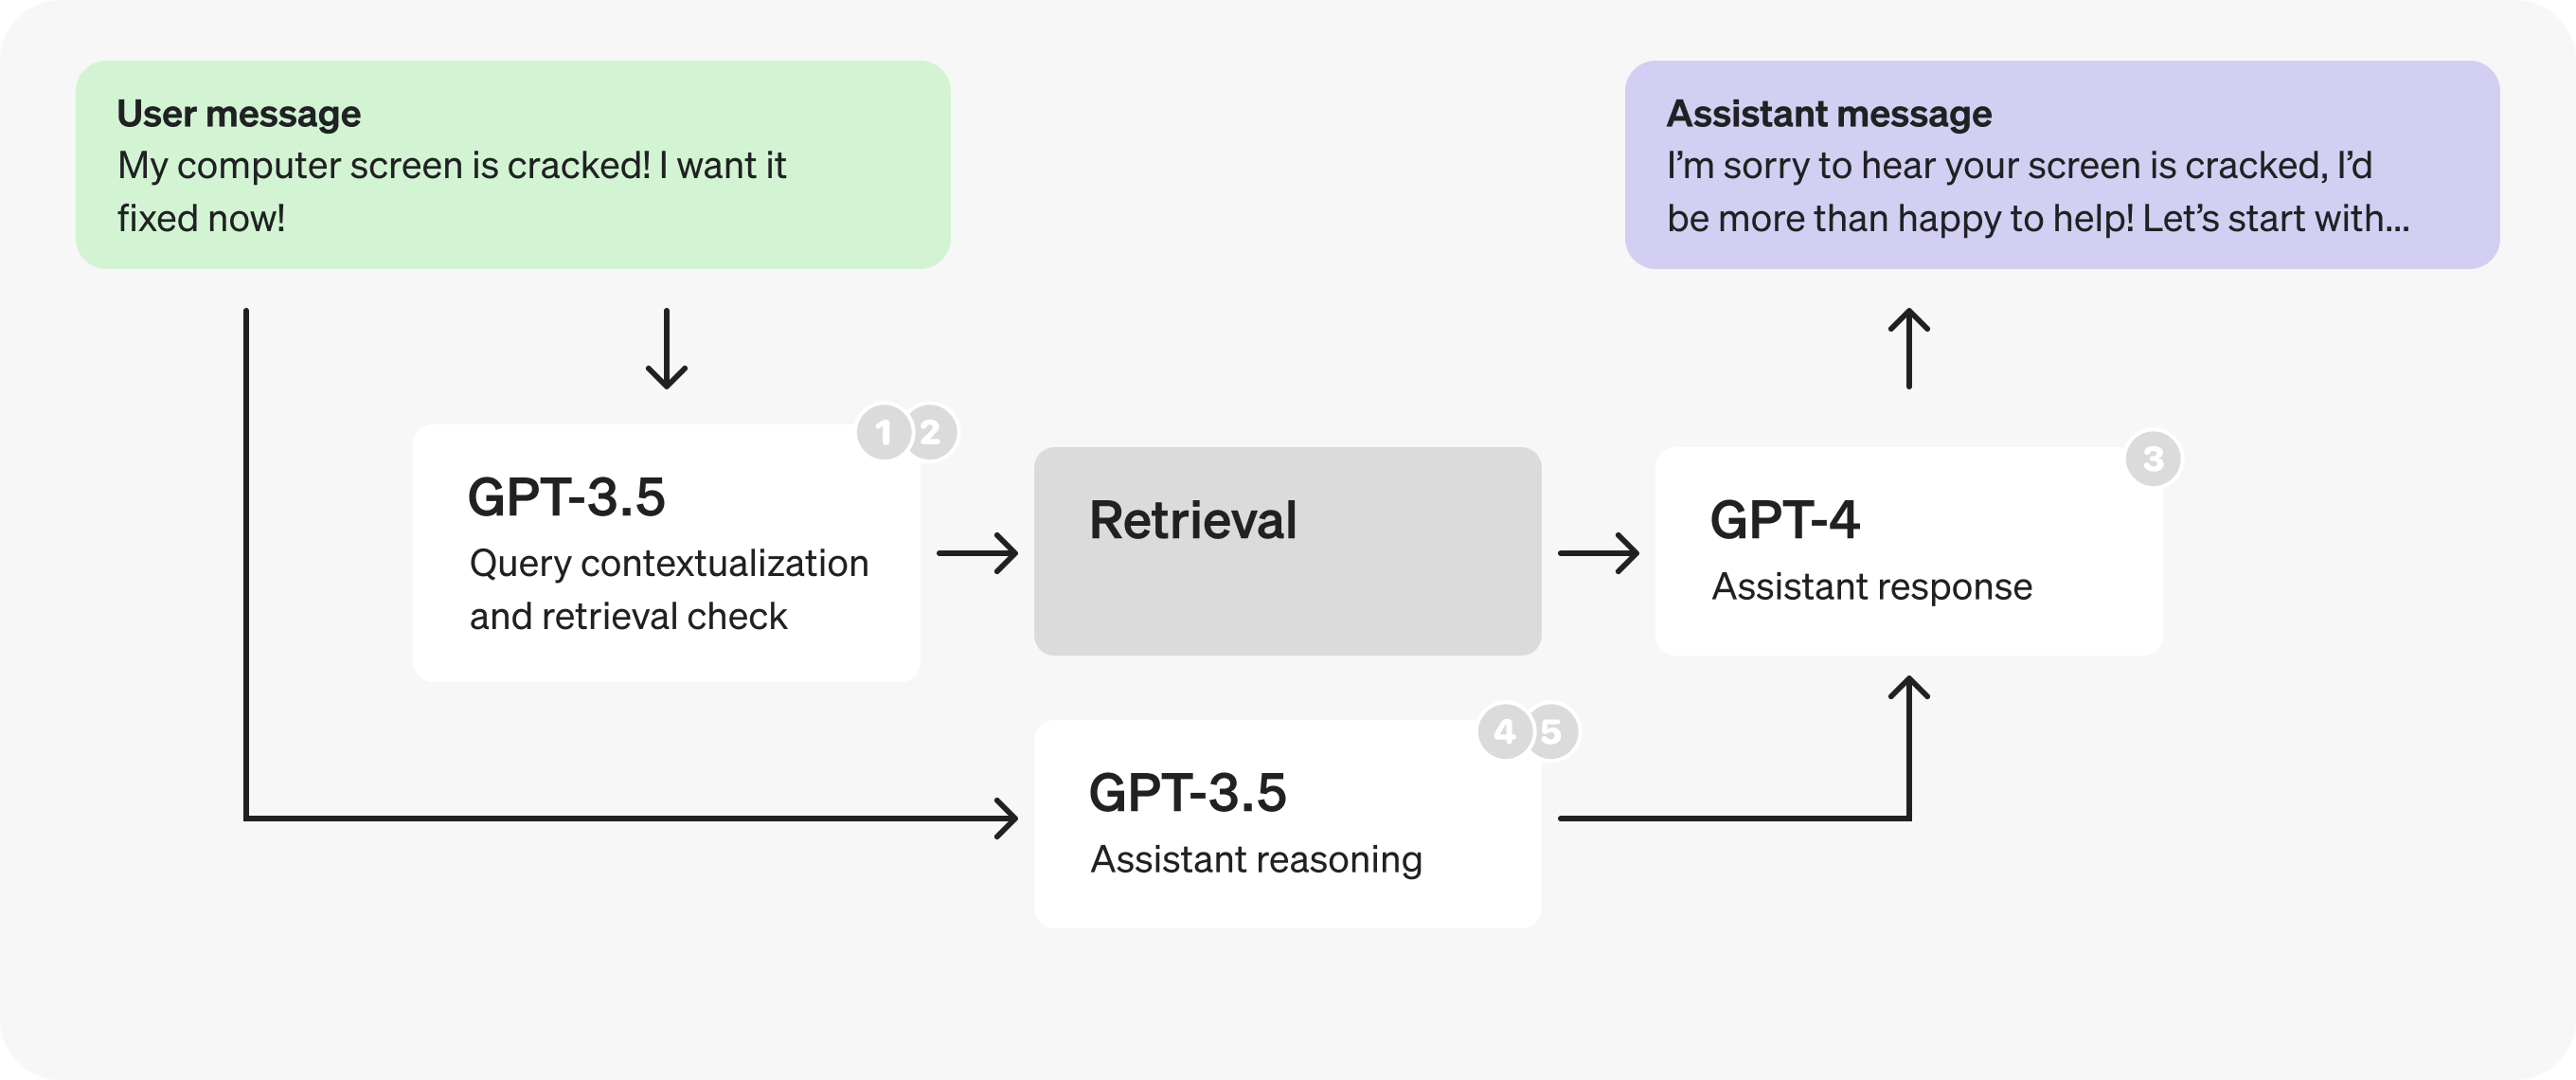
- 쿼리 컨텍스트화와 검색 필요 판단 단계를 결합해 요청을 더 적게 만들기를 달성.
- 새 프롬프트에 더 작고 fine-tuned된 GPT-3.5로 전환해 토큰을 더 빠르게 처리.
- 어시스턴트 프롬프트를 둘로 쪼개 추론에는 더 작고 fine-tuned된 GPT-3.5로 전환, 역시 토큰을 더 빠르게 처리.
- 검색 필요 판단과 추론 단계를 병렬화.
- 추론 필드 이름을 짧게 하고 설명을 프롬프트로 옮겨 더 적은 토큰을 생성.
더 알아보기 (Learn more)
관련 문서: 프롬프트 엔지니어링, 모델 최적화, Predicted outputs 가이드를 함께 보면 좋아요.