
대화 상태 관리
대화 상태 관리 (Conversation state)
OpenAI는 대화 상태를 관리하는 몇 가지 방법을 제공해요. 대화에서 여러 메시지나 턴에 걸쳐 정보를 보존하는 데 중요하죠.
GPT-5.5가 중간 업데이트를 최종 답으로 취급하는 문제를 해결할 때는, 통합이 어시스턴트 메시지의 phase 필드를 올바르게 보존하는지 확인하세요. 자세한 내용은 Phase 파라미터를 참고하세요.
출처: 문서
본문
수동으로 대화 상태 관리하기
각 텍스트 생성 요청은 독립적이고 상태가 없지만, 텍스트 생성 요청의 파라미터로 추가 메시지를 제공하면 다중 턴 대화를 구현할 수 있어요. knock-knock 농담을 생각해 보죠.
과거 대화를 수동으로 구성하는 예시를 볼게요.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input=[
        {"role": "user", "content": "knock knock."},
        {"role": "assistant", "content": "Who's there?"},
        {"role": "user", "content": "Orange."},
    ],
)

print(response.output_text)
JavaScript(client.responses.create), Go(client.Responses.New), Java(client.responses().create), C#, Ruby에서도 마찬가지로 user와 assistant 메시지를 번갈아 넣어요.
user와 assistant 메시지를 번갈아 사용하면 모델에 대한 한 번의 요청으로 대화의 이전 상태를 담을 수 있어요.
생성된 응답 간에 컨텍스트를 수동으로 공유하려면 모델의 이전 응답 출력을 입력으로 포함하고, 그 입력을 다음 요청에 추가하세요.
상태가 없는 추론 모델 요청의 경우 응답의 output 배열에 있는 모든 항목을 보존하세요. Responses API는 기본적으로 암호화된 추론 항목을 반환해요. 전체 출력을 재생하면 추론 항목과 어시스턴트 phase 값이 온전히 유지돼요. 지속 추론(persisted reasoning)을 지원하는 모델은 reasoning.context: "all_turns"를 사용해 이전 턴의 사용 가능한 추론을 다음 샘플에 렌더링할 수 있어요. 호출 간 추론 보존을 참고하세요.
아래 예시에서는 모델에게 농담을 하나 말하라고 하고, 이어서 다른 농담을 요청해요. 이런 식으로 이전 응답을 새 요청에 추가하면 대화가 자연스럽게 느껴지고 이전 상호작용의 컨텍스트가 유지돼요.
from openai import OpenAI

client = OpenAI()

history = [{"role": "user", "content": "tell me a joke"}]

response = client.responses.create(
    model="gpt-6-astra",
    input=history,
    store=False,
)

print(response.output_text)

# Add all response output items, including encrypted reasoning items, to the conversation
history += response.output

history.append({"role": "user", "content": "tell me another"})

second_response = client.responses.create(
    model="gpt-6-astra",
    input=history,
    store=False,
)

print(second_response.output_text)
OpenAI 대화 상태 API
OpenAI API는 대화 상태를 자동으로 관리하기 더 쉽게 만들어 줘서, 대화의 매 턴마다 입력을 수동으로 전달하지 않아도 돼요.
Conversations API 사용하기
Conversations API는 Responses API와 함께 동작해 대화 상태를 고유 식별자가 있는 오래 지속되는(long-running) 객체로 영속화해요. 대화 객체를 만든 뒤 세션, 기기, 작업에 걸쳐 계속 사용할 수 있어요.
Conversation은 메시지, 툴 호출, 툴 출력, 그 외 데이터가 될 수 있는 항목(items)을 저장해요.
conversation = openai.conversations.create()
다중 턴 상호작용에서 conversation을 후속 응답에 전달하면 여러 응답 항목을 직접 연결하지 않아도 상태를 유지하고 후속 응답 간에 컨텍스트를 공유할 수 있어요.
response = openai.responses.create(
    model="gpt-6-astra",
    input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],
    conversation=conversation.id,
)
이전 응답에서 컨텍스트 전달하기
대화 상태를 관리하는 또 다른 방법은 previous_response_id 파라미터로 생성된 응답 간에 컨텍스트를 공유하는 거예요. 이 파라미터로 응답을 연결하고 스레드형 대화를 만들 수 있어요.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input="tell me a joke",
)
print(response.output_text)

second_response = client.responses.create(
    model="gpt-6-astra",
    previous_response_id=response.id,
    input=[{"role": "user", "content": "explain why this is funny."}],
)
print(second_response.output_text)
아래 예시에서는 모델에게 농담을 말하라고 해요. 별도로 왜 그게 웃긴지 설명을 요청하면, 모델은 좋은 응답을 내는 데 필요한 모든 컨텍스트를 가져요.
WebSocket 모드의 previous_response_id
Responses API WebSocket 모드를 쓰고 있다면, 연속은 HTTP 모드와 같은 previous_response_id 의미론을 따르지만 영구 소켓 위에서 반복되는 response.create 이벤트로 이뤄져요.
연결 로컬 캐시가 최근 이전 응답을 메모리에 유지해 저지연 연속을 지원해요. stream_id를 쓰면 각 레인이 최신 응답을 보유할 수 있고, previous_response_id가 여전히 계보(lineage)를 제어하므로, 응답이 사용 가능한 동안 새 레인이 다른 레인의 응답에서 분기할 수 있어요. 캐시되지 않은 ID를 해석할 수 없으면 previous_response_id를 null로 설정하고 전체 입력 컨텍스트를 전달해 새 턴을 보내세요.
모델 응답의 데이터 보존
Response 객체는 기본적으로 30일 동안 저장돼요. 대시보드 logs 페이지에서 보거나 API로 retrieve 할 수 있어요. Response 생성 시 store를 false로 설정하면 이 동작을 끌 수 있어요.
Conversation 객체와 그 안의 항목은 30일 TTL의 적용을 받지 않아요. Conversation에 연결된 어떤 응답이든 그 항목이 30일 TTL 없이 영속화돼요.
OpenAI는 명시적 동의 없이 API로 보낸 데이터를 모델 학습에 사용하지 않아요. your data에서 더 알아보세요.
previous_response_id를 사용하더라도, 체인에 있는 응답의 모든 이전 입력 토큰은 API에서 입력 토큰으로 청구돼요.
컨텍스트 윈도우 관리하기
컨텍스트 윈도우를 이해하면 스레드형 대화를 만들고 모델 상호작용 간 상태를 관리하는 데 도움이 돼요.
컨텍스트 윈도우는 단일 요청에 사용할 수 있는 최대 토큰 수예요. 이 최대 토큰 수에는 입력, 출력, 추론 토큰이 포함돼요. 모델의 컨텍스트 윈도우는 model details에서 확인하세요.
텍스트 생성 컨텍스트 관리
입력이 복잡해지거나 대화에 턴을 더 많이 포함하면 출력 토큰과 컨텍스트 윈도우 한도를 모두 고려해야 해요. 모델 입력과 출력은 토큰으로 계량되는데, 입력에서 콘텐츠와 의도를 분석하기 위해 파싱되고 논리적 출력을 렌더링하기 위해 조립돼요. 모델은 텍스트 생성 요청 수명 주기 동안 토큰 사용에 한도가 있어요.
- 출력 토큰은 모델이 프롬프트에 대한 응답으로 생성하는 토큰이에요. 각 모델은 다른 출력 토큰 한도를 가져요. 예를 들어
gpt-4o-2024-08-06은 최대 16,384개의 출력 토큰을 생성할 수 있어요. - 컨텍스트 윈도우는 입력과 출력 토큰(일부 모델은 추론 토큰 포함) 양쪽에 쓸 수 있는 총 토큰을 나타내요. 모델의 컨텍스트 윈도우 한도를 비교해 보세요. 예를 들어
gpt-4o-2024-08-06은 총 128k 토큰의 컨텍스트 윈도우를 가져요.
큰 프롬프트를 만들면(보통 모델에 추가 컨텍스트, 데이터, 예시를 포함하는 방식) 모델에 할당된 컨텍스트 윈도우를 초과할 위험이 있고, 출력이 잘릴 수 있어요.
tiktoken 라이브러리로 만든 tokenizer 툴을 사용해 특정 텍스트 문자열에 토큰이 몇 개인지 확인할 수 있어요.
예를 들어 o1 모델 같은 추론 활성 모델로 Responses API에 요청하면 다음 토큰 수가 컨텍스트 윈도우 총합에 적용돼요.
- 입력 토큰 (Responses API의
input배열에 포함한 입력) - 출력 토큰 (프롬프트에 대한 응답으로 생성된 토큰)
- 추론 토큰 (모델이 응답을 계획하는 데 사용)
컨텍스트 윈도우 한도를 초과해 생성된 토큰은 API 응답에서 잘릴 수 있어요.
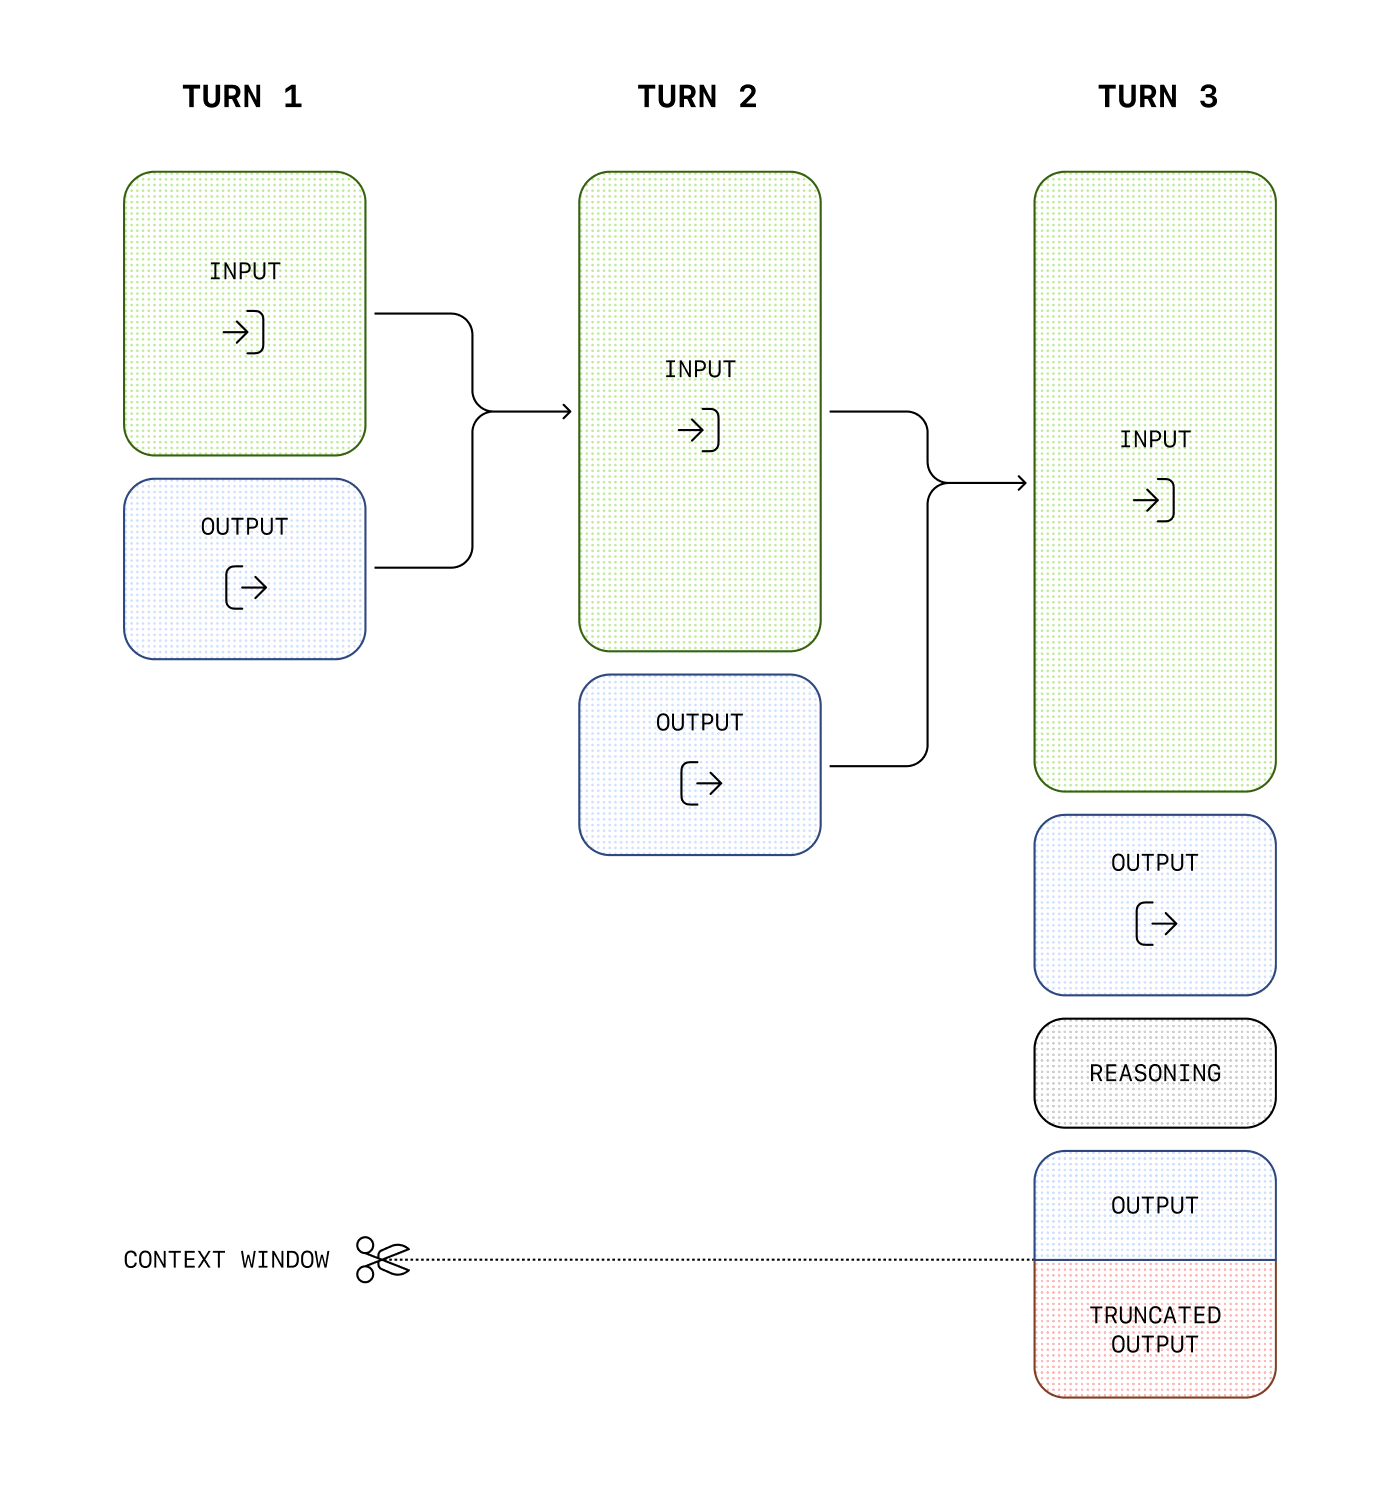
tokenizer 툴로 메시지가 사용할 토큰 수를 추정할 수 있어요.
압축 (Compaction)
자세한 압축 지침은 Compaction에 있어요.
context_management과compact_threshold가 있는/responses는 서버 측 압축을 참고하세요.- 명시적 압축 제어는 단독 compact 엔드포인트와
/responses/compactAPI reference를 참고하세요.
다음 단계
더 구체적인 예시와 사용 사례는 OpenAI Cookbook을 방문하거나, API로 모델 기능을 확장하는 방법을 배워 보세요.