
플러그인·API 통합을 위한 MCP 서버 만들기
플러그인·API 통합을 위한 MCP 서버 만들기 (Building MCP servers for plugins and API integrations)
Model Context Protocol(MCP)은 AI 모델에 추가 도구와 지식을 붙이는 업계 표준으로 자리 잡아 가는 오픈 프로토콜이에요. 원격 MCP 서버를 쓰면 인터넷 너머의 새 데이터 소스와 기능을 모델에 연결할 수 있어요.
출처: 문서
본문
이 가이드에서는 프라이빗 데이터 소스(vector store)에서 데이터를 읽어, ChatGPT와 Codex의 플러그인, ChatGPT 딥 리서치와 회사 지식, 그리고 API를 통해 쓸 수 있게 해 주는 원격 MCP 서버를 만드는 방법을 다뤄요.
참고: MCP 서버로 플러그인을 만들려면 플러그인 문서부터 시작하세요. Quickstart, Build your MCP server, Connect and test your plugin, Authentication. MCP 서버에 UI가 필요 없다면 UI 리소스 없이 도구만 노출할 수 있어요.
데이터 소스 구성
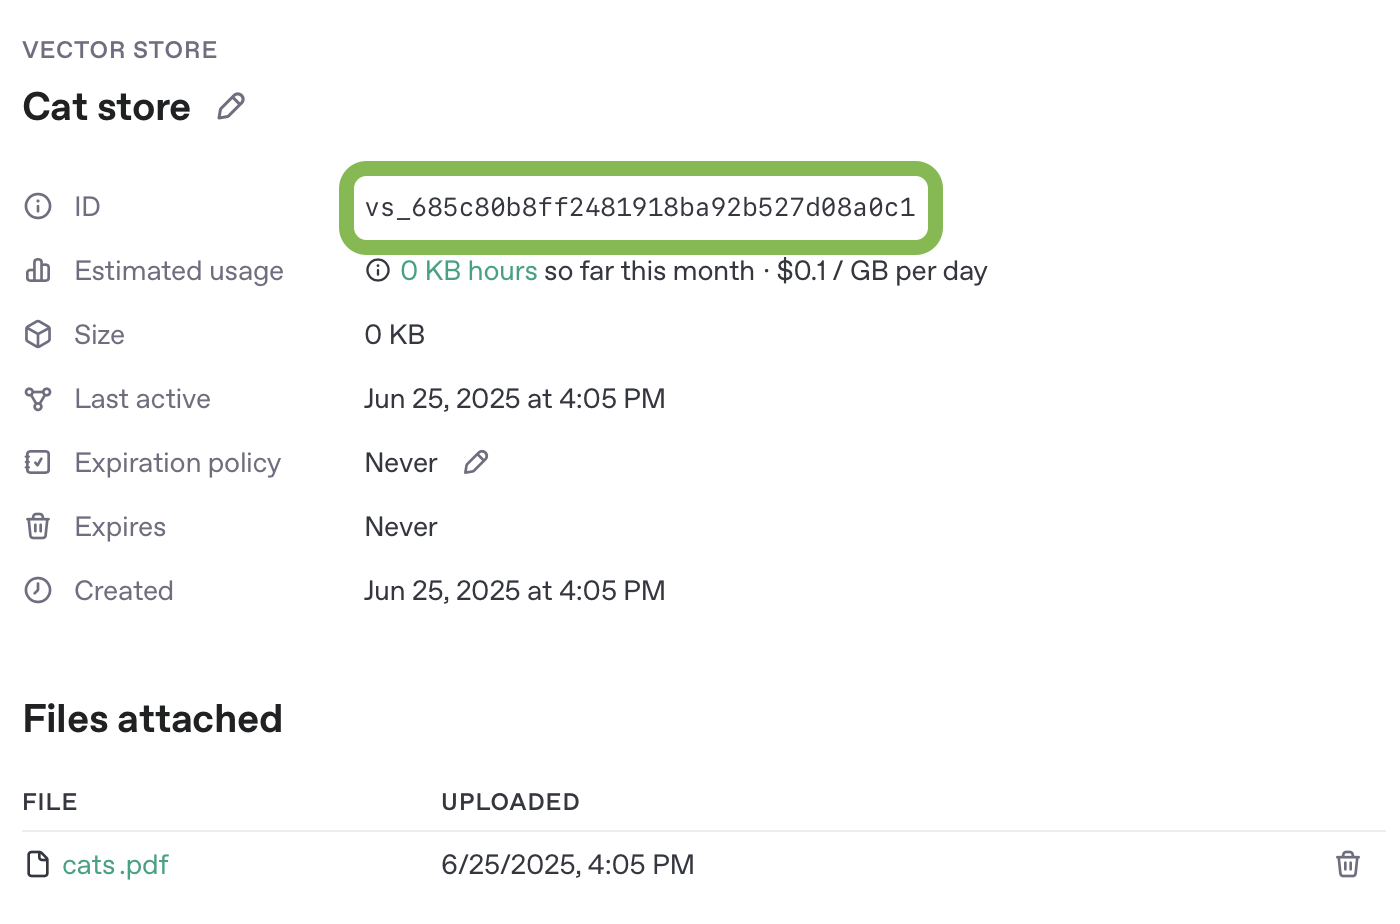
어떤 소스의 데이터든 원격 MCP 서버의 기반이 될 수 있지만, 편의상 OpenAI API의 vector stores를 사용할게요. 새 vector store에 PDF 문서를 업로드하는 것부터 시작해요 — 예시로 이 공개 도메인 19세기 고양이 책을 쓸 수 있어요. 대시보드에서 파일을 업로드하고 vector store를 만들거나 API로 만들 수 있어요. vector store 가이드를 따라 설정하고 파일을 업로드하세요.
vector store의 고유 ID를 메모해 두세요. 다음 예시에서 쓸 거예요.
MCP 서버 만들기
이제 vector store에 대한 검색 쿼리를 실행하고, 주어진 ID의 파일에 대한 문서 내용을 반환하는 원격 MCP 서버를 만들어 볼게요. 예시에서는 Python과 FastMCP로 서버를 만들 거예요. 서버의 전체 구현은 이 섹션 끝에 있고, 브라우저 기반 개발 환경에서 실행하는 방법도 함께 나와요.
다른 프로그래밍 언어의 MCP 서버 프레임워크도 여럿 있지만, 어떤 프레임워크를 쓰든 서버의 도구 정의는 여기서 설명하는 형태를 따라야 해요. ChatGPT 딥 리서치와 회사 지식에서 동작하게 하려면 MCP 서버가 search와 fetch라는 두 개의 읽기 전용 도구를 구현해야 해요. 호환 스키마는 Company knowledge compatibility에서 확인하세요. 이 인터페이스는 API를 통한 리서치 워크플로에도 유용해요.
각 도구에 출력 스키마를 선언해 클라이언트가 결과 형태를 검증하도록 하세요. FastMCP에서는 타입이 있는 반환 모델이 이 스키마를 자동 생성할 수 있는데, 아래 예시는 같은 모델에서 output_schema를 명시적으로 넘겨줘요.
search 도구
search 도구는 사용자 쿼리 기준으로 MCP 서버 데이터 소스에서 관련 검색 결과 목록을 반환해요.
인자: 단일 쿼리 문자열. 반환: results 단일 키를 갖는 객체로, 값은 결과 객체 배열이에요. 각 결과 객체는 다음을 포함해야 해요.
id— 문서나 검색 결과 항목의 고유 IDtitle— 사람이 읽을 수 있는 제목url— 인용을 위한 canonical URL
MCP에서 이 객체를 structuredContent로 반환하고, 호환성을 위해 같은 값을 content 배열에 JSON-encoded 문자열로도 넣어요. 최종 도구 응답은:
{
  "structuredContent": {
    "results": [{ "id": "doc-1", "title": "...", "url": "..." }]
  },
  "content": [
    {
      "type": "text",
      "text": "{\"results\":[{\"id\":\"doc-1\",\"title\":\"...\",\"url\":\"...\"}]}"
    }
  ]
}
fetch 도구
fetch 도구는 검색 결과 문서나 항목의 전체 내용을 가져와요.
인자: 검색 문서를 식별하는 문자열. 반환: 다음 속성을 가진 단일 객체.
id— 문서나 검색 결과 항목의 고유 IDtitle— 검색 결과 항목의 문자열 제목text— 문서나 항목의 전체 텍스트url— 문서나 검색 결과 항목의 URL. 리서치에서 특정 리소스를 인용할 때 유용해요.metadata— 결과에 대한 키/값 메타데이터(선택)
역시 structuredContent로 반환하고 같은 값을 JSON-encoded 문자열로 content 배열에 넣어요.
{
  "structuredContent": {
    "id": "doc-1",
    "title": "...",
    "text": "full text...",
    "url": "https://example.com/doc",
    "metadata": { "source": "vector_store" }
  },
  "content": [
    {
      "type": "text",
      "text": "{\"id\":\"doc-1\",\"title\":\"...\",\"text\":\"full text...\",\"url\":\"https://example.com/doc\",\"metadata\":{\"source\":\"vector_store\"}}"
    }
  ]
}
인용 동작 (Citation behavior)
search 결과와 fetch 응답 모두에서, ChatGPT는 url이 비어 있지 않은 문자열일 때만 인용 메타데이터를 만들어요. title은 있지만 쓸 수 있는 url이 없는 결과는 빈 인용이 아니라 일반 도구 출력으로 남아요. 결과를 인용 가능하게 하려면 canonical url을 반환하세요.
예를 들어 ChatGPT가 search를 이렇게 호출하면:
{ "query": "What is the quarterly plan?" }
MCP 서버는 URL 기반 결과로 응답할 수 있어요:
{
  "structuredContent": {
    "results": [
      {
        "id": "quarterly-plan",
        "title": "Quarterly plan",
        "url": "https://example.com/quarterly-plan"
      }
    ]
  },
  "content": [
    {
      "type": "text",
      "text": "{\"results\":[{\"id\":\"quarterly-plan\",\"title\":\"Quarterly plan\",\"url\":\"https://example.com/quarterly-plan\"}]}"
    }
  ]
}
이 응답에서 url 필드에 값이 있어 인용 메타데이터 대상이 돼요. 쿼리 자체는 인용 처리를 일으키지 않아요. 결과가 url을 생략하거나 빈 값·비문자열 값을 주면 ChatGPT는 결과를 일반 도구 출력으로 유지해요.
서버 예시
이 예시 서버는 브라우저 기반 개발 환경에서 시도할 수 있어요. 자신의 API 자격증명과 vector store 정보로 샘플을 구성하세요.
Replit에서 예시 MCP 서버 — Remix해서 라이브로 테스트해 보세요. FastMCP에서 search와 fetch 두 도구의 전체 구현은 아래와 같아요.
전체 구현 — FastMCP 서버
# Replace the illustrative IDs and URLs below with your own resource values.
"""
Sample MCP Server for ChatGPT Integration

This server implements the Model Context Protocol (MCP) with search and fetch
capabilities designed to work with ChatGPT's chat and deep research features.
"""

import logging
import os
from typing import Any

from fastmcp import FastMCP
from openai import OpenAI
from pydantic import BaseModel


class SearchResult(BaseModel):
    id: str
    title: str
    url: str


class SearchOutput(BaseModel):
    results: list[SearchResult]


class FetchOutput(BaseModel):
    id: str
    title: str
    text: str
    url: str
    metadata: dict[str, Any] | None = None


# Configure logging
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger(__name__)

# OpenAI configuration
OPENAI_API_KEY = os.environ["OPENAI_API_KEY"]
VECTOR_STORE_ID = "vs_123"

# Initialize OpenAI client
openai_client = OpenAI(api_key=OPENAI_API_KEY)

server_instructions = """
This MCP server provides search and document retrieval capabilities
for ChatGPT Apps and deep research. Use the search tool to find relevant documents
based on keywords, then use the fetch tool to retrieve complete
document content with citations.
"""


def create_server():
    """Create and configure the MCP server with search and fetch tools."""

    # Initialize the FastMCP server
    mcp = FastMCP(name="Sample MCP Server", instructions=server_instructions)

    @mcp.tool(output_schema=SearchOutput.model_json_schema())
    async def search(query: str) -> SearchOutput:
        """
        Search for documents using OpenAI Vector Store search.

        This tool searches through the vector store to find semantically relevant matches.
        Returns a list of search results with basic information. Use the fetch tool to get
        complete document content.
        """
        if not query or not query.strip():
            return SearchOutput(results=[])

        if not openai_client:
            logger.error("OpenAI client not initialized - API key missing")
            raise ValueError("OpenAI API key is required for vector store search")

        response = openai_client.vector_stores.search(
            vector_store_id=VECTOR_STORE_ID, query=query
        )

        results = []
        if hasattr(response, "data") and response.data:
            for i, item in enumerate(response.data):
                item_id = getattr(item, "file_id", f"vs_{i}")
                item_filename = getattr(item, "filename", f"Document {i + 1}")

                result = SearchResult(
                    id=item_id,
                    title=item_filename,
                    url=f"https://platform.openai.com/storage/files/{item_id}",
                )
                results.append(result)

        return SearchOutput(results=results)

    @mcp.tool(output_schema=FetchOutput.model_json_schema())
    async def fetch(id: str) -> FetchOutput:
        """
        Retrieve complete document content by ID for detailed
        analysis and citation.
        """
        if not id:
            raise ValueError("Document ID is required")

        if not openai_client:
            logger.error("OpenAI client not initialized - API key missing")
            raise ValueError("OpenAI API key is required for vector store file retrieval")

        content_response = openai_client.vector_stores.files.content(
            vector_store_id=VECTOR_STORE_ID, file_id=id
        )
        file_info = openai_client.vector_stores.files.retrieve(
            vector_store_id=VECTOR_STORE_ID, file_id=id
        )

        file_content = ""
        if hasattr(content_response, "data") and content_response.data:
            content_parts = []
            for content_item in content_response.data:
                if hasattr(content_item, "text"):
                    content_parts.append(content_item.text)
            file_content = "\n".join(content_parts)
        else:
            file_content = "No content available"

        filename = getattr(file_info, "filename", f"Document {id}")

        result = FetchOutput(
            id=id,
            title=filename,
            text=file_content,
            url=f"https://platform.openai.com/storage/files/{id}",
        )

        if hasattr(file_info, "attributes") and file_info.attributes:
            result.metadata = dict(file_info.attributes)

        return result

    return mcp


def main():
    """Main function to start the MCP server."""
    server = create_server()
    try:
        port = int(os.environ.get("OPENAI_EXAMPLE_PORT", "8000"))
        server.run(
            transport="sse",
            host="0.0.0.0",
            port=port,
            uvicorn_config={"loop": "asyncio"},
        )
    except KeyboardInterrupt:
        logger.info("Server stopped by user")
    except Exception as e:
        logger.error(f"Server error: {e}")
        raise


if __name__ == "__main__":
    main()
Replit 설정
Replit에서 "Secrets" UI에 OPENAI_API_KEY를 설정하고, 방금 만든 vector store ID로 vs_123을 바꾸세요. 무료 Replit 계정에서는 에디터가 활성화된 동안에만 서버 URL이 동작하므로, 테스트하는 동안 브라우저 탭을 열어 두어야 해요. 링크 체인 아이콘을 클릭하면 MCP 서버 URL을 얻을 수 있어요.
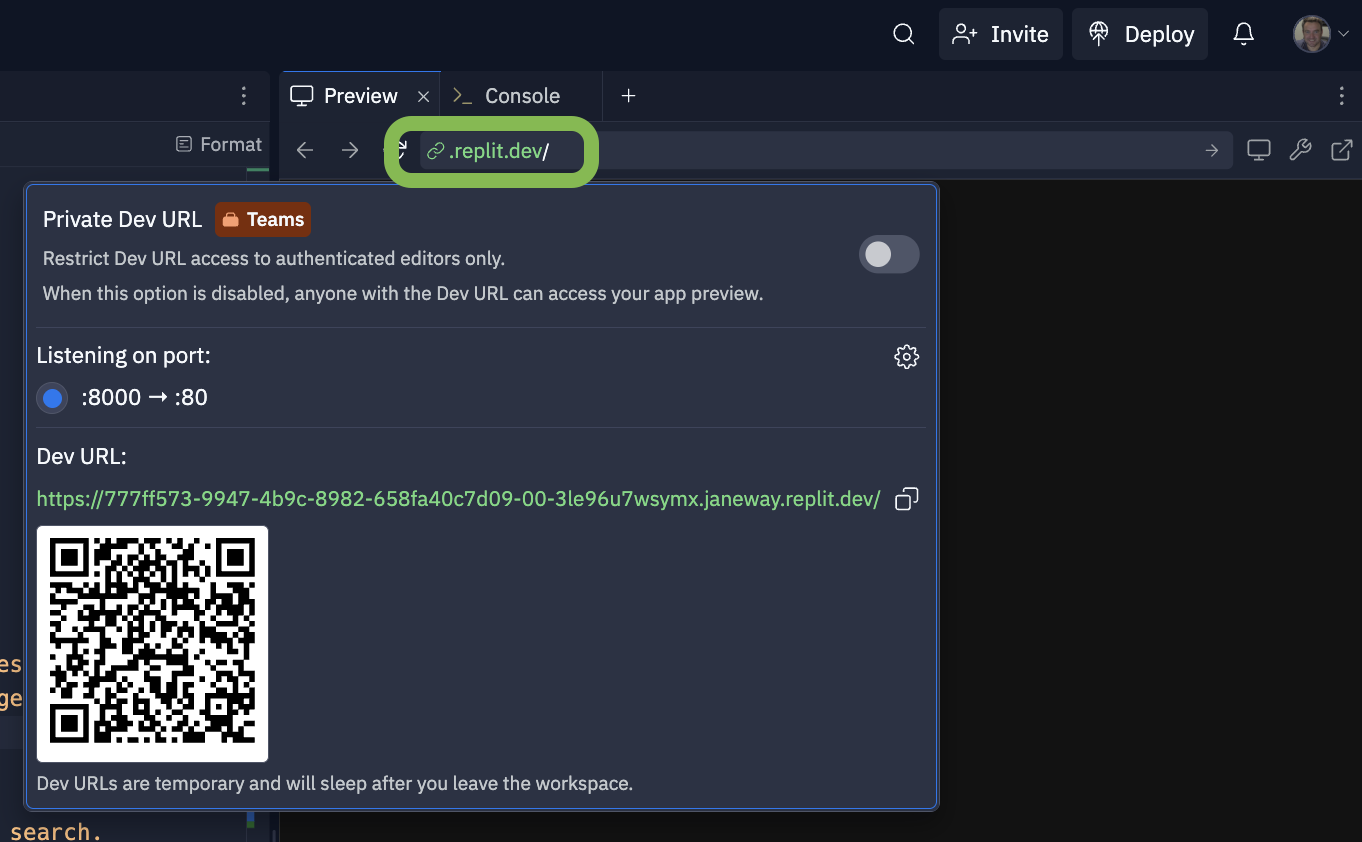
긴 개발 URL은 MCP 서버의 server-sent events(스트리밍) 인터페이스인 /sse/로 끝나는지 확인하세요. ChatGPT에서 앱을 연결하고 API로 호출할 때 쓰는 URL이에요. 예:
https://777xxx.janeway.replit.dev/sse/
테스트하고 연결하기
딥 리서치 모델로 prompts 대시보드에서 MCP 서버를 테스트할 수 있어요. 새 프롬프트를 만들거나 기존 것을 편집하고, 프롬프트 구성에 MCP 도구를 추가하세요. 이 호환 예시는 읽기 전용 search·fetch 도구만 노출하므로 API 요청에서 이 도구들에 대한 승인을 건너뛰어요. 데이터를 수정하거나 다른 중대한 결과를 일으키는 도구에는 승인을 켜 두세요. 플러그인의 일부로 테스트한다면 Connect and test your plugin을 따르세요.
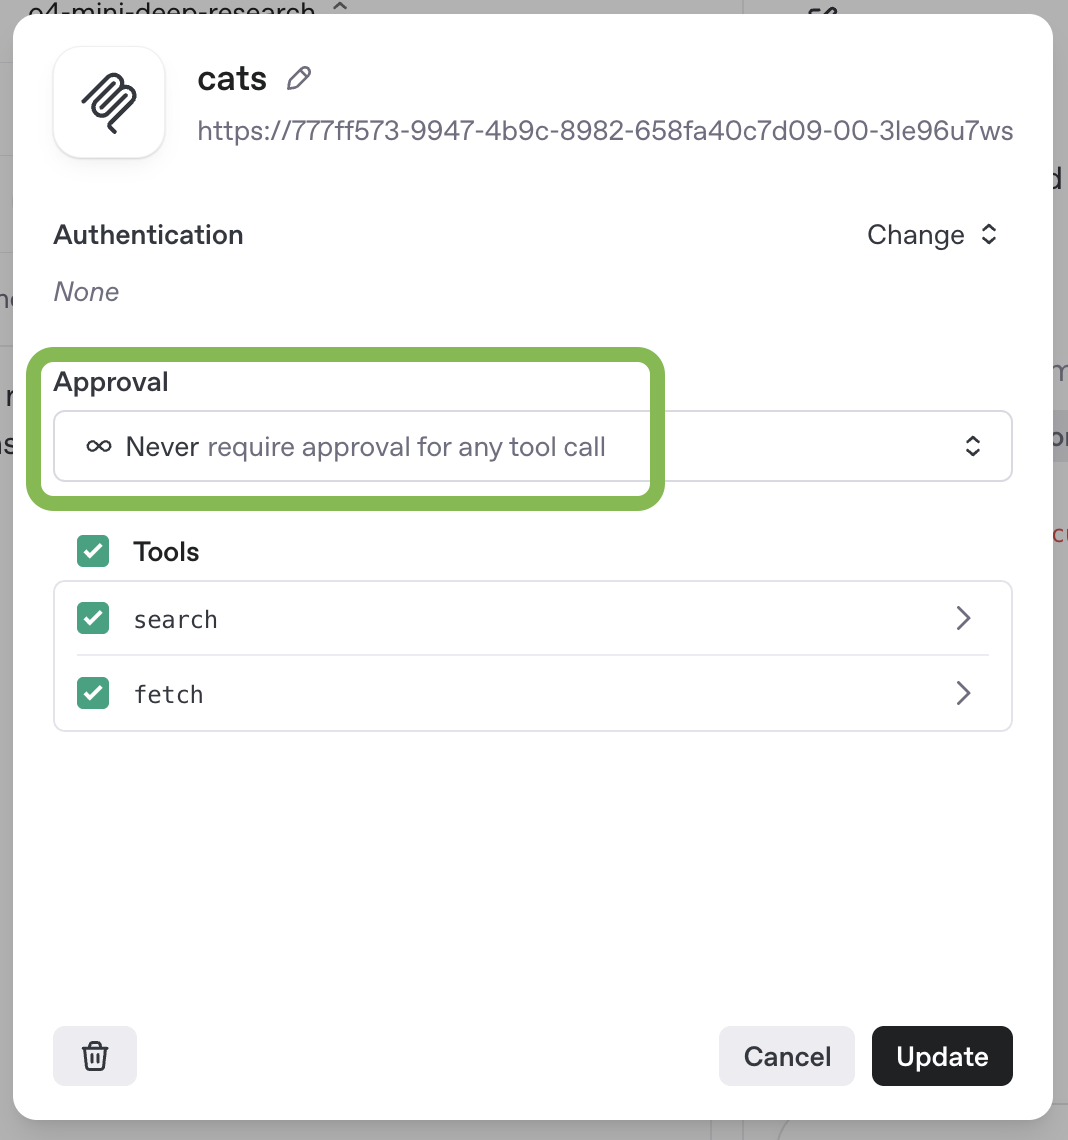
MCP 서버를 구성하고 나면 Prompts UI로 모델과 대화할 수 있어요. Responses API로 직접 테스트할 수도 있어요:
curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ***" \
  -d '{
  "model": "gpt-5.6-sol",
  "input": [
    {
      "role": "developer",
      "content": [
        {
          "type": "input_text",
          "text": "You are a research assistant that searches MCP servers to find answers to your questions."
        }
      ]
    },
    {
      "role": "user",
      "content": [
        {
          "type": "input_text",
          "text": "Are cats attached to their homes? Give a succinct one page overview."
        }
      ]
    }
  ],
  "reasoning": {
    "summary": "auto"
  },
  "tools": [
    {
      "type": "mcp",
      "server_label": "cats",
      "server_url": "https://777ff573-9947-4b9c-8982-658fa40c7d09-00-3le96u7wsymx.janeway.replit.dev/sse/",
      "allowed_tools": [
        "search",
        "fetch"
      ],
      "require_approval": "never"
    }
  ]
}'
인증 처리
커스텀 원격 MCP 서버를 만들 때는 권한 부여와 인증이 데이터 보호에 중요해요. 권한 서버가 CIMD를 지원하고 플러그인 제작자가 선택한다면, 클라이언트 등록에 Client ID Metadata Documents를 사용한 OAuth를 권장해요. ChatGPT는 public-client 토큰 교환(none) 또는 서명된 클라이언트 어서션 토큰 교환(private_key_jwt)으로 CIMD를 지원해요. 동적 클라이언트 등록도 설정 시 계속 지원돼요. 플러그인 인증 요구사항은 Authentication, 프로토콜 세부 사항은 MCP user guide나 authorization specification을 읽어보세요.
플러그인을 통해 커스텀 원격 MCP 서버를 연결하면, 워크스페이스의 사용자에게 서비스로의 OAuth 흐름이 제공돼요.
ChatGPT에서 연결
- ChatGPT에서 Settings → Security and login을 열고 Developer mode를 켜요.
- ChatGPT Plugins로 가서 더하기 버튼을 누르고 개발자 모드에서 서버 URL을 연결해요.
- 채팅과 딥 리서치에서 프롬프트를 실행해 플러그인을 테스트해요.
자세한 설정은 Connect and test your plugin을 참고하세요.
위험과 안전
커스텀 MCP 서버를 쓰면 ChatGPT 워크스페이스를 외부 애플리케이션에 연결할 수 있고, ChatGPT가 이 앱들에서 데이터에 접근하고 보내고 받을 수 있게 돼요. 커스텀 MCP 서버는 OpenAI가 개발하거나 검증한 것이 아니며, 자체 이용약관을 가진 타사 서비스라는 점 유의하세요. 악성 MCP 서버를 발견하면 [email protected]으로 신고해 주세요.
프롬프트 인젝션 관련 위험
프롬프트 인젝션은 공격자가 모델이 접할 가능성이 높은 콘텐츠(예: 웹페이지)에 악성 지침을 심어 ChatGPT의 의도된 동작을 덮어쓰려는 공격 형태예요. 모델이 주입된 지침을 따르면 사용자·개발자가 의도하지 않은 행동 — 민감한 데이터를 외부로 보내는 것까지 — 을 할 수 있어요.
예를 들어 단체 저녁 식사 장소를 찾으라고 ChatGPT에 요청할 때, 캘린더와 최근 이메일을 확인하는 동안 악성 댓글(에이전트를 의도하지 않은 행동으로 속이려는 유해 콘텐츠)을 만나 Gmail에서 비밀번호 재설정 코드를 가져와 악성 사이트로 보내라고 지시받을 수 있어요.
아래 표는 고려할 구체적인 시나리오예요. 커스텀 MCP 사용 여부를 결정할 때 잘 검토해 보세요.
| 시나리오 / 위험 | MCP 개발자를 신뢰하면 안전한가? | 위험을 줄이려면? |
|---|---|---|
| 공격자가 MCP를 통해 접근 가능한 데이터에 프롬프트 인젝션 공격을 심을 수 있음 | MCP 개발자를 신뢰한다고 안전해지지 않아요. MCP 내에서 접근되는 _모든 콘텐츠_를 신뢰해야 해요. | MCP 개발자를 신뢰해도 악성·신뢰할 수 없는 사용자 입력이 포함될 수 있으면 MCP를 쓰지 마세요. 접근 인원을 최소화하도록 설정하세요. |
| 악성 MCP가 읽기·쓰기 동작에 과도한 파라미터를 요청할 수 있음 | MCP 개발자를 신뢰해도 반드시 안전하진 않아요. 개발자가 공유해도 괜찮다고 보는 데이터가 여러분 기준에선 과할 수 있어요. | 수동으로 MCP 서버를 설치할 때 각 동작이 요청하는 파라미터를 검토하고 개인정보 과잉 요청이 없는지 확인하세요. |
| 공격자가 프롬프트 인젝션으로 커스텀 MCP에서 민감 데이터를 가져오게 속일 수 있음 | MCP 개발자를 신뢰한다고 안전해지지 않아요. 위험은 다른 악성 소스의 공격으로 데이터가 도난당하는 데서 오기 때문이에요. | _ChatGPT는 사용자를 보호하도록 설계_되지만 공격자가 데이터를 훔치려 할 수 있으니 위험을 인지하세요. 특히 민감한 데이터를 가진 MCP 접근 인원을 최소화하세요. |
| 공격자가 커스텀 MCP의 쓰기 동작으로 민감 정보를 유출시킬 수 있음 | MCP를 완전히 신뢰해도, 쓰기 동작의 결과를 공격자가 관찰할 수 있다면 악용할 수 있어요. | 쓰기 동작이 발생할 때 신중히 검토해 의도된 것인지, 공유하면 안 되는 데이터가 없는지 확인하세요. |
| 공격자가 읽기 동작으로 커스텀 MCP에서 민감 정보를 유출시킬 수 있음(로그로 남기 때문에) | 이 공격은 MCP가 악성이거나 쓰기 동작을 읽기로 잘못 표시할 때만 동작해요. 개발자를 신뢰한다면 위험은 작을 수 있어요. | 신뢰하는 개발자의 MCP만 사용하세요(다만 이걸로 충분히 안전하진 않아요). |
| 공격자가 프롬프트 인젝션으로 사용자가 의도하지 않은 해로운 쓰기 동작을 하게 속일 수 있음 | MCP 개발자를 신뢰한다고 안전해지지 않아요. 공격이 다른 악성 소스에서 오기 때문에 이 위험은 여전해요. | 사용자는 쓰기 동작을 신중히 검토해 의도된 것인지 확인하세요. _ChatGPT는 사용자를 보호하도록 설계_되지만 공격자가 의도하지 않은 쓰기 동작을 유도할 수 있어요. |
프롬프트 인젝션 외 위험
커스텀 MCP는 프롬프트 인젝션 공격과 무관한 다른 위험도 가져와요.
- 쓰기 동작은 유용성과 위험을 모두 키워요. 서버가 정보만 돌려주는 대신 파괴적인 동작을 할 수 있게 되기 때문이에요. ChatGPT는 현재 쓰기 동작 전에 대화에서 수동 확인을 요구해요. 확인 과정이 잠재적 민감 데이터를 표시하지만, ChatGPT가 그런 동작에 실수할 가능성을 잘 고려하고 수용할 수 있을 때만 쓰기 동작을 쓰세요. MCP 서버가 동작을 읽기 전용으로 표시했어도 쓰기 동작이 일어날 수 있어서, ChatGPT에 배포하기 전에 커스텀 MCP 서버를 신뢰하는 것이 더욱 중요해요.
- 어떤 MCP 서버든 쿼리 과정에서 민감 데이터를 받을 수 있어요. 서버가 악성이 아니어도, 상호작용 중 ChatGPT가 제공하는 데이터(사용자가 이전에 ChatGPT에 준 민감 데이터 포함)에 접근할 수 있어요. 예를 들어 딥 리서치나 채팅 앱 도구를 쓸 때 ChatGPT가 MCP 서버로 보내는 쿼리에 그런 데이터가 포함될 수 있어요.
신뢰할 수 있는 서버에 연결
기반 애플리케이션을 알고 신뢰하지 않는 한 커스텀 MCP 서버에 연결하지 않는 것을 권장해요. 예를 들어 서비스 제공자가 직접 호스팅하는 공식 서버를 고르세요. 제3자가 호스팅하는 비공식 Stripe MCP 서버 대신 Stripe가 호스팅하는 mcp.stripe.com을 연결하세요. 오늘날 공식 MCP 서버가 많지 않아, 다른 서비스로 요청을 프록시하는 조직이 호스팅하는 서버를 고려할 수도 있어요. 그 조직이 데이터를 어떻게 사용하는지 검토하고 서버를 신뢰할 수 있는지 확인한 뒤에만 연결하세요. 직접 만든 MCP 서버를 연결할 때는 올바른 서버인지 다시 확인하고, 요청에 응답하며 주는 데이터와 OpenAI가 서버를 호출할 때 받은 데이터를 어떻게 다룰지 주의하세요.
원격 MCP 서버는 다른 사람이 OpenAI를 여러분의 서비스에 연결하게 하고, OpenAI가 그 서비스에서 데이터에 접근·송수신·행동하도록 허용해요. 도구의 JSON에 민감한 정보를 넣지 말고, 원격 MCP 서버에 접근하는 ChatGPT 사용자의 민감 정보를 저장하지 마세요. MCP 서버를 만들 때는 도구 정의에 악의적인 것을 넣지 마세요.
더 알아보기 (Learn more)
MCP의 기본 개념과 전송·인증에 대한 자세한 내용은 Model Context Protocol 문서를, 플러그인 빌드 절차는 플러그인 문서를 참고하세요. vector store 세부 사항은 retrieval 가이드에 있어요.