
강화 파인튜닝 사용 사례
강화 파인튜닝 사용 사례 (Reinforcement fine-tuning use cases)
출처: 문서
Reinforcement fine-tuning(RFT)은 특정 작업에서 모델 성능을 개선하는 방법을 제공해요. 작업은 명확하고 검증 가능한 답이 있어야 해요.
OpenAI는 파인튜닝 플랫폼을 단계적으로 종료하고 있어요. 이제 새 사용자는 플랫폼에 접근할 수 없지만, 파인튜닝 플랫폼의 기존 사용자는 앞으로 몇 달 동안 훈련 작업을 만들 수 있을 거예요.
모든 파인튜닝 모델은 해당 기반 모델이 deprecated될 때까지 추론에 계속 사용할 수 있어요. 전체 일정은 여기에 있어요.
강화 파인튜닝을 언제 사용하나요
에이전트형 워크플로는 정확하고 검증 가능한 결정을 내리도록 설계돼요. RFT는 명시적인 루브릭(rubric)을 제공하고 코드 기반 또는 LLM 기반 grader를 사용해 기능적 성공, 사실적 정확성, 정책 준수를 측정하는 데 도움을 줄 수 있어요.
초기 사용자 전반에서 세 가지 명확한 사용 사례가 나타났어요:
- 지침을 작동하는 코드로 바꾸기: 개방형 프롬프트를 결정론적 테스트를 통과해야 하는 구조화된 코드, 구성, 템플릿으로 변환해요.
- 사실을 깔끔한 형식으로 끌어내기: 지저분하고 구조화되지 않은 텍스트에서 검증 가능한 사실과 요약을 추출하고 JSON 구조형 또는 기타 스키마 기반 출력을 반환해요.
- 복잡한 규칙을 올바르게 적용하기: 제공된 정보가 미묘하고, 양이 많고, 계층적이거나, 고위험일 때 세밀한 라벨 또는 정책 결정을 내려요.
강화 파인튜닝을 사용할 준비가 되셨나요? 가이드로 건너뛰기 →
1. 지침을 작동하는 코드로 바꾸기
이 사용 사례에서 모델은 숨겨진 도메인 제약 조건을 추론해 코드, 쿼리, 인프라 템플릿 같은 구조화된 출력을 생성해요. 출력은 여러 정확성 조건을 충족해야 하며, 성공은 보통 결정론적으로 평가돼요: 아티팩트가 컴파일되거나, 테스트를 통과하거나, 명시적 스키마를 충족하거나.
반도체 설계를 위한 검증 IP 배선 (Wiring)
Use case
회사: ChipStack은 칩 설계와 검증을 위한 차세대 AI 기반 도구를 구축하며, 복잡한 반도체 칩을 개발·검증하는 시간과 비용을 크게 줄이는 것을 목표로 해요.
해결할 문제: 인간에게 어렵고 시간이 많이 걸리는 작업 중 하나는 설계 인터페이스를 검증 IP(검증 IP는 미리 만들어진 검증 컴포넌트로, 제대로 적용하면 검증의 품질과 범위를 크게 향상시킬 수 있음)에 바인딩하는 거예요. 검증 IP는 매우 많고, 각각 수십에서 수백 개의 매핑될 수 있는 신호를 포함할 수 있어요. 이 도메인을 잘 이해해야 검증 IP를 올바르게 적용할 수 있어요.
목표: OpenAI reasoning 모델이 대신 이 작업을 수행하도록 훈련하기 위해 ChipStack은 50개 미만의 샘플로 구성된 데이터셋을 준비한 다음 여러 RFT 변형을 수행했어요. 최종 평가 보고서를 위해 o1-mini base/fine-tuned, o3-mini base/fine-tuned의 각 모델과 변형에 대해 이 평가 세트를 세 번 실행하고, 샘플별로 평균을 낸 후 전체 평균을 냈어요.
Prompt
아래는 제공된 예시 데이터 조각이에요.
[
    {“name”: “BLOCK_SIZE”, “value”: “8”},
    {“name”: “ADDR_WIDTH”, “value”: “4”}
]
Grader code
아래는
name과value속성을 가진 객체 목록으로 표현된 문자열 맵의 Python grader 정의예요.개념적으로
Dict[str, str]타입을 모델링한 것이에요.
{
    "type": "python",
    "name": "donors_caas",
    "image_tag": "alpha",
    "source": """from collections import Counter

def grade(sample: dict[str, str], item: dict[str, str]) -> float:
    # multisets of (name, value) pairs
    predicted = sample["output_json"]["predicted"]
    expected = item["reference_answer"]
    pred_counts = Counter((d["name"], d["value"]) for d in predicted)
    exp_counts = Counter((d["name"], d["value"]) for d in expected)

    true_pos = sum(min(pred_counts[p], exp_counts[p]) for p in pred_counts)
    pred_total = sum(pred_counts.values())
    exp_total = sum(exp_counts.values())

    precision = true_pos / pred_total if pred_total else 0.0
    recall = true_pos / exp_total if exp_total else 0.0

    if precision + recall == 0.0:
        return 0.0
    return 2 * precision * recall / (precision + recall)""",
}
Results
o1-mini와 o3-mini 모두 성능이 약 12%포인트 개선됐어요. 파인튜닝된 변형은 배선을 적용하지 말아야 할 때를 인식하는 데 훨씬 나아졌어요. 많은 상업용 검증 IP는 수백 개의 선택적 신호를 포함할 수 있는데, 대부분은 적용되지 말아야 하는 것들이에요.
"강력한 베이스 모델과 사용하기 쉬운 Reinforced Fine-Tuning API 덕분에, 우리는 소수의 고품질 샘플로 작업 성능을 크게 높일 수 있었습니다."
—ChipStack, 칩 설계와 검증을 위한 차세대 AI 기반 도구
컴파일되고 AST 검사를 통과하는 프로덕션 준비 API 스니펫
Use case
회사: Runloop은 AI 기반 코딩 에이전트를 프로덕션에 배포하기 위한 플랫폼으로, 성능을 개선하기 위해 공개 및 커스텀 벤치마킹 기능으로 구축됐어요.
해결할 문제: Runloop은 Stripe API 같은 서드파티 API 사용에서 모델 성능을 개선하고 싶었어요. Stripe API는 사람의 개입 없이는 크고 복잡할 수 있어요. Stripe API를 사용하도록 모델을 훈련할 수 있다면, Runloop은 경제적으로 영향력 있는 비즈니스 사례를 작동하는 코드로 바꿀 수 있었어요.
목표: 그들의 목표는 모델이 Stripe API 사용을 숙달하게 하는 것이었어요. 여기에는 기존 통합 가이드의 정보를 조정하거나, 여러 가이드의 정보를 병합하거나, 가이드에 명시적으로 언급되지 않은 정보를 추론해 임의의 사용자 요청에 대한 완전한 코드 스니펫 작성이 포함돼요. 그들은 두 가지 주요 보상으로 RFT를 사용했어요:
- "동적" 통합 가이드가 가져야 할 모습에 대한 기대와 일치하는 Markdown 형식으로 답을 출력한 데 대해 보상.
- AST Grep으로 출력된 코드를 검증해 "올바른" 코드 스니펫을 생성한 데 대해 보상. 이를 통해 모델이 올바른 Stripe SDK 호출을 올바른 파라미터로, 어떤 경우에는 올바른 순서로도 호출하는 것을 확인할 수 있었어요.
Grader code
# Note this file gets uploaded to the OpenAI API as a grader
from ast_grep_py import SgRoot
from pydantic import BaseModel, Field  # type: ignore
from typing import Any
import re

SUPPORTED_LANGUAGES = ['typescript', 'javascript', 'ts', 'js']

class CodeBlock(BaseModel):
    language: str = Field(
        description="Programming language of the code block (e.g., 'python', 'javascript')",
        examples=["python", "javascript", "typescript"]
    )
    path: str = Field(
        description="Target file path where the code should be written",
        examples=["main.py", "src/app.js", "index.html"]
    )
    code: str = Field(
        description="Actual code content extracted from the code block"
    )

class ASTGrepPattern(BaseModel):
    file_path_mask: str = Field(..., description="The file path pattern to match against")
    pattern: str = Field(..., description="The main AST grep pattern to search for")
    additional_greps: list[str] | None = Field(
        default=None,
        description="Additional patterns that must also be present in the matched code"
    )

def extract_code_blocks(llm_output: str) -> list[CodeBlock]:
    # Regular expression to match code blocks with optional language and path
    try:
        pattern = r"```(\w+\s+)?([\w./-]+)?\n([\s\S]*?)\n```"
        matches = list(re.finditer(pattern, llm_output, re.DOTALL))

        print(f"Found {len(matches)} code blocks in the LLM output")

        # Check if any code blocks were found
        if not matches:
            raise Exception("No code blocks found in the LLM response")

        code_blocks: list[CodeBlock] = []
        for match in matches:
            language = match.group(1) or ""
            path = match.group(2) or ""
            code = match.group(3)

            # Clean the path and language
            path = path.strip()
            language = language.strip()

            # If path is relative (doesn't start with /), prefix with /home/user/testbed/
            if path and not path.startswith("/"):
                original_path = path
                path = f"/home/user/testbed/{path}"
                print(
                    f"Converting relative path '{original_path}' to absolute path '{path}'"
                )

            code_blocks.append(
                CodeBlock(language=language, path=path, code=code.strip())
            )

        # Check for missing language or path in code blocks
        missing_language = [
            i for i, block in enumerate(code_blocks) if not block.language
        ]
        missing_path = [i for i, block in enumerate(code_blocks) if not block.path]

        if missing_language:
            print(
                f"WARNING: Code blocks at positions {missing_language} are missing language identifiers"
            )
            raise Exception(
                f"Code blocks at positions {missing_language} are missing language identifiers"
            )

        if missing_path:
            print(
                f"WARNING: Code blocks at positions {missing_path} are missing file paths"
            )
            raise Exception(
                f"Code blocks at positions {missing_path} are missing file paths"
            )

        paths = [block.path for block in code_blocks if block.path]
        print(
            f"Successfully extracted {len(code_blocks)} code blocks with paths: {', '.join(paths)}"
        )

    except Exception as e:
        print(f"Error extracting code blocks: {str(e)}")
        raise

    return code_blocks


def calculate_ast_grep_score(code_blocks: list[CodeBlock], ast_greps: Any) -> float:
    # Convert ast_greps to list if it's a dict
    if isinstance(ast_greps, dict):
        ast_greps = [ast_greps]

    # Parse each grep pattern into the Pydantic model
    parsed_patterns: list[ASTGrepPattern] = []
    for grep in ast_greps:
        try:
            pattern = ASTGrepPattern(**grep)
            parsed_patterns.append(pattern)
        except Exception as e:
            print(f"Error parsing AST grep pattern: {e}")
            return 0.0

    if not parsed_patterns:
        return 0.0

    total_score = 0.0
    pattern_count = len(parsed_patterns)

    # Filter code blocks to only include TypeScript and JavaScript files
    supported_blocks = [
        block for block in code_blocks
        if block.language.lower() in SUPPORTED_LANGUAGES
    ]

    if not supported_blocks:
        print("No TypeScript or JavaScript code blocks found to analyze")
        return 0.0

    for pattern in parsed_patterns:
        # Find matching code blocks based on path prefix
        matching_blocks = [
            block for block in supported_blocks
            if block.path.startswith(pattern.file_path_mask)
        ]

        if not matching_blocks:
            print(f"No matching code blocks found for path prefix: {pattern.file_path_mask}")
            continue

        pattern_found = False
        for block in matching_blocks:
            try:
                # Create AST root for the code block
                root = SgRoot(block.code, block.language)
                node = root.root()

                # Check main pattern
                matches = node.find(pattern=pattern.pattern)
                if not matches:
                    continue

                # If we have additional greps, check them too
                if pattern.additional_greps:
                    all_additional_found = True
                    for additional_grep in pattern.additional_greps:
                        if additional_grep not in block.code:
                            all_additional_found = False
                            break

                    if not all_additional_found:
                        continue

                # If we get here, we found a match with all required patterns
                pattern_found = True
                break

            except Exception as e:
                print(f"Error processing code block {block.path}: {e}")
                continue

        if pattern_found:
            total_score += 1.0

    # Return average score across all patterns
    return total_score / pattern_count if pattern_count > 0 else 0.0

def grade_format(output_text: str) -> float:
        # Find <plan> and </plan> tags
    plan_start = output_text.find('<plan>')
    plan_end = output_text.find('</plan>')

    # Find <code> and </code> tags
    code_start = output_text.find('<code>')
    code_end = output_text.find('</code>')

    reward = 0.0

    if plan_start == -1 or plan_end == -1 or code_start == -1 or code_end == -1:
        print(f'missing plan or code tags. format reward: {reward}')
        return reward
    reward += 0.1 # total: 0.1

    if not (plan_start < plan_end < code_start < code_end):
        print(f'tags present but not in the correct order. format reward: {reward}')
        return reward
    reward += 0.1 # total: 0.2

    # Check if there are any stray tags
    plan_tags = re.findall(r'</?plan>', output_text)
    code_tags = re.findall(r'</?code>', output_text)

    if len(plan_tags) != 2 or len(code_tags) != 2:
        print(f'found stray plan or code tags. format reward: {reward}')
        return reward
    reward += 0.2 # total: 0.4

    # Extract content after </code> tag
    after_tags = output_text[code_end + len('</code>'):].strip()
    if after_tags:
        print(f'found text after code tags. format reward: {reward}')
        return reward
    reward += 0.2 # total: 0.6

    # Extract content inside <plan> tags
    plan_content = output_text[plan_start + len('<plan>'):plan_end].strip()
    if not plan_content:
        print(f'no plan content found. format reward: {reward}')
        return reward
    reward += 0.1 # total: 0.7

    # Extract content inside <code> tags
    code_content = output_text[code_start + len('<code>'):code_end].strip()
    if not code_content:
        print(f'no code content found. format reward: {reward}')
        return reward
    reward += 0.1 # total: 0.8

    # Extract content between </plan> and <code> tags
    between_tags = output_text[plan_end + len('</plan>'):code_start].strip()
    if between_tags:
        print(f'found text between plan and code tags. format reward: {reward}')
        return reward
    reward += 0.2 # total: 1.0

    if reward == 1.0:
        print(f'global format reward: {reward}')

    return reward

def grade(sample: Any, item: Any) -> float:
    try:
        output_text = sample["output_text"]

        format_reward = grade_format(output_text)
        if format_reward < 1.0:
            return format_reward

        # Extract code content for grading
        code_start = output_text.find('<code>')
        code_end = output_text.find('</code>')
        code_to_grade: str = output_text[code_start + len('<code>'):code_end].strip()
        code_blocks: list[CodeBlock] = []
        try:
            code_blocks = extract_code_blocks(code_to_grade)
        except Exception as e:
            print(f'error extracting code blocks: {e}')
            return 0.5

        ast_greps = item["reference_answer"]["ast_greps"]
        ast_grep_score = calculate_ast_grep_score(code_blocks, ast_greps)

        return (format_reward + ast_grep_score) / 2.0
    except Exception as e:
        print(f"Error during grading: {str(e)}")
        return 0.0
Results
총 보상(형식과 AST Grep)을 함께 보면, Runloop은 벤치마크에서 기본 o3-mini 모델에 비해 RFT 모델이 평균 12% 개선된 것을 확인했어요.
그들은 통합 가이드의 명시적 콘텐츠를 제공하는(추론 및 지침 따르기 평가) 테스트와 제공하지 않는(지식 회상 평가) 테스트 두 가지 유형을 구현했어요. 두 변형 모두 8% 이상 개선됐어요.
"OpenAI의 RFT 플랫폼은 우리에게 세계 최고 수준의 일반화 reasoning 모델에 대한 접근을 제공하며, 우리 비즈니스에 중요한 문제 도메인에서 그 추론을 강화할 수 있는 도구 세트도 제공합니다."
스케줄 관리자에서 충돌과 중복의 올바른 처리
Use case
회사: Milo은 바쁜 부모가 지저분한 입력(할 일이 포함된 문자 대화, 학교 소식지 PDF, 주간 알림, 스포츠 스케줄 이메일 등)을 신뢰할 수 있는 달력 및 목록 작업으로 변환해 혼란스러운 가족 일정을 관리하도록 도와줘요.
해결할 문제: 기본 GPT-4o 프롬프팅과 SFT는 신뢰 임계값에 미치지 못했어요.
목표: Milo는 RFT를 사용해 이벤트 vs 목록 분류, 반복 규칙 생성, 정확한 업데이트·삭제, 충돌 감지, 엄격한 출력 형식 같은 코딩 작업을 제대로 만들었어요. 생성된 항목 객체가 완전한지, 올바르게 분류되었는지, 중복인지 또는 달력 충돌이 있는지 확인하는 grader를 정의했어요.
Results
전반적으로 성능이 개선됐으며, 평균 정확도 점수가 0.86에서 0.91로 증가했고, 가장 어려운 시나리오는 0.46에서 0.71로 개선됐어요(완벽한 점수=1).
"정확성은 단순한 지표가 아니라 바쁜 부모를 위한 안심입니다. 아직 초기 단계이지만 기반 성능에서 이렇게 중요한 개선이 있기 때문에 우리는 복잡한 추론 요구에 더 적극적으로 나설 수 있습니다."
"가족 역학을 탐색하고 지원하려면 데이터의 미묘한 함의를 이해해야 합니다. 충돌을 예로 들면 — Ethan의 축구가 Ella의 연주회와 충돌하는 이유는 아빠가 두 아이를 모두 운전해야 하기 때문이라는 것은 단순한 시간 겹침보다 깊습니다."
—Milo, 가족을 위한 AI 스케줄링 도구
2. 사실을 깔끔한 형식으로 끌어내기
이 작업들은 보통 명확한 분류 지침을 요구하는 미묘한 구분을 포함해요. 성공적인 프레이밍은 도메인 전문가들의 합의로 정의된 명시적이고 계층적인 라벨링 체계를 요구해요. 일관된 합의가 없으면 평가 신호가 시끄러워져 RFT 효과가 약해져요.
ICD-10 의료 코드 할당
Use case
회사: Ambience은 임상의의 행정적 부담을 없애고 100개 이상의 전문 분야에서 정확하고 규정을 준수하는 문서화를 보장하는 AI 플랫폼이에요. 의사가 환자 진료에 집중할 수 있게 하면서 문서화 품질을 높이고 의료 시스템의 규정 준수 위험을 줄여요.
해결할 문제: ICD-10 코딩은 의학에서 가장 복잡한 행정 작업 중 하나예요. 환자 방문 후마다 임상의는 각 진단을 ~70,000개의 코드 중 하나에 매핑해야 해요 — 지불자별 특이성, 진료 장소, 상호 배타적인 쌍 규칙을 처리하면서 말이에요. 오류는 감사와 벌금으로 이어질 수 있고, 그 규모는 아홉 자리까지 갈 수 있어요.
목표: OpenAI 프론티어 모델에 강화 파인튜닝을 사용해, Ambience는 방문 오디오를 듣고 관련 EHR 컨텍스트를 가져와 전문 임상의를 뛰어넘는 정확도로 ICD-10 코드를 추천하는 추론 시스템을 훈련하고 싶었어요.
Results
Ambience는 인간 전문가를 앞설 수 있는 모델 개선을 달성했어요.
수백 건의 방문에 걸친 골드 패널 테스트 세트에서 강화 파인튜닝은 모델을 인간보다 뒤처지는 상태에서 12점 앞서는 상태로 만들었어요 — 훈련된 의사가 범하는 코딩 오류의 약 4분의 1을 제거한 것이에요:
- o3-mini (base): 0.39 (-6 pts)
- Physician baseline: 0.45
- RFT-tuned o3-mini: 0.57 (+12 pts)
그 결과는 상환 무결성을 높이고 규정 준수 위험을 줄일 수 있는 실시간 진료 시점 코딩 지원이에요.
"정확한 ICD-10 선택은 규정 준수 문서화에 매우 중요합니다. RFT는 어떤 기반 모델에서도 본 적 없는 새로운 수준의 코딩 정밀도를 열어주었고, 자동화 코딩의 새로운 기준을 세웠습니다."
법적 청구를 뒷받침하는 발췌문 추출
Use case
회사: Harvey는 법률 팀이 신뢰하는 AI를 구축하고 있어요. 그 신뢰는 방대한 계약서, 법령, 판례 말뭉치에서 정확히 올바른 증거를 검색하는 데 달려 있어요. 법률 전문가들은 그럴듯한 요약이나 의역된 답변만 생성하는 모델에 만족하지 않아요. 그들은 검증 가능한 인용 — 원본 문서로 직접 추적할 수 있는 구절을 요구해요.
해결할 문제: Harvey의 클라이언트는 소송 위험 분류, 법적 주장 구성, 법률 전문가를 위한 실사 지원에 그 모델을 사용해요 — 이 모든 작업에서 한 문장을 놓치거나 잘못 인용하면 결과가 뒤집힐 수 있어요. 모델은 길고 조밀한 법적 문서를 구문 분석하고 중요한 부분만 추출해야 해요. 실제로 이러한 입력은 종종 지저분하고 일관성이 없어요: 일부 청구는 모호하고, 다른 청구는 표준 조항 깊숙이 묻힌 희귀한 법적 원칙에 달려 있어요.
목표: 이 작업의 요구사항은 미묘한 법적 청구를 해석하고, 긴 형식 문서를 탐색하며, 있는 그대로의 발췌문으로 적절한 근거를 선택하는 것이에요.
Prompt
## Instructions
You will be provided with a question and a text excerpt. Identify any passages in the text that are directly relevant to answering the question.
- If there are no relevant passages, return an empty list.
- Passages must be copied **exactly** from the text. Do not paraphrase or summarize.
## Excerpt
"""{text_excerpt}"""
Grader
from rapidfuzz import fuzz


# Similarity ratio helper
def fuzz_ratio(a: str, b: str) -> float:
    """Return a normalized similarity ratio using RapidFuzz."""
    if len(a) == 0 and len(b) == 0:
        return 1.0
    return fuzz.ratio(a, b) / 100.0


# Main grading entrypoint (must be named \`grade\`)
def grade(sample: dict, item: dict) -> float:
    """Compute an F1‑style score for citation extraction answers using RapidFuzz."""
    model_passages = (sample.get("output_json") or {}).get("passages", [])
    ref_passages = (item.get("reference_answer") or {}).get("passages", [])

    # If there are no reference passages, return 0.
    if not ref_passages:
        return 0.0

    # Recall: average best match for each reference passage.
    recall_scores = []
    for ref in ref_passages:
        best = 0.0
        for out in model_passages:
            score = fuzz_ratio(ref, out)
            if score > best:
                best = score
        recall_scores.append(best)
    recall = sum(recall_scores) / len(recall_scores)

    # Precision: average best match for each model passage.
    if not model_passages:
        precision = 0.0
    else:
        precision_scores = []
        for out in model_passages:
            best = 0.0
            for ref in ref_passages:
                score = fuzz_ratio(ref, out)
                if score > best:
                    best = score
            precision_scores.append(best)
        precision = sum(precision_scores) / len(precision_scores)

    if precision + recall == 0:
        return 0.0

    return 2 * precision * recall / (precision + recall)
Results
강화 파인튜닝 후 Harvey는 F1 점수가 20% 증가했어요:
- Baseline F1: 0.563
- Post-RFT F1 - 0.6765
RFT를 사용해 Harvey는 법적 사실 추출 성능을 크게 개선했고, GPT-4o의 효율성과 정확성을 뛰어넘었어요. 초기 시험에서 RFT는 GPT-4o와의 비교 93%에서 이기거나 비겼어요.
"RFT 모델은 GPT-4o와 동등하거나 우수한 성능을 보여주면서도 추론 속도가 훨씬 빨랐고, 실세계 법률 사용 사례에서 특히 유용함을 입증했습니다."
—Harvey, 법률 팀을 위한 AI
3. 복잡한 규칙을 올바르게 적용하기
이 사용 사례는 구조화되지 않은 입력에서 검증 가능한 사실이나 엔터티를 명확하게 정의된 스키마(예: JSON 객체, 조건 코드, 의료 코드, 법적 인용, 재무 지표)로 끌어내는 것을 포함해요.
성공적인 추출 작업은 일반적으로 스팬 수준 F1 점수, 퍼지 텍스트 매칭 지표, 숫자 정확도 검사 같은 정밀하고 연속적인 평가 방법론의 이점을 받아, 추출된 정보가 ground truth와 얼마나 정확히 일치하는지 평가해요. 명시적인 성공 기준과 상세한 루브릭을 정의해요. 그러면 모델이 안정적이고 반복 가능한 개선을 얻을 수 있어요.
세금 분석의 전문가 수준 추론
Use case
회사: Accordance은 세무, 감사, CPA 팀을 위한 플랫폼을 구축하고 있어요.
해결할 문제: 세무는 매우 복잡한 도메인으로, 미묘한 사실 패턴과 복잡한 규정에 걸친 깊은 추론이 필요해요. 또한 계속 변화하는 분야이기도 해요.
목표: Accordance는 정확성을 유지하면서 정교한 세무 시나리오를 위한 높은 신뢰도 시스템을 원했어요. 전통적인 하드코딩 소프트웨어와 달리, 데이터 추출 도구가 세무 환경이 진화함에 따라 적응하는 것이 중요해요.
Grader code
[+0.05] For correctly identifying Alex (33.33%), Barbara (33.33% → 20%), Chris (33.33%), and Dana (13.33%) ownership percentages
[+0.1] For correctly calculating Barbara's annual allocation as 26.67% and Dana's as 6.67% without closing of books
[+0.15] For properly allocating Alex ($300,000), Barbara ($240,030), Chris ($300,000), and Dana ($60,030) ordinary income
[+0.1] For calculating Alex's ending stock basis as $248,333 and debt basis as $75,000
[+0.05] For calculating Barbara's remaining basis after sale as $264,421
[+0.1] For calculating AAA before distributions as $1,215,000 and ending AAA as $315,000
[+0.1] For identifying all distributions as tax-free return of capital under AAA
[+0.1] For calculating Barbara's capital gain on stock sale as $223,720 ($400,000 - $176,280)
[+0.1] For explaining that closing of books would allocate based on actual half-year results
[+0.05] For identifying the ordering rules: AAA first, then E&P ($120,000), then remaining basis
[+0.05] For noting distributions exceeding $1,215,000 would be dividends up to $120,000 E&P
[+0.05] For correctly accounting for separately stated items in basis calculations (e.g., $50,000 Section 1231 gain)
Results
OpenAI 및 자체 세무 전문가와 협력해 Accordance는 다음을 달성했어요:
- 베이스 모델 대비 세무 분석 작업에서 거의 40% 개선
- TaxBench 같은 벤치마크에서 다른 모든 주요 모델보다 우수한 성능
- RFT로 훈련된 모델은 고급 세무 시나리오를 높은 정확도로 처리할 수 있는 능력을 보여줬어요 — 세무 전문가가 평가했을 때 Accordance의 파인튜닝 모델은 전문가 수준 추론을 보여줬으며, 수천 시간의 수작업을 절약할 잠재력이 있어요.
"우리는 베이스 모델 대비 세무 분석 작업에서 38.89%의 개선을 달성했고, 주요 세무 벤치마크( TaxBench 포함)에서 다른 모든 주요 모델을 크게 능가했습니다. RFT로 훈련된 모델이 정확성을 유지하면서 정교한 세무 시나리오를 처리하는 능력은 강화 파인튜닝 — 그리고 더 넓게는 AI —이 전문가용 애플리케이션에 준비되었음을 보여줍니다. 가장 중요한 것은 RFT가 세무 환경이 진화함에 따라 지속적인 적응을 위한 기반을 제공해 지속적인 가치와 관련성을 보장한다는 것입니다. 세무 전문가가 평가했을 때, 우리의 파인튜닝 모델은 수천 시간의 전문가 시간을 절약할 전문가 수준의 추론 능력을 보여줬습니다 — 이는 단순한 점진적 개선이 아니라 세무 업무를 수행할 수 있는 방식의 패러다임 전환입니다."
—Accordance, AI 세무 회계 회사
미묘한 콘텐츠 중재 정책의 적용
Use case
회사: SafetyKit은 복잡한 콘텐츠 중재 워크플로에서 결정을 내리도록 조직을 돕는 위험 및 규정 준수 플랫폼이에요.
해결할 문제: 이러한 시스템은 대량의 콘텐츠를 처리하고 다단계 추론이 필요한 복잡한 정책 로직을 적용해야 해요. 데이터 양과 라벨링의 미묘한 구분 때문에 이러한 유형의 작업은 일반 목적 모델에게 어려울 수 있어요.
목표: SafetyKit은 강화 파인튜닝 모델로 가장 복잡한 워크플로의 여러 노드를 단일 추론 에이전트로 대체하는 것을 목표로 했어요. 목표는 까다롭고 미묘한 도메인에서도 새 정책 집행에 대한 출시 기간(time-to-market)을 줄이는 것이에요.
Results
SafetyKit은 o3-mini RFT 모델을 사용해 고급 콘텐츠 중재 기능을 지원하며, 세계에서 가장 큰 AI 챗봇 회사 중 하나의 사용자 안전을 보장하고 있어요. F1 점수를 86%에서 90%로 성공적으로 개선했으며, 곧 프로덕션 파이프라인에서 수십 개의 4o 호출을 대체할 예정이에요.
"SafetyKit의 RFT 지원 중재는 동적이고 실세계 시나리오에서 사용자를 보호하는 데 중요한 미묘한 콘텐츠 중재 작업에서 상당한 개선을 달성했습니다."
법적 문서 검토, 비교, 요약
Use case
회사: Thomson Reuters은 신뢰할 수 있는 콘텐츠와 워크플로 자동화로 전문가를 지원하는 AI 및 기술 회사예요.
해결할 문제: 법률 전문가들은 결정을 내리기 전에 많은 콘텐츠를 읽어야 해요. Thomson Reuters의 CoCounsel 제품은 콘텐츠와 산업 지식이 있는 AI 어시스턴트를 제공해 이 전문가들이 더 빠르게 움직이도록 돕기 위해 설계됐어요. 이 도구를 구동하는 모델은 복잡한 법적 규칙을 이해해야 해요.
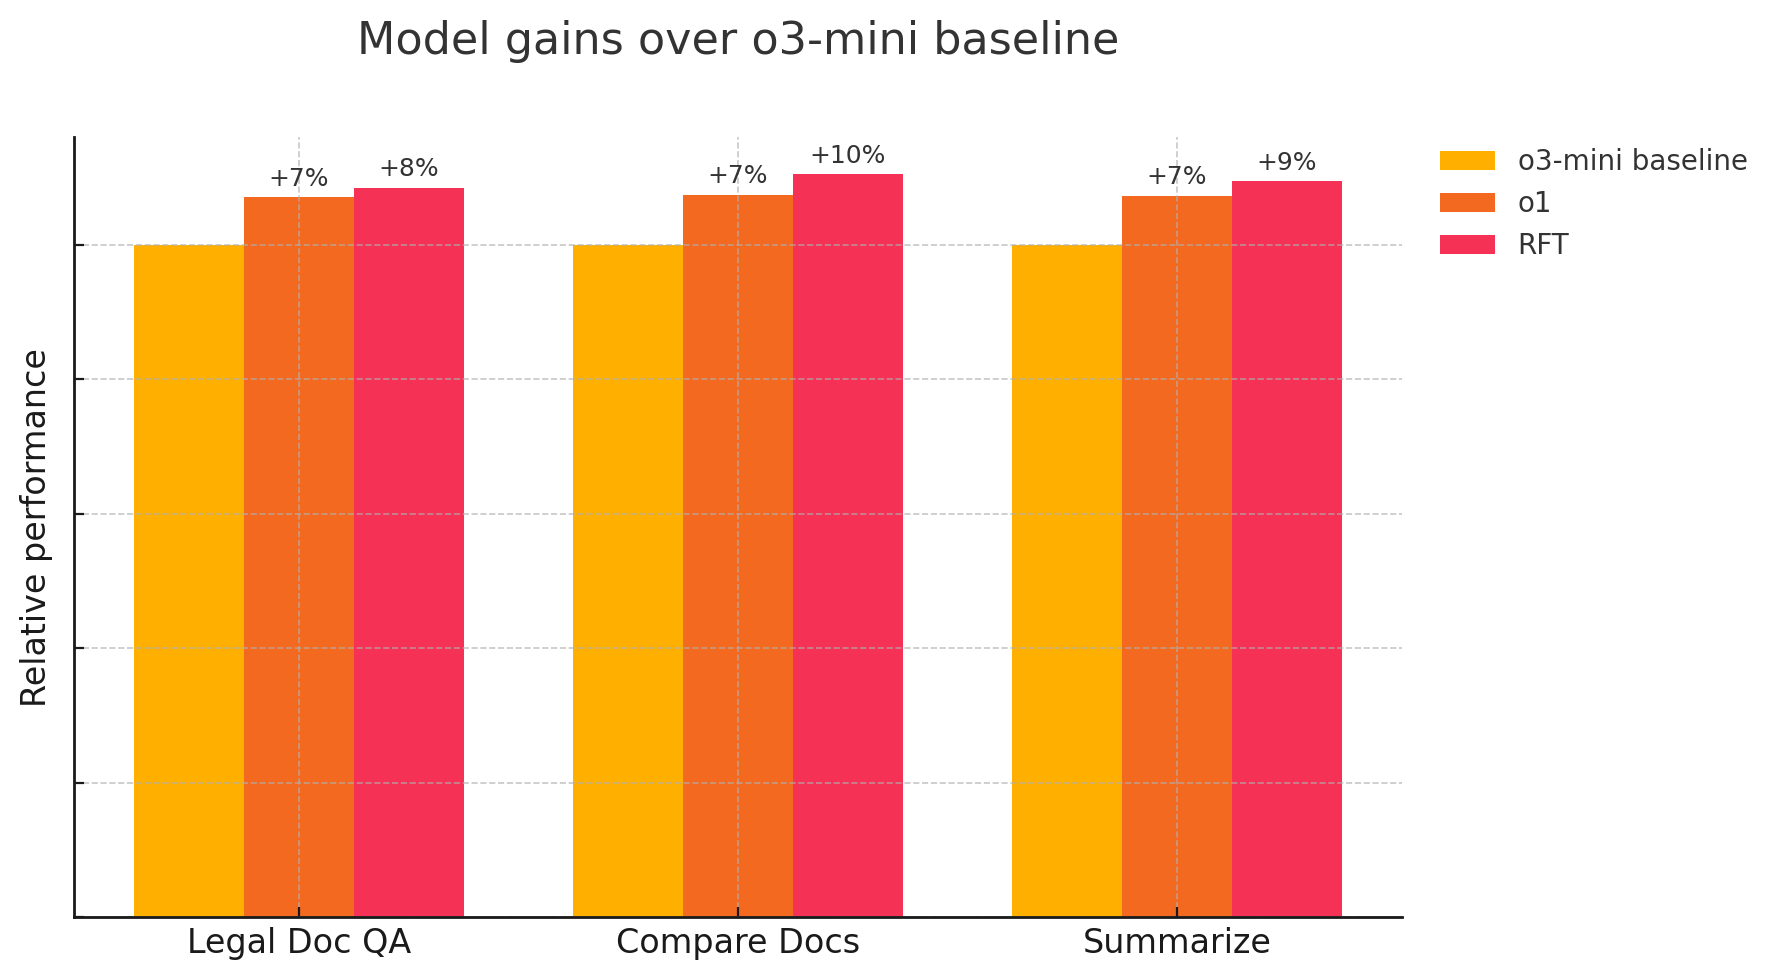
목표: Thomson Reuters는 법적 AI 스킬에서 탁월한 강화 파인튜닝 모델을 만드는 것을 목표로 했어요. 그들은 법률 전문가를 위해 가장 많이 사용되는 세 가지 CoCounsel 법적 AI 스킬의 전문 데이터셋을 사용해 모델 성능 개선을 달성할 수 있는지 RFT의 예비 평가를 수행했어요:
- 절차 검토(Review documents): 계약서, 녹취록, 기타 법적 문서에 대한 질문에 상세한 답변 생성
- 비교(Compare documents): 둘 이상의 다른 계약서 또는 문서 간의 실질적 차이 강조
- 요약(Summarize): 하나 이상의 문서 내 가장 중요한 정보를 요약해 신속한 법적 검토 지원
Results
"LLM as a judge는 reasoning 모델 개선 가능성을 입증하는 데 유용했습니다 — 예비 평가에서 RFT 모델은 기준 o3-mini 및 o1 모델보다 일관되게 더 잘 수행했습니다."
—Thomson Reuters, AI 및 기술 회사
평가가 기반입니다
RFT를 구현하기 전에 파인튜닝하려는 작업에 대한 평가를 만들고 실행할 것을 강력히 권장해요. 파인튜닝하려는 모델이 가능한 최소 또는 최대 점수에서 점수를 받는다면, RFT는 사용자에게 유용하지 않을 거예요.
RFT는 제공된 프롬프트에 대한 더 나은 답변을 강화하는 방식으로 작동해요. 서로 다른 답변의 품질을 구분할 수 없다면(즉, 모두 최소 또는 최대 가능 점수를 받는다면), 학습할 훈련 신호가 없어요. 그러나 평가 점수가 최소와 최대 가능 점수 사이 어딘가에 있다면, 작업할 충분한 데이터가 있는 거예요.
효과적인 평가는 인간 전문가가 일관되게 동의하지만 현재 프론티어 모델이 어려워하는 기회를 드러내며, RFT가 메울 가치 있는 격차를 제시해요. 평가 시작하기.
RFT에서 더 나은 결과를 얻는 방법
파인튜닝된 모델의 개선을 보려면 재검토하고 다듬을 주요 지점이 두 가지 있어요: 작업이 잘 정의되었는지 확인하고, 평가 체계를 더 견고하게 만드는 것.
작업 재구성 또는 명료화하기
좋은 작업은 모델에게 학습할 공정한 기회를 주고 개선을 정량화할 수 있게 해요.
- 모델이 가끔은 이미 해결할 수 있는 작업으로 시작해요. RFT는 많은 답변을 샘플링해서 가장 좋아 보이는 것을 유지하고 모델을 그 답변들 쪽으로 밀어붙이는 방식으로 작동해요. 모델이 오늘 절대 정답을 얻지 못한다면, 개선할 수 없어요.
- 각 답변이 평가될 수 있는지 확인해요. grader는 사람의 개입 없이 답변을 읽고 점수를 만들어야 해요. 우리는 커스텀 Python grader와 LLM judge를 포함한 여러 grader 타입을 지원해요. 사용 가능한 grader로 답변을 판단할 코드를 작성할 수 없다면, RFT는 올바른 도구가 아니에요.
- "정답"에 대한 의심을 제거해요. 신중한 두 사람이 해결책에 대해 자주 동의하지 않는다면, 작업이 너무 모호한 거예요. 도메인 전문가가 동의할 때까지 프롬프트를 다시 쓰거나, 컨텍스트를 추가하거나, 작업을 더 명확한 부분으로 나눠요.
- 운 좋은 추측을 제한해요. 작업이 명백한 최선의 선택이 있는 객관식이라면, 모델이 우연히 이길 수 있어요. 클래스를 더 추가하고, 짧은 개방형 텍스트를 요청하거나, 추측이 비싸도록 형식을 조정해요.
grader 강화하기
명확하고 견고한 평가 체계는 RFT에 필수적이에요.
- 통과/실패 도장이 아니라 부드러운 점수를 만들어요. 답변이 개선됨에 따라 점수가 점진적으로 변하면 더 나은 훈련 신호를 제공해요.
- 보상 해킹(reward hacking)에 대비해요. 이는 모델이 실제 기술 없이 높은 점수를 얻는 지름길을 찾을 때 발생해요.
- 편향된 데이터를 피해요. 한 라벨이 대부분 나타나는 데이터셋은 모델이 그 라벨을 추측하도록 유도해요. 모델이 생각해야 하도록 세트를 균형 있게 만들거나 희귀한 경우에 가중치를 높여요.
- 코드가 부족할 때는 LLM judge를 사용해요. 풍부하고 개방형 답변의 경우 [별도의 OpenAI 모델이]파인튜닝된 모델의 답변을 평가](https://developers.openai.com/api/docs/guides/graders#model-graders)하게 해요. 다음을 확인해요:
- Judge 평가하기: 여러 후보 응답과 정답을 LLM judge에 통과시켜 반환된 점수가 안정적이고 선호도와 일치하는지 확인해요.
- Few-shot 예시 제공하기: 훌륭한, 공정한, 나쁜 답변을 프롬프트에 포함해 grader의 효과를 개선해요.
기타 리소스
더 많은 영감을 얻으려면 예제 코드와 서드파티 리소스 링크가 있는 OpenAI Cookbook을 방문하거나, 모델과 reasoning 기능에 대해 더 알아보세요: