Cost optimization
Cost optimization (비용 최적화)
어떤 API를 선택할지 정해 사용량이 어떻게 측정되는지 이해하고, 음성 애플리케이션의 비용을 관리하는 방법을 찾으세요.
출처: 문서
본문
GPT-Live 사용량과 비용
GPT-Live는 음성 대화와, reasoning·도구를 실행하는 백엔드를 분리해요. 이 두 비용을 별도로 추정하세요: 음성 세션은 지속 시간에 의존하고, 백엔드 비용은 사용하는 모델과 도구에 의존해요.
음성 세션 비용
GPT-Live 음성 세션은 현재 모델 요금으로 초당 청구돼요. 세션 지속 시간은 다음 전체 분으로 반올림되지 않아요.
활성 세션 시간은 사용자가 말하는 시간, 어시스턴트가 말하는 시간, 둘 다 침묵하는 시간, 백엔드가 작업하는 시간을 포함해요.
추정 시 시작부터 종료까지 활성 세션을 세어보세요. 재생하는 오디오만 타이밍하지 말고 API가 보고하는 지속 시간을 사용하세요. 마이크 입력을 음소거해도 세션은 닫히지 않아요. 대화가 끝나면 세션을 닫고 최종 사용량을 수집하세요.
백엔드 모델과 도구 가격은 API 가격을 참고하세요.
WebRTC 초기화 요금
WebRTC 세션을 만들기 위한 POST /v1/live/sessions 요청은 세션이 초기화되는 동안 음성 지속 시간 15초를 청구해요. 그 금액은 세션이 실행되기 시작하면 지속 시간 요금에서 크레딧(차감)돼요. 비용을 추정할 때 실행 세션의 지속 시간에 15초를 더하지 마세요.
예를 들어 아래 90초 세션에는 초기화 시 청구된 15초가 이미 포함돼요. 105초로 청구되지 않아요. 재연결이나, 사용자가 말할 준비가 되기 전에 세션을 만드는 애플리케이션을 평가할 때 세션 생성 요금을 고려하세요.
백엔드 비용
백엔드 호출은 음성이 없는 애플리케이션에서처럼 음성 세션과 별도로 청구돼요. 모델 입력·출력 토큰, 지원되는 경우 캐시된 입력, 적용 가능한 이미지·도구 요금을 포함하세요. 애플리케이션이 다른 서비스를 호출한다면 그 비용도 추정에 포함하세요.
이 작업은 음성 프론트엔드와 별도로 최적화할 수 있어요. 요청과 토큰 사용을 줄이려면 일반 비용 최적화 가이드를 사용하세요. 적격 백엔드 모델에는 재사용 가능한 지시, 도구 정의, 기타 안정적인 콘텐츠를 프롬프트 시작 부분에 유지해 프롬프트 캐싱을 사용하세요.
백엔드 선택은 대화 길이도 바꿀 수 있어요. 최적화가 사용자를 더 오래 기다리게 하거나 어시스턴트가 작업을 완료하는 신뢰성을 바꾸면 결합 비용을 비교하세요.
대화 비용 추정
음성 세션 하나가 있는 대화의 경우:
총 비용 = (청구 가능한 음성 초 ÷ 60 × 분당 음성 요금) + 백엔드 비용
예를 들어 예시 음성 요금이 분당 $0.05일 때 90초 음성 세션은 $0.075예요. 백엔드 모델과 도구 비용이 총 $0.02라면 대화 비용은 $0.095예요.
| 컴포넌트 | 계산 | 비용 |
|---|---|---|
| 음성 세션 | 90초 ÷ 60 × $0.05 | $0.075 |
| 백엔드 작업 | 모델·도구 비용 합계 | $0.02 |
| 대화 합계 | $0.075 + $0.02 | $0.095 |
위 요금과 백엔드 비용은 예시예요. 현재 음성 요금, 측정된 백엔드 사용량, 적용되는 모델·도구 요금을 사용하세요. 작업이 여러 음성 세션에 걸친다면 지속 시간을 더하고 세션 사이에 수행된 백엔드 작업을 포함하세요.
최적화 전략
사용자가 불필요한 대화와 대기 없이 작업을 완료하도록 돕는 데 집중하세요. 작업이 요구하는 확인과 검사는 유지하세요.
세션 전에 관련 컨텍스트 제공
음성 세션을 시작하기 전에 애플리케이션이 이미 사용할 권한이 있는 정보를 수집하세요. 예를 들어 주문을 돕는 어시스턴트는 주문 번호와 현재 상태로 시작해서, 사용자가 그것을 반복하거나 또 다른 조회를 기다릴 필요가 없게 해요.
이 컨텍스트를 현재 상태로 유지하고 작업에 집중하세요. 음성 모델에게 대화에 필요한 정보를 주고, 상세 기록과 워크플로는 백엔드에 두세요. 세션 구성과 위임과 도구를 참고하세요.
도구 대기 시간 줄이기
더 짧은 대기는 사용자 경험을 개선하고 음성 세션 비용을 줄일 수 있어요. 예를 들어 백엔드가 Fast mode로 gpt-5.6-luna를 사용하고 독립 도구 호출을 병렬로 실행한다고 가정해보세요. 이 최적화가 사용자가 음성 세션을 1분 더 일찍 끝내고 닫게 해주면 음성 요금이 $0.05 절약돼요. 추가 백엔드 비용이 그 절약보다 작다면 총 비용이 줄어들어요.
또한 위임 이벤트가 도착하기 전에 트랜스크립트 조각에서 예측 조회를 시작할 수도 있어요. 사용되지 않은 예측 작업을 백엔드 비용 측정에 포함하세요.
모델, 연결, 스트리밍, 도구 최적화는 백엔드 지연 줄이기를 참고하세요. 유용한 음성 응답 시간과 작업 성공을 음성 에이전트 평가로 검증하세요.
긴 작업 중 세션 닫기
음성 프론트엔드와 애플리케이션이 관리하는 백엔드는 독립적으로 실행될 수 있어요. 클라이언트 위임을 사용하면 음성 세션이 열려 있거나 닫혀 있는 동안 백엔드 워커가 계속 실행될 수 있어요. 음성 세션 닫기 전에 작업 상태와 대화 컨텍스트를 저장하세요.
비활성 타임아웃, 재시작 트리거, 컨텍스트 복원 워크플로는 유휴 세션 닫기와 재개를 참고하세요.
앰비언트 에이전트의 경우 백엔드가 목표 모드 코딩 같은 장기 실행 작업을 처리하는 동안 음성 세션을 닫으세요. 사용자가 돌아올 때 대화 재개(Resume conversation) 라벨의 버튼을 제공해 새 음성 세션을 시작하게 하거나, 백엔드 완료 이벤트로 새 세션을 시작하고 결과가 준비됐음을 사용자에게 알리세요.
저장된 컨텍스트와 검증된 작업 결과를 input으로 포함한 새 세션을 시작해 대화를 복원하세요. 예를 들어 새 WebSocket 연결로 이 시작 이벤트를 보내세요.
{
  "type": "session.start",
  "session": {
    "model": "gpt-live-1",
    "instructions": "Help the user review completed work and delegate follow-up tasks.",
    "input": [
      {
        "type": "message",
        "role": "developer",
        "content": [
          {
            "type": "input_text",
            "text": "Saved task: add CSV export. Result: code is ready for review."
          }
        ]
      }
    ],
    "delegation": { "type": "client" }
  }
}
오디오를 스트리밍하기 전에 session.started를 기다리세요. 지원되는 기록 형식은 이전 대화로 세션 시드를 참고하세요.
이전 세션이 store: true로 저장됐다면 그 세션을 포크할 수도 있어요. 어떤 접근을 쓰든 검증된 백엔드 작업 상태를 애플리케이션에 유지하세요.
닫기는 유휴 음성 시간 1분당 $0.05를 절약해요. 그 절약을 재연결 비용과 사용자 경험의 중단과 비교하세요.
올바른 백엔드 모델 선택
작업의 정확성과 신뢰성 요구를 충족하는 모델부터 시작하세요. 그런 다음 음성 지속 시간, 모델 사용량, 도구 호출, 재시도를 포함한 총 대화 비용을 비교하세요. 모델 선택 가이드가 이러한 트레이드오프를 균형 잡는 방법을 설명해요.
더 큰 백엔드 모델이 더 빨리 작업을 완료하고 음성 세션 절약이 추가 토큰 비용을 초과하면 전체적으로 더 저렴할 수 있어요. 더 싼 모델이 더 오래 걸리거나, 도구 호출을 반복하거나, 작업을 실패하면 전체적으로 더 비쌀 수 있어요.
성공한 작업당 비용을 완료율 및 완료 시간과 함께 비교하세요. 실패한 시도와 재시도를 합계에 포함해서, 더 싼 구성이 더 적은 작업을 완료해서 더 좋아 보이지 않게 하세요. 비교를 계획할 때 음성 에이전트 평가 Cookbook을 사용하세요.
실제 사용량 모니터링
각 세션에 대해 음성 지속 시간과 백엔드 사용량을 별도로 기록하세요. GPT-Live는 누적 음성 지속 시간을 초 단위로 보고해요.
{
  "type": "session.usage.updated",
  "event_id": "event_usage_1",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
각 업데이트는 이전 지속 시간 스냅샷을 교체해요. 스냅샷을 합산하지 마세요. session.close를 보낸 후 session.closed까지 계속 이벤트를 받고 최종 usage.seconds를 한 번 기록하세요. 우아한 종료 절차를 따라 애플리케이션이 연결 해제 전에 최종 사용량을 수집할 수 있게 하세요.
Responses 위임의 경우 response.event를 통해 전달되는 중첩 response.completed 이벤트에서 백엔드 응답의 usage를 읽으세요. 응답 ID를 사용해 각 백엔드 응답을 한 번 세고, 그 모델의 요금을 적용하는 데 필요한 입력, 출력, 캐시 토큰 세부 사항을 유지하세요. 애플리케이션이 독립적으로 실행하는 백엔드 작업의 경우 그 요청에서도 사용량을 수집하세요.
대표 대화에 걸쳐 추정값과 실제 합계를 비교하세요. 평가 전용 모델 호출을 애플리케이션 사용량과 분리하고, 비용을 작업 성공과 함께 검토하세요.
Realtime API 비용
이 문서는 Realtime API 청구가 어떻게 동작하는지 설명하고 비용 최적화 전략을 제공해요. 음성 에이전트 세션은 텍스트, 오디오, 이미지 모달리티에 걸쳐 입력·출력 토큰을 누적해요. 스트리밍 번역·스트리밍 전사 세션은 오디오 지속 시간으로 청구돼요. 가격은 모델별로 다르며, 모델 페이지에 나열돼 있어요 (예: gpt-realtime-2, gpt-realtime-translate, gpt-realtime-whisper, gpt-realtime).
대화형 Realtime API 세션은 일련의 턴(turns) 이에요. 사용자가 입력을 추가해 _Response_를 트리거해 모델 출력을 생성해요. 서버는 다음 턴의 입력을 형성하는 Items 목록인 Conversation 을 유지해요. Response가 반환되면 출력이 자동으로 Conversation에 추가돼요.
번역·전사 세션은 다른 스트리밍 아키텍처를 사용해요. 클라이언트는 오디오를 지속적으로 스트리밍하고, 소스 오디오가 도착할 때 번역된 오디오, 트랜스크립트 델타, 트랜스크립트 이벤트를 받아요. 이 세션들은 일반 Response 생애 주기를 사용하지 않으므로, Response별 토큰 사용량 대신 지속 시간 기반 요금으로 추정·모니터링하세요.
Response별 비용
Realtime API 비용은 Response가 생성될 때 누적되며 입력·출력 토큰 수에 따라 청구돼요 (입력 전사 비용은 아래 참고). 현재 네트워크 대역폭이나 연결에는 비용이 없어요. Response는 수동으로 또는 음성 활동 감지(VAD)가 켜져 있으면 자동으로 생성될 수 있어요. VAD는 빈 입력 오디오를 효과적으로 걸러내므로, 클라이언트가 대화 입력으로 수동 추가하지 않는 한 빈 오디오는 입력 토큰으로 계산되지 않아요.
각 Response마다 전체 대화가 모델로 전송돼요. 한 턴의 출력은 서버 Conversation에 Items로 추가되어 이후 턴의 입력이 되므로, 세션 후반의 턴이 더 비싸요.
텍스트 토큰 비용은 토크나이저 도구로 추정할 수 있어요. 사용자 메시지의 오디오 토큰은 오디오 100ms당 1토큰이고, 어시스턴트 메시지의 오디오 토큰은 오디오 50ms당 1토큰이에요. 토큰 수에는 메시지 콘텐츠 외의 특수 토큰이 포함되며, 이는 이러한 수에 작은 변동으로 나타나요. 예를 들어 콘텐츠 10 텍스트 토큰의 사용자 메시지는 12토큰으로 계산될 수 있어요.
예시
다중 턴 Realtime API 세션의 토큰 비용을 설명하는 간단한 예시예요.
대화의 첫 턴에서 지시 100토큰, 사용자 메시지 오디오 토큰 20개(예: 사용자가 말하는 것에 기반해 VAD가 추가)를 추가해 총 120개의 입력 토큰이 됐어요. Response 생성은 어시스턴트 출력 메시지(오디오 20, 텍스트 10 토큰)를 만들어요.
그런 다음 또 다른 사용자 오디오 메시지로 두 번째 턴을 만들면 턴 2의 토큰은 어떻게 될까요? 이 시점의 Conversation에는 초기 지시, 첫 사용자 메시지, 첫 턴의 출력 어시스턴트 메시지, 두 번째 사용자 메시지(오디오 25 토큰)가 포함돼요. 이 턴은 입력에 텍스트 110·오디오 64 토큰, 그리고 또 다른 어시스턴트 출력 메시지의 출력 토큰을 가지게 돼요.
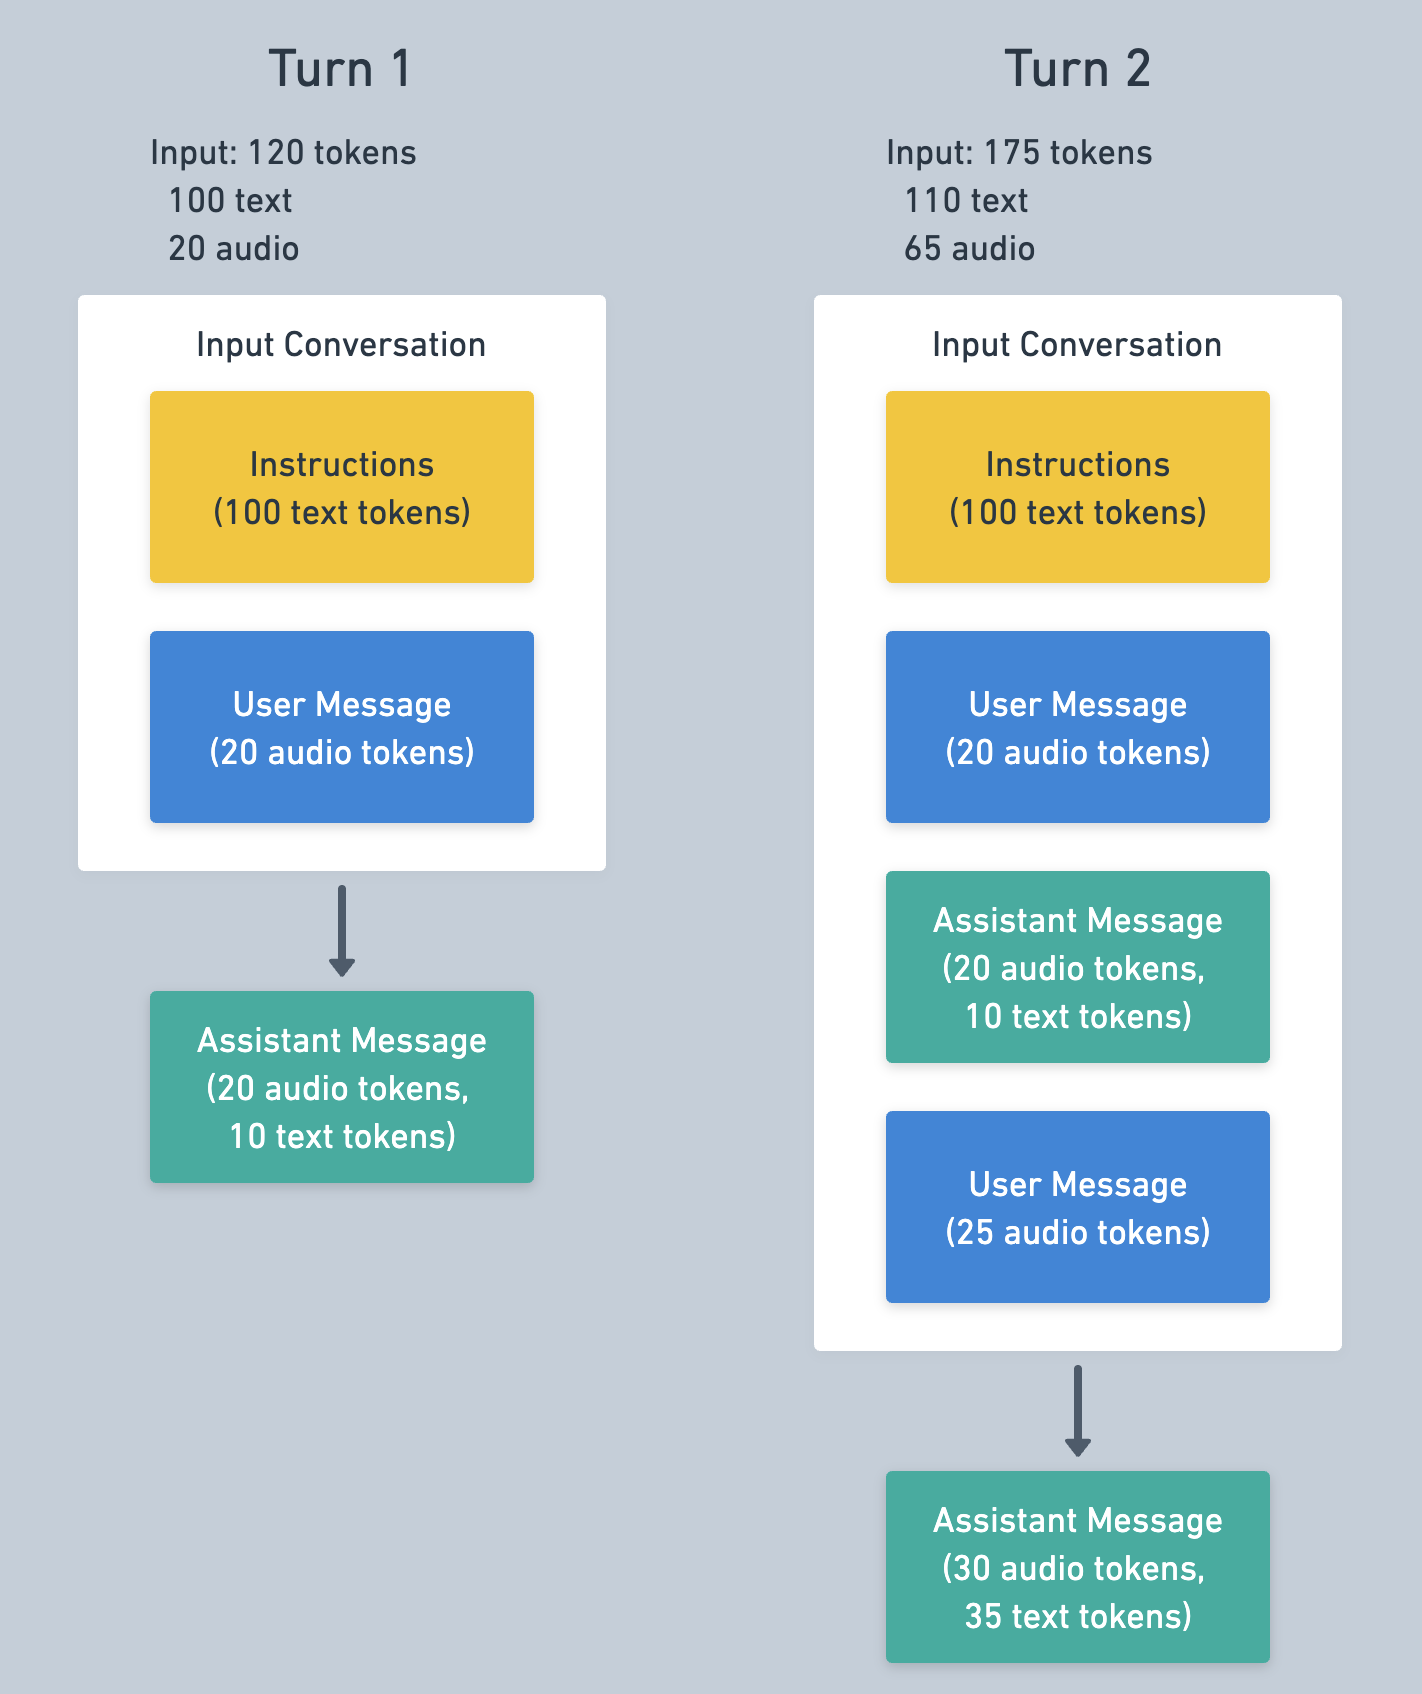
첫 턴의 메시지는 턴 2에서 캐시될 가능성이 높아 입력 비용이 줄어들어요. 캐싱에 대한 자세한 내용은 아래를 참고하세요.
Response에 사용된 토큰은 다음과 같은 response.done 이벤트에서 읽을 수 있어요.
{
  "type": "response.done",
  "response": {
    ...
    "usage": {
      "total_tokens": 253,
      "input_tokens": 132,
      "output_tokens": 121,
      "input_token_details": {
        "text_tokens": 119,
        "audio_tokens": 13,
        "image_tokens": 0,
        "cached_tokens": 64,
        "cached_tokens_details": {
          "text_tokens": 64,
          "audio_tokens": 0,
          "image_tokens": 0
        }
      },
      "output_token_details": {
        "text_tokens": 30,
        "audio_tokens": 91
      }
    }
  }
}
입력 전사 비용
대화형 Responses 외에도 Realtime API는 활성화하면 입력 전사를 청구해요. 입력 전사는 speech2speech 모델과 다른 모델(예: whisper-1 또는 gpt-4o-transcribe)을 사용하므로 다른 요금 카드로 청구돼요. 전사는 오디오가 입력 오디오 버퍼에 쓰여진 후 수동 또는 VAD로 커밋될 때 수행돼요.
입력 전사 토큰 수는 다음 예시처럼 conversation.item.input_audio_transcription.completed 이벤트에서 읽을 수 있어요.
{
  "type": "conversation.item.input_audio_transcription.completed",
  ...
  "transcript": "Hi, can you hear me?",
  "usage": {
    "type": "tokens",
    "total_tokens": 26,
    "input_tokens": 17,
    "input_token_details": {
      "text_tokens": 0,
      "audio_tokens": 17
    },
    "output_tokens": 9
  }
}
캐싱
Realtime API는 프롬프트 캐싱을 지원하며, 자동으로 적용되어 다중 턴 세션 중 입력 토큰 비용을 크게 줄일 수 있어요. 캐싱은 Response의 입력 토큰이 이전 Response의 토큰과 일치할 때 적용되지만, 최선 노력(best-effort)이며 보장되지 않아요.
캐시율을 최대화하는 최선의 전략은 세션 기록을 정적으로 유지하는 것이에요. 대화에서 콘텐츠를 제거하거나 변경하면 변경 지점까지 캐시가 "버스트(bust)"되고, 입력이 이전만큼 일치하지 않게 돼요. 지시와 도구 정의는 대화 시작 부분에 있으므로, 세션 중간에 이를 변경하면 이후 턴의 캐시율이 낮아져요.
잘림 (Truncation)
대화의 토큰 수가 모델의 입력 토큰 한도를 초과하면 대화가 잘려서 메시지(가장 오래된 것부터)가 Response 입력에서 제거돼요. 최대 출력 토큰 4,096개의 32k 컨텍스트 모델은 잘림 전에 컨텍스트에 28,224 토큰만 포함할 수 있어요.
클라이언트는 모델 최대치보다 작은 토큰 창을 설정할 수 있는데, 이는 토큰 사용량과 비용을 통제하는 좋은 방법이에요. 이것은 token_limits.post_instructions 구성으로 통제돼요 (아래처럼 retention_ratio 타입으로 잘림을 구성하는 경우). 이름이 말하듯, 이는 지시 토큰을 제외하고 Response의 최대 입력 토큰 수를 통제해요. post_instructions를 1,000으로 설정하면 1,000 입력 토큰 한도를 넘는 항목은 Response를 위해 모델에 보내지지 않아요.
잘림은 대화 시작 부근에서 캐시를 버스트시키고, 매 턴 잘림이 발생하면 캐시율이 매우 낮아져요. 이 문제를 완화하기 위해 클라이언트는 필요한 것보다 더 많은 메시지를 제거하도록 잘림을 구성할 수 있는데, 이는 다음 잘림이 필요하기 전까지 여유(headroom)를 늘려요. 이것은 session.truncation.retention_ratio 설정으로 통제할 수 있어요. 서버는 기본값 1.0을 사용하며, 이는 잘림이 필요한 항목만 제거한다는 뜻이에요. 0.8 값은 잘림이 최대의 80%를 유지하고 추가 20%를 제거한다는 뜻이에요.
(주어진 모델에 대해) 세션당 Realtime API 비용을 줄이려면 토큰 수를 제한하고 다음 예시처럼 retention_ratio를 1보다 작게 설정하는 것을 권장해요. 여기서 비용은 낮아지지만 특정 턴의 모델 메모리는 낮아지는 트레이드오프가 있을 수 있다는 점을 기억하세요.
{
  "event": "session.update",
  "session": {
    "truncation": {
      "type": "retention_ratio",
      "retention_ratio": 0.8,
      "token_limits": {
        "post_instructions": 8000
      }
    }
  }
}
잘림은 아래처럼 완전히 비활성화할 수도 있어요. 비활성화하면 Response를 만들기에는 Conversation이 너무 길면 오류가 반환돼요. Conversation 크기를 수동으로 관리하려는 경우에 유용할 수 있어요.
{
  "event": "session.update",
  "session": {
    "truncation": "disabled"
  }
}
기타 최적화 전략
Mini 모델 사용
Realtime speech2speech 모델은 "일반" 크기와, 상당히 더 싼 mini 크기로 제공돼요. 여기서의 트레이드오프는 지시 따르기와 함수 호출과 관련된 지능으로, mini 모델에서는 덜 효과적일 수 있어요. 먼저 더 큰 모델로 애플리케이션을 테스트하고, 애플리케이션과 프롬프트를 다듬은 다음, mini 모델로 최적화를 시도할 것을 권장해요.
Conversation 편집
잘림은 서버에서 자동으로 발생하지만, 또 다른 비용 관리 전략은 Conversation을 수동으로 편집하는 것이에요. API의 원칙 중 하나는 서버 측 Conversation에 대한 완전한 클라이언트 통제를 허용해서, 클라이언트가 원하는 대로 항목을 추가·제거할 수 있게 하는 것이에요.
{
  "type": "conversation.item.delete",
  "item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}
오래된 메시지를 지우는 것은 입력 토큰 크기와 비용을 줄이는 좋은 방법이에요. 이는 중요한 콘텐츠를 제거할 수 있지만, 일반적인 전략은 이 오래된 메시지를 요약으로 대체하는 것이에요. 항목은 위처럼 conversation.item.delete 메시지로 Conversation에서 삭제하고, conversation.item.create 메시지로 추가할 수 있어요.
비용 추정
Realtime API 토큰 사용량의 복잡성 때문에 비용을 사전에 추정하기는 어려울 수 있어요. 좋은 접근 방식은 의도한 프롬프트와 함수로 Realtime Playground를 사용하고, 샘플 세션에 걸쳐 토큰 사용량을 측정하는 것이에요. 세션의 토큰 사용량은 Realtime Playground의 Logs 탭에서 세션 id 옆에서 찾을 수 있어요.