
Eval Alignment
Eval Alignment
메트릭 평가를 인간 어노테이션과 비교해서, 여러분의 판정기가 팀과 얼마나 잘 일치하는지 보세요.
출처: 문서
본문
개요
Eval Alignment는 프로젝트의 메트릭이 같은 항목을 어노테이션하는 인간과 얼마나 자주 일치하는지 측정해요. 인간 어노테이션과 메트릭 평가를 둘 다 가진 모든 큐 항목에서, 페이지는 인간 결과를 접지 진리로 취급하고 일치도를 메트릭별로 집계해요 — 혼동 행렬 뷰(True Positive, False Negative, True Negative, False Positive)를 포함해서요.
Eval Alignment를 이렇게 써요:
- 인간과 일관되게 불일치하는 메트릭을 발견하고, 판정 프롬프트를 조정해요.
- 메트릭을 반복하면서 시간에 따른 정렬 개선을 측정해요.
- 릴리스를 게이트하거나 알림을 발화할 만큼 신뢰할 수 있는 메트릭을 결정해요.
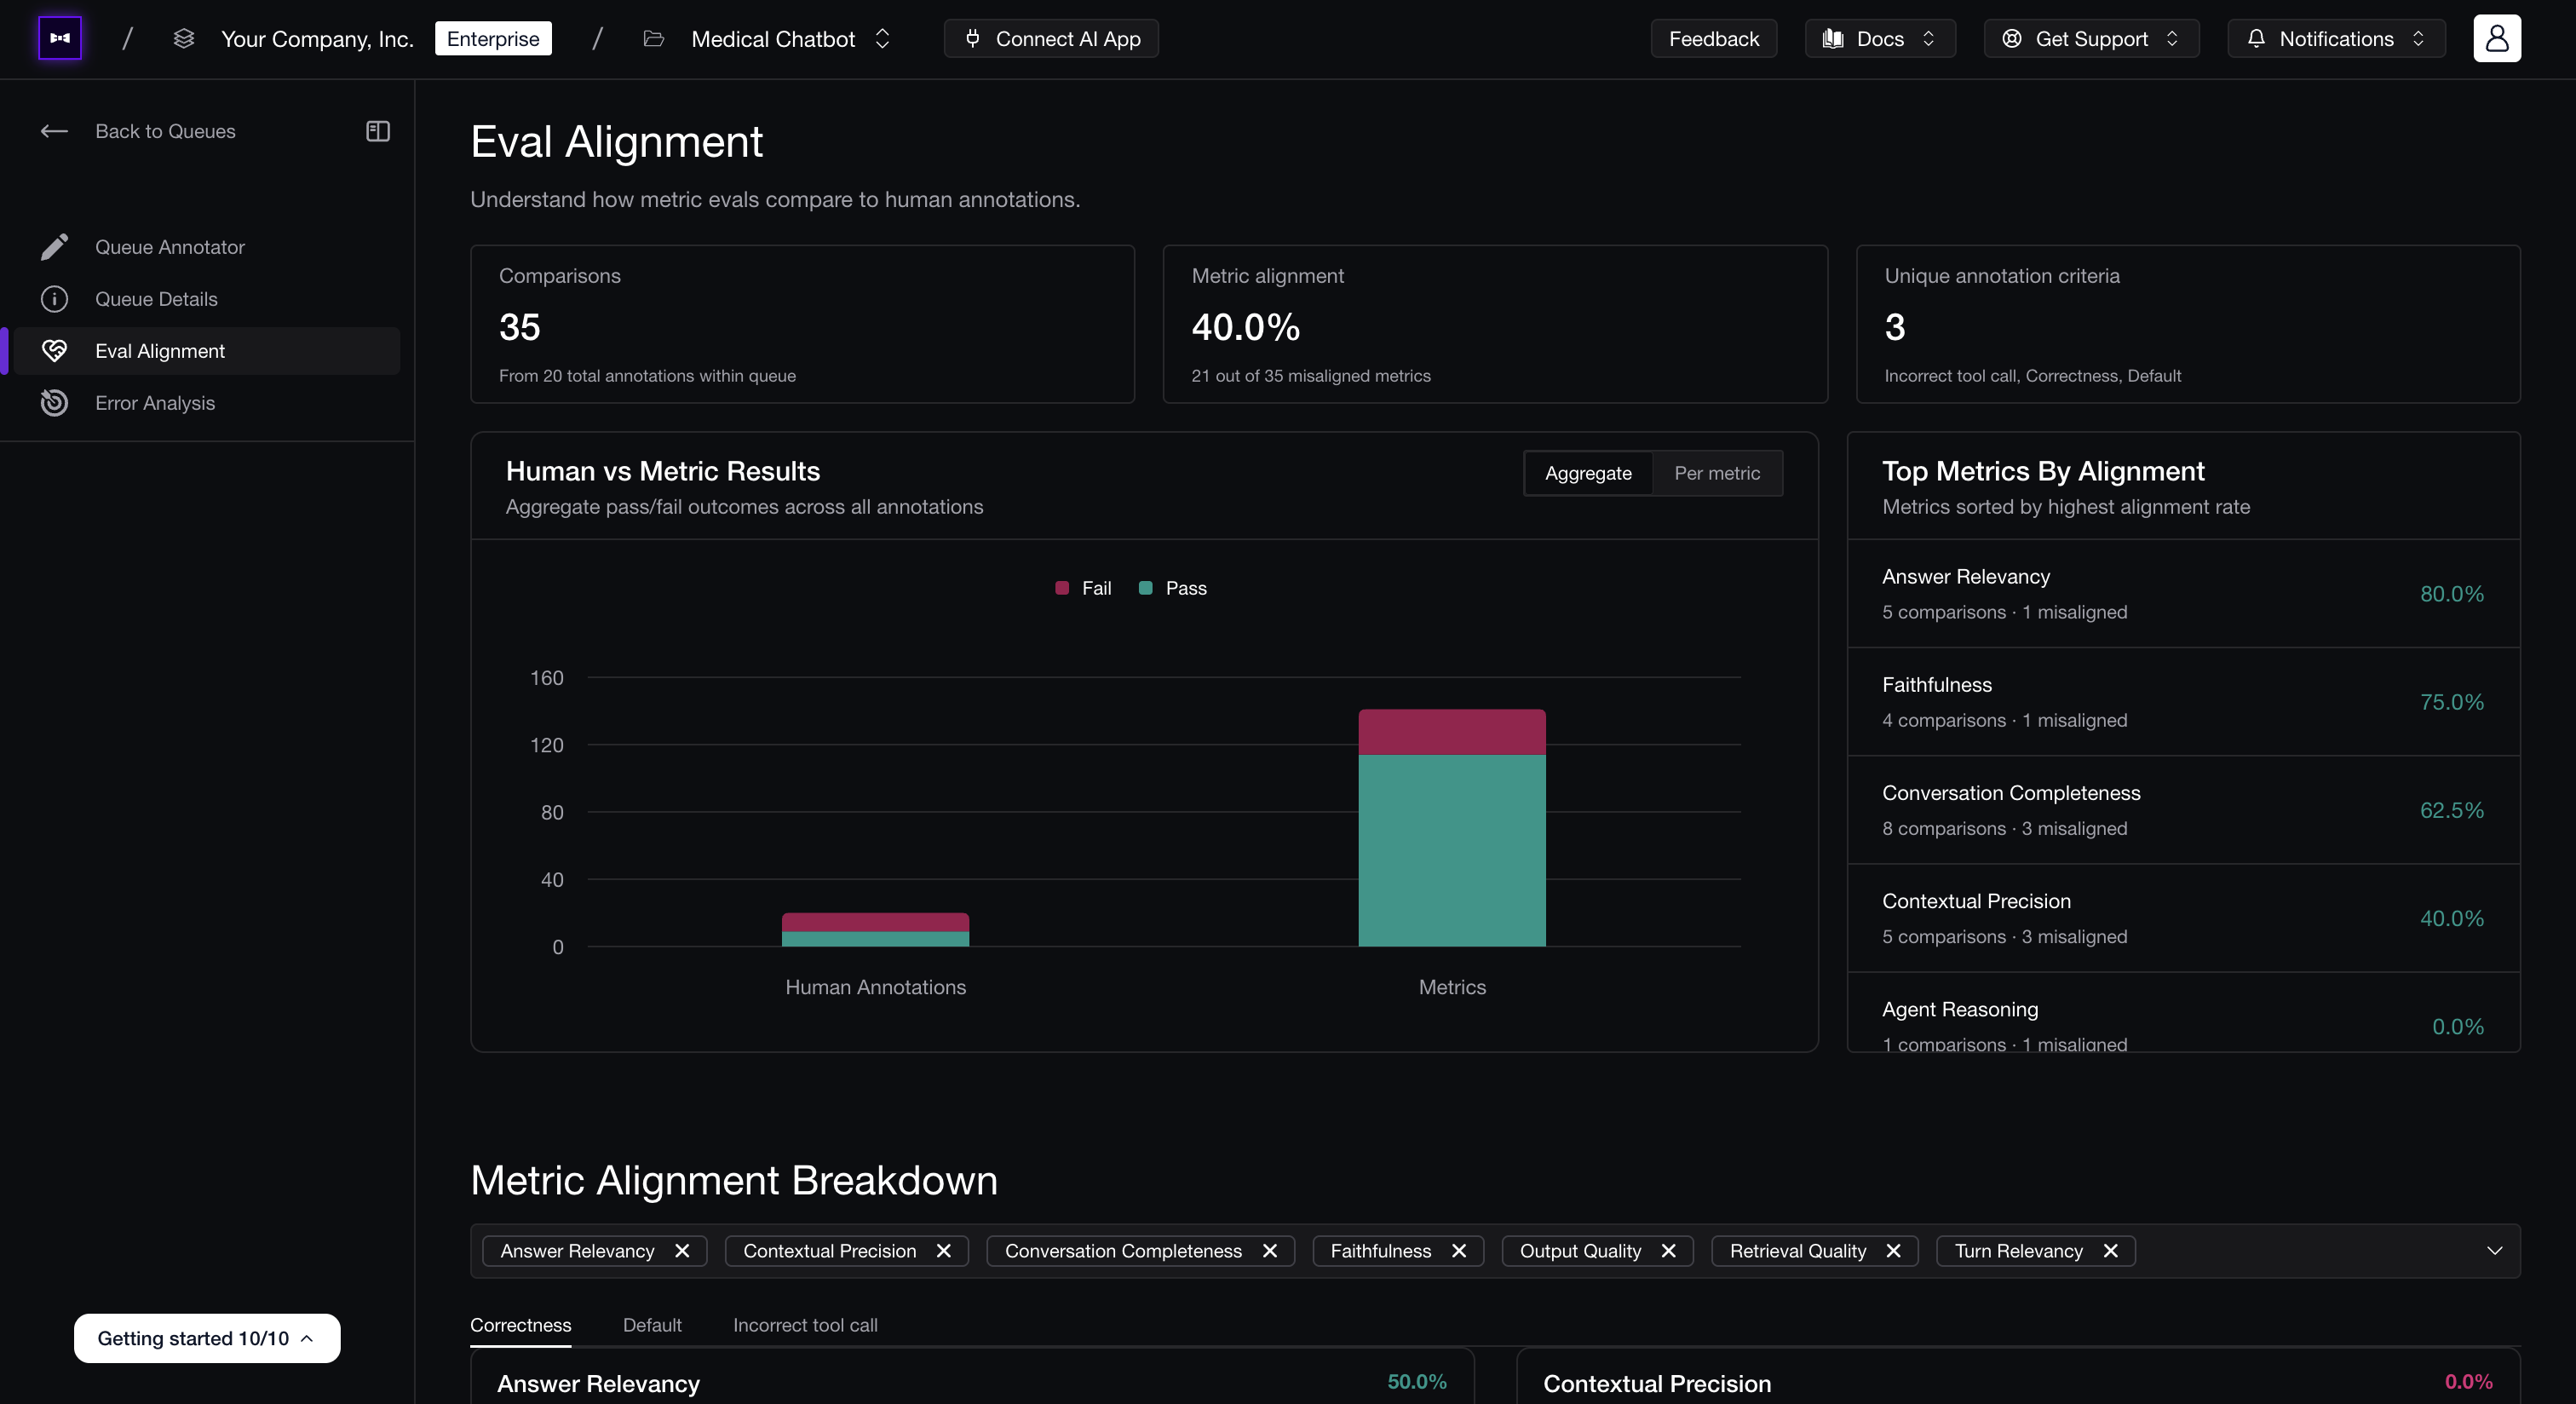
어노테이션 큐의 Eval Alignment 개요
어노테이션 큐의 왼쪽 레일에서 Eval Alignment를 열어요. 페이지는 큐의 최소 한 항목이 인간에게 어노테이션되고 메트릭으로 평가되기 전까지는 데이터가 없어요.
통과/실패 관례
단일 일치 신호를 만들기 위해, 인간 어노테이션과 메트릭 평가를 모두 이진 pass / fail로 정규화해요:
| Source | Pass | Fail |
|---|---|---|
| Human annotation | Thumbs-up, or 3-5 stars | Thumbs-down, or 1-2 stars |
| Metric eval | Score ≥ metric's threshold | Score < metric's threshold |
인간과 메트릭이 pass/fail에 동의하면 비교는 정렬됨(aligned) 이고, 그렇지 않으면 불일치(misaligned) 예요.
페이지에 무엇이 있나요
요약 통계
페이지 상단의 세 카드가 헤드라인을 주어요:
- Comparisons — 인간 어노테이션과 메트릭 평가를 둘 다 가진 항목. 푸터는 큐의 전체 어노테이션 중 몇 개가 기여했는지 보여줘요.
- Metric alignment — 모든 메트릭–인간 비교에 걸친 전체 일치율, 아래에
M out of N misaligned. - Unique annotation criteria — 큐가 쓰는 고유 어노테이션 크라이테리아(예: 어노테이션 루브릭 이름).
집계 vs 메트릭별 뷰
통계 아래의 막대 차트에는 탭 토글이 있어요:
- Aggregate — Human Annotations vs Metrics pass/fail 합계를 나란히. 인간과 메트릭이 같은 전체 결과로 수렴하는지 한눈에 보는 판독이에요.
- Per metric — 정렬율로 정렬된 메트릭당 pass/fail 막대 하나. 집계를 끌어올리거나 내리는 메트릭을 발견할 때 쓰세요.
그 아래 Top Metrics By Alignment가 일치율로 순위가 매겨진 모든 메트릭을, 비교와 불일치 수를 인라인으로 나열해요.
메트릭 정렬 분해
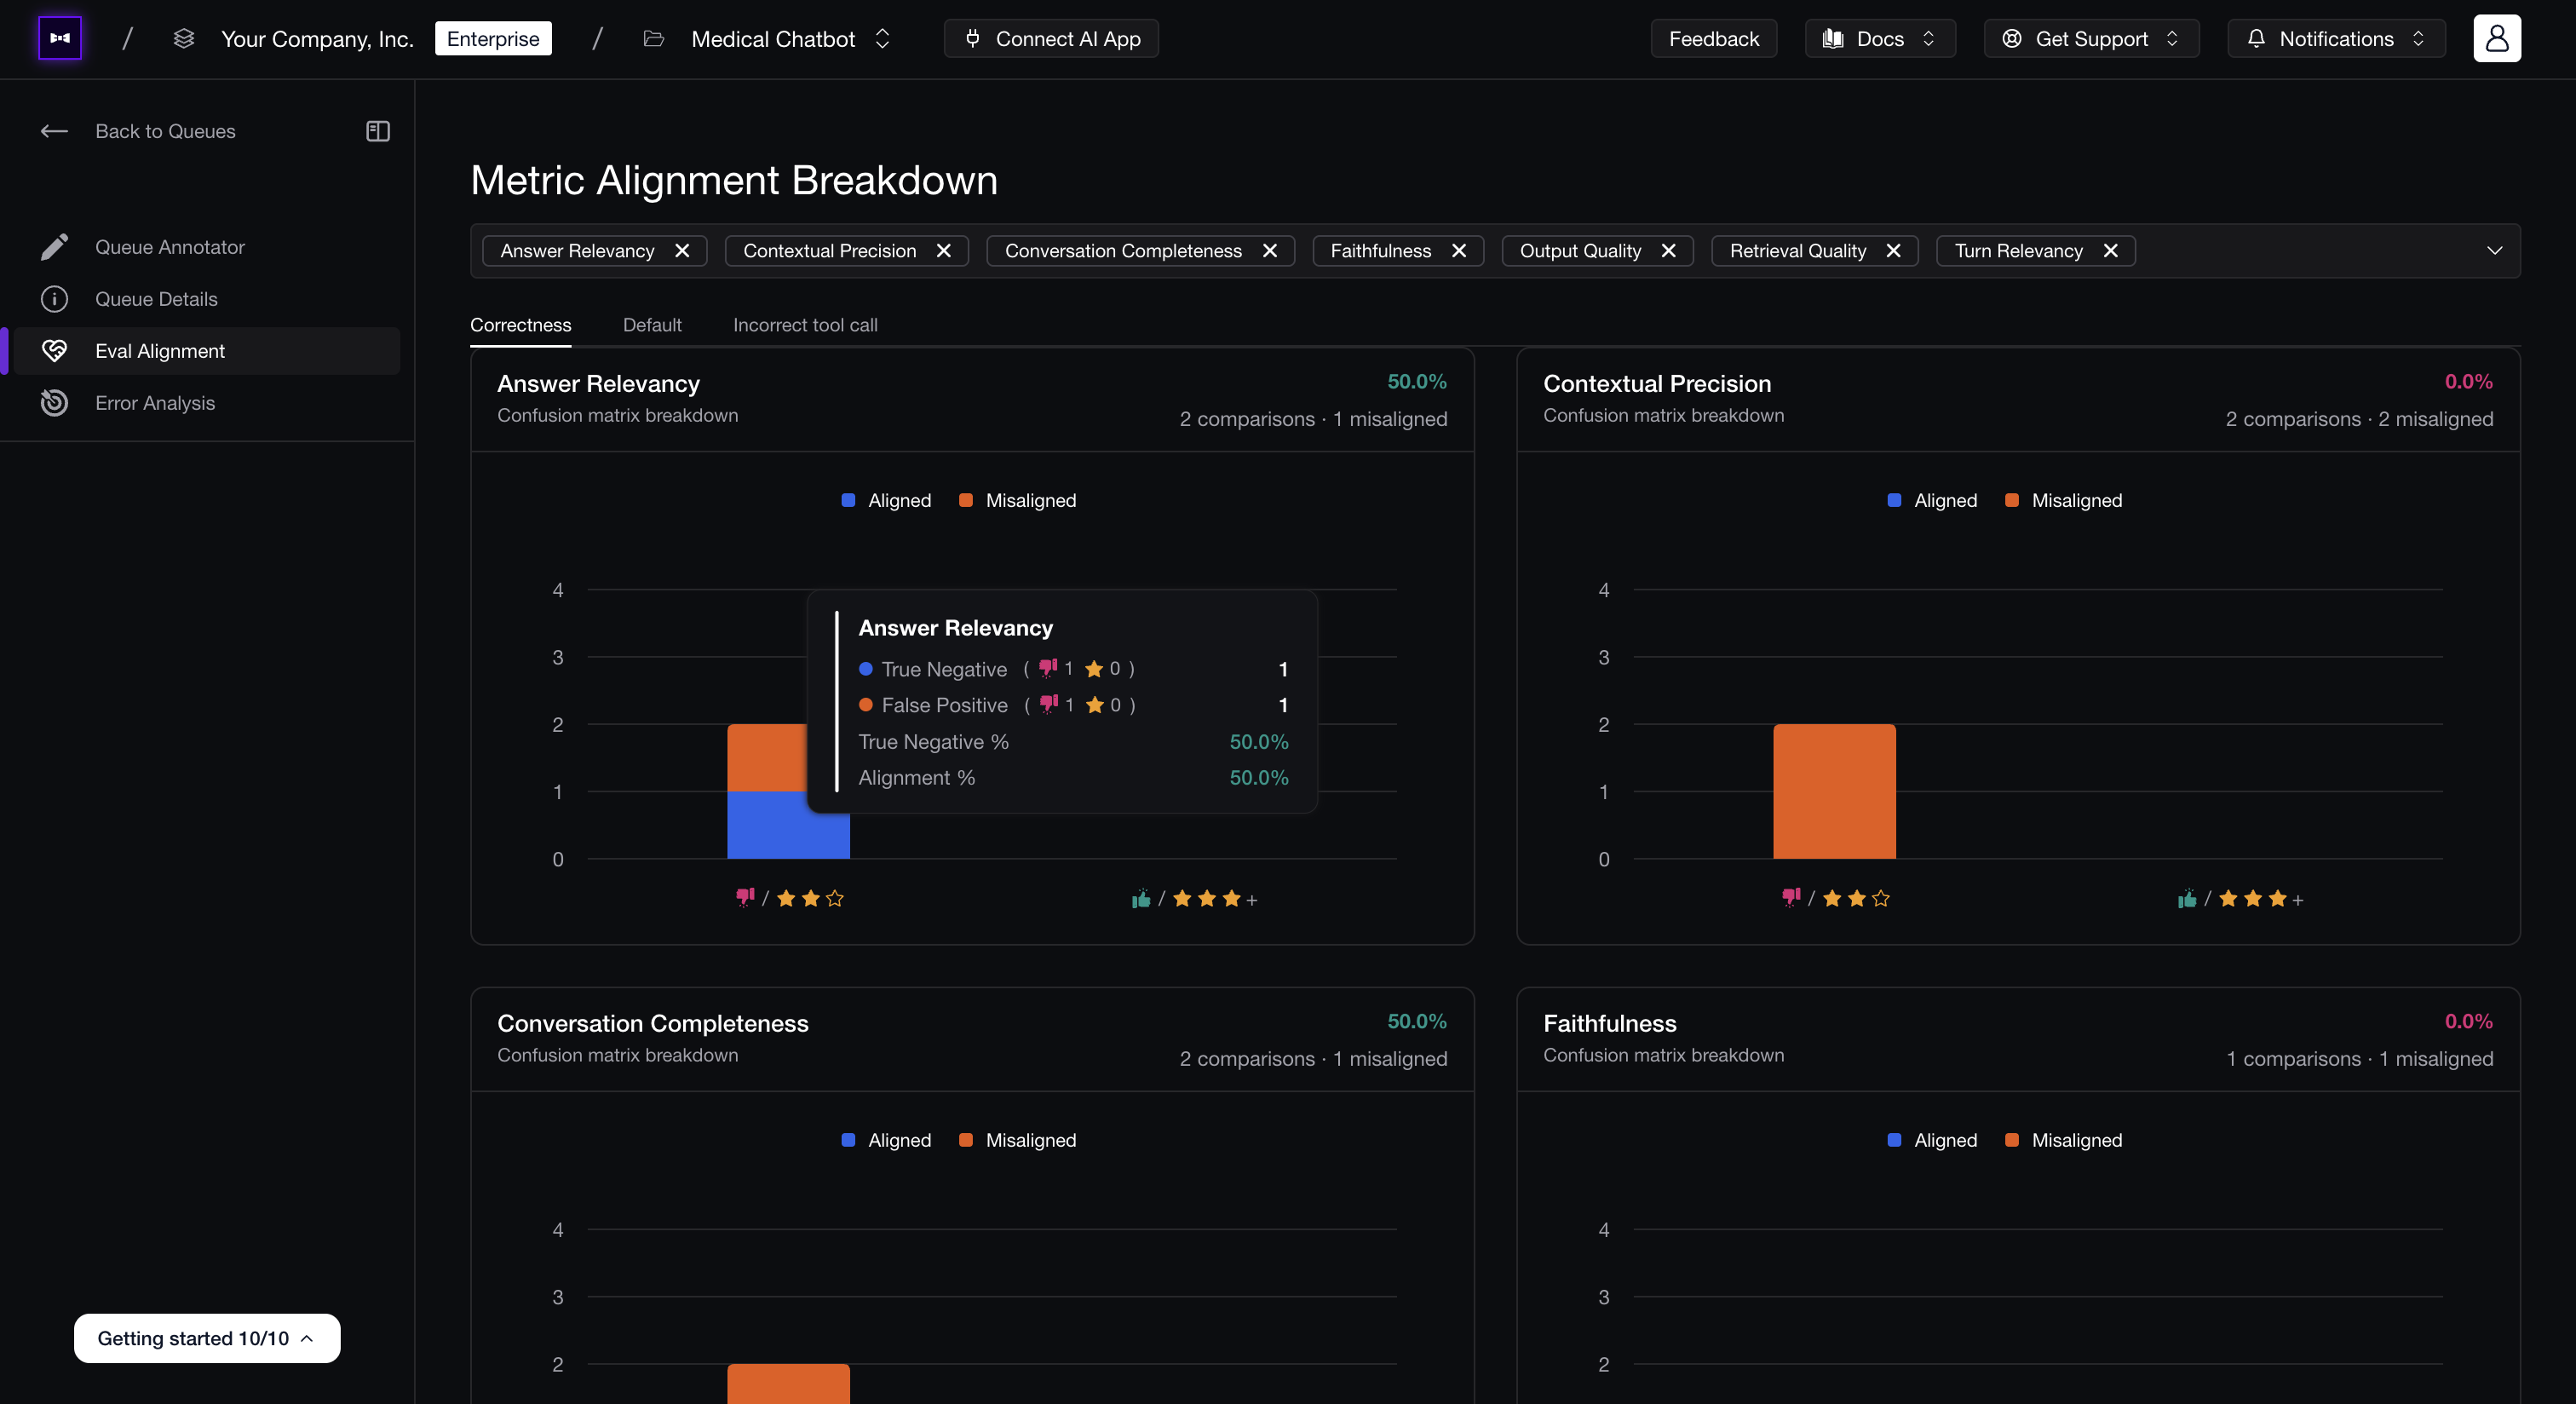
메트릭별 혼동 행렬 분해
Metric Alignment Breakdown 그리드는 메트릭별 간결한 혼동 행렬을, 인간 결과를 접지 진리로 해서 보여줘요:
| Cell | Meaning |
|---|---|
| True Positive | Human said pass, metric said pass. (Aligned.) |
| False Negative | Human said pass, metric said fail. (Misaligned — metric is too strict.) |
| True Negative | Human said fail, metric said fail. (Aligned.) |
| False Positive | Human said fail, metric said pass. (Misaligned — metric is too lenient.) |
각 카드는 색칠된 배지로 일치율을, 비교와 불일치 수를 보여줘요. 막대에 호버하면 기저 어노테이션의 엄지/별점 분해가 드러나서, 불일치가 낮은 신뢰도의 평점에서 오는지 강한 반대에서 오는지 볼 수 있어요.
그리드 상단의 multi-select dropdown을 사용해 메트릭 부분집합에 집중해요. 큐가 하나 이상의 어노테이션 크라이테리아를 쓰면 탭 스트립으로 크라이테리아를 전환할 수 있어요 — 정렬은 크라이테리아마다 독립적으로 계산돼요.
False Negative와 False Positive가 가장 행동 가능한 셀이에요. False-Negative 수가 높으면 보통 메트릭 프롬프트가 너무 엄격하다는 뜻이고, False-Positive 수가 높으면 보통 너무 관대하다는 뜻이에요. 불일치 어노테이션 뒤의 큐 항목을 열고 인간의 설명으로 판정기를 조정하세요.
보여줄 것이 없을 때
인간 어노테이션과 메트릭 평가를 둘 다 가진 큐 항목이 없으면 페이지는 빈 상태를 보여줘요:
No Comparisons Available — Run evaluations and annotate at least one item to start comparing metric evals to human annotations.
채우는 두 가지 방법:
- 큐의 트레이스, 스레드, 스팬에서 온라인 평가를 실행한 뒤 어노테이션해요.
- 먼저 항목을 어노테이션하고, 그 위에서 평가 규칙을 실행해요 — 양쪽이 존재하면 비교가 채워져요.
Annotation Queues
큐를 설정하고, 검토자를 배정하고, 항목을 수동으로 또는 자동 수집으로 추가해요.
Error Analysis
인간 어노테이션을 실패 모드와 메트릭 제안으로 바꿔요.