
트레이스·스팬 평가
트레이스·스팬 평가 (Evaluate Traces & Spans)
개별 트레이스와 스팬에 온라인·오프라인 평가를 즉석에서 실행하는 방법을 다루는 페이지예요. 온라인 평가(online evaluations)는 트레이스와 스팬이 Confident AI에 유입되는 대로 메트릭을 실행해서, AI 품질에 대한 실시간 프로덕션 모니터링을 제공해요. 평가는 Confident AI에서 서버 측으로 실행된답니다.
출처: 문서
본문
개요 (Overview)
온라인 평가(online evaluations)는 트레이스와 스팬이 Confident AI에 유입되는 대로 메트릭을 실행해서, AI 품질에 대한 실시간 프로덕션 모니터링을 제공해요.
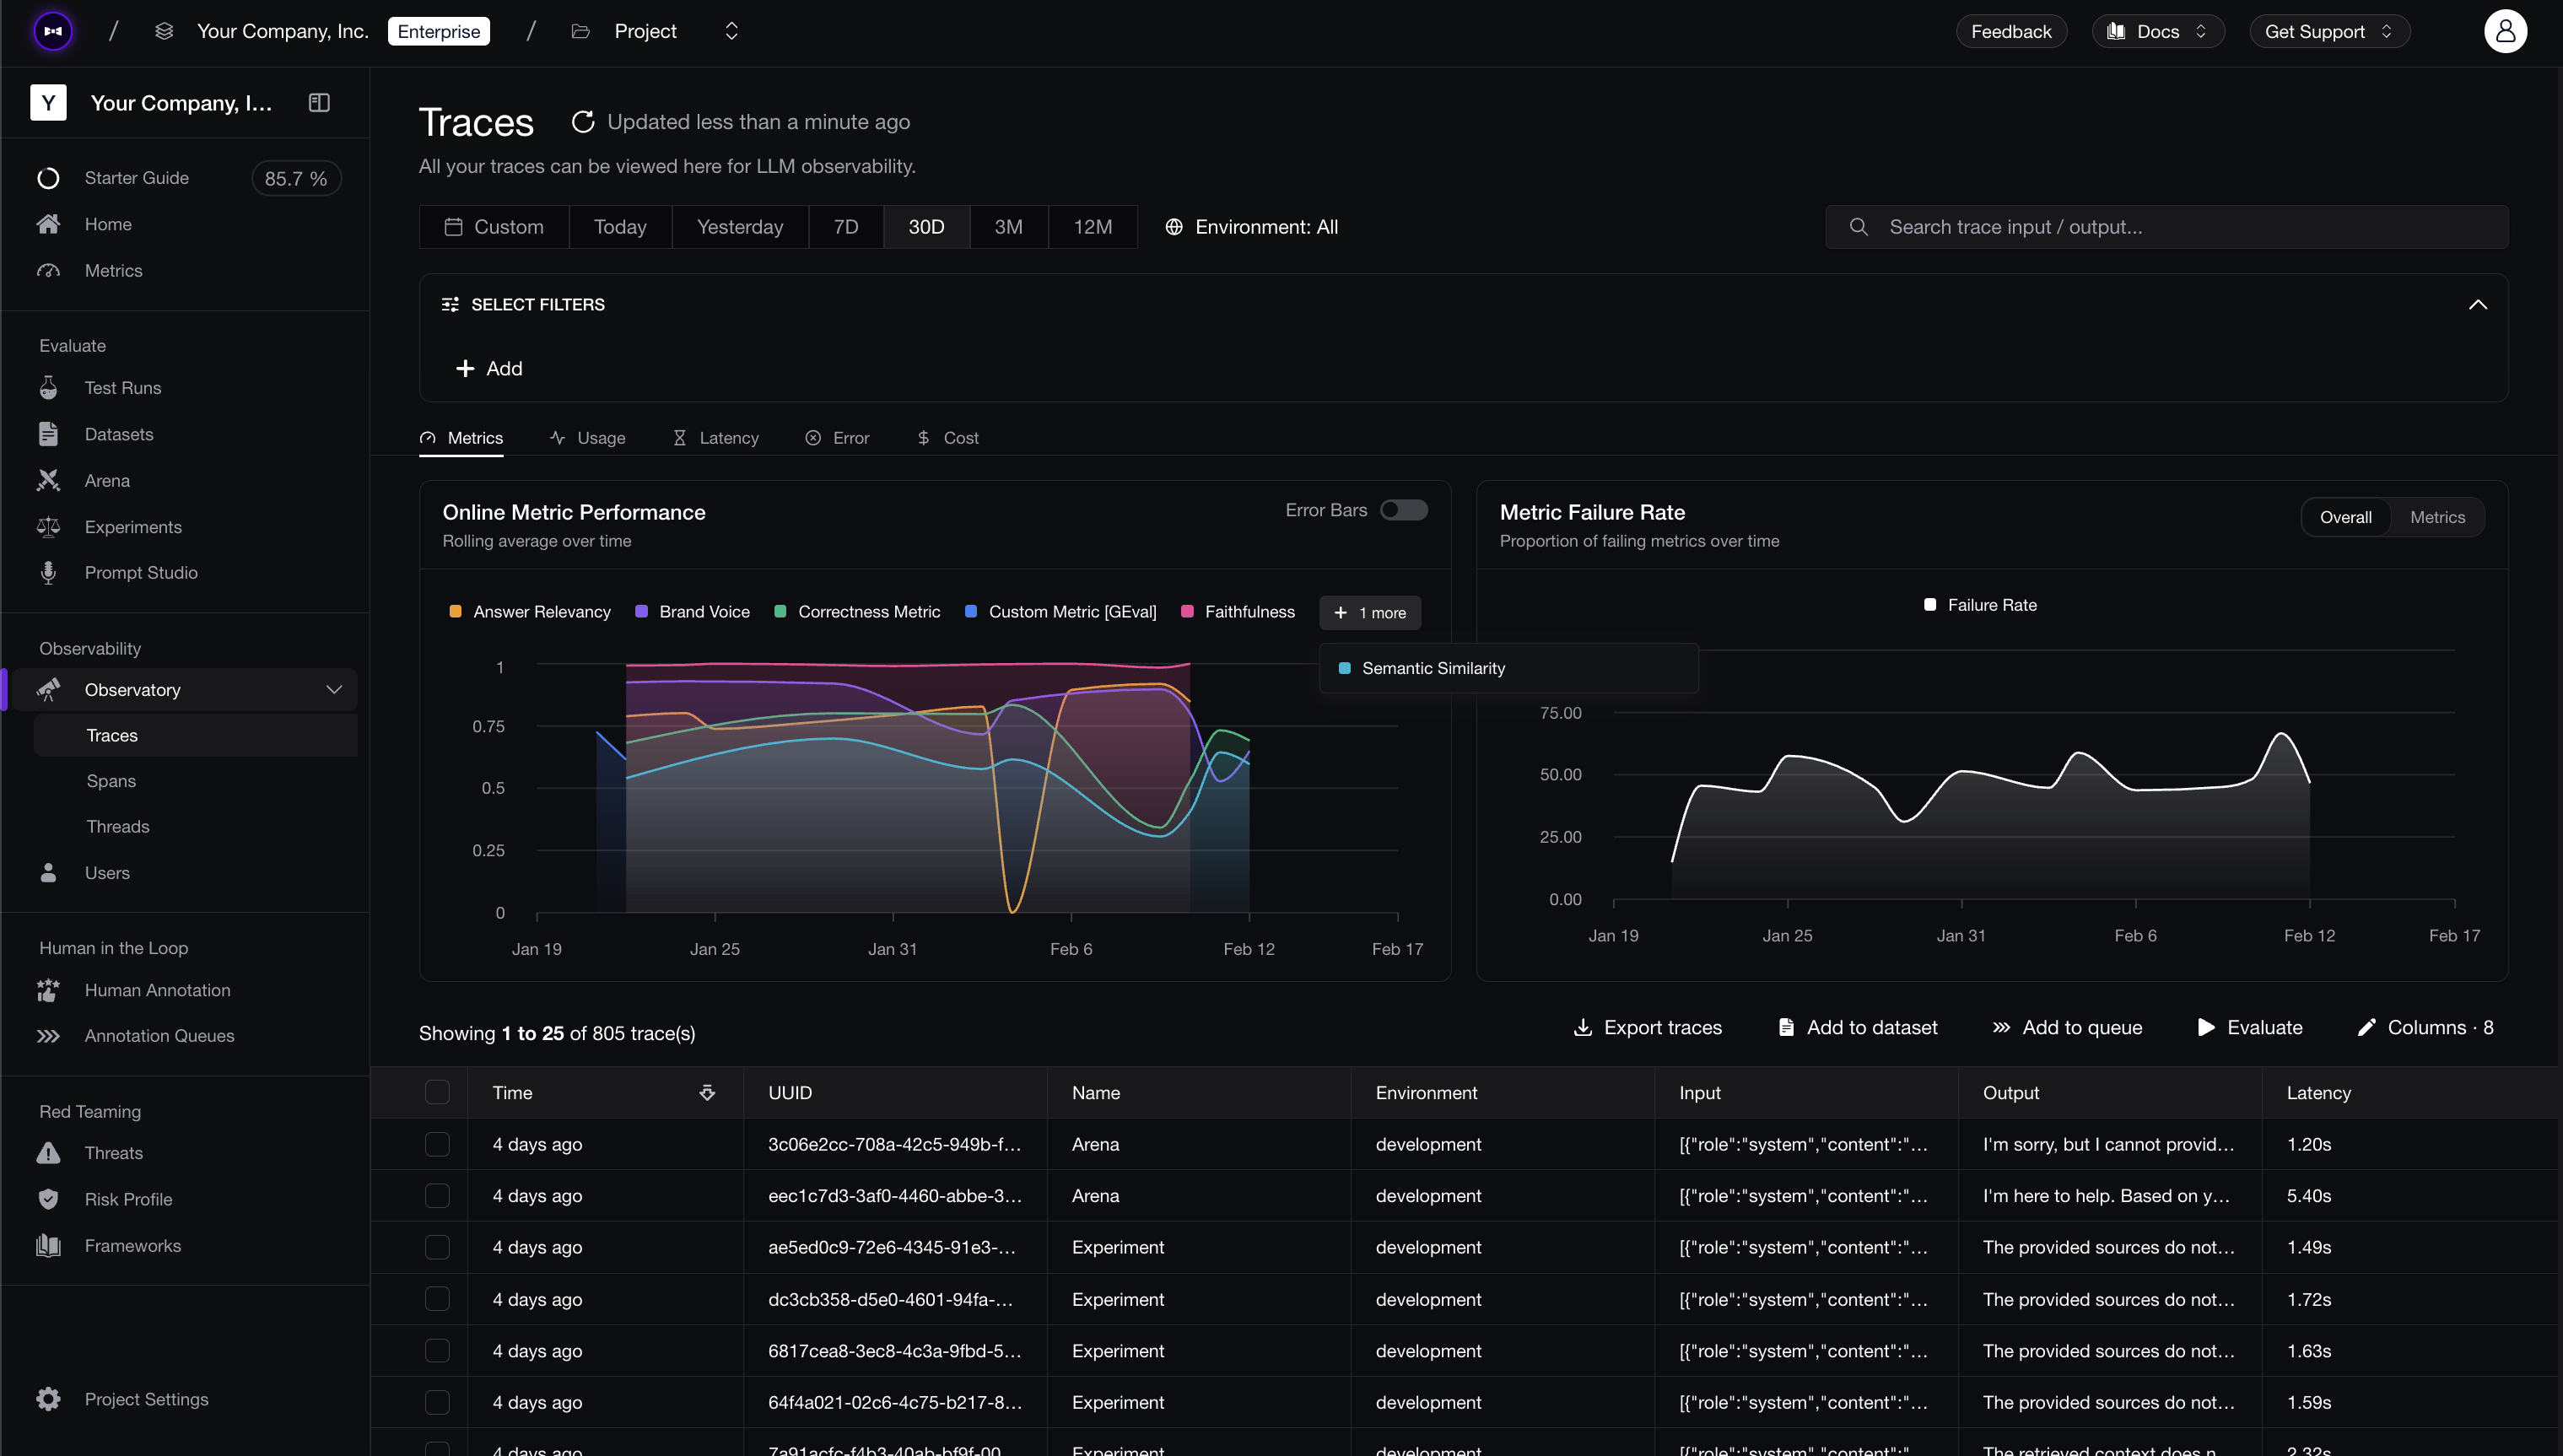
Online Evaluations on Confident AI
평가는 Confident AI에서 서버 측으로 실행돼요. confident-trace는 테스트 케이스 데이터를 보내고 트레이스·스팬에 메트릭 컬렉션을 직접 선택할 수 있어요. 또는 플랫폼에서 Evaluation Rules을 구성해 필터와 샘플 비율로 컬렉션을 선택할 수도 있어요.
트레이스·스팬에 설정된
metric_collection은 UI에서 구성된 Evaluation Rules보다 우선해요. 이것은 모델 비용 결정(model cost resolution)과 같은 패턴을 따라요. 명시적인 OpenTelemetry 레벨 값이 이기고, 프로젝트 구성이 폴백을 제공해요.
멀티턴 대화(스레드) 평가는 Evaluate Threads를 참고하세요.
동작 방식 (How It Works)
트레이스·스팬의 온라인 평가는 다음 단계를 따라요:
- Confident AI에서 실행하고 싶은 single-turn 메트릭으로 메트릭 컬렉션을 만든다.
- 트레이스·스팬에
metric_collection/metricCollection을 설정하거나 UI에서 Evaluation Rule을 만들어 컬렉션을 선택한다. span안에서 스팬·트레이스 업데이트 헬퍼로 스팬·트레이스에 테스트 케이스 파라미터를 설정한다.- 트레이스가 유입되면 Confident AI는 명시적 OpenTelemetry 레벨 컬렉션이 있을 때 그것을 사용한다. 그 외에는 트레이스·스팬을 Evaluation Rules에 매칭한다.
- 결과가 Confident AI 대시보드의 트레이스/스팬에 나타난다.
sequenceDiagram
    participant App as Your App
    participant SDK as confident-trace
    participant CAI as Confident AI

    App->>SDK: Enter span
    SDK->>SDK: Create trace & span(s)
    App->>SDK: update_span / update_trace (metric collection, input, output, etc.)
    App->>SDK: Span ends
    SDK->>CAI: Export trace with test case data
    CAI->>CAI: Resolve inline collection, then Evaluation Rules
    CAI->>CAI: Run referenceless metrics against test case
    CAI->>CAI: Store results on trace/span
메트릭 컬렉션의 referenceless 메트릭만 트레이싱 중에 실행돼요. Referenceless 메트릭은
expected_output이나expected_tools같은 참조 데이터 없이 LLM 성능을 평가할 수 있어요. Non-referenceless 메트릭은 조용히 건너뛰어져요.
특정 트레이스·스팬이 항상 그 컬렉션을 써야 한다면 인라인 메트릭 컬렉션을 사용해요. 재배포 없이 어떤 메트릭이 실행되는지 바꾸거나, 프로덕션 트래픽의 5%, 스테이징의 100% 같은 필터·샘플 비율을 적용하고 싶다면 Evaluation Rules을 사용해요.
테스트 케이스 파라미터 매핑 (Map Test Case Parameters)
평가를 실행하려면 먼저 트레이스·스팬 파라미터가 메트릭이 평가에 사용하는 테스트 케이스 파라미터로 어떻게 매핑되는지 이해해야 해요. 이 파라미터들은 메트릭이 평가에 대항하는 데이터를 제공해요.
update_span / update_trace(또는 updateSpan / updateTrace)에 전달하는 파라미터들이 테스트 케이스 파라미터로 직접 매핑돼요:
Python
| Trace/Span Parameter | Test Case Parameter | Description |
|---|---|---|
input |
input |
The input to your AI app |
output |
actual_output |
The output of your AI app |
expected_output |
expected_output |
The expected output of your AI app |
retrieval_context |
retrieval_context |
List of retrieved text chunks from a retrieval system |
context |
context |
List of ideal retrieved text chunks |
tools_called |
tools_called |
List of tool call objects ({"name", "input", "output"}) actually used |
expected_tools |
expected_tools |
List of tool call objects you expected to be used |
TypeScript
| Trace/Span Parameter | Test Case Parameter | Description |
|---|---|---|
input |
input |
The input to your AI app |
output |
actualOutput |
The output of your AI app |
expectedOutput |
expectedOutput |
The expected output of your AI app |
retrievalContext |
retrievalContext |
List of retrieved text chunks from a retrieval system |
context |
context |
List of ideal retrieved text chunks |
toolsCalled |
toolsCalled |
List of tool call objects ({ name, input, output }) actually used |
expectedTools |
expectedTools |
List of tool call objects you expected to be used |
모든 파라미터는 선택 사항이에요 — 컬렉션의 메트릭이 요구하는 것만 제공하면 돼요. 툴 호출은 일반 JSON 객체라서 구성하려고 아무것도 import할 필요가 없어요.
각 메트릭은 서로 다른 테스트 케이스 파라미터를 요구해요. 각 메트릭이 무엇을 필요로 하는지에 대한 세부 사항은 공식 DeepEval 문서를 참고하세요.
스팬을 온라인으로 평가 (Evaluate Spans Online)
컬렉션을 직접 선택하려면 스팬의 테스트 케이스 파라미터와 함께 metric_collection / metricCollection을 설정해요. 리트리버 스팬이 자연스러운 지점이에요. retrieval_context를 검색된 청크로 설정하고 contextual relevancy 메트릭을 실행해 나쁜 검색이 LLM에 도달하기 전에 잡아내요:
Python
from openai import OpenAI
from confident_trace import init, span, update_span, shutdown

init()
client = OpenAI()

@span(type="retriever")
def retriever(query: str) -> list[str]:
    chunks = vector_store.search(query, top_k=3)
    update_span(
        metric_collection="Retrieval Quality",
        input=query,
        output=chunks,
        retrieval_context=chunks,
    )
    return chunks

def llm_app(query: str) -> str:
    with span("llm_app", type="agent"):
        chunks = retriever(query)
        return client.chat.completions.create(
            model="gpt-4o",
            messages=[{"role": "user", "content": f"{query}\n\n{chunks}"}]
        ).choices[0].message.content

try:
    llm_app("Write me a poem.")
finally:
    shutdown()
TypeScript
import OpenAI from "openai";
import { init, span, withSpan, updateSpan } from "confident-trace";

const runtime = init();
const openai = new OpenAI();

const retriever = span({ name: "retriever", type: "retriever" }, async (query: string) => {
  const chunks = await vectorStore.search(query, { topK: 3 });
  updateSpan({
    metricCollection: "Retrieval Quality",
    input: query,
    output: chunks,
    retrievalContext: chunks,
  });
  return chunks;
});

const llmApp = async (query: string) => {
  return withSpan({ name: "llm_app", type: "agent" }, async () => {
    const chunks = await retriever(query);
    const res = await openai.chat.completions.create({
      model: "gpt-4o",
      messages: [{ role: "user", content: `${query}\n\n${chunks.join("\n")}` }],
    });
    return res.choices[0].message.content ?? "";
  });
};

try {
  await llmApp("Write me a poem.");
} finally {
  await runtime.shutdown();
}
명시적 컬렉션은 설정된 리트리버 스팬만 평가해요. 대신 스팬 Evaluation Rule을 사용한다면, 규칙은 일치하는 모든 스팬에 대해 실행돼요. 모든 스팬 타입을 매칭하는 규칙은 에이전트 스팬·리트리버 스팬·자동 계측 LLM 스팬을 모두 평가하므로, Span Type 필터로 관심 있는 스팬만 겨냥하세요.
프로바이더 호출을 직접 감쌀 필요는 없어요. OpenAI 통합이 이미 프롬프트와 완성을 LLM 스팬의 입력·출력으로 기록하므로, LLM 타입으로 제한된 스팬 규칙은 추가 코드 없이 동작해요. 그리고 같은 호출 주위에 자신의
llm스팬을 추가하면 중복될 거예요. 타입별 필드는 스팬 타입(span types)을 참고하세요.
트레이스를 온라인으로 평가 (Evaluate Traces Online)
스팬과 비슷하게, update_trace / updateTrace로 metric_collection / metricCollection을 설정해 트레이스의 컬렉션을 선택해요. 트레이스 레벨 평가는 종단간 품질 — "사용자가 좋은 답을 받았나?" — 에 적합해요. 트레이스 입력·출력이 전체 요청을 나타내기 때문이죠:
Python
from openai import OpenAI
from confident_trace import init, span, update_trace, shutdown

init()
client = OpenAI()

def llm_app(query: str) -> str:
    with span("llm_app", type="agent"):
        chunks = retrieve(query)
        res = client.chat.completions.create(
            model="gpt-4o",
            messages=[{"role": "user", "content": f"{query}\n\n{chunks}"}]
        ).choices[0].message.content

        update_trace(
            metric_collection="Agent Quality",
            input=query,
            output=res,
            retrieval_context=chunks,
        )
        return res

try:
    llm_app("Write me a poem.")
finally:
    shutdown()
TypeScript
import OpenAI from "openai";
import { init, withSpan, updateTrace } from "confident-trace";

const runtime = init();
const openai = new OpenAI();

const llmApp = async (query: string) => {
  return withSpan({ name: "llm_app", type: "agent" }, async () => {
    const chunks = await retrieve(query);
    const res = await openai.chat.completions.create({
      model: "gpt-4o",
      messages: [{ role: "user", content: `${query}\n\n${chunks.join("\n")}` }],
    });
    const data = res.choices[0].message.content ?? "";

    updateTrace({
      metricCollection: "Agent Quality",
      input: query,
      output: data,
      retrievalContext: chunks,
    });
    return data;
  });
};

try {
  await llmApp("Write me a poem.");
} finally {
  await runtime.shutdown();
}
> 각 레벨에 컬렉션을 설정하거나, 각 데이터 모델에 대해 Evaluation Rule을 하나씩 만들거나, 두 접근을 결합해서 트레이스와 스팬에서 동시에 온라인 평가를 실행할 수 있어요.
규칙이 트레이스·스팬을 매칭했지만 그 메트릭 중 하나에 충분한 테스트 케이스 파라미터를 제공하지 않았다면, 그 메트릭은 Confident AI에서 오류로 표시돼요. 코드를 차단하거나 문제를 일으키지는 않아요 — 평가는 내보내기 후에 플랫폼에서 전적으로 일어나거든요.
update_span과update_trace는 쓸 활성 스팬이 필요해요 — 스팬 밖(또는 스팬이 끝난 후)에서는 조용히 아무것도 하지 않으므로, 평가가 "missing input"으로 오류가 나면 먼저 호출이 스팬 본문 안에 있는지 확인하세요.update_trace를 호출할 스팬이 없다면 호출 주위에trace_context/traceContext를 열어 트레이스 필드를 미리 설정해요(다만output은 여전히 스팬이 필요해요). set trace attributes without a span을 참고하세요. 어느 것을 써야 할지 모르겠다면update_tracevsupdate_span을 보세요.
예시 (Examples)
빠른 퀴즈: 아래 코드가 있고, Trace 규칙 하나와 Span 규칙 하나(스팬 타입 Any)가 모두 활성화돼 있다고 할 때, 각 규칙은 무엇을 평가할까요?
Python
from confident_trace import span, update_span, update_trace

@span(type="tool")
def inner_function(query: str):
    result = lookup(query)
    update_span(input=query, output=result)
    update_trace(input=query, output="final answer")
    return result

def outer_function(query: str):
    with span("outer_function", type="agent"):
        return inner_function(query)
TypeScript
import { span, withSpan, updateSpan, updateTrace } from "confident-trace";

const innerFunction = span({ name: "inner_function", type: "tool" }, async (query: string) => {
  const result = await lookup(query);
  updateSpan({ input: query, output: result });
  updateTrace({ input: query, output: "final answer" });
  return result;
});

const outerFunction = async (query: string) => {
  return withSpan({ name: "outer_function", type: "agent" }, async () => {
    return innerFunction(query);
  });
};
답: Trace 규칙은 하나의 테스트 케이스 — input=query, actual_output="final answer" — 를 평가해요. update_trace는 어디서 호출됐든 항상 트레이스에 쓰기 때문이에요. Span 규칙은 두 스팬을 평가해요: inner_function은 input=query와 actual_output=result로, 그리고 outer_function은 테스트 케이스 파라미터가 전혀 없어서(그것을 필요로 하는 메트릭에는 모두 오류)요.
이유는 다음 때문이에요:
update_trace는 트레이스 안 어디서든 트레이스 레벨 필드를 설정해요 — 자식 스팬에서 호출됐다는 건 중요하지 않아요.update_span은 부모가 아니라 가장 안쪽 활성 스팬(inner_function)을 업데이트해요.- 타입 Any인 스팬 규칙은 트레이스의 모든 스팬을 매칭하는데, 그 안에서
update_span이 호출된 적 없는outer_function도 포함해요. 규칙을 Tool 스팬으로 제한하거나(또는outer_function에서update_span호출) 이것을 고치세요.
다음 단계 (Next Steps)
이제 개별 트레이스·스팬을 평가할 수 있으니, 전체 대화를 평가하는 법을 배워요.
Evaluate Threads
멀티턴 대화에 평가를 실행하고 스레드 평가가 트레이스 평가와 어떻게 다른지 이해해요.
Evaluation Rules
코드를 건드리지 않고 어떤 메트릭 컬렉션이 어떤 트레이스·스팬·스레드에서 실행될지 — 필터와 샘플 비율로 — 구성해요.
더 알아보기
- Configure Span Types — 스팬을 분류하고 온라인 평가에 필요한 타입별 필드를 설정해요.
- Set Input/Output — 온라인 평가가 읽는 테스트 케이스 I/O를 설정해요.