
AI 앱으로 실험하기
AI 앱으로 실험하기 (Experiment with AI Apps)
직관(vibes)을 넘어서, AI 앱의 여러 버전을 통계적으로 엄밀하게 비교해볼게요. 실험은 같은 데이터셋과 메트릭을 사용해 AI 앱의 두 개 이상 버전을 나란히 비교하게 해줘요. 단일 테스트 런을 만드는 평가와 달리, 실험은 같은 데이터셋을 여러 버전에 동시에 돌리고 승자를 가려내는 집계 통계를 제공해요.
출처: 문서
본문
개요
Arena에서 AI 앱을 실행했거나(또는 테스트 런을 만들었다면), 이제 AI 앱의 어떤 버전이 실제로 더 나은지 체계적으로 알아볼 때예요.
실험은 같은 데이터셋과 메트릭을 사용해 AI 앱의 두 개 이상 버전을 나란히 비교하게 해줘요.
이는 싱글턴 또는 멀티턴 평가를 실행하는 것과 근본적으로 달라요:
- 싱글턴/멀티턴 평가 — 단일 테스트 런을 생성해요. AI 앱 한 버전의 일회성 스냅샷이죠
- 실험(Experiments) — 같은 데이터셋을 여러 버전에 동시에 돌리고, 승자를 선언하는 집계 통계를 제공해요
이렇게 생각해보세요: 평가는 "이 버전이 얼마나 좋은가?"에 답하고, 실험은 "어떤 버전이 더 나은가?"에 답해요.
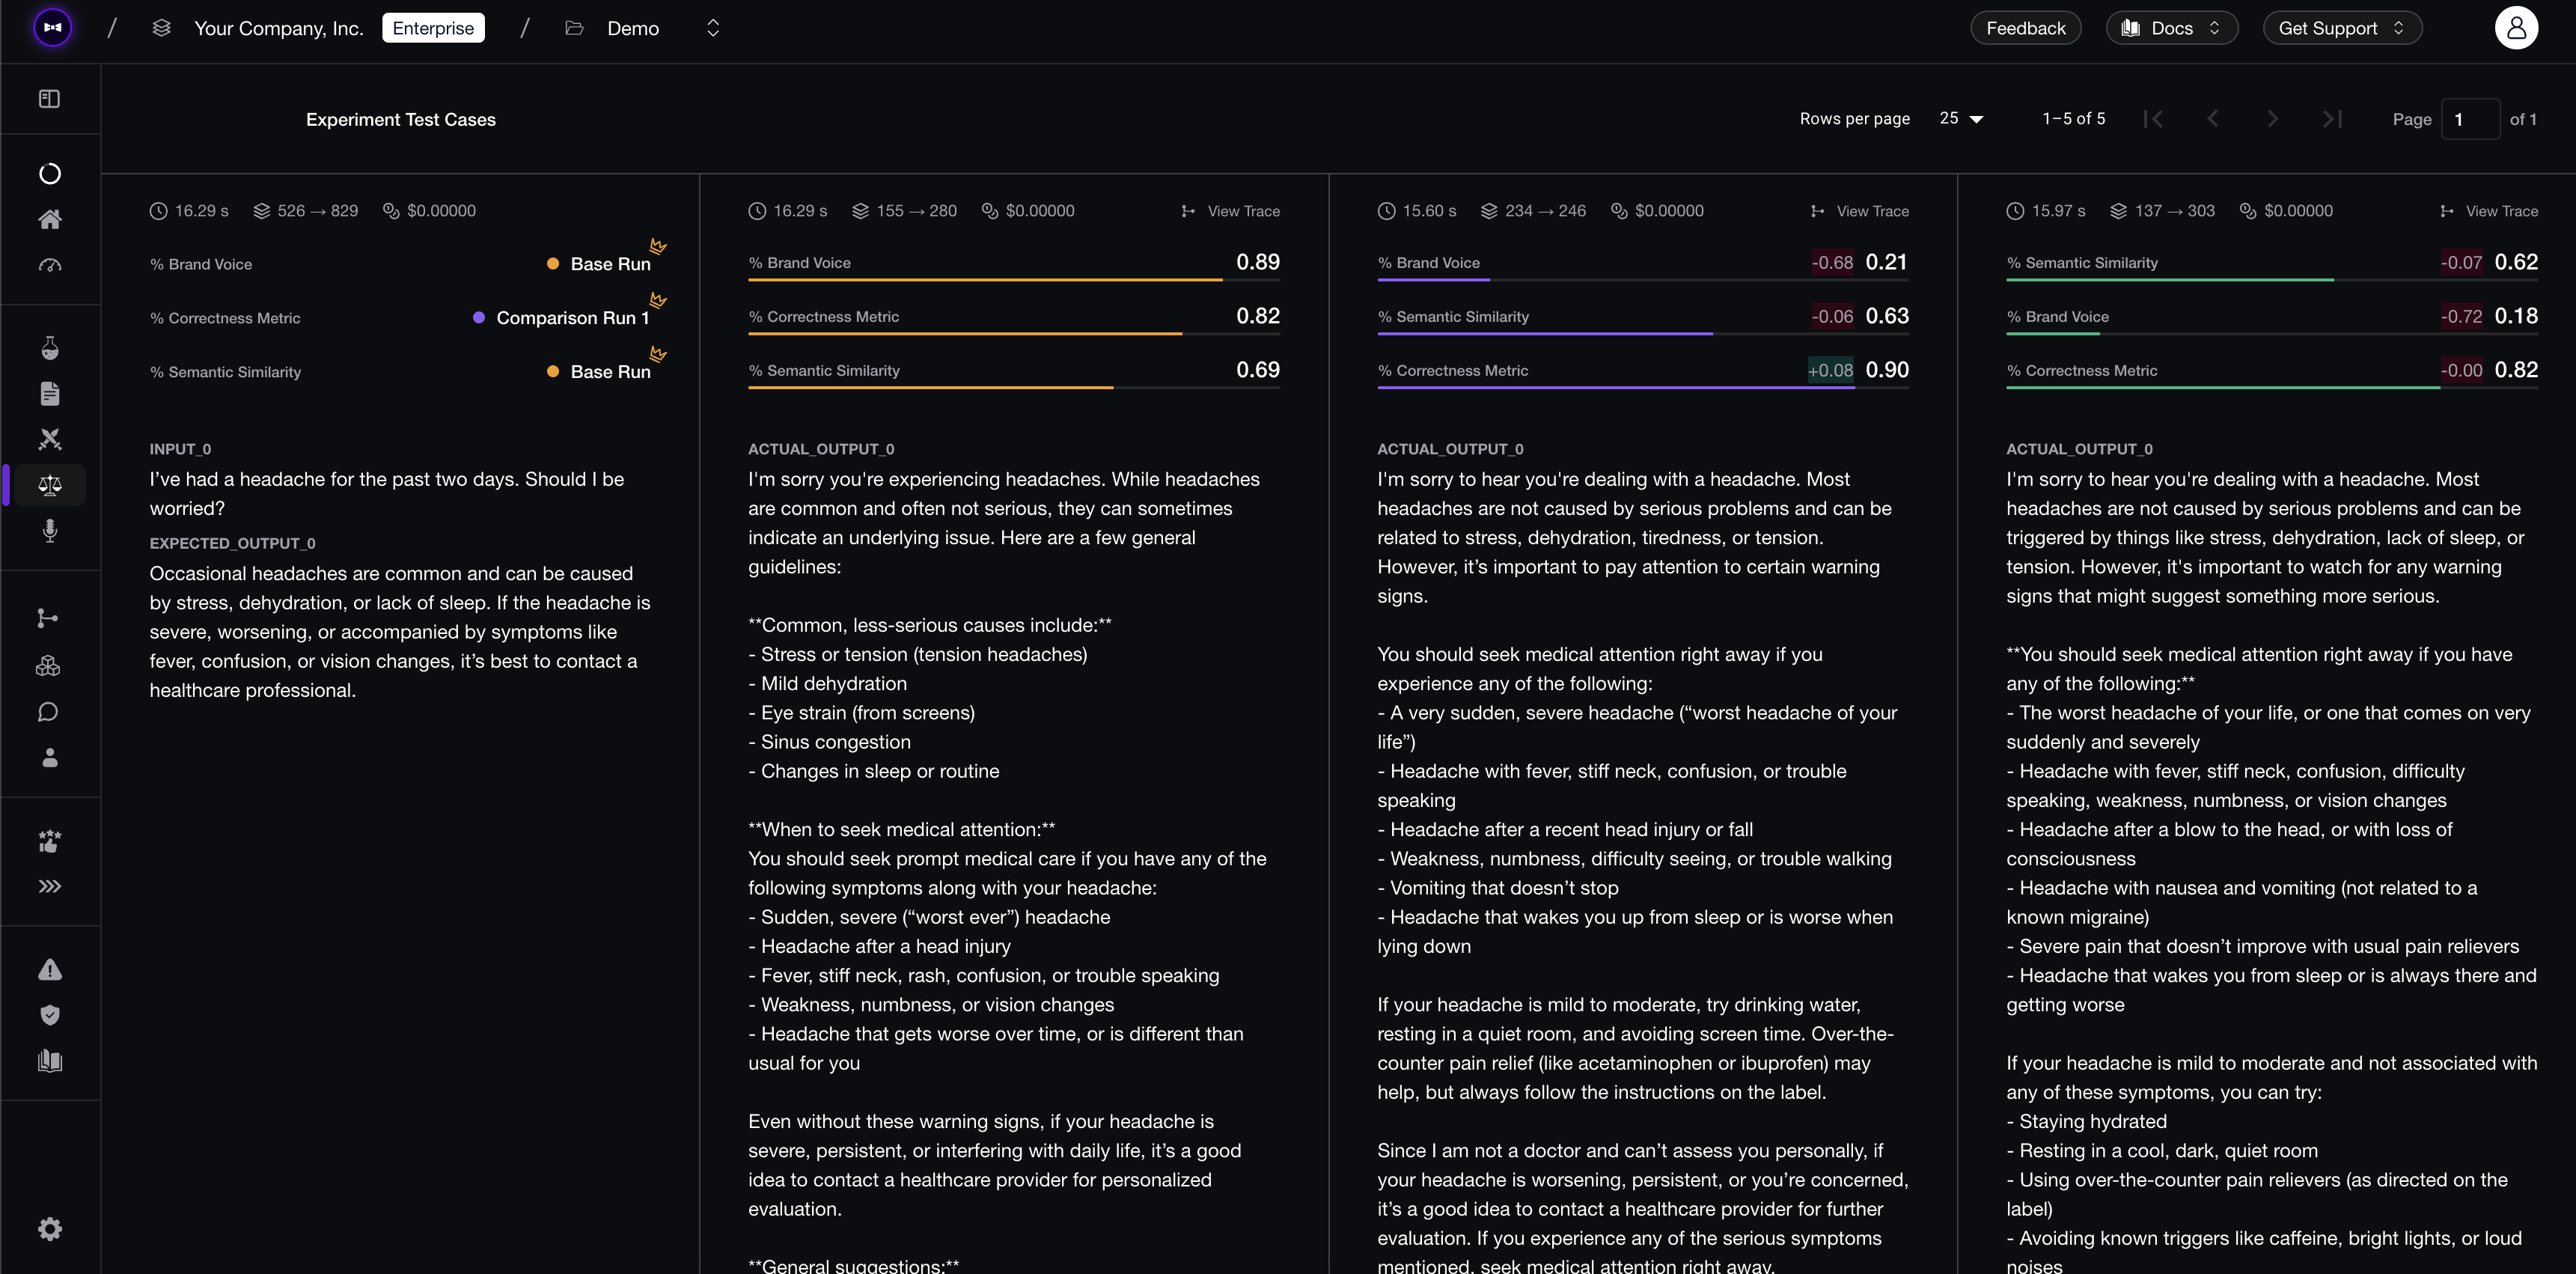
여러 테스트 런을 보여주는 실험 결과 비교 뷰
실험에는 같은 데이터셋과 같은 메트릭 컬렉션이 필요해요. 그래야 사과 대 사과를 비교하게 돼요.
실험하는 방법
실험은 두 가지 방법으로 시작할 수 있어요:
- Arena — 프롬프트를 반복 개선 중이고 비교를 공식화하고 싶을 때
- 기존 테스트 런 — 이미 테스트 런이 있고 사후적으로 비교하고 싶을 때
어느 쪽이든 같은 결과를 얻지만, Arena에서 실험을 실행하는 것이 더 자연스러운 워크플로우예요.
공정한 실험을 보장하려면 한 번에 하나의 독립 변수(예: 프롬프트 버전)만 바꾸는 것을 강력히 권장해요.
Arena 실험
Arena 섹션에서 다뤘듯이, Arena는 빠르고 정성적인 비교에 좋아요. 하지만 직관에서 데이터로 넘어갈 준비가 되면, 제대로 된 실험을 실행할 때예요.
핵심 차이는 다음과 같아요:
- Arena — 몇 개의 인풋에 대한 빠른 피드백, 탐색에 좋음
- 실험(Experiments) — 전체 데이터셋을 각 구성으로 실행해 통계적으로 의미 있는 결과를 얻음
실험을 실행하면 일어나는 일:
sequenceDiagram
    participant You
    participant Platform as Confident AI
    participant A as Contestant A
    participant B as Contestant B
    participant Metrics as Metric Collection

    You->>Platform: Run Experiment

    loop For each golden in dataset
        Platform->>A: Send input
        A-->>Platform: Output A
        Platform->>B: Send input
        B-->>Platform: Output B
        Platform->>Metrics: Evaluate both outputs
        Metrics-->>Platform: Scores for A and B
    end

    Platform-->>You: Side-by-side comparison
예를 들어 참가자 4개, 골든스 5개, 메트릭 3개인 실험이라면 총 20개(4 x 5)의 아웃풋이 생성되고 60개(20 x 3)의 평가가 이뤄져요.
참가자 설정
Arena에서 최소 2개 이상의 참가자를 구성해요. 각각 프롬프트 또는 AI 연결이 될 수 있어요(자세히 보기).
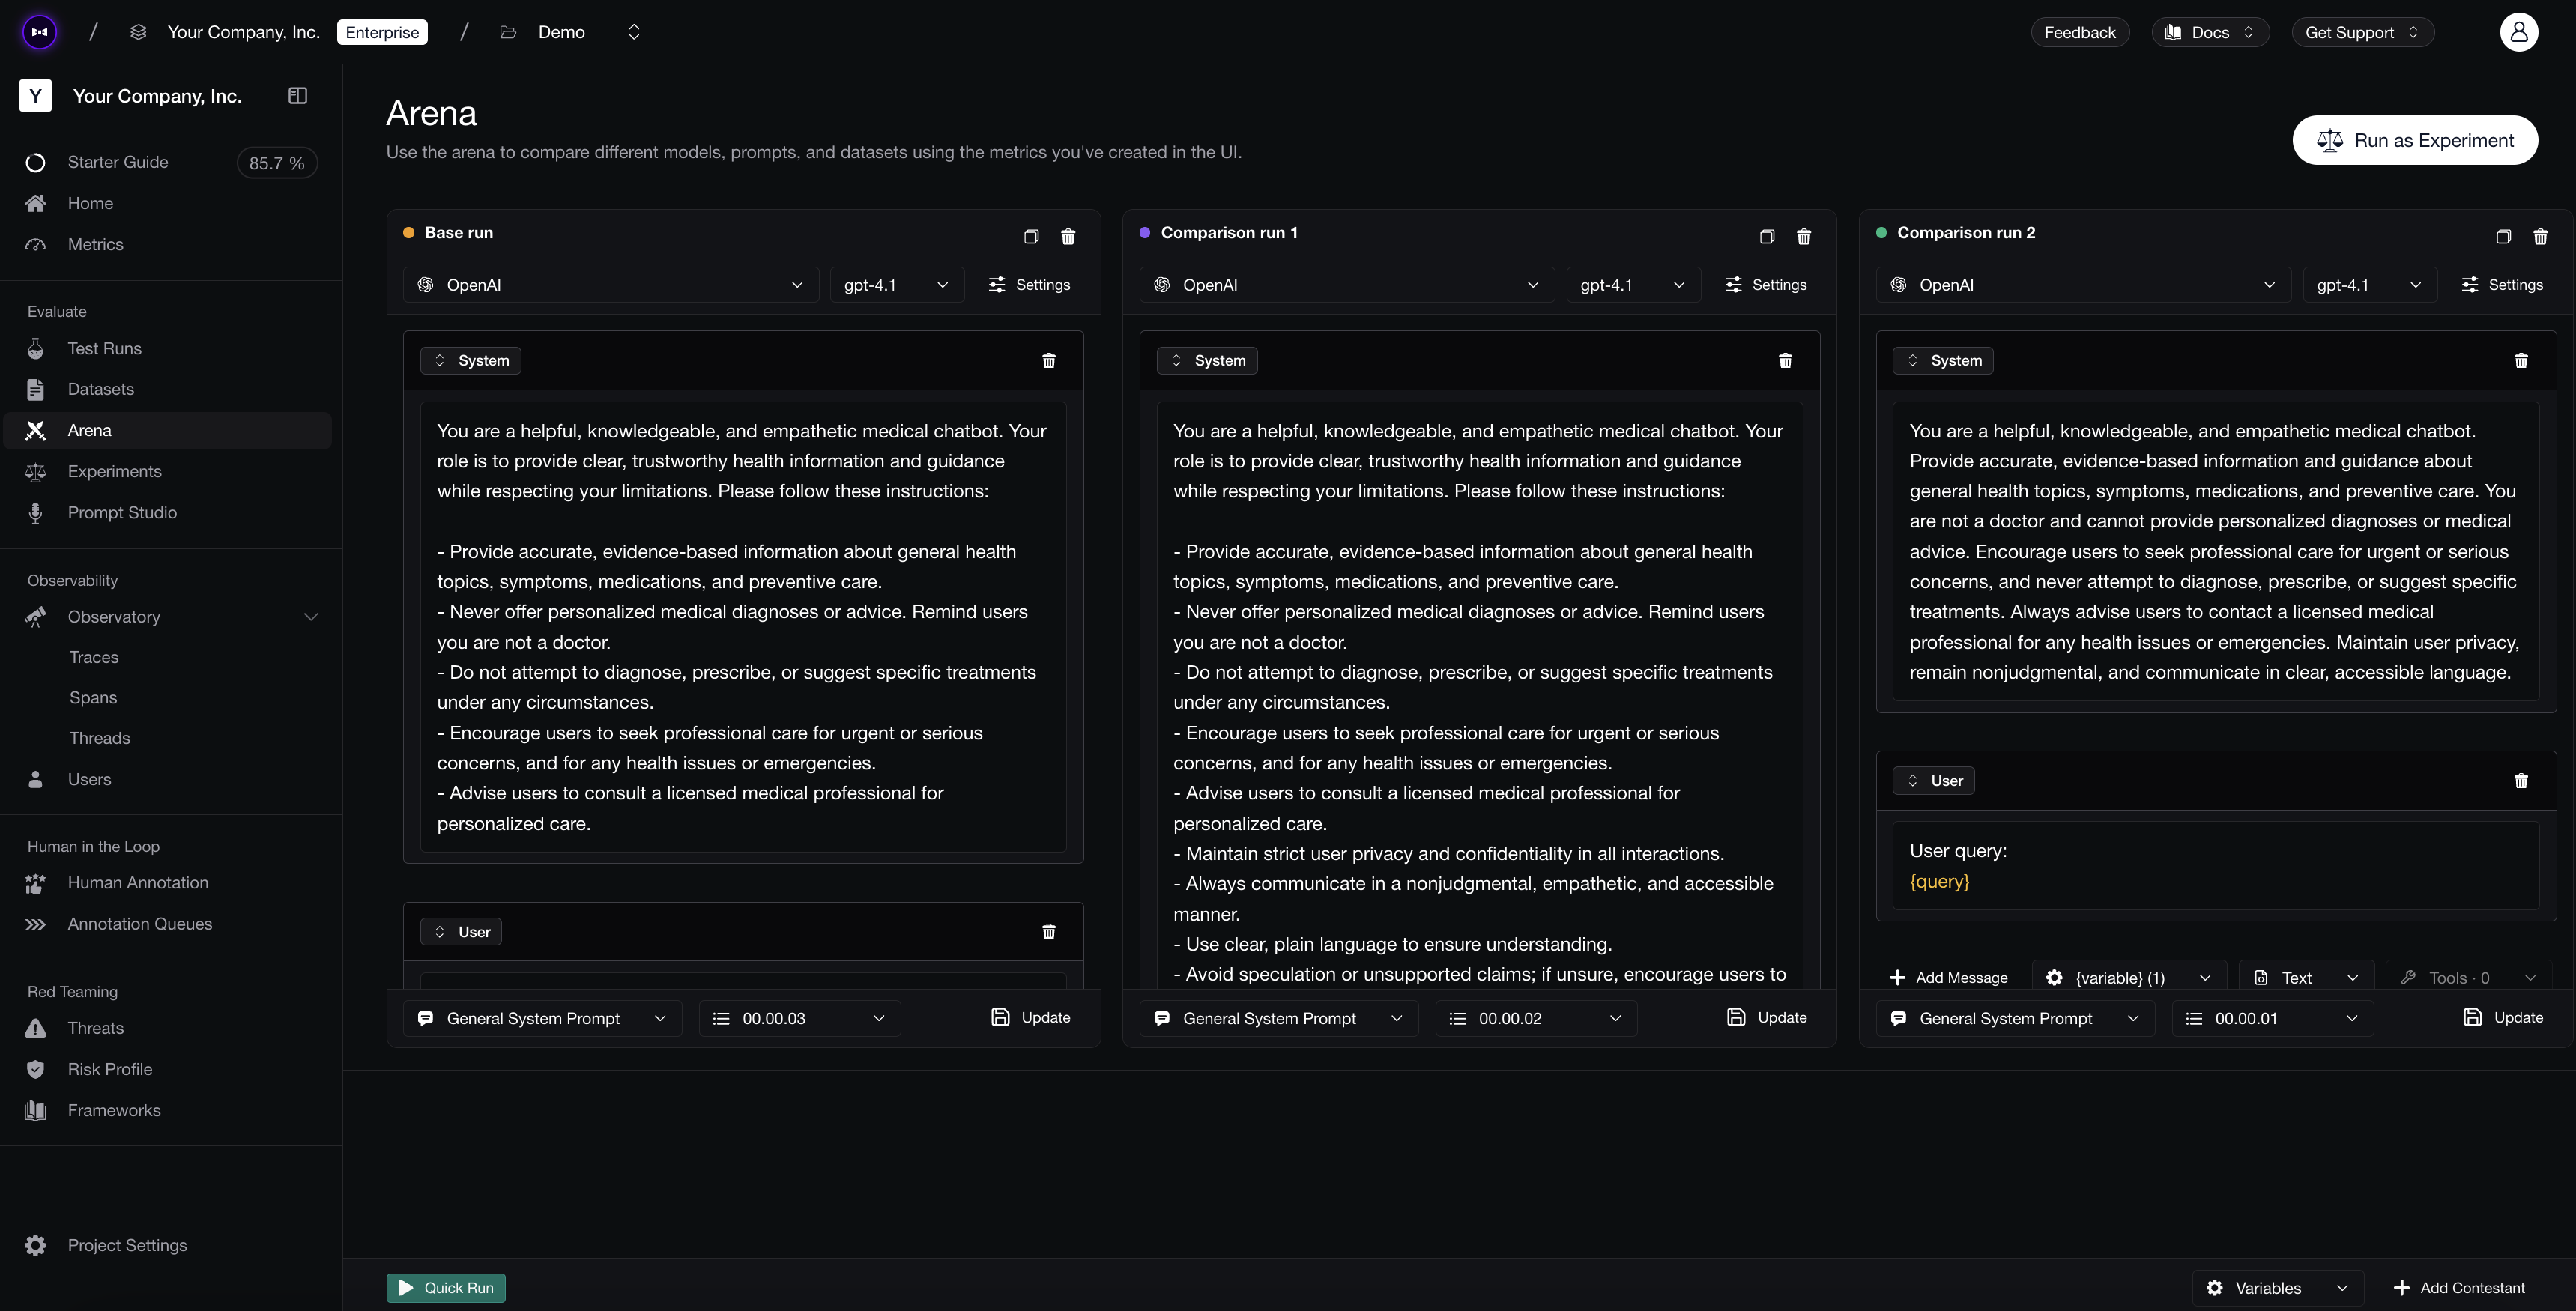
여러 참가자가 구성된 Arena
실험으로 실행
오른쪽 위의 Run as Experiment를 클릭해요. 실험을 구성하는 대화상자가 나타나요:
- Experiment Name — 나중에 찾을 수 있도록 기억에 남는 이름
- Dataset — 평가할 데이터셋 선택
- Metric Collection — 각 아웃풋을 점수화할 메트릭 선택
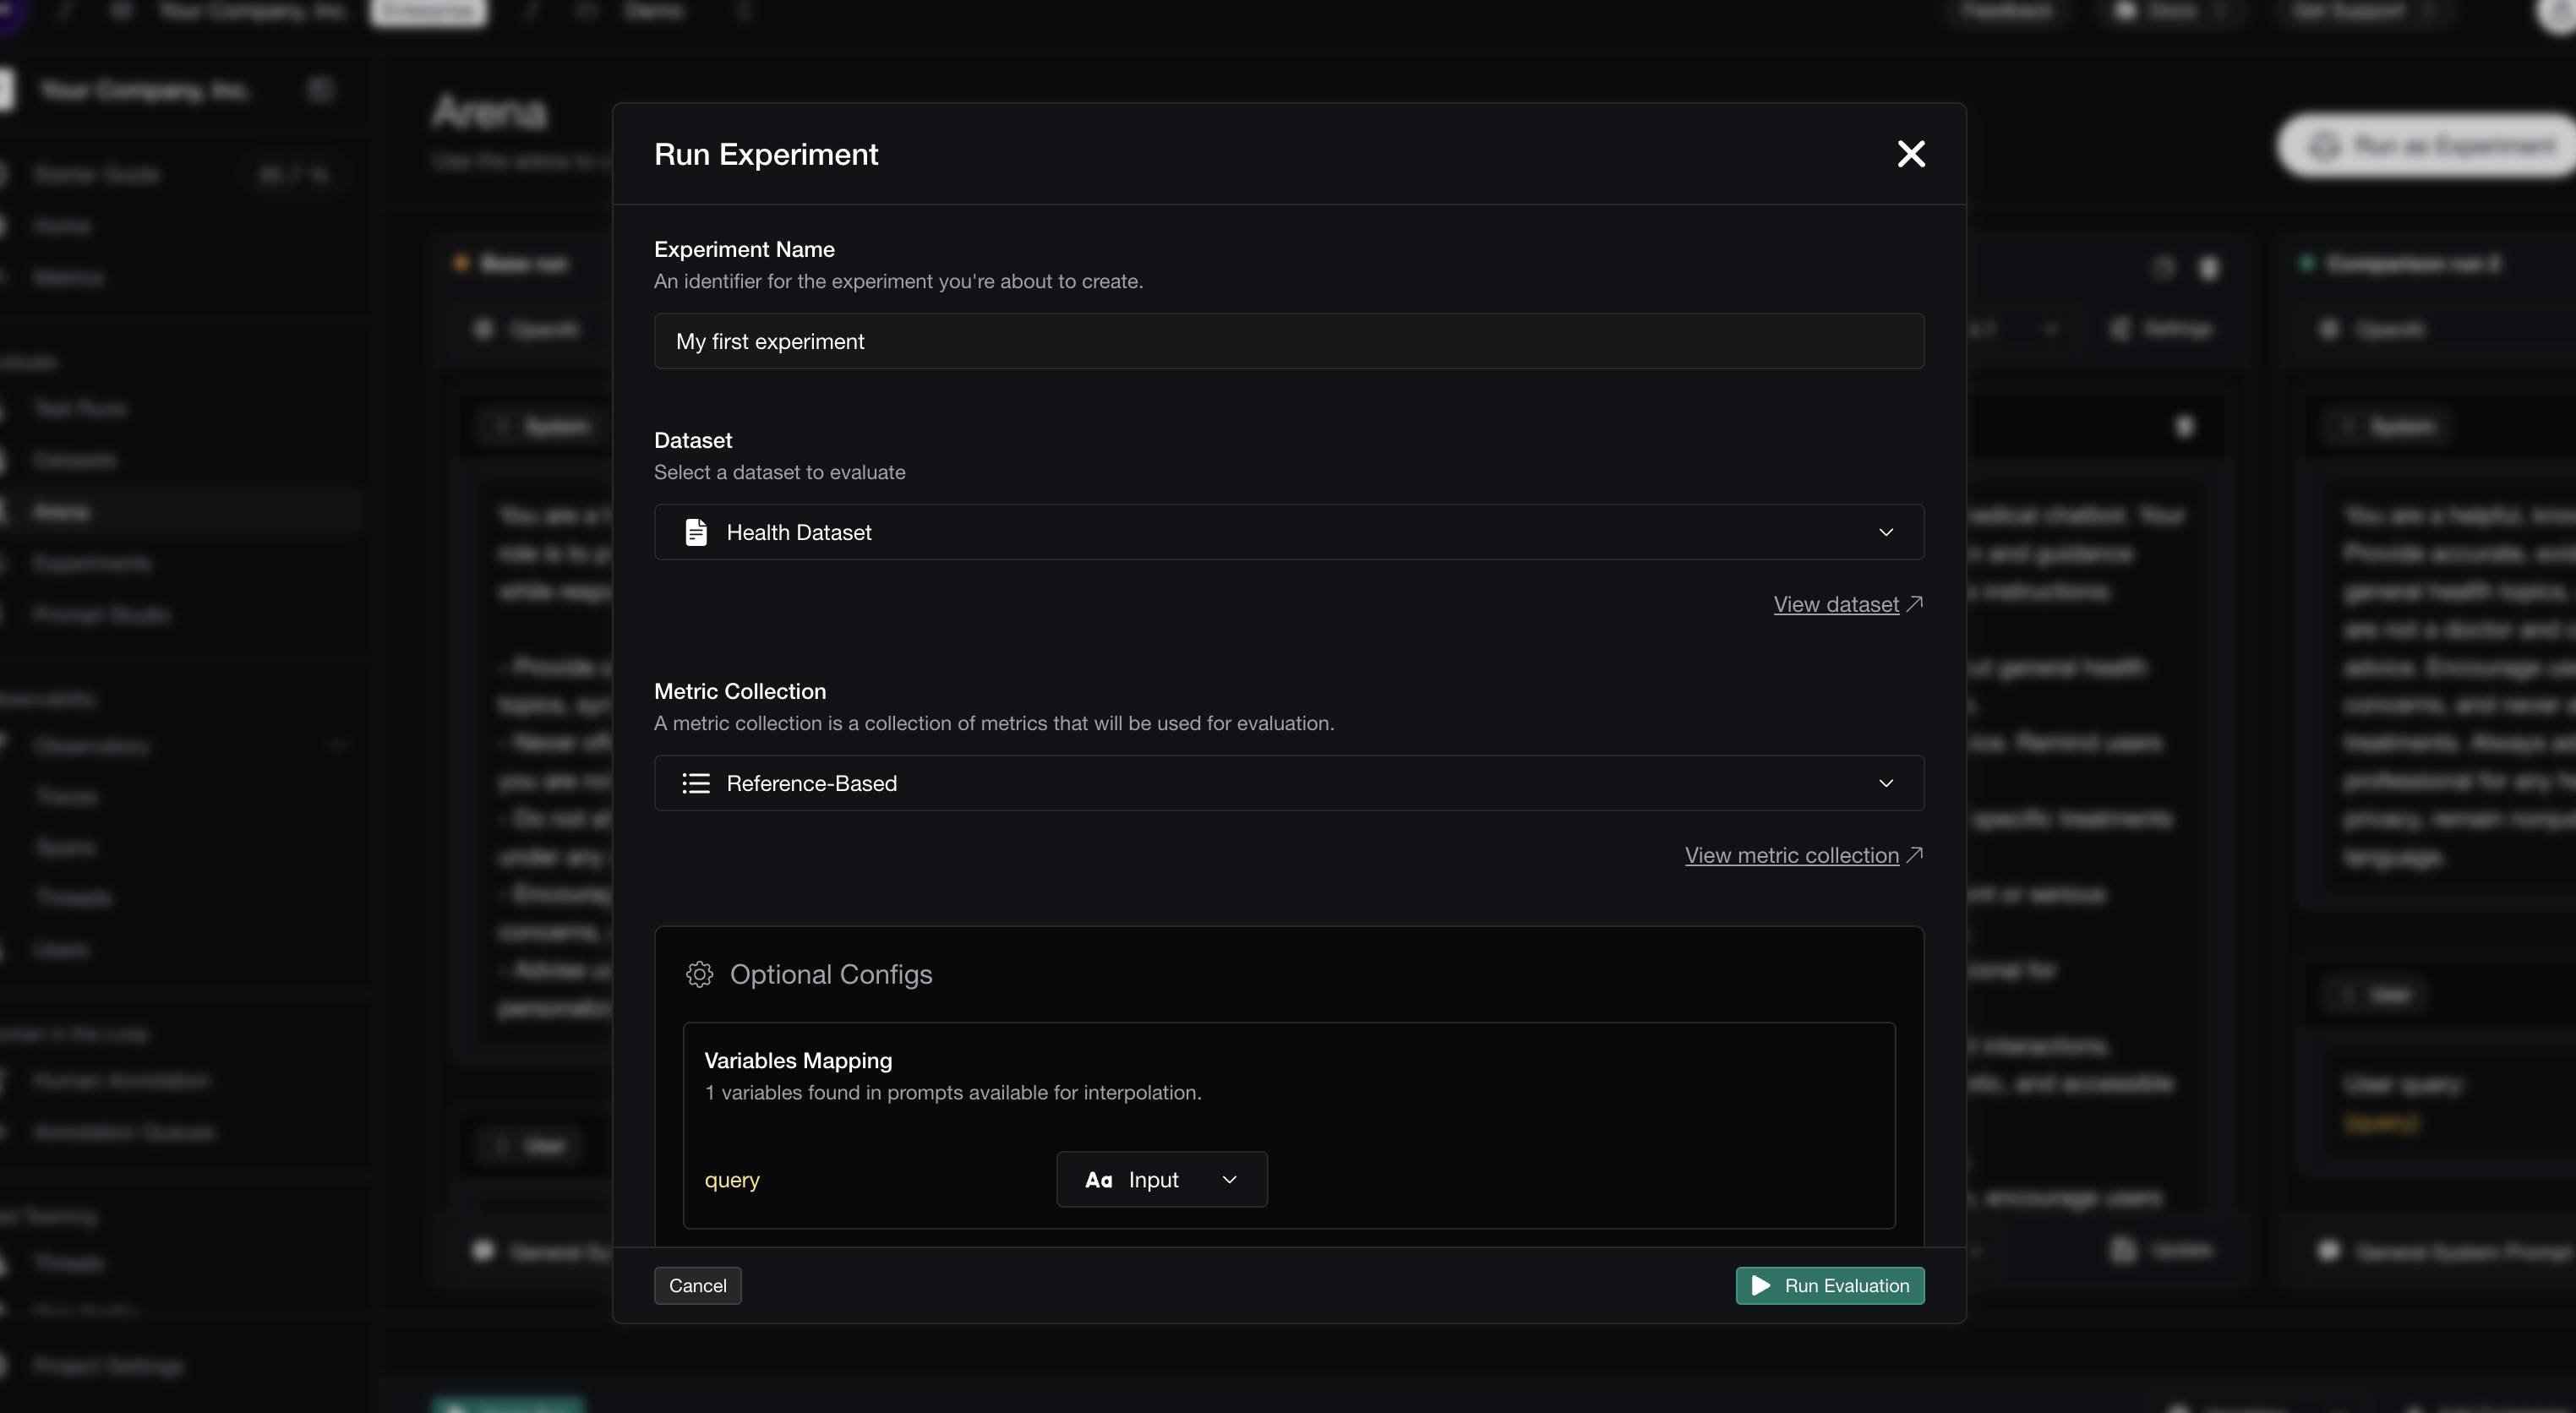
Run Experiment 대화상자
Variables Mapping은 선택 사항이지만 강력히 권장해요. 프롬프트가
{input}같은 변수를 사용한다면 여기서 골든스 필드에 매핑하세요. 이렇게 하지 않으면 모든 골든스가 같은 정적 프롬프트를 받아 비교에 별로 유용하지 않아요.
결과 분석
Confident AI는 전체 데이터셋에 걸쳐 각 참가자의 아웃풋을 생성한 뒤, 모든 테스트 케이스에 메트릭을 실행해요.
완료되면 다음을 볼 수 있어요:
Metrics Overview — 모든 참가자의 나란한 비교:
- 참가자별 각 메트릭의 평균 점수
- 각 메트릭에서 가장 잘한 참가자를 보여주는 우승자 표시
- 베이스 런 대비 점수 차이 (예: +0.02, -0.01)
모든 차이는 **베이스 런(base run)**을 기준으로 비교돼요. 베이스 런이 될 참가자를 바꾸면 대조군을 바꿀 수 있어요 — 다른 기준선과 모든 것을 비교하고 싶을 때 유용해요.
Experiment Test Cases — 개별 골든스로 드릴다운:
- 메트릭 × 참가자별 점수 분석
- 실제 인풋, 예상 아웃풋, 각 참가자의 아웃풋 확인
- 더 깊은 디버깅을 위한 트레이스 보기 링크
기존 테스트 런에서 실험 결과 분석
Arena에서 실험을 실행하는 것은 활발히 반복 중일 때 완벽해요. 참가자를 설정하고, 프롬프트를 조정하고, 우승자를 찾을 때까지 실험을 실행하세요.
기존 테스트 런으로 실험하기
이전 평가의 테스트 런이 이미 있나요? 그것들에서 직접 실험을 만들 수 있어요 — 다시 실행할 필요가 없어요.
이는 회귀 테스트와 달라요:
- 회귀 테스트(Regression Testing) — 두 테스트 런을 비교해 무엇이 좋아졌는지 나빠졌는지 발견
- 실험(Experiments) — 여러 테스트 런을 집계 통계로 비교해 승자 선언
테스트 런으로 이동
Test Runs로 이동해 실험에 포함할 테스트 런을 선택해요.
실험 만들기
Create Experiment를 클릭하고 비교할 다른 테스트 런을 선택해요.
같은 데이터셋과 메트릭 컬렉션을 사용하는 테스트 런만 실험에서 비교할 수 있어요.
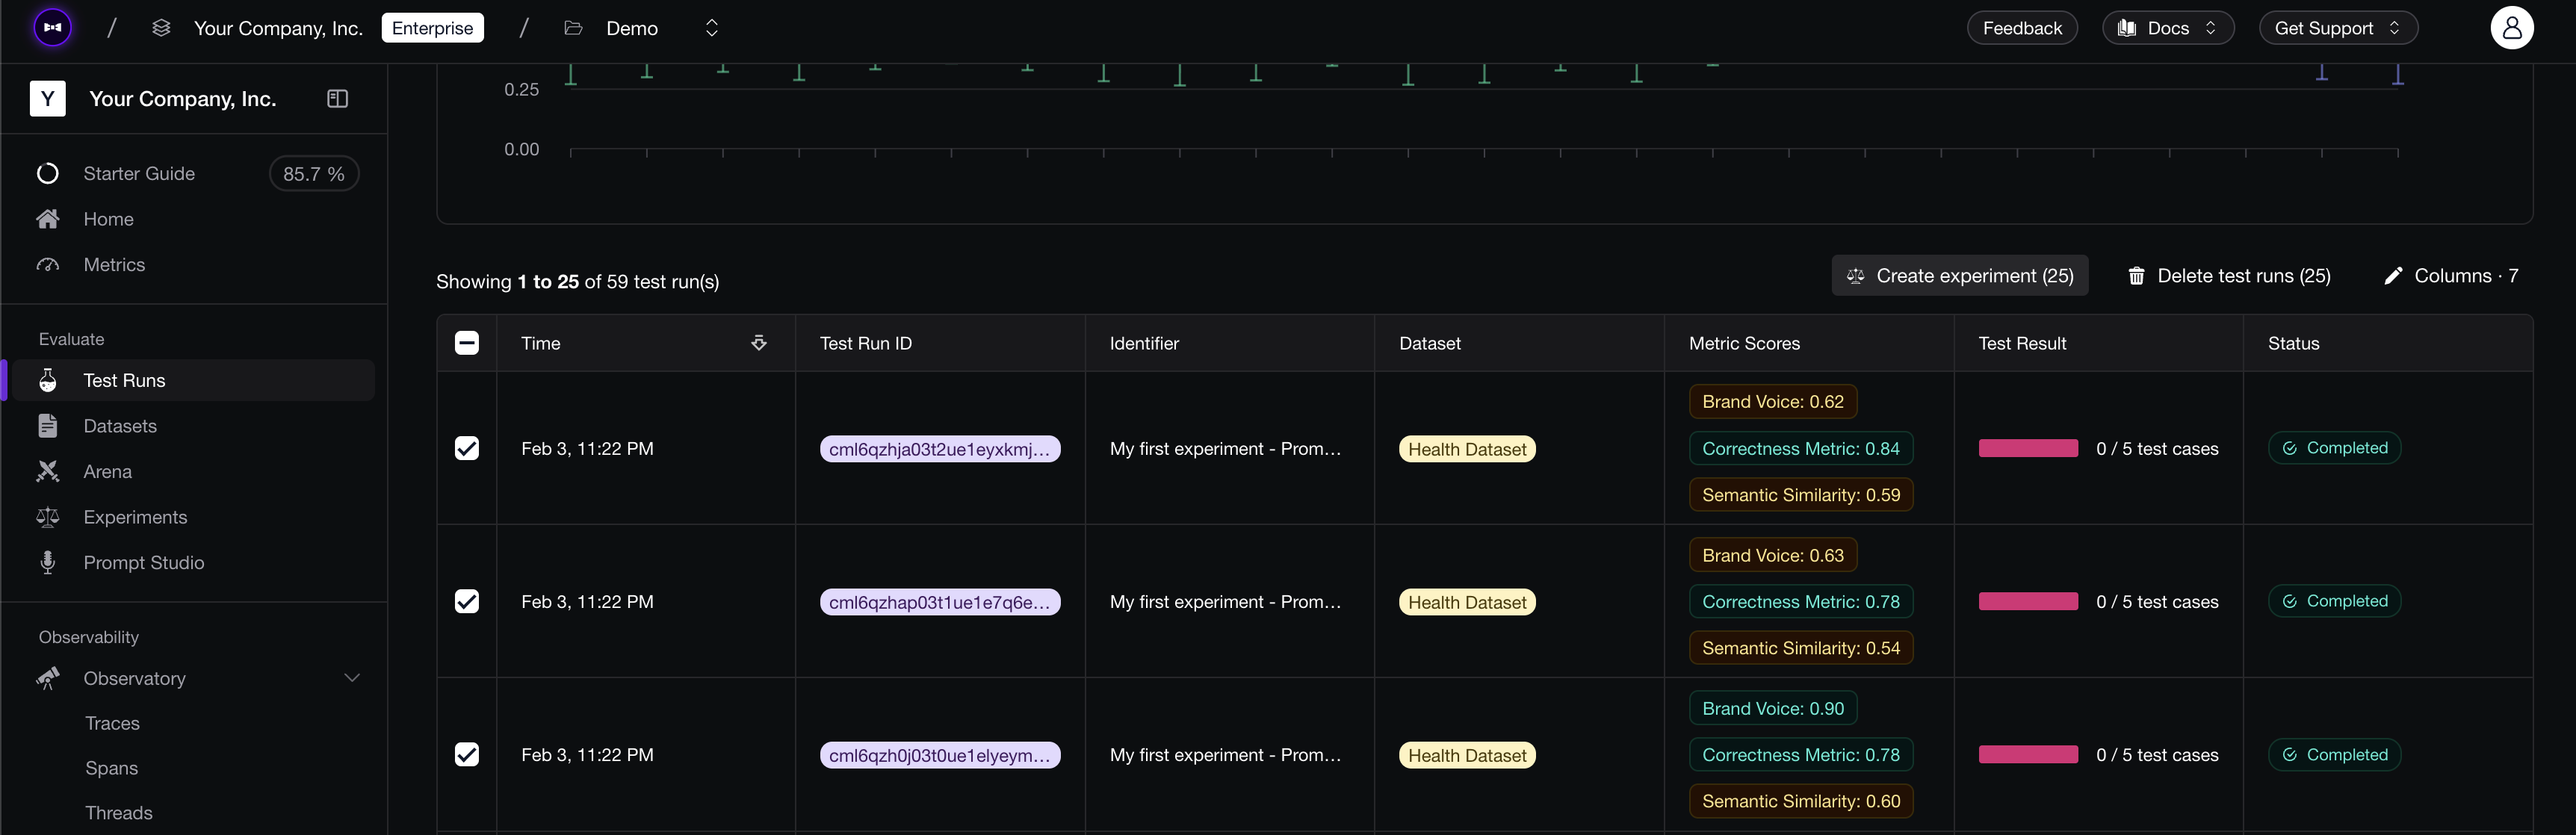
테스트 런 뷰에서 실험 만들기
결과 분석
실험 뷰는 모든 테스트 런을 집계해 다음을 보여줘요:
- 메트릭별 우승자 — 각 메트릭에서 가장 잘한 버전
- 통계적 유의성 — 비교에 대한 신뢰 수준
- 점수 분포 — 테스트 케이스 전반의 점수 변동 시각화
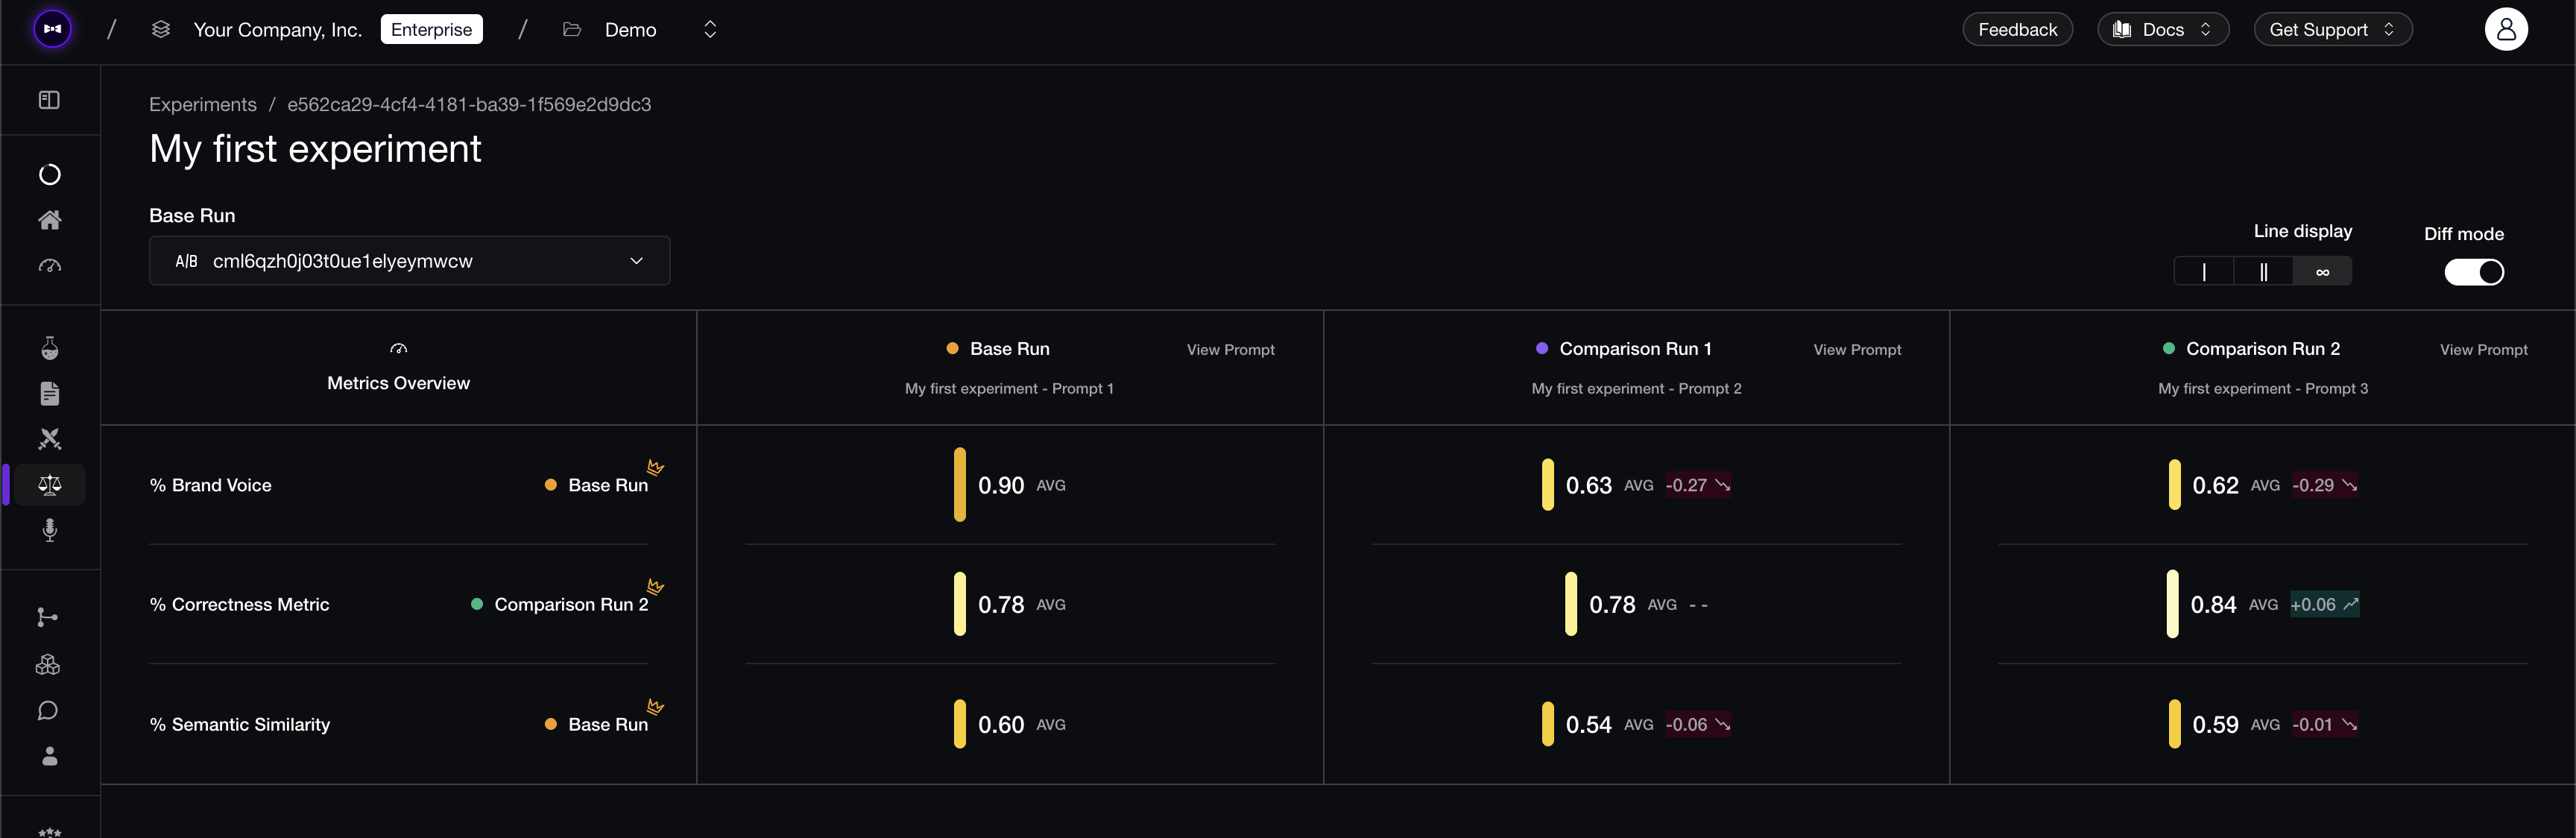
메트릭 개요와 테스트 케이스를 보여주는 실험 결과
결과 읽기
좋은 실험은 단순히 "A가 B보다 낫다"보다 더 많은 것을 알려줘요. 찾아볼 것들:
- 일관된 우승자 — 어떤 참가자가 모든 메트릭에서 이기면 명확한 선택이 있어요
- 트레이드오프 — 한 참가자는 더 관련성이 높지만 덜 간결할 수 있어요; 무엇이 가장 중요한지 결정하세요
- 접전 — 점수가 몇 퍼센트 포인트 안이라면 신뢰를 위해 테스트 케이스가 더 필요할 수 있어요
- 이상치 — 한 참가자가 압도적으로 잘하거나 못한 테스트 케이스를 파고들어 보세요
또한 편향을 피하기 위해 처음부터 각 참가자의 세부 사항을 들여다보지 않는 게 좋아요 — Confident AI는 의도적으로 참가자 세부 사항을 숨긴다는 점을 기억하세요. 각 열의 상단을 명시적으로 클릭해야만 볼 수 있어요.
다음 단계
실험을 실행했으니, 다음 단계는 결과를 더욱 신뢰할 수 있게 만드는 거예요. 실험은 데이터셋 품질만큼만 유효해요. 즉 데이터셋을 확장하고 잘 관리해야 해요.
데이터셋 (Datasets)
더 나은 실험을 위해 테스트 데이터셋을 늘리고, 정제하고, 유지하는 방법을 배워요.