
LLM 평가 메트릭
LLM 평가 메트릭
Confident AI에서의 LLM 평가는 메트릭에서 시작해요. 메트릭은 LLM 출력을 채점하고 평가하는 기준을 정의하는데, 개발 단계의 테스트부터 실험, 프로덕션 모니터링까지 어디서든 쓰여요. 이 글에서는 Confident AI가 제공하는 메트릭의 종류와 동작 원리를 하나씩 살펴볼게요.
출처: 문서
본문
개요
메트릭은 Confident AI에서 LLM 평가의 기반이에요. LLM 출력을 채점하고 평가하는 기준을 정의하죠. 개발 중 테스트, 실험 실행, 프로덕션 시스템 모니터링 등 어느 상황에서든 사용할 수 있어요.
Confident AI에서 "metrics"는 LLM 출력의 품질을 평가하는 평가 메트릭을 가리켜요. 지연 시간(latency), 비용(cost), 토큰 사용량 같은 운영 메트릭과는 달라요. 운영 데이터 추적은 Latency, Cost, and Error Tracking 문서를 참고하세요.
Confident AI는 두 가지 범주의 메트릭을 제공해요.
- Pre-built metrics(사전 구성 메트릭) — answer relevancy, faithfulness, hallucination 탐지 등 일반적인 평가 시나리오에 검증된 메트릭이에요.
- Custom metrics(사용자 정의 메트릭) — G-Eval(자연어 기준) 또는 Code-Evals(Python 코드)로 내 사용 사례에 맞는 메트릭을 직접 만들어요.
두 범주 모두 single-turn(개별 LLM 상호작용)과 multi-turn(대화형) 평가를 지원해요.
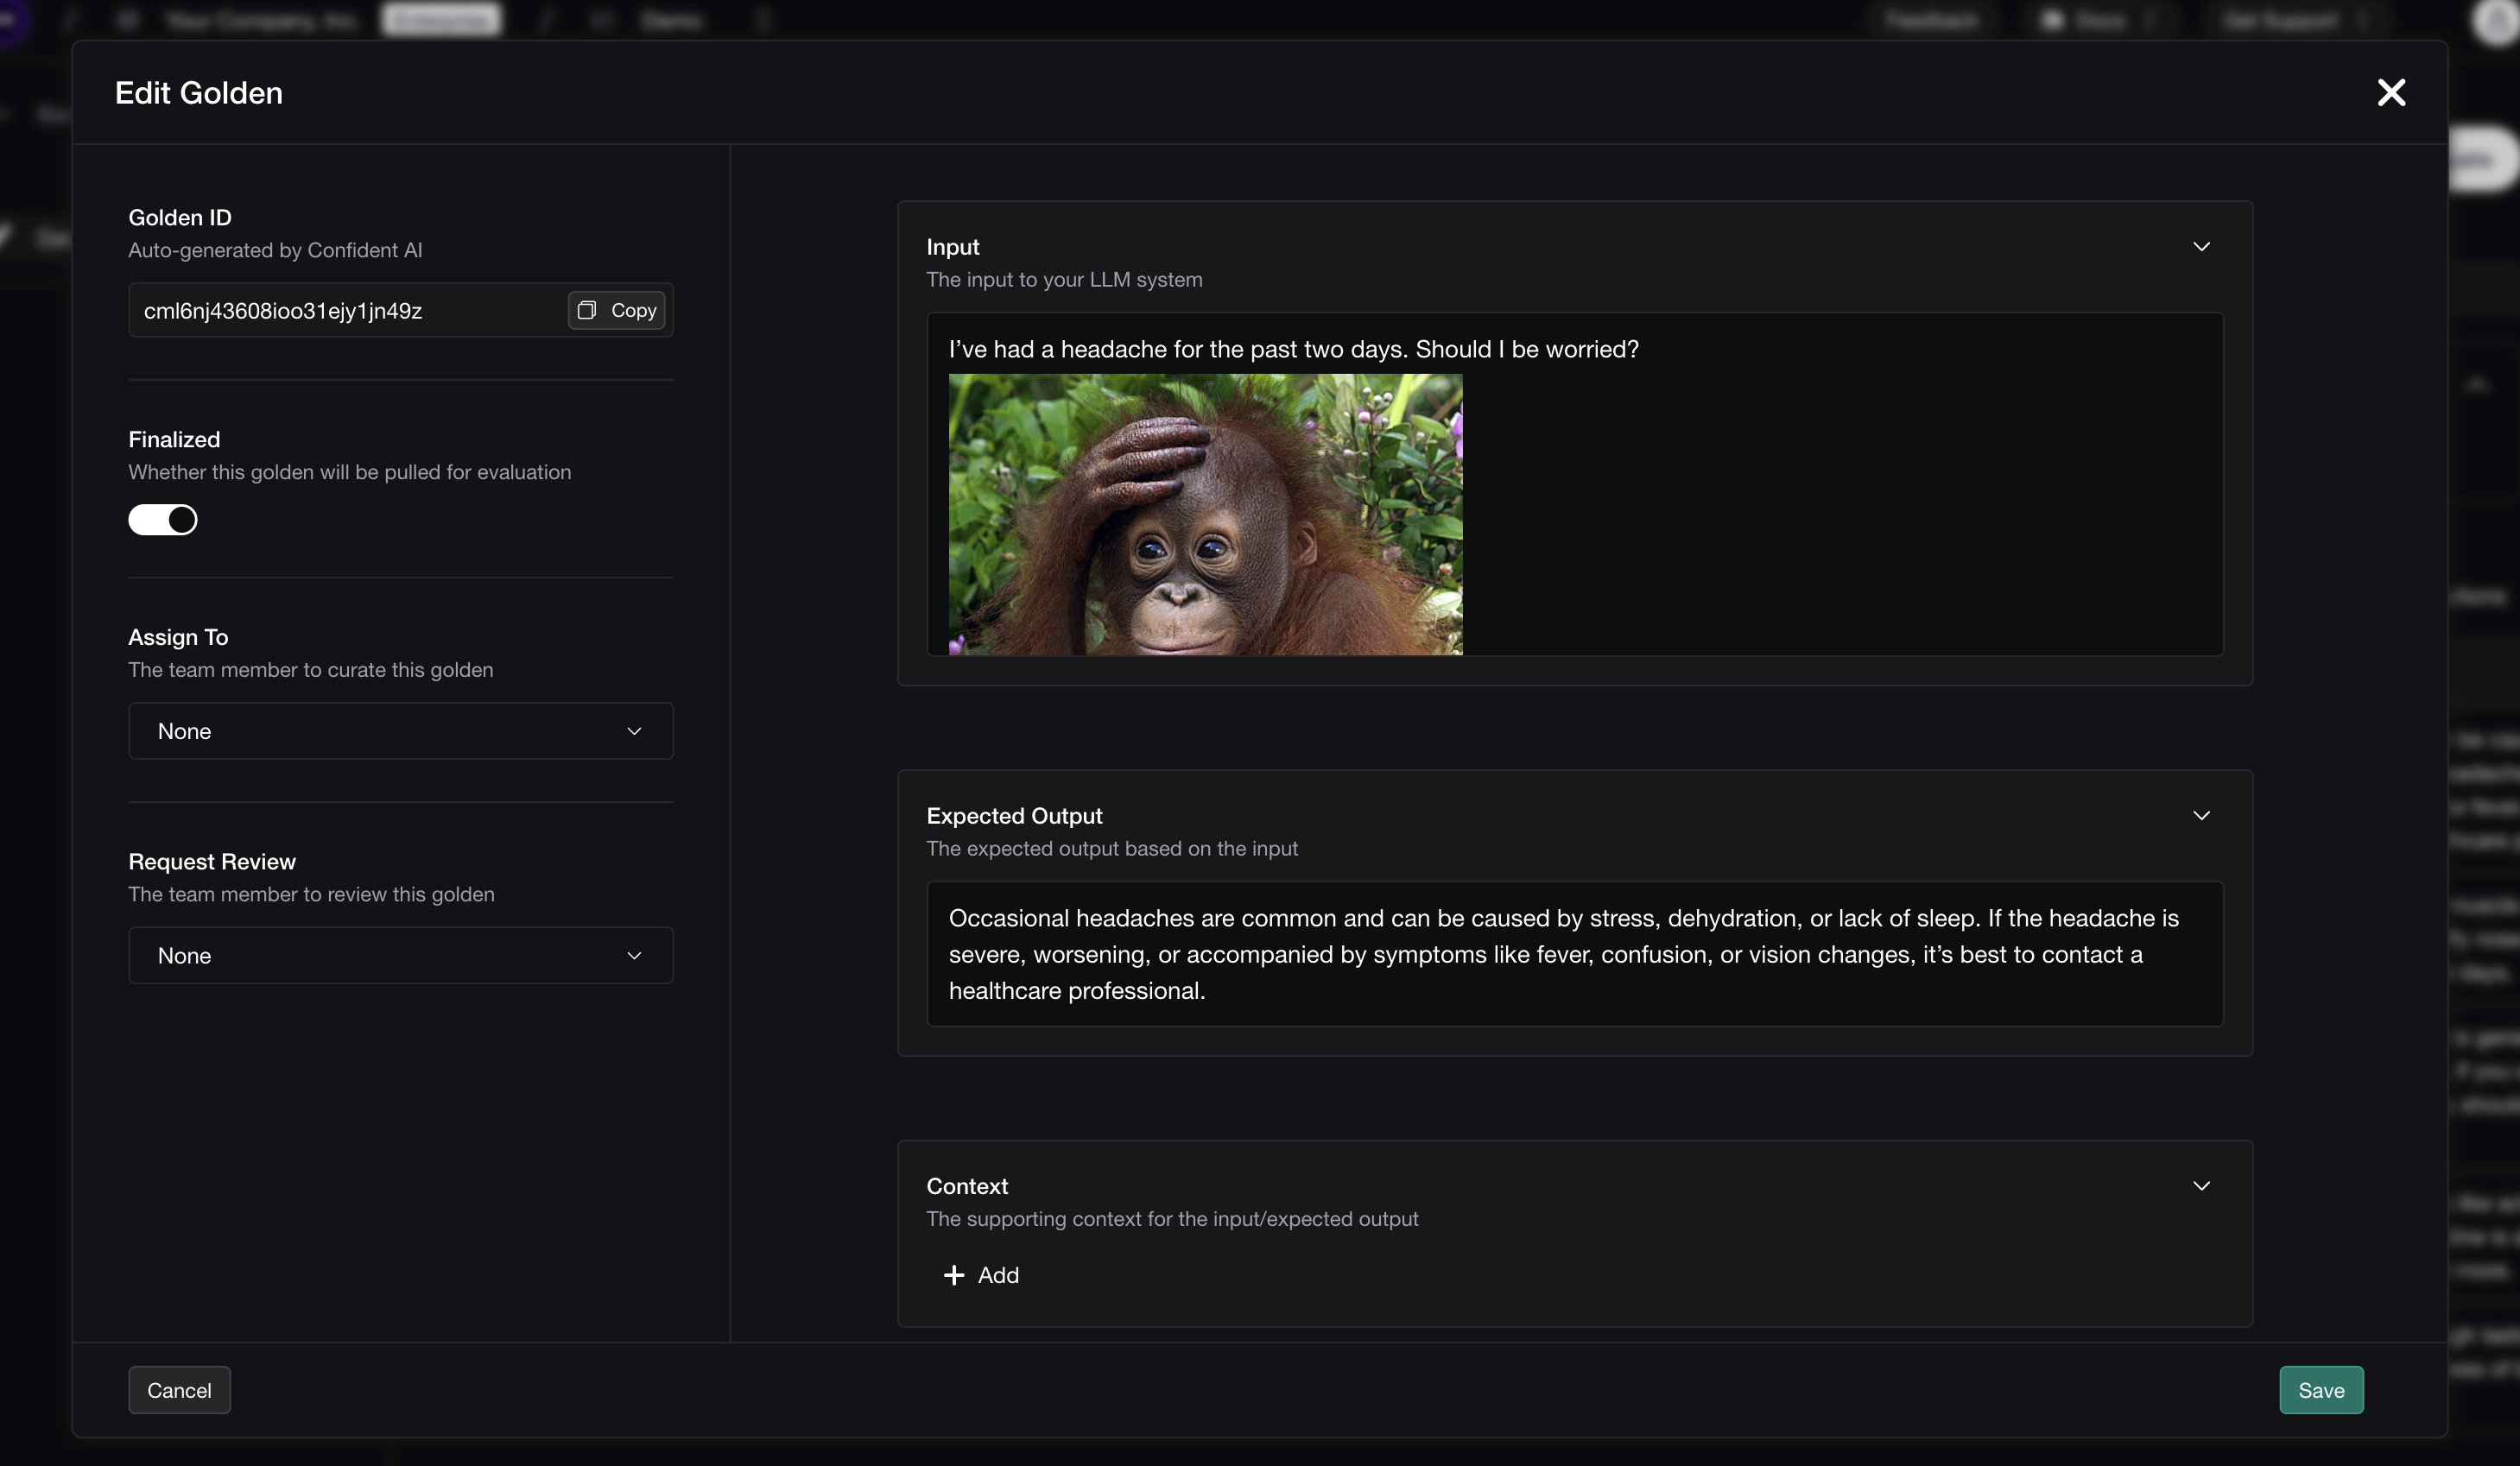
기본적으로 모든 메트릭은 멀티모달 평가를 네이티브로 지원해요. dataset editor의 golden 텍스트 필드에 이미지를 끌어다 놓으면 되는데, 자세한 내용은 여기에서 확인할 수 있어요.
dataset editor에서 golden에 이미지 추가하기
메트릭은 어떻게 동작하나요?
Confident AI의 메트릭은 단순한 패턴을 따라가요.
- 메트릭 정의 — 사전 구성 메트릭을 고르거나 커스텀 메트릭을 만들어요.
- 컬렉션으로 묶기 — 메트릭을 metric collection에 넣고 threshold, strictness 같은 설정을 지정해요.
- 평가 실행 — 컬렉션을 테스트 실행, 실험, 프로덕션 모니터링에 사용해요.
- 결과 분석 — 대시보드에서 점수, reasoning, pass/fail 상태를 확인해요.
Confident AI에서 원격 평가를 하려면 metric collection이 필수예요. 원격으로 실행하는 모든 메트릭(사전 구성이든 커스텀이든)은 반드시 어떤 컬렉션에 속해야 해요.
사전 구성 메트릭 (Pre-built Metrics)
Confident AI는 LLM-as-a-judge 기반으로 동작하는 방대한 사전 구성 메트릭 라이브러리를 제공해요.
Single-Turn
| 메트릭 | 설명 |
|---|---|
| Answer Relevancy | 응답이 입력 쿼리에 얼마나 관련 있는지 측정 |
| Argument Correctness | 각 tool call에 대해 생성된 인자를 판단 |
| Bias | 응답의 편향 콘텐츠 탐지 |
| Contextual Precision | 검색 랭킹 품질 평가 |
| Contextual Recall | 검색 완전성 측정 |
| Contextual Relevancy | 검색된 컨텍스트의 관련성 평가 |
| Exact Match | 출력이 기대 출력과 정확히 일치하는지 확인 |
| Faithfulness | 응답이 제공된 컨텍스트에 기반하는지 확인 |
| Hallucination | 지어낸 정보나 근거 없는 정보 탐지 |
| Image Coherence | 이미지가 주변 텍스트를 얼마나 잘 보완하는지 측정 |
| Image Editing | 이미지가 지시대로 편집되었는지 평가 |
| Image Helpfulness | 이미지가 텍스트 이해에 얼마나 도움이 되는지 측정 |
| Image Reference | 텍스트가 이미지를 얼마나 정확히 참조하는지 평가 |
| Misuse | 도메인 챗봇이 범위 밖 요청에 답한 것 탐지 |
| Non-Advice | 자격 없는 전문 조언 탐지 |
| Pattern Match | 출력이 정규 표현식과 일치하는지 확인 |
| PII Leakage | 개인 식별 정보 노출 탐지 |
| Plan Adherence | 에이전트가 세운 계획을 따랐는지 확인 |
| Plan Quality | 에이전트의 계획이 작업에 적합한지 평가 |
| Prompt Alignment | 출력이 프롬프트 지시를 따르는지 확인 |
| Role Violation | 부여된 캐릭터 이탈 탐지 |
| Step Efficiency | 에이전트가 불필요하게 수행한 단계 탐지 |
| Summarization | 요약 품질과 정확성 평가 |
| Task Completion | 작업이 성공적으로 완료되었는지 확인 |
| Tool Correctness | 올바른 tool/함수 사용 검증 |
| Toxicity | 유해하거나 공격적인 콘텐츠 식별 |
Multi-Turn
| 메트릭 | 설명 |
|---|---|
| Conversation Completeness | 대화가 목표를 달성했는지 측정 |
| Goal Accuracy | 에이전트가 사용자 목표에 도달했는지 측정 |
| Knowledge Retention | 턴 사이에 컨텍스트가 유지되는지 확인 |
| Role Adherence | 부여된 페르소나와의 일관성 평가 |
| Topic Adherence | 챗봇이 관련 주제에 머무르는지 확인 |
| Turn Contextual Precision | 각 턴에서 검색 랭킹 품질 평가 |
| Turn Contextual Recall | 각 턴에서 검색 완전성 측정 |
| Turn Contextual Relevancy | 각 턴에서 검색된 컨텍스트의 관련성 평가 |
| Turn Faithfulness | 각 턴이 검색된 컨텍스트에 기반하는지 확인 |
| Turn Relevancy | 각 대화 턴의 관련성 평가 |
커스텀 메트릭 (Custom Metrics)
사전 구성 메트릭이 내 사용 사례에 맞지 않을 때는 커스텀 메트릭을 만들어요.
G-Eval
자연어로 평가 기준을 정의해요. 톤, 도움됨, 도메인별 정확성 같은 주관적 품질에 가장 적합해요.
Code-Evals
Confident AI에서 직접 Python 코드를 작성해요. 결정적 검증, 포맷 검증, 복잡한 계산에 가장 적합해요.
Arena G-Eval
LLM 앱의 두 개 이상 버전 중 더 나은 것을 고르게 해요. 프롬프트나 모델을 서로 비교할 때 가장 적합해요.
DAG
평가를 위한 결정적 의사결정 트리를 만들어요. 조건부 규칙, 게이트, 알려진 채점 경로에 가장 적합해요.
다음 단계
평가를 시작할 준비가 되셨나요? 이어서 볼 내용이에요.
Metric Collections
원격 평가를 위해 메트릭을 묶고 설정하는 방법을 배워요.
Custom Metrics
구체적인 평가 요구에 맞는 메트릭을 만들어요.
더 알아보기
- G-Eval — 자연어 기준으로 LLM-as-a-judge 메트릭 만들기
- Metric Collections — 메트릭을 묶어 원격 평가 실행하기