
테스트 케이스, 골든스, 데이터셋
테스트 케이스, 골든스, 데이터셋 (Test Cases, Goldens, and Datasets)
LLM 평가의 핵심 프리미티브(primitive)를 배워볼게요. 테스트 케이스, 골든스, 데이터셋은 LLM 앱과의 상호작용이 Confident AI에서 어떻게 표현되는지를 정의하는 가장 중요한 기초 개념이에요. 메트릭을 적용하기 전에 이 셋이 서로 어떻게 이어지는지 이해해야 해요.
출처: 문서
본문
개요
테스트 케이스, 골든스, 데이터셋은 LLM 평가를 배울 때 가장 중요한 프리미티브 세 가지예요. 이들은 LLM 앱과의 상호작용이 Confident AI에서 어떻게 표현되는지를 정의하며, 평가에 메트릭을 적용할 때 필수적인 개념이에요.
요약하면:
- 테스트 케이스(Test cases) — LLM 앱과의 싱글턴 또는 멀티턴 상호작용을 나타내며, 메트릭이 평가에 사용해요
- 골든스(Goldens) — 테스트 케이스의 전 단계예요. Confident AI에서 데이터셋을 편집할 때 편집하는 것은 골든스이며, LLM 앱을 시작하는
input뿐 아니라 앱 호출에 필요한 기타 커스텀 메타데이터도 담겨 있어요 - 데이터셋(Datasets) — 골든스의 목록으로, 싱글턴·멀티턴·E2E·컴포넌트 레벨 테스트 등 전체 평가 과정을 조율해요
이 프리미티브들은 Confident AI에 표준화되어 있으며 모든 형태의 평가에 사용돼요.
메트릭이 무엇을 평가하는지 이해하려면 테스트 케이스를 먼저 이해해야 해요. 다음 섹션에서 이어집니다.
테스트 케이스 (Test Cases)
테스트 케이스는 LLM 앱의 런타임 인풋과 아웃풋을 캡처하며, 메트릭이 이를 평가에 사용해요. 테스트 케이스는:
- 테스트 런(test run)에서만 찾을 수 있고, 평가 후에 생성돼요
- 메트릭 점수로 결정되는 통과/실패(pass/fail) 상태를 담고 있어요
- 불변(immutable)이라 생성 후 편집할 수 없어요
개발자로서 이 인자들을 싱글턴 또는 멀티턴 방식의 테스트 케이스 형식으로 매핑해야 해요.
싱글턴 (Single-Turn)
싱글턴 테스트 케이스는 LLM 앱과의 단일하고 원자적인 상호작용을 나타내요:
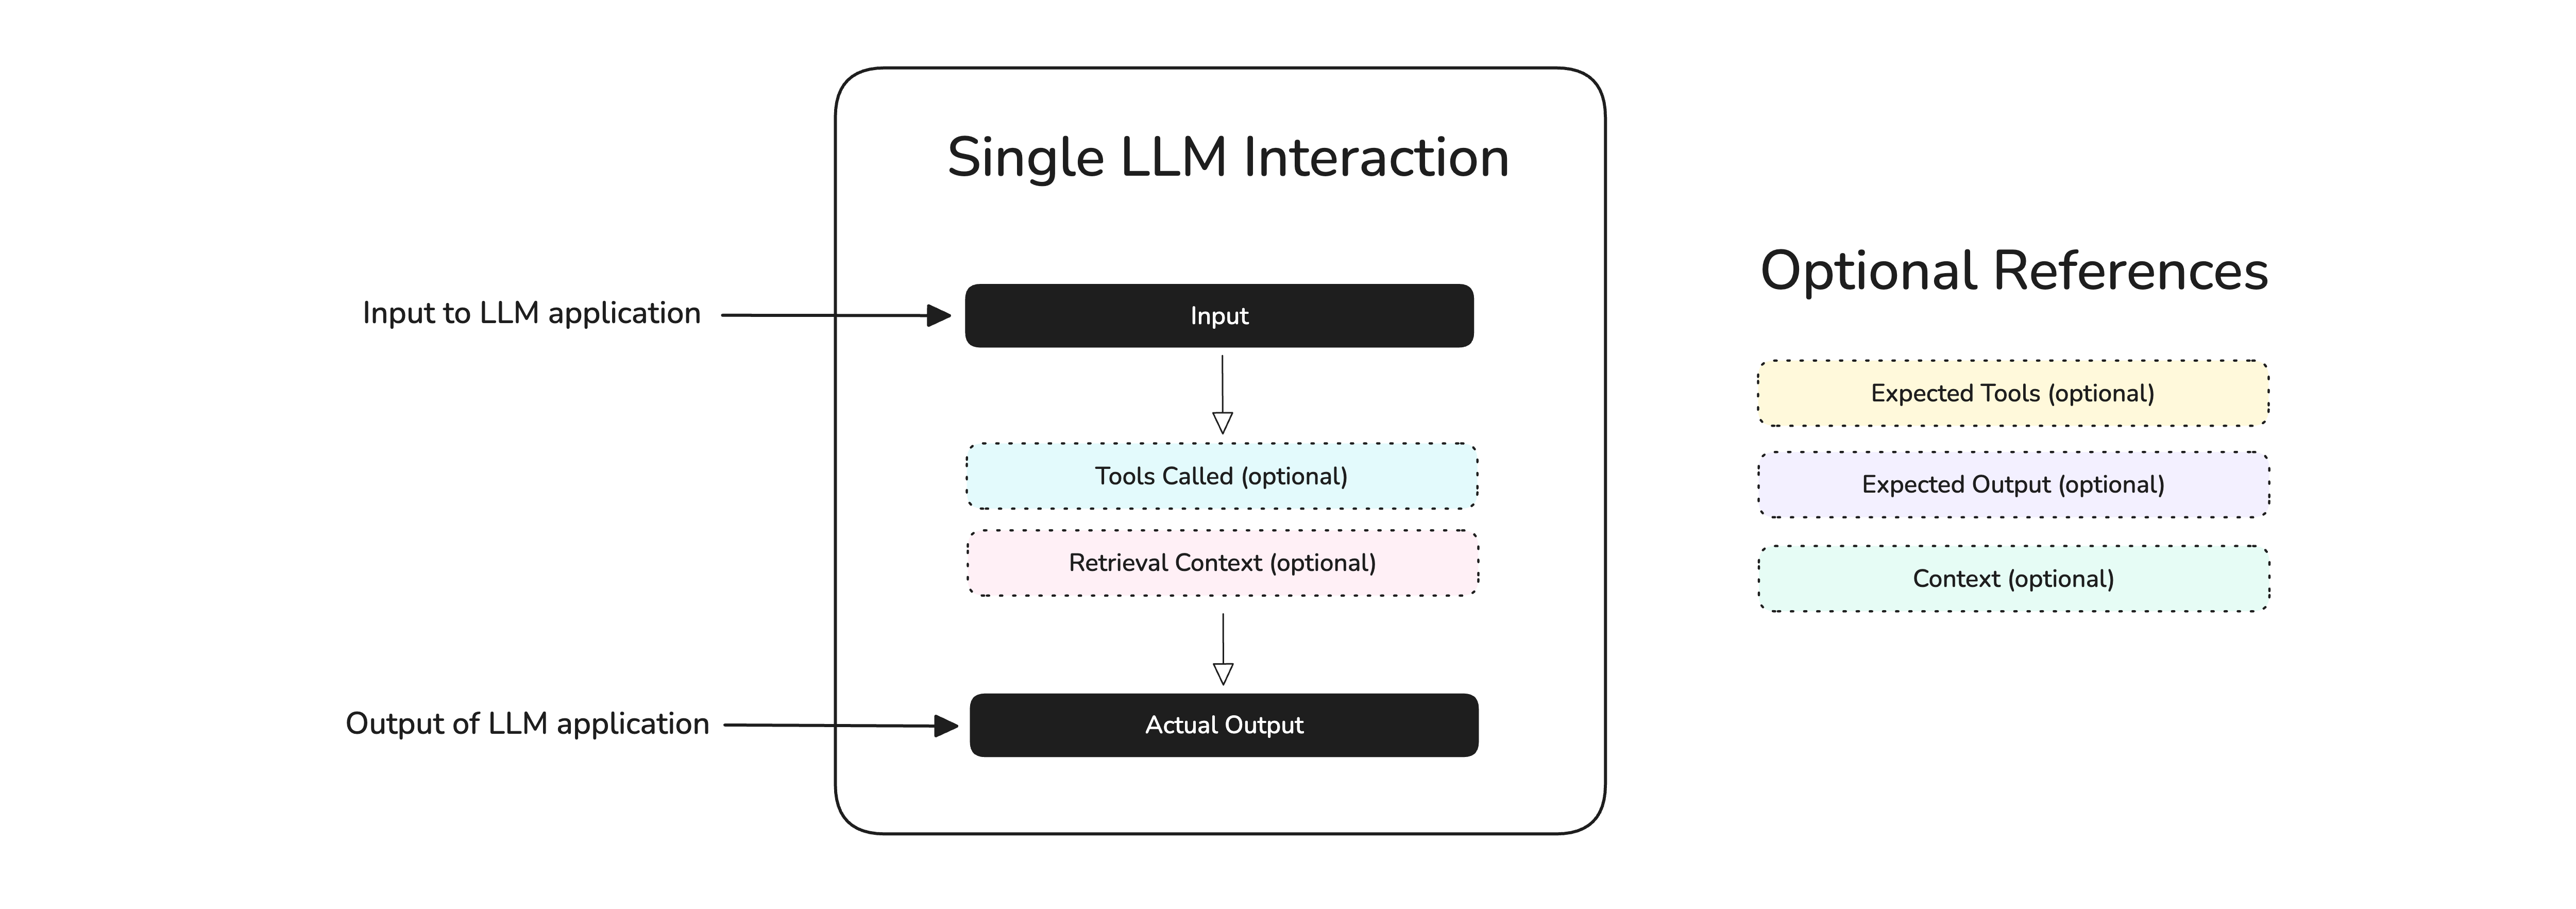
단일 LLM 상호작용
위 다이어그램에서 상호작용은 input, actual_output, (RAG용) retrieval_context, tools_called 등을 포함할 수 있어요. 상호작용은 다음 두 곳 어디든 존재할 수 있어요:
- 종단 간 레벨(End-to-end level): "관찰 가능한" 시스템 인풋과 아웃풋이 테스트 케이스로 들어가요
- 컴포넌트 레벨(Component-level): 개별 컴포넌트의 상호작용이 테스트 케이스로 들어가요
deepeval에서 싱글턴 테스트 케이스는 LLMTestCase로 표현돼요:
from pydantic import BaseModel

class LLMTestCase(BaseModel):
    input: str
    actual_output: Optional[str] = None
    retrieval_context: Optional[List[str]] = None
    tools_called: Optional[List[ToolCall]] = None

    # Static fields that are ported over from goldens
    expected_output: Optional[str] = None
    context: Optional[List[str]] = None
    expected_tools: Optional[List[ToolCall]] = None

    # Not used for evals
    name: Optional[str] = None
각 파라미터는 상호작용의 서로 다른 측면을 나타내요:
- Input: LLM 앱에 넣는 인풋이에요. 보통 전체 프롬프트는 아니고, 예를 들어 OpenAI API를 쓴다면 마지막 유저 메시지의 내용이 되죠.
- Actual output: 주어진 인풋에 대한 LLM 앱의 아웃풋이에요.
- Retrieval Context: 검색된 동적 텍스트 청크로, 특히 RAG 유스케이스에서 중요해요.
- Tools Called: 주어진 인풋에 대해 호출된 툴들이에요.
- Expected Output: 주어진 인풋에 대한 LLM 앱의 이상적인 아웃풋이에요.
- Context: 유스케이스와 관련된 정적 보조 컨텍스트예요.
- Expected Tools: 주어진 인풋에 대해 호출되어야 하는 이상적인 툴 목록이에요.
평가 중에 LLMTestCase의 input과 actual_output 필드를 어떻게 채우는지 간단한 예시를 볼게요:
from openai import OpenAI
from deepeval.test_case import LLMTestCase

client = OpenAI()

def llm_app(query: str) -> str:
    return client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "user", "content": query}
        ]
    ).choices[0].message.content

query = "What's the date today?"
output = llm_app(query)

test_case = LLMTestCase(input=query, actual_output=output)
실제로는 예시처럼 인풋이 고립되어 있는 경우가 거의 없고, 대부분 데이터셋의 싱글턴 골든스에서 온다는 점을 기억하세요.
이후 섹션에서 회귀 테스트를 실행할 때, 테스트 케이스의 인풋이나 이름을 매칭해 테스트 런 간에 성능이 회귀했는지 확인할 거예요.
멀티턴 (Multi-Turn)
멀티턴 테스트 케이스는 LLM 앱과의 일련의 상호작용을 나타내요:
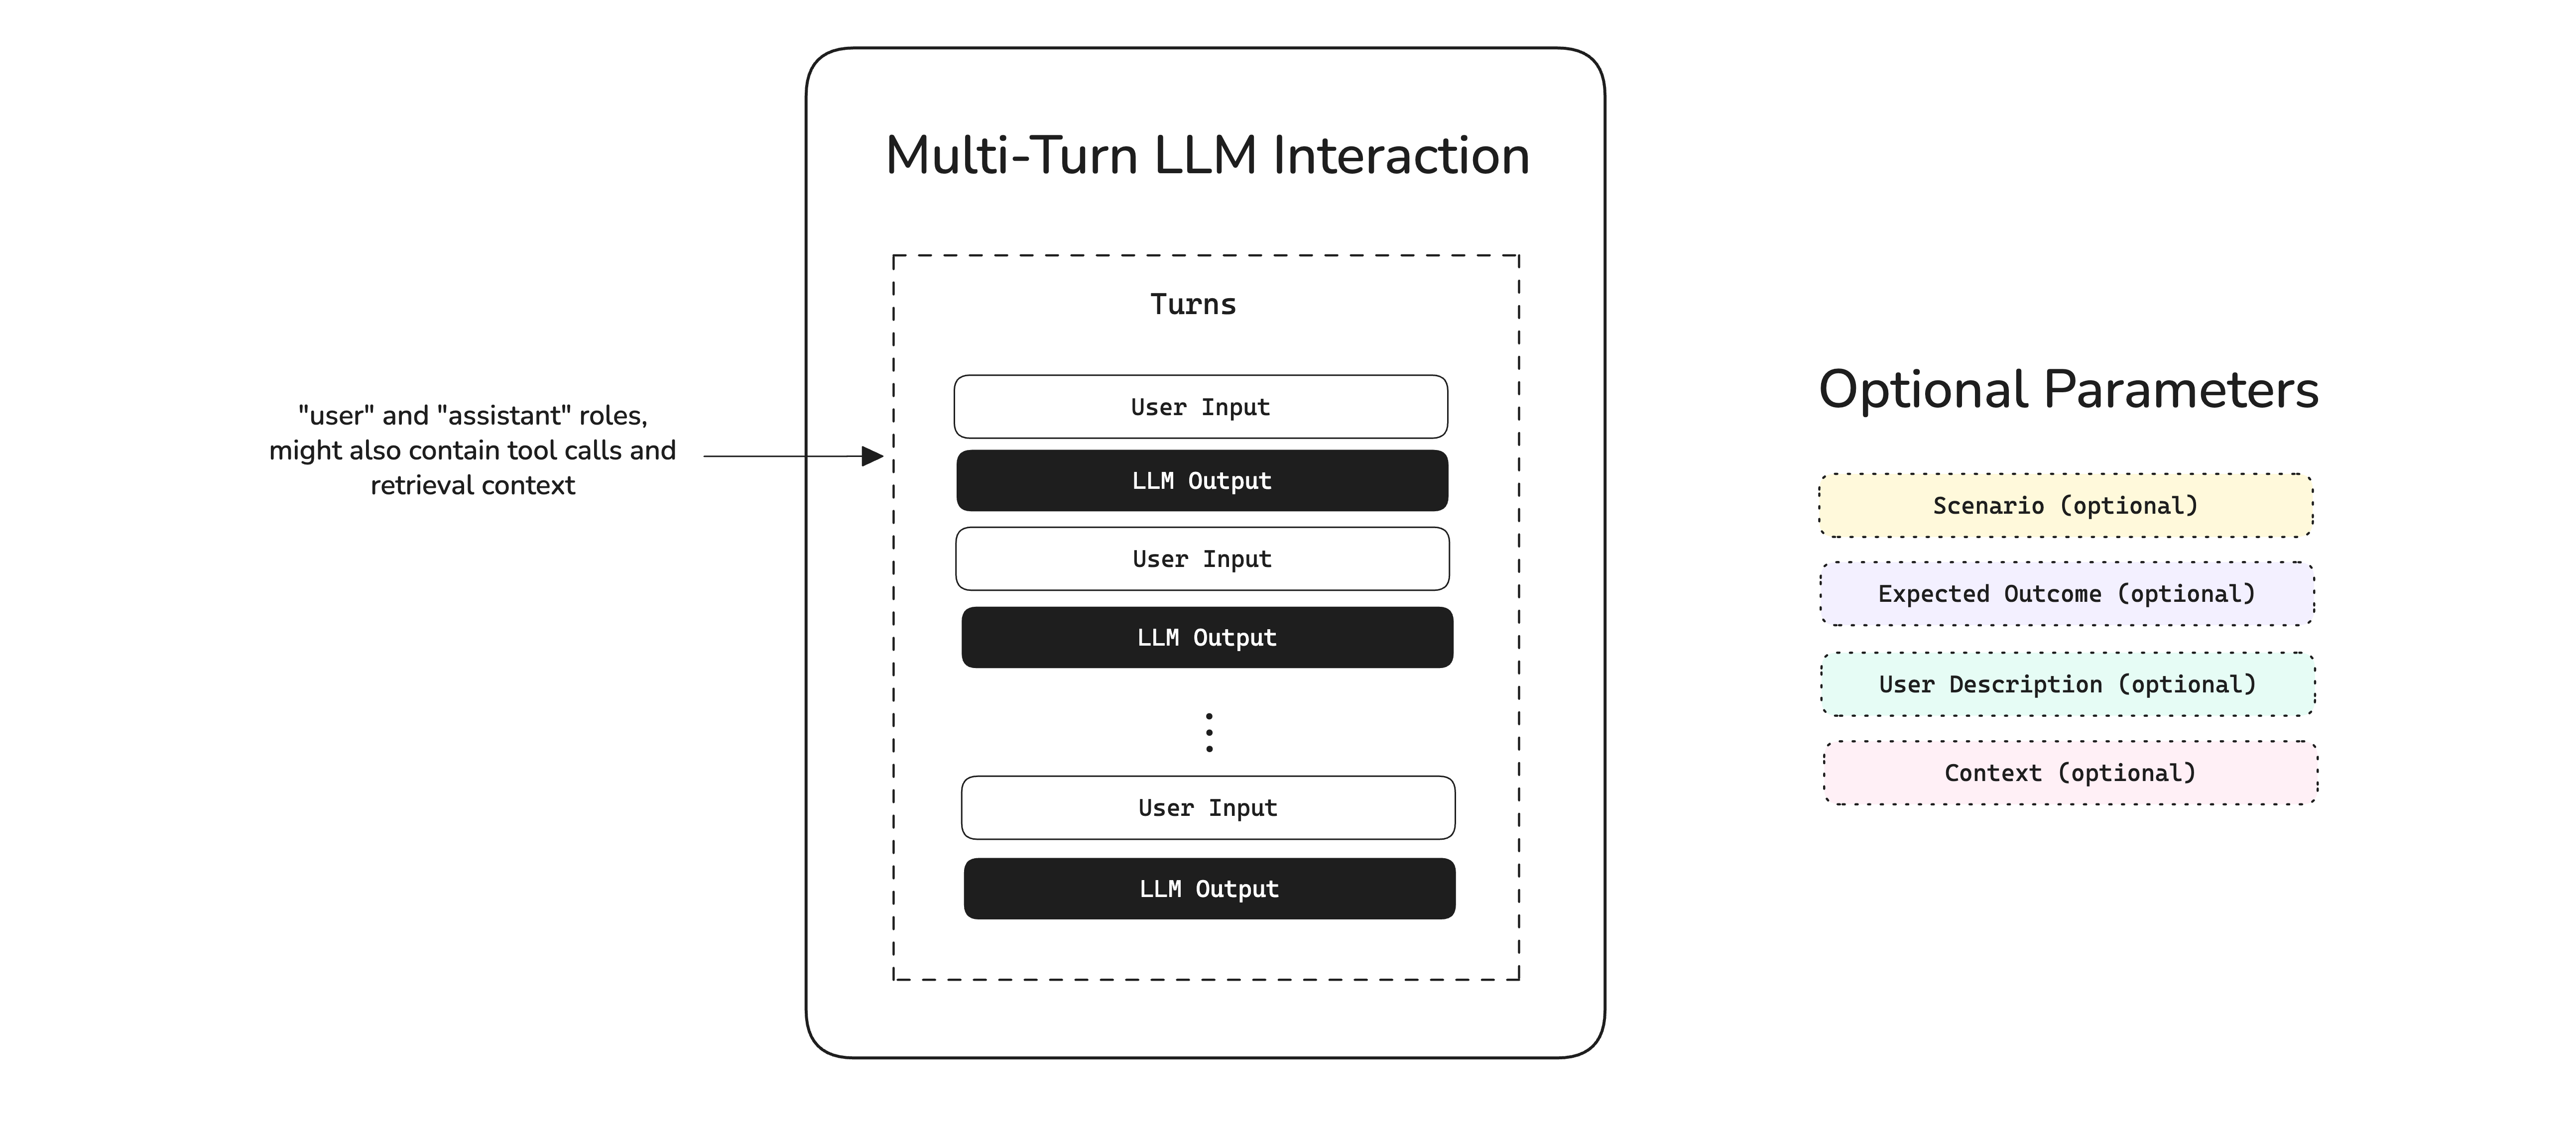
다중 LLM 상호작용
위 다이어그램에서 상호작용은 턴(turn) 목록으로 구성되며, 이는 유저와 AI 사이의 교환을 나타내요. deepeval에서는 ConversationalTestCase로 표현돼요:
from pydantic import BaseModel

class ConversationalTestCase(BaseModel):
    turns: List[Turn]
    scenario: Optional[str] = None
    expected_outcome: Optional[str] = None
    user_description: Optional[str] = None
    context: Optional[List[str]] = None

    # Not used for evals
    name: Optional[str]
각 파라미터는 상호작용의 서로 다른 측면을 나타내요:
- Turns: 대화의 메시지 목록이며, 예를 들어 특정 어시스턴트 아웃풋에서 호출된 툴을 명시해요. OpenAI API 형식을 따릅니다.
- Scenario: 대화가 진행되는 상황(경위)을 명시해요.
- Expected Outcome: 주어진 시나리오에 대한 바람직하고 이상적인 결과를 개요로 보여줘요.
- User Description: 멀티턴 LLM 앱과 상호작용하는 유저에 대한 설명이에요.
- Context: 유스케이스와 관련된 정적 보조 컨텍스트예요.
평가 중에 ConversationalTestCase의 turns 필드를 어떻게 채우는지 간단한 예시를 볼게요:
from openai import OpenAI
from deepeval.test_case import ConversationalTestCase, Turn

client = OpenAI()
messages, turns = [], []

# Example multi-turn conversation until user says it's done
for user_msg in ["What's the date today?", "And the day of week?", "Thanks, that's all."]:
    # Add user turn
    messages.append({"role": "user", "content": user_msg})
    turns.append(Turn(role="user", content=user_msg))

    # Get assistant reply and add assistant turn
    reply = client.chat.completions.create(model="gpt-4o", messages=messages).choices[0].message.content
    messages.append({"role": "assistant", "content": reply})
    turns.append(Turn(role="assistant", content=reply))

    # Stop once conversation is terminated
    if "thanks" in user_msg.lower():
        break

# Build test case only after the full conversation
test_case = ConversationalTestCase(turns=turns)
멀티턴 테스트 케이스는 각 n번째 아웃풋이 (n-1)번째 유저 인풋에 의존하기 때문에 구성하기가 더 까다로워요. 이런 이유로 Confident AI는 유저 상호작용 시뮬레이션 기능도 제공해요.
이 의존성 때문에 어떤 단일 턴의 내용에 평가를 고정시킬 수 없어요. 대신 회귀 테스트 시 대화를 이끄는 시나리오를 매칭해서 테스트 케이스를 비교해요.
골든스 (Goldens)
골든스는 테스트 케이스와 매우 유사해요 — 실제로 싱글턴과 멀티턴 모두 거의 동일하죠. 다만 골든스는 편집 위주(edit-heavy)이며, 평가를 위해 LLM 앱을 시작할 때 더 많은 유연성을 제공하는 추가 필드를 담고 있어요.
Confident AI에서 데이터셋을 편집할 때 편집하는 것은 테스트 케이스가 아니라 골든스예요. 또 중요한 점은, 싱글턴 골든스는 싱글턴 테스트 케이스를 만들고 그 반대도 마찬가지라는 거예요.
싱글턴 (Single-Turn)
싱글턴 골든스는 deepeval의 Golden 클래스로 표현돼요:
from pydantic import BaseModel

class Golden(BaseModel):
    input: str
    expected_output: Optional[str] = None
    context: Optional[List[str]] = None
    expected_tools: Optional[List[ToolCall]] = None

    # Useful metadata for generating test cases
    additional_metadata: Optional[Dict] = None
    comments: Optional[str] = None
    custom_column_key_values: Optional[Dict[str, str]] = None

    # Fields that you should ideally not populate
    actual_output: Optional[str] = None
    retrieval_context: Optional[List[str]] = None
    tools_called: Optional[List[ToolCall]] = None
골든스에 actual output, retrieval context, tools called를 미리 채우는 것은 권장하지 않아요. 이들은 동적으로 채워지도록 설계된 필드라서, 미리 채우면 평가의 목적을 무색하게 만들어요.
멀티턴 (Multi-Turn)
멀티턴 골든스는 deepeval의 ConversationalGolden 클래스로 표현돼요:
from pydantic import BaseModel

class ConversationalGolden(BaseModel):
    scenario: str
    expected_outcome: Optional[str] = None
    user_description: Optional[str] = None
    context: Optional[List[str]] = None

    # Useful metadata for generating test cases
    additional_metadata: Optional[Dict] = None
    comments: Optional[str] = None
    custom_column_key_values: Optional[Dict[str, str]] = None

    # Fields that you should ideally not populate
    turns: Optional[Turn] = None
turns 필드는 이상적으로 채우지 않는 것이 좋지만, 평가 전에 처음부터 전체 대화를 시뮬레이션하지 않도록 일반적인 시작 메시지 역할을 하는 몇 개의 턴을 두면 유용할 수 있어요.
골든스는 좀 더 의견이 반영된(opinionated) 구조이며, 플랫폼이나 코드를 통해 편집할 수 있는 custom_column_key_values 필드를 담고 있다는 점을 눈여겨보세요.
데이터셋 (Datasets)
마지막으로, 데이터셋은 골든스의 모음이에요. 데이터셋은 멀티턴 또는 싱글턴 중 하나이며, 동시에 둘 다일 수는 없어요. 데이터셋은 다음 두 가지 방법으로 만들 수 있어요:
- Project > Datasets 아래에서 플랫폼에서 직접, 또는
- Confident API를 통해 (
deepeval에서도 사용 가능)
싱글턴 데이터셋을 만들려면 싱글턴 골든스를 사용해야 하며, 그 반대도 마찬가지예요. 평가 시점에는 다음 단계를 수행해야 해요:
- 데이터셋의 골든스를 순회하면서 각 골든스의 인풋을 사용해 LLM 앱을 호출
- 골든스와 LLM 앱에서 올바른 인자를 매핑해 테스트 케이스 생성
- 이 테스트 케이스들을 다시 데이터셋에 추가
- 이 테스트 케이스들에 대해 평가 실행
이 워크플로우는 매우 중요하며, 종단 간·컴포넌트 레벨·싱글턴·멀티턴 평가 중 무엇을 실행하든 동일하게 유지돼요.
사용자들이 3단계의 중요성을 종종 간과하는데, 이는 매우 중요해요. 어떤 테스트 런이 어떤 데이터셋에 속하는지 Confident AI에 알려주고, 그래야 나중에 프롬프트와 모델을 비교할 수 있거든요.
종단 간 평가의 간단한 예시를 볼게요:
싱글턴 (Single-Turn)
from deepeval.dataset import EvaluationDataset
from deepeval.test_case import LLMTestCase
from deepeval.metrics import AnswerRelevancyMetric
from deepeval import evaluate

dataset = EvaluationDataset()
dataset.pull(alias="YOUR-DATASET-ALIAS") # replace with your alias

# step 1.
for golden in dataset.goldens:
    test_case = LLMTestCase(
        input=golden.input,
        actual_output=your_llm_app(golden.input) # step 2.
    )
    # step 3., very important!
    dataset.add_test_case(test_case)

# step 4.
evaluate(test_cases=dataset.test_cases, metrics=[AnswerRelevancyMetric()])
멀티턴 (Multi-Turn)
from deepeval.dataset import EvaluationDataset
from deepeval.test_case import ConversationalTestCase
from deepeval.metrics import TurnRelevancyMetric
from deepeval import evaluate

dataset = EvaluationDataset()
dataset.pull(alias="YOUR-DATASET-ALIAS") # replace with your alias

# step 1.
for golden in dataset.goldens:
    test_case = ConversationalTestCase(
        scenario=golden.scenario,
        turns=generate_turns(golden.scenario) # step 2.
    )
    # step 3.
    dataset.add_test_case(test_case)

evaluate(test_cases=dataset.test_cases, metrics=[TurnRelevancyMetric()])
싱글턴과 멀티턴 예시를 모두 보면, 멀티턴 평가가 왜 훨씬 까다로운지 알 수 있어요. 골든스를 테스트 케이스로 바꾸는 필요한 ETL뿐 아니라, 긴 턴 목록도 생성해야 하니까요.
다음 단계
이제 싱글턴·멀티턴·종단 간·컴포넌트 레벨 테스트가 무엇인지, 그리고 평가에 관여하는 프리미티브를 알았으니 다음을 이해할 때가 됐어요:
- LLM-as-a-Judge 메트릭이 무엇인지
- 어떤 메트릭이 여러분의 유스케이스에 적합한지