
LLM 비용 추적
LLM 비용 추적 (Track LLM Costs)
LLM 호출의 토큰 사용량과 비용을 추적하는 방법을 다루는 페이지예요. Confident AI가 LLM 호출의 토큰 사용량·비용을 추적해서 애플리케이션 전반의 고비용 모델과 과도한 사용 패턴을 식별하도록 도와줘요. 비용 추적은 LLM 스팬에만 적용된답니다.
출처: 문서
본문
개요 (Overview)
Confident AI는 LLM 호출의 토큰 사용량과 비용을 추적해서, 애플리케이션 전반의 고비용 모델과 과도한 사용 패턴을 식별하도록 도와줘요.
LLM Cost Tracking
동작 방식 (How It Works)
Confident AI는 각 LLM 스팬에 대해 토큰 사용량과 비용을 다음 우선순위 순서로 결정하고, 입력·출력 토큰을 각각 따로 처리해요:
confident-trace에 설정된 토큰당 비용과 개수(span(...)또는update_span()/updateSpan()을 통해)는 최우선순위이며 항상 다른 어떤 소스도 덮어써요.- 통합이 토큰 개수를 제공할 수 있지만, 비용 계산은 같은 방식으로 이루어져요.
- 커스텀 설정된 모델 비용 — 토큰 개수는 제공하지만 토큰당 비용은 제공하지 않는다면, Confident AI는 Model Costs 설정에서 구성한 가격으로 비용을 계산해요.
- 자동 추론 — 토큰당 비용도 프로젝트 레벨 비용도 없다면, Confident AI는 프로바이더별 토크나이저로 스팬의 입력/출력 텍스트를 토큰화하고 내부적으로
model에 기반한 가격을 조회해요.
자동 추론은 OpenAI, Anthropic, Gemini 모델에서만 사용 가능해요. 다른 모든 프로바이더는 토큰 개수와 비용을 수동으로 제공하거나 프로젝트 설정에서 Model Costs를 구성하세요.
자동 사용량 캡처 (Automatic Usage Capture)
OpenAI 통합이나 다른 지원 프로바이더 통합을 사용한다면 아무것도 할 필요가 없어요: init()이 클라이언트를 계측하고 각 호출의 input_token_count와 output_token_count가 표준 OpenTelemetry GenAI 속성을 사용해 LLM 스팬에 캡처돼요.
스트리밍 중인가요? 스트리밍된 응답의 사용량은 프로바이더가 반환하는 것에 달려 있고 스트림이 완료된 후에만 사용 가능해지므로, 스트림 전체를 소비하세요. 일부 프로바이더는 스트림에 대해 사용량 보고를 명시적으로 켜야 해요 — OpenAI의 경우
stream_options={"include_usage": True}예요.
토큰 사용량 개수 추적 (Track Token Usage Count)
update_span() / updateSpan()으로 LLM 스팬에 입력·출력 토큰 개수를 수동으로 설정할 수 있어요. 프로바이더가 응답에 토큰 사용량을 반환하고 정밀하게 기록하고 싶을 때, 또는 통합이 다루지 않는 모델을 호출할 때 유용해요.
Python
from confident_trace import span, update_span

@span(type="llm", model="gpt-4o", provider="openai")
def generate_response(prompt: str) -> str:
    response = call_llm(prompt)
    update_span(
        input_token_count=response.usage.prompt_tokens,
        output_token_count=response.usage.completion_tokens,
    )
    return response.text
TypeScript
import { span, updateSpan } from "confident-trace";

const generateResponse = span(
  { name: "generate_response", type: "llm", model: "gpt-4o", provider: "openai" },
  async (prompt: string) => {
    const response = await callLlm(prompt);
    updateSpan({
      inputTokenCount: response.usage.promptTokens,
      outputTokenCount: response.usage.completionTokens,
    });
    return response.text;
  },
);
토큰 개수는 음이 아닌 정수여야 하고, 명시적인 0은 설정되지 않은 것으로 취급하지 않고 0으로 유지돼요.
통합이 이미 계측하는 호출 주위에 수동
llm스팬을 추가하지 마세요 — 하나의 요청에 대해 LLM 스팬 두 개(그리고 비용 두 배)가 생기거든요. 수동 토큰 개수는 통합이 다루지 않는 호출에만 사용하세요.
토큰 개수를 제공하지 않고 통합도 쓰지 않는다면, Confident AI는 적절한 프로바이더 토크나이저로 스팬의 입력·출력 텍스트를 토큰화해 추론하려 할 거예요. 아래 표는 각 지원 프로바이더와 그 토큰화 방법을 요약해요.
| Provider | Tokenizer | Example Models | Token Counting Method |
|---|---|---|---|
| OpenAI | tiktoken | gpt-4o, gpt-4.1, o1, o3 |
Client-side tokenization using model-specific encodings |
| Anthropic | @anthropic-ai/tokenizer | claude-3.5-sonnet, claude-3.7-sonnet, claude-4 |
Claude-specific tokenization algorithm |
| Gemini API | gemini-2.0-flash, gemini-2.5-pro |
Server-side token counting via API call |
최신 가격은 OpenAI 문서, Anthropic 문서, 또는 Google 문서를 참고하세요.
입력과 출력은 별도로 계산된다는 점을 명심하세요 — 둘 중 하나의 비용을 설정하기 위해 둘 다 제공할 필요는 없어요.
토큰 사용량 비용 추적 (Track Token Usage Cost)
토큰 개수를 사용할 수 있게 되면(수동 설정, 통합 캡처, 또는 자동 추론), Confident AI는 다음 우선순위로 토큰당 비용을 결정해요:
- 코드에서 설정한 토큰당 비용 —
span(...)또는update_span()/updateSpan()으로 입력/출력 토큰당 비용을 직접 제공하면 항상 우선해요. - 커스텀 설정된 모델 비용 — 코드에 토큰당 비용이 없다면, Confident AI는 Model Costs 설정에서 구성한 가격을 사용해요.
- 자동 가격 조회 — 프로젝트 레벨 비용이 없으면 Confident AI는
model에 기반해 내부적으로 토큰당 가격을 조회해요. 이것은 OpenAI, Anthropic, Gemini 모델에서만 사용 가능해요.
위 중 어느 것도 토큰당 비용을 결정하지 못하면, 그쪽(입력 또는 출력)의 비용은 기록되지 않아요.
명시적 비용 설정 (Explicit Cost Setting)
토큰 개수와 함께 스팬에 토큰당 비용을 명시적으로 설정해요. 이것은 자동 가격 조회가 지원하지 않는 프로바이더 모델 — 자체 호스팅 모델, 커스텀 게이트웨이, 협상된 엔터프라이즈 가격 — 을 위해 유용해요.
명시적 비용 설정은 비용에 대한 프로그램적 제어를 원하는 팀에 가장 좋아요. 플랫폼에서 직접 모델 비용을 설정하고 싶은 팀은 custom price lookup을 참고하세요.
Python
from confident_trace import span, update_span

@span(
    type="llm", model="my-model", provider="custom",
    cost_per_input_token=0.000001,
    cost_per_output_token=0.000002,
)
def generate_response(prompt: str) -> str:
    response = call_llm(prompt)
    update_span(
        input_token_count=response.usage.prompt_tokens,
        output_token_count=response.usage.completion_tokens,
    )
    return response.text
TypeScript
import { span, updateSpan } from "confident-trace";

const generateResponse = span(
  {
    name: "generate_response", type: "llm", model: "my-model", provider: "custom",
    costPerInputToken: 0.000001,
    costPerOutputToken: 0.000002,
  },
  async (prompt: string) => {
    const response = await callLlm(prompt);
    updateSpan({
      inputTokenCount: response.usage.promptTokens,
      outputTokenCount: response.usage.completionTokens,
    });
    return response.text;
  },
);
요율은 토큰당 USD이며 백만 토큰당이 아니에요. 백만 입력 토큰당 $1.00인 모델은
cost_per_input_token=0.000001이에요. 요율은 유한하고 음이 아니어야 해요.
비용 필드는 스팬 옵션이나(위처럼) update_span() / updateSpan() 둘 중 편한 쪽으로 전달할 수 있어요. 어느 쪽이든 LLM 스팬에만 적용돼요. 다른 스팬 타입에서는 일반 필드는 여전히 적용되지만 LLM 필드는 일회성 경고와 함께 건너뛰어져요.
커스텀 가격 조회 (Custom Price Lookup)
토큰 개수는 제공하지만 코드에 토큰당 비용은 설정하지 않는다면, Confident AI는 프로젝트의 Model Costs 설정에서 구성한 가격을 사용해요. 코드를 바꾸지 않고 가격을 중앙에서 관리하고 싶을 때 유용해요.
모델 비용은 LLM 스팬의 model 이름에 와일드카드 패턴으로 매칭돼요. 예를 들어:
gpt-4o—gpt-4o만 매칭gpt-4*—gpt-4o,gpt-4o-mini,gpt-4-turbo등을 매칭claude-*— 모든 Claude 모델 변형을 매칭
비용 규칙을 특정 프로바이더로 제한할 수도 있고, 백만 토큰당 입력·출력 비용을 독립적으로 설정할 수 있어요. 설정 지침 전체는 Model Costs 설정 페이지를 참고하세요.
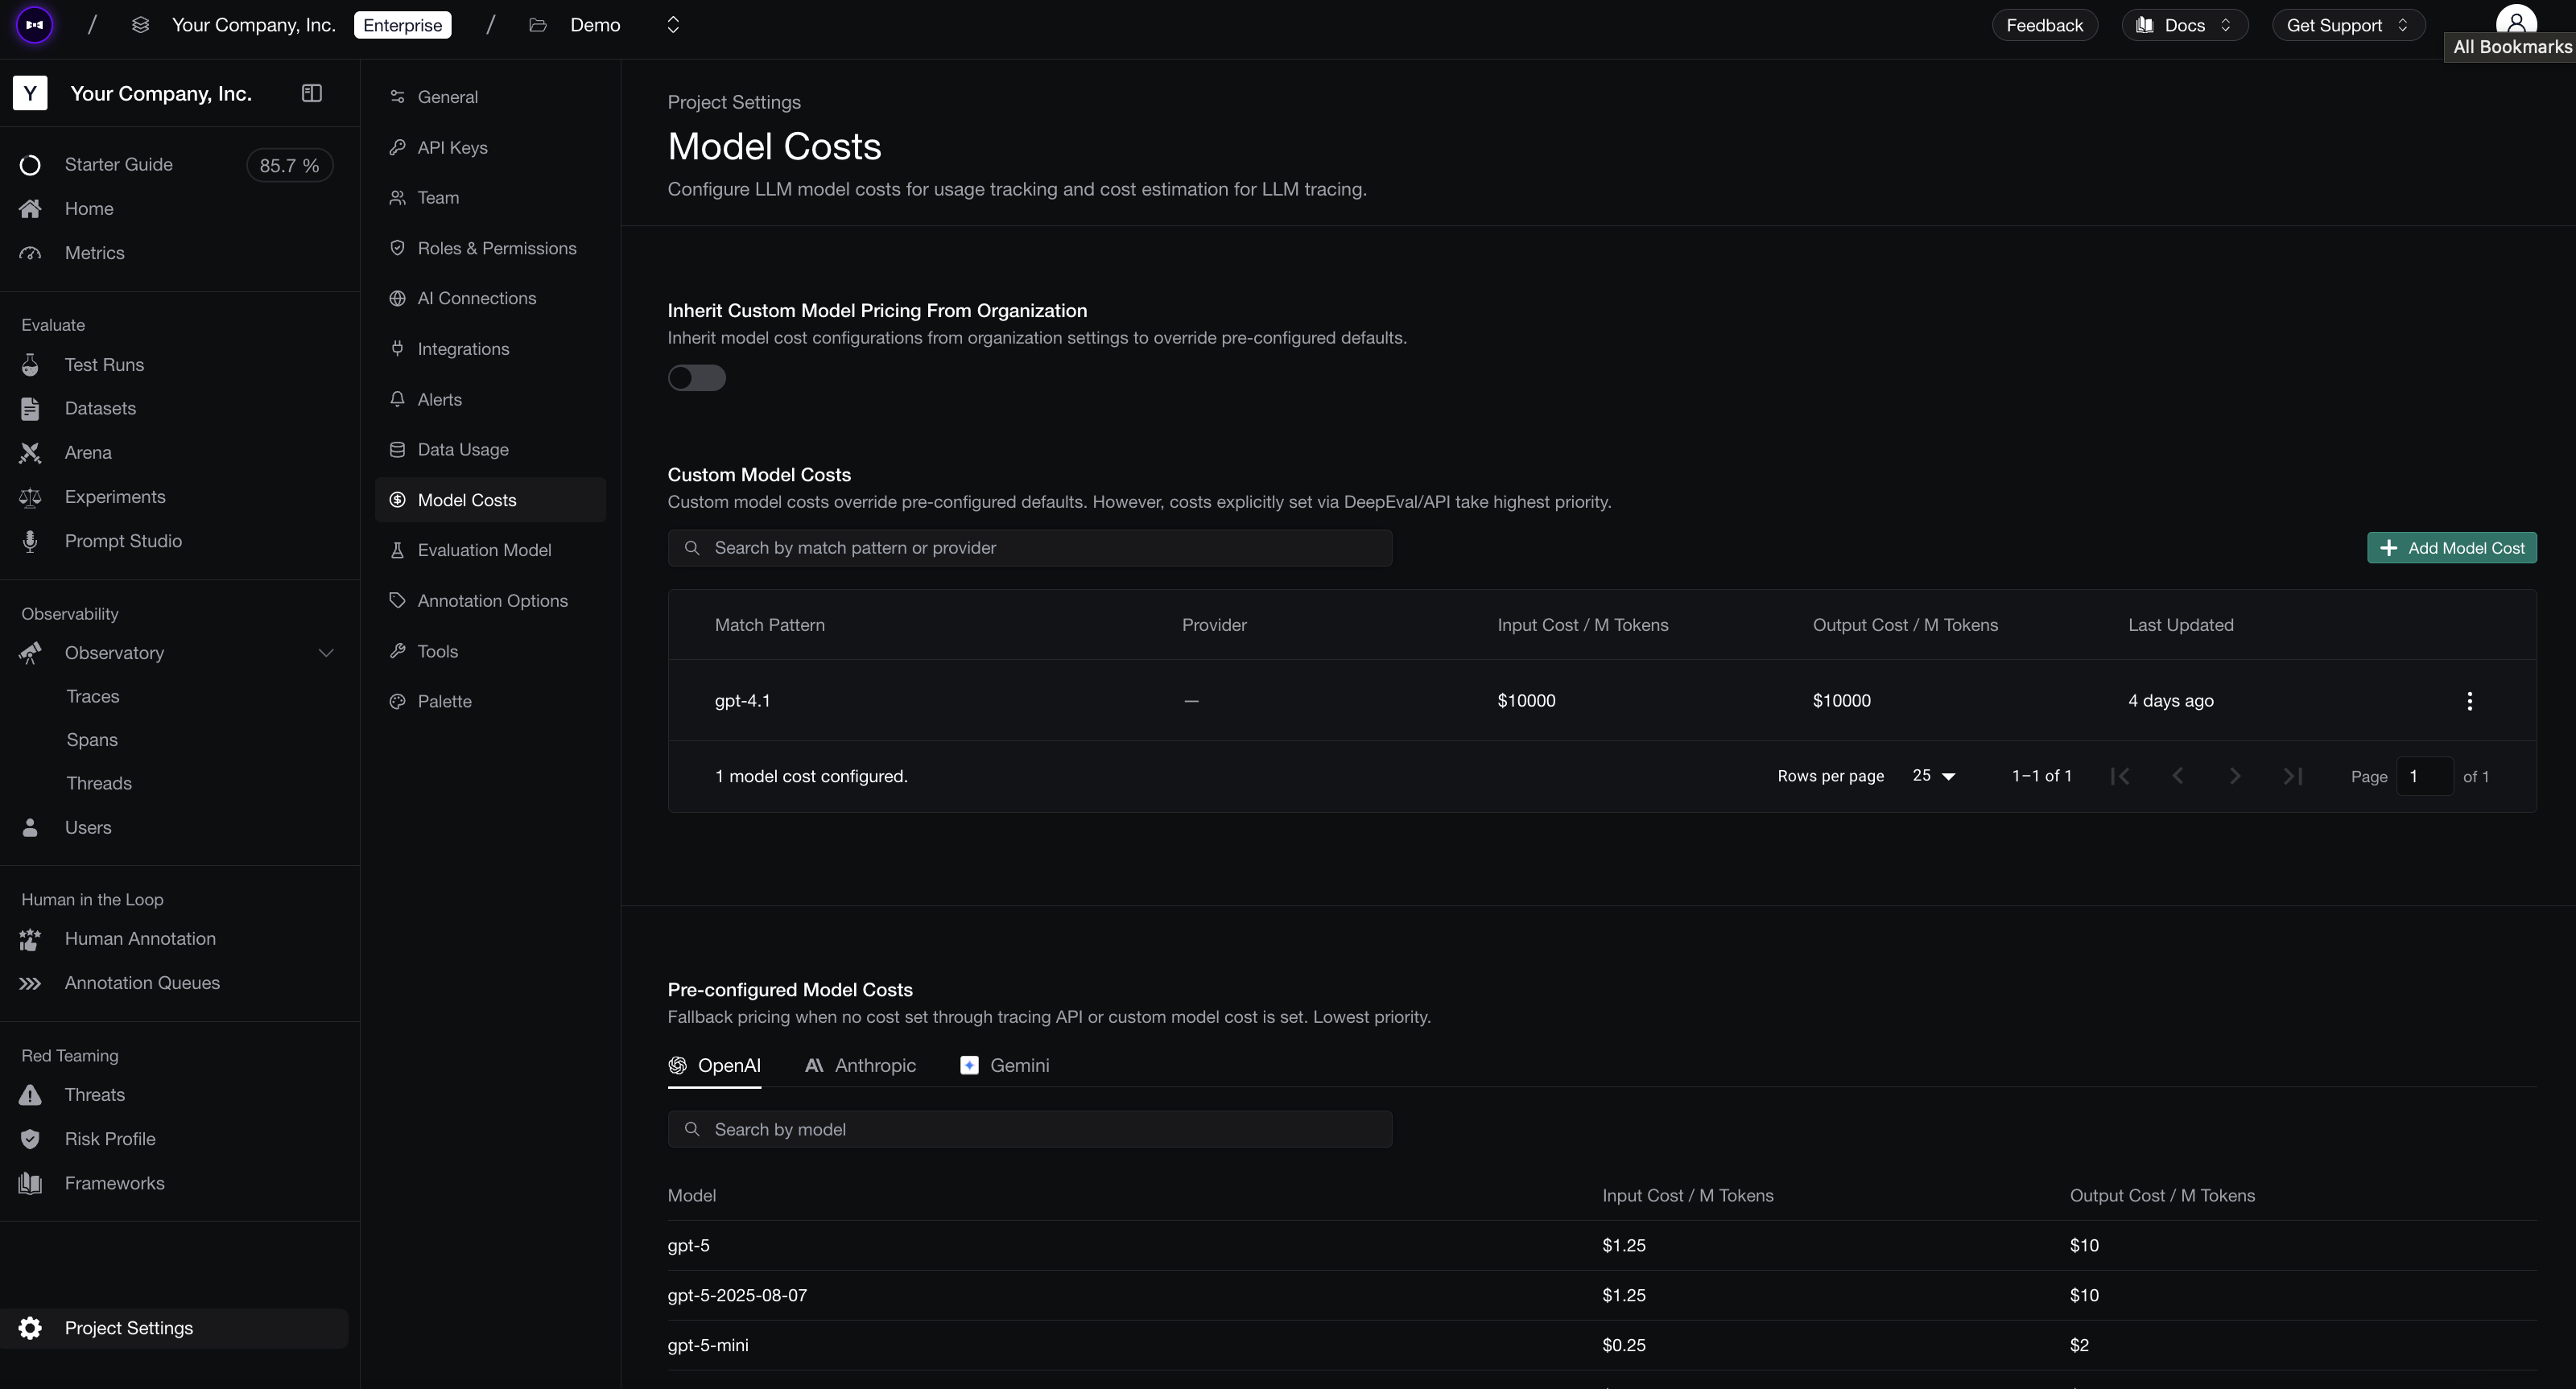
Configure Model Costs
자동 가격 조회 (Automatic Price Lookup)
LLM 스팬에 지원되는 model을 제공하고 SDK 레벨이나 프로젝트 레벨 비용이 모두 구성되지 않았다면, Confident AI는 자동으로 토큰당 가격을 조회하고 비용을 계산해요 — 추가 코드가 필요 없어요.
Python
from confident_trace import span, update_span

@span(type="llm", model="gpt-4o", provider="openai")
def generate_response(prompt: str) -> str:
    output = call_llm(prompt)
    update_span(input=prompt, output=output)
    return output
TypeScript
import { span, updateSpan } from "confident-trace";

const generateResponse = span(
  { name: "generate_response", type: "llm", model: "gpt-4o", provider: "openai" },
  async (prompt: string) => {
    const output = await callLlm(prompt);
    updateSpan({ input: prompt, output });
    return output;
  },
);
자동 가격 조회는 OpenAI, Anthropic, Gemini 모델에서만 사용 가능해요. 다른 프로바이더는 토큰당 비용을 수동으로 설정하거나 프로젝트 설정에서 Model Costs를 구성하세요.
트레이스의 비용 (Cost on Traces)
트레이스의 비용은 그 트레이스에 있는 모든 LLM 스팬의 비용을 합산해서 자동으로 설정돼요. LLM 스팬과 비슷하게, LLM 스팬에 null이 아닌 값이 없으면 트레이스 비용은 null 값으로 기본 설정돼요.
다음 단계 (Next Steps)
비용 추적을 구성했다면 나머지 계측 설정을 계속해요.
Set Input/Output
더 나은 시각화와 평가를 위해 트레이스와 스팬의 기본 입력·출력을 재정의해요.
Thread Traces
트레이스를 스레드로 묶어 멀티턴 대화를 추적하고 전체 워크플로를 평가해요.
더 알아보기
- Configure Span Types — 스팬을 LLM·리트리버·툴·에이전트로 분류해요.
- Log Prompts — LLM 스팬에 버전화된 프롬프트를 기록해요.