
LLM-as-a-Judge 메트릭
LLM-as-a-Judge 메트릭 (LLM-as-a-Judge Metrics)
LLM-as-a-Judge란 다른 LLM 시스템의 아웃풋을 평가하는 데 대형 언어 모델(LLM)을 사용하는 기법이에요. 확장 가능하고 비용 효율적이며 인간에 가까운 평가를 가능하게 해줘요. deepeval의 거의 모든 메트릭이 LLM-as-a-Judge 기반이고, 실제로 Confident AI에서 만드는 모든 커스텀 메트릭도 여기에 해당해요.
출처: 문서
본문
개요
LLM-as-a-Judge는 다른 LLM 시스템의 아웃풋을 평가하는 데 대형 언어 모델(LLM)을 사용하는 것을 말해요. 이 접근 방식은 확장 가능하고 비용 효율적이며 인간에 가까운 평가를 가능하게 해요. 특징은:
- 전통적인 메트릭인 BLEU나 ROUGE보다 더 효과적
- 수동 인간 평가보다 더 빠름
- 인간 어노테이터보다 더 신뢰할 수 있고 일관적
이 기법은 루브릭(rubric) 또는 평가 프롬프트를 만들어 인풋과 아웃풋과 함께 보조 LLM("judge")에 넘기고, 품질 점수나 판정을 반환하게 하는 방식으로 동작해요.
deepeval의 거의 모든 메트릭은 LLM-as-a-Judge예요. 즉 Confident AI에서 사용하는 모든 메트릭도 LLM-as-a-Judge라는 뜻이죠.실제로 Confident AI에서 만드는 모든 커스텀 메트릭은
deepeval의 G-Eval 메트릭을 기반으로 해요. 이에 대해서는 나중에 더 배우게 될 거예요.
LLM-as-a-Judge란 무엇인가요?
LLM-as-a-Judge는 전용 LLM을 사용해 생성된 LLM 아웃풋을 등급화하거나 평가해요. 평가 프롬프트를 통해 스코어링 기준을 정의하면, judge가 인풋과 아웃풋을 살펴보고 그 루브릭에 따라 점수나 라벨을 할당해요.
평가 프롬프트 (Evaluation Prompt):
You are an expert judge. Your task is to rate how relevant the following response is based on the provided input. Rate on a scale from 1 to 5, where:

1 = Completely irrelevant
2 = Mostly irrelevant
3 = Somewhat relevant but with noticeable issues
4 = Mostly relevant with minor issues
5 = Fully correct and accurate

Input:
{input}

LLM Response:
{output}

Please return only the numeric score (1 to 5) and no explanation.

Score:
{input}과{output}이라는 파라미터가 이전 섹션에서 본 테스트 케이스의 파라미터와 우연히 닮아 보이는 점을 눈여겨보세요.
이 기법은 제대로 수행되면 인간보다 높은 정렬률(81%)을 보이는 것으로 나타났어요. 이는 "Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena" 논문에서 다뤘으며, LLM-as-a-Judge를 처음 소개한 논문이기도 해요.
두 가지 유형의 Judge
위 섹션에서는 실제로 싱글턴 LLM 상호작용을 평가하는 시스템 프롬프트를 봤어요. 하지만 LLM-as-a-judge에는 두 가지 주요 유형이 있어요:
싱글 아웃풋 (Single-Output)
- 단일 상호작용을 기반으로 LLM 아웃풋 평가
- 정량 분석을 위해 수치 점수(예: 1-5 척도) 출력
- 참조 없음(referenceless, 예상 아웃풋 없음) 또는 참조 기반(reference-based) 가능
- 회귀 테스트와 프로덕션 온라인 평가에 완벽
적합한 대상: 대부분의 평가 시나리오, 특히 정량적 점수가 필요할 때
쌍 비교 (Pairwise Comparison)
- 두 응답을 비교해 어떤 것이 더 나은지 판정
- 점수 대신 정성적 판정(A, B, 또는 Tie) 출력
- 여러 LLM 버전이 동시에 실행되어야 함
- 복잡성과 정량적 아웃풋 부족 때문에 덜 흔함
적합한 대상: 직접 비교가 필요한 A/B 테스트 시나리오
앞서 본 예시 평가 프롬프트는 싱글 아웃풋, 참조 없음, 싱글턴 LLM-as-a-judge예요.
싱글 아웃풋 (Single-output)
싱글 아웃풋 LLM-as-a-judge는 평가 프롬프트 템플릿에 표현된 단일 상호작용에만 기반해 LLM 아웃풋을 평가하는 것을 말해요. 참조 없음 또는 참조 기반이 될 수 있어요.
LLM 앱에 회귀 테스트를 실행할 때는 종종 싱글 아웃풋 LLM-as-a-judge로 평가를 두 번 실행한 뒤, 두 점수를 비교해 회귀가 있는지 확인해요.
참조 없음 (Referenceless)
참조 없는 싱글 아웃풋 judge는 LLM judge가 이상적인 아웃풋으로 고정할 라벨링된 예상 아웃풋/결과가 없다는 뜻이에요. 다음 팀에 완벽해요:
- 온라인 평가를 실행하고 싶은 프로덕션 환경처럼 예상 아웃풋/결과에 접근할 수 없는 경우
- 예상 아웃풋/결과를 정제하기 어려운 경우
참조 기반 (Reference-based)
참조 기반 싱글 아웃풋 평가는 더 나은 신뢰성을 주고, 팀이 이상적인 아웃풋/결과가 무엇인지에 고정되도록 도와줘요. 종종 평가 프롬프트에 예상 아웃풋 변수 하나만 추가하면 돼요:
You are an expert judge. Your task is to rate how relevant the following response is based on the provided input. Rate on a scale from 1 to 5, where:

1 = Completely irrelevant
2 = Mostly irrelevant
3 = Somewhat relevant but with noticeable issues
4 = Mostly relevant with minor issues
5 = Fully correct and accurate

Input:
{input}

Expected Output:
{expected_output}

LLM Response:
{output}

Please return only the numeric score (1 to 5) and no explanation.

Score:
참조 기반 LLM-as-a-judge의 큰 단점은 프로덕션의 온라인 평가에서 사용하는 것이 불가능하다는 점이에요.
쌍 비교 (Pairwise comparison)
싱글 아웃풋과 달리, 쌍 비교 LLM-as-a-judge는 훨씬 덜 흔해요. 그 이유는:
- 점수를 출력하지 않아 점수 분석에 덜 정량적
- LLM의 여러 버전이 한 번에 실행되어야 해서 까다로울 수 있음
본질적으로 쌍 비교는 점수를 출력하는 대신, 주어진 커스텀 루브릭에 기반해 최고의 아웃풋/결과를 고르는 것을 목표로 해요. 프롬프트 템플릿은 대략 이렇게 생겼어요:
You are an expert judge. Your task is to compare two responses to the same input and decide which one is better based on relevance and accuracy.

Guidelines:

Choose Response A if it is clearly better.

Choose Response B if it is clearly better.

If both are equally good (or equally poor), choose Tie.

Input:
{input}

Expected Output (reference, if helpful):
{expected_output}

Response A:
{output_a}

Response B:
{output_b}

Please return only one of the following:

- A
- B
- Tie

Decision:
Confident AI에서 50개 이상의 LLM 평가 메트릭 중 쌍 비교를 사용하는 것은 Arena G-Eval 메트릭뿐이에요. 하지만 deepeval의 Arena G-Eval 메트릭에 대한 내부 벤치마킹은 참조 없는 싱글 아웃풋 LLM-as-a-judge와 거의 동일한 성능을 보여줘요:
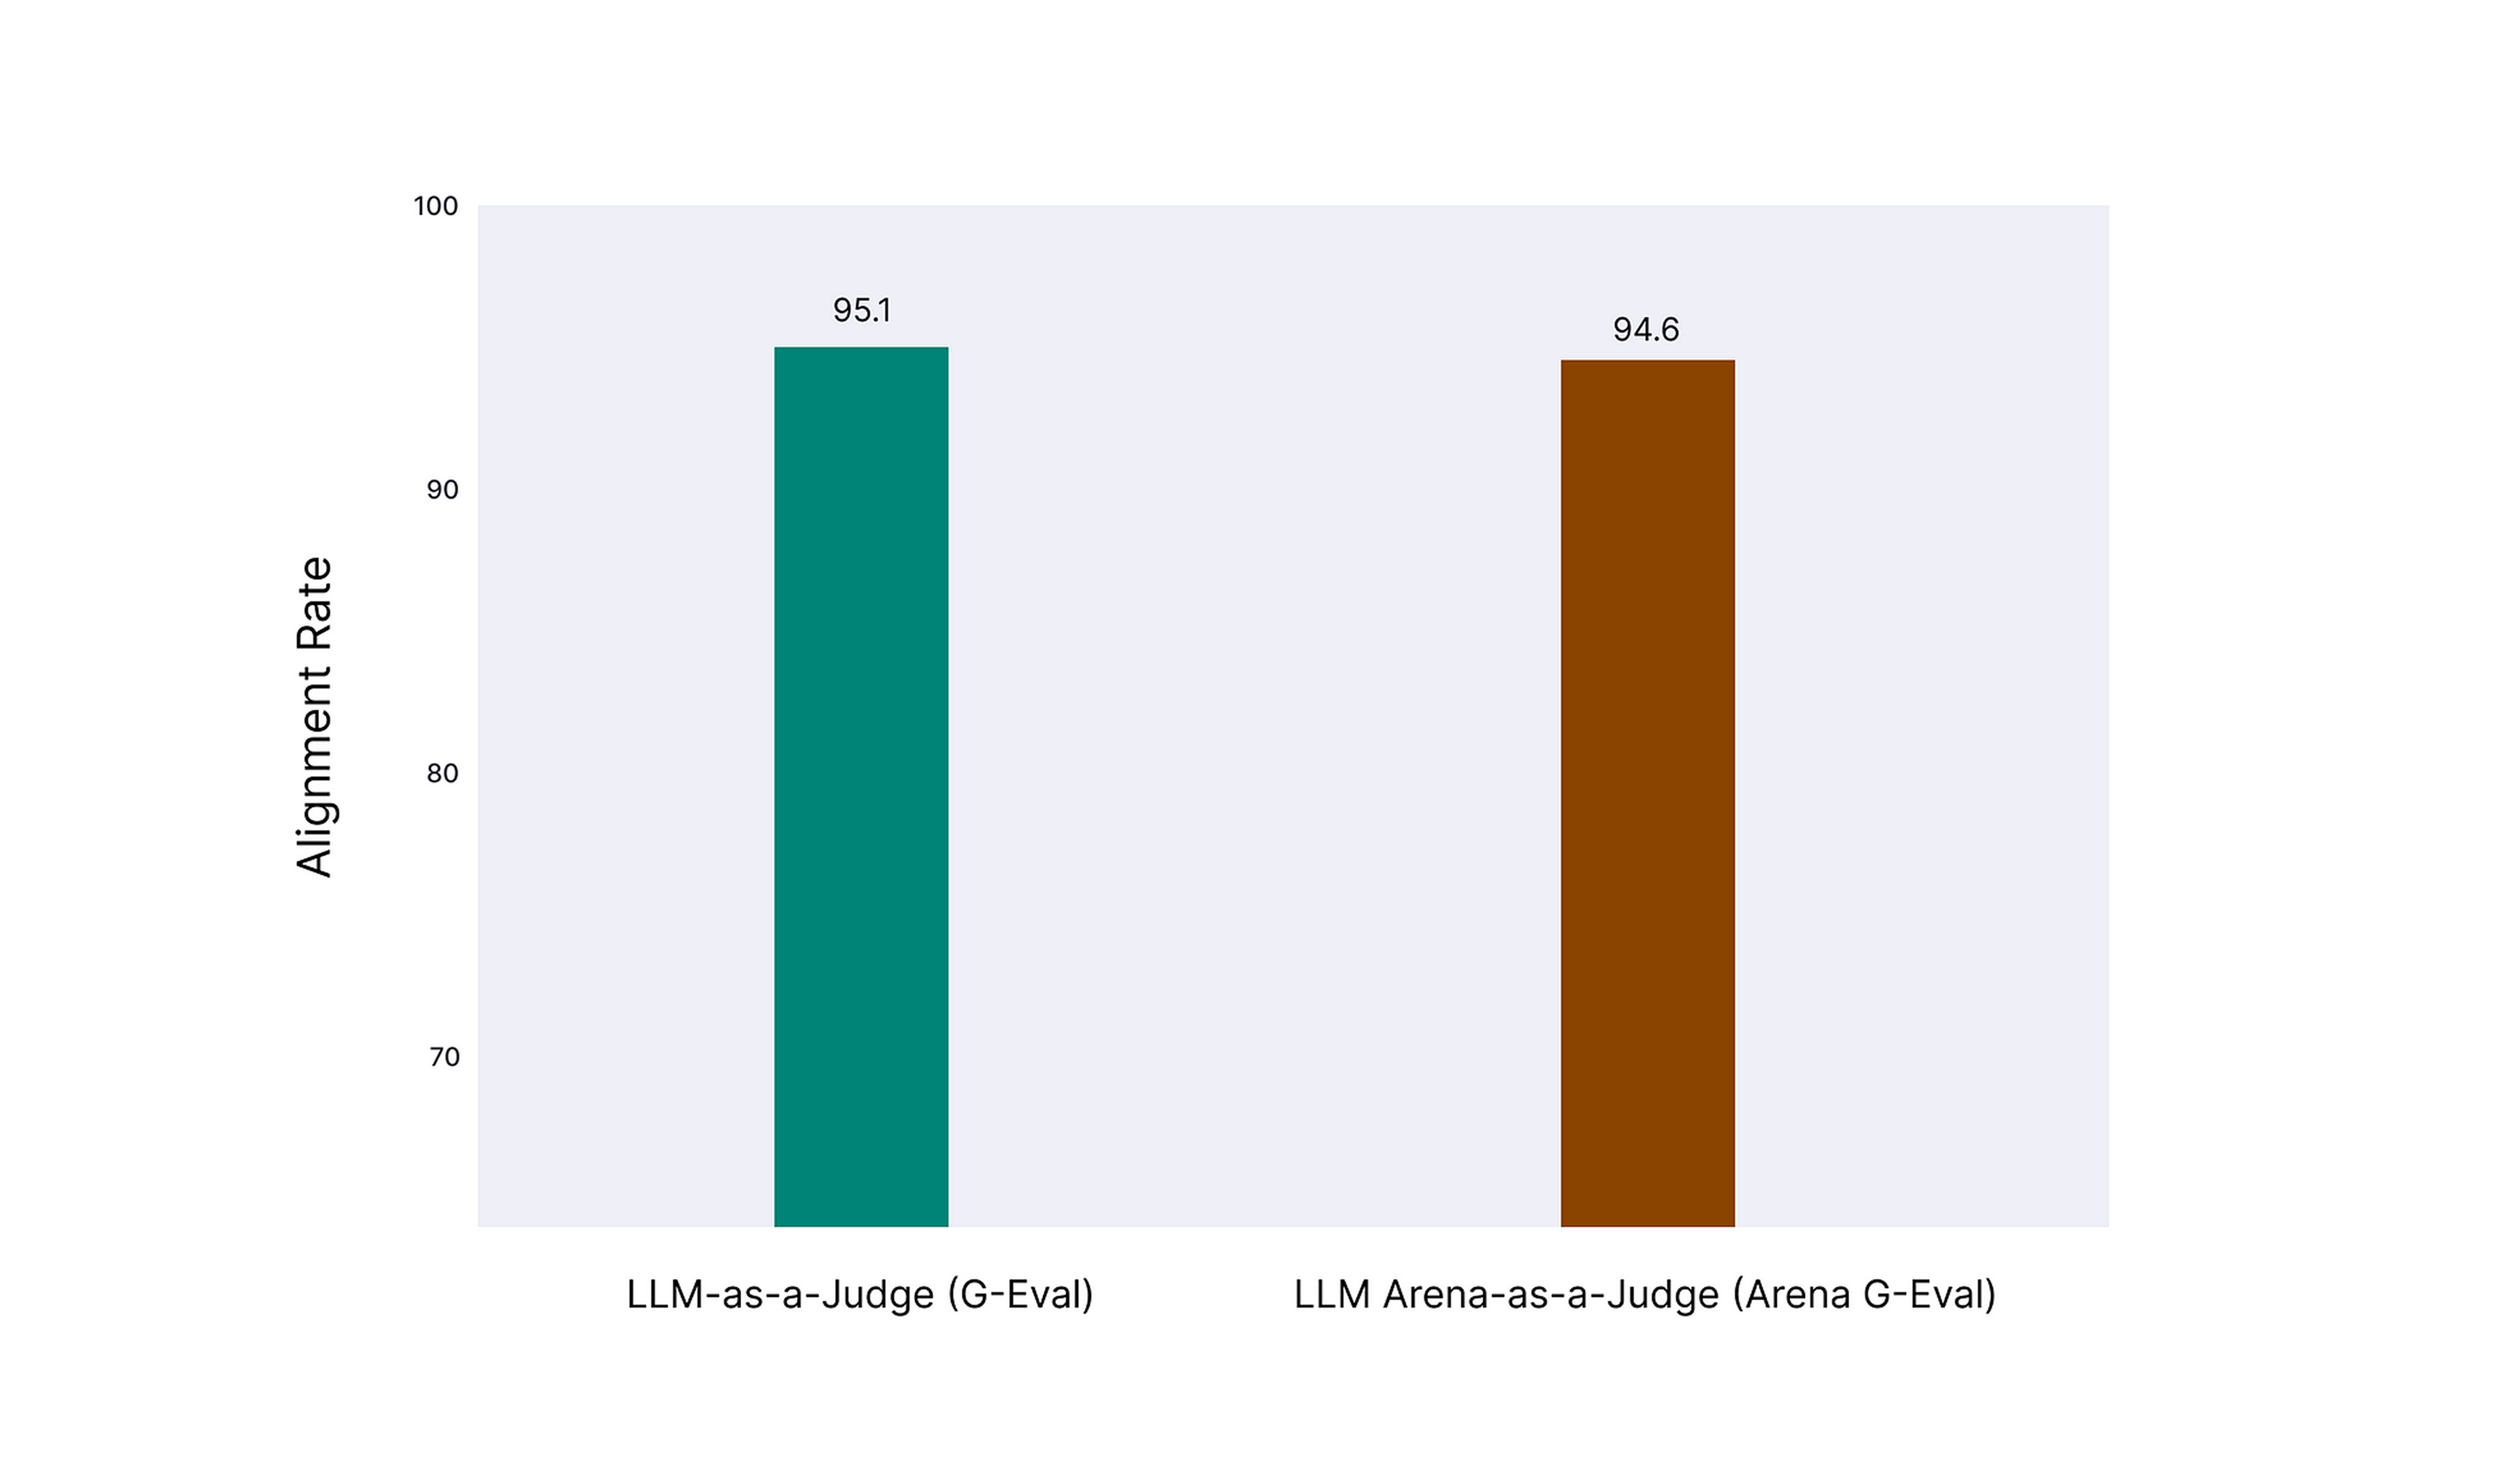
Arena G-Eval vs Single-Output
싱글턴 vs 멀티턴
이전 섹션에서 봤듯이 싱글턴 LLM 앱을 스코어링하는 것은 간단해요. 싱글턴 평가의 경우 평가 프롬프트의 동적 변수로 테스트 케이스 파라미터를 제공하기만 하면 점수를 얻을 수 있어요.

싱글턴 LLM-as-a-Judge
하지만 멀티턴 평가에서는 다음을 하는 프롬프트가 필요해요:
- 전체 대화를 고려
- 대화의 일부를 기반으로 점수 계산
- 턴 내 툴 콜링과 리트리벌 컨텍스트 고려
실제로 대화가 길어질 수 있는데, 평가하는 최선의 방법은 대화를 여러 턴 목록으로 나누는 경우가 많아요:
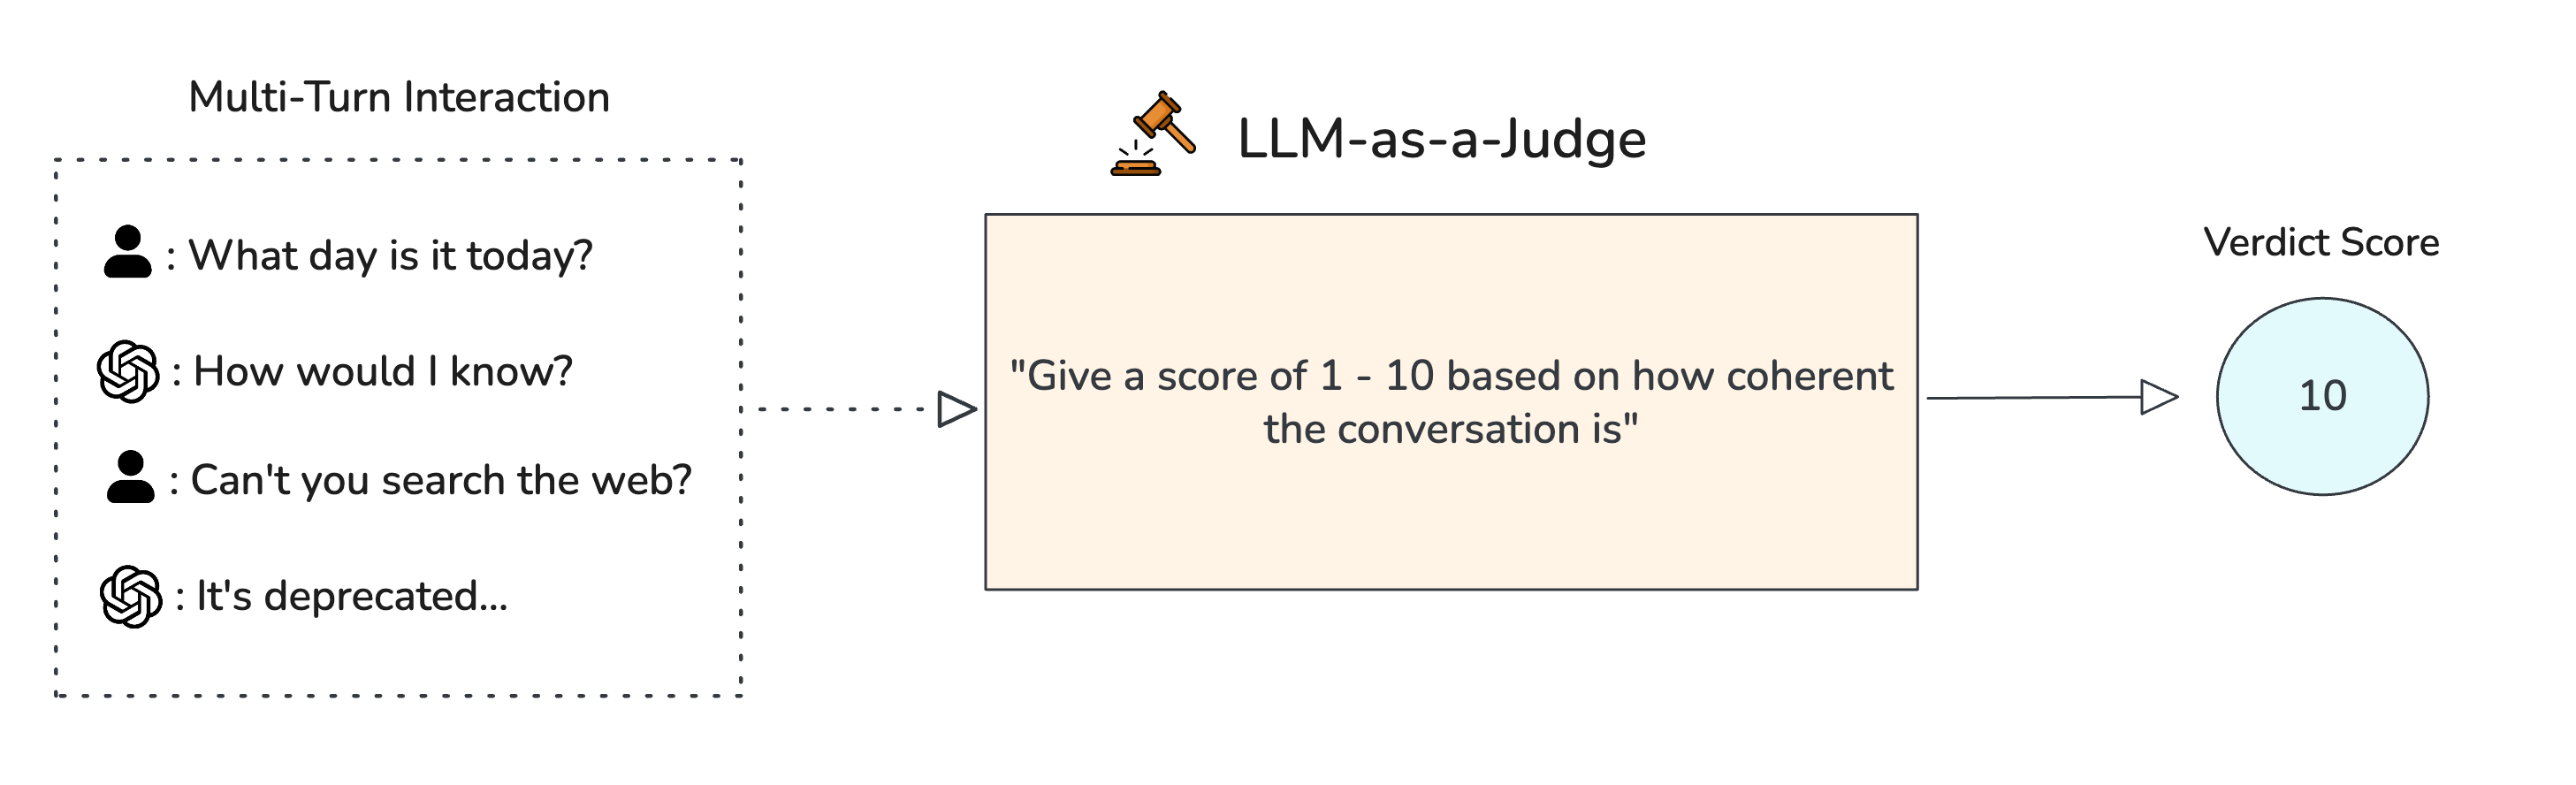
멀티턴 LLM-as-a-Judge
싱글턴과 멀티턴 LLM-as-a-judge가 아무리 다르게 보여도, 둘 다 실제로는 싱글 아웃풋 LLM-as-a-judge 범주에 속해요. 쌍 비교는 일반적으로 멀티턴에서 하지 않아요 — LLM judge에게 컨텍스트를 과도하게 주게 되어 싱글턴 쌍 비교만큼 잘 동작하지 않기 때문이에요.
Confident AI가 다 처리해드려요 (Confident AI Has You Covered)
Confident AI는 이미
deepeval을 통해 모든 LLM-as-a-judge 구현을 처리해요. 이 모든 것이 구현하기에 너무 복잡해 보여도 걱정하지 마세요.
LLM Judge 스코어링을 위한 기법과 알고리즘
LLM-as-a-judge는 적어도 위 섹션에서 보여준 구현에서는 여러 문제를 겪을 수 있어요:
- 신뢰성 (Reliability) — 무작위성이나 프롬프트 민감성 때문에 실행마다 점수가 달라질 수 있어요.
- 편향 (Bias) — judge가 위치 편향(첫 번째 또는 마지막 응답 선호)을 보이거나, judge 자신과 같은 모델 패밀리가 생성한 아웃풋을 선호할 수 있어요.
- 장황함 선호 (Verbosity preference) — judge가 덜 정확하거나 덜 유용해도 더 길고 상세한 답변에 점수를 주는 경우가 많아요.
- 정확성 (Accuracy) — judge가 루브릭을 오해하거나, 사실적 실수를 놓치거나, 점수에 대한 근거를 지어낼 수 있어요.
이런 한계 때문에 Confident AI에 구현된 것처럼 더 나은 기법과 알고리즘이 필요해요.
G-Eval
G-Eval은 SOTA(최첨단), 연구 기반 프레임워크로, 싱글 아웃풋 LLM-as-a-judge를 사용해 일상 언어로 된 어떤 커스텀 기준이든 LLM 아웃풋을 평가해요. 평가 알고리즘은 다음과 같아요:
- 초기 기준에 기반해 일련의 CoT(사고 사슬, chain of thoughts) 생성
- 이 CoT를 평가 프롬프트의 평가 단계로 사용
- 평가 프롬프트에 테스트 케이스 인자를 동적으로 포함
G-Eval은 "NLG Evaluation using GPT-4 with Better Human Alignment" 논문에서 처음 소개됐어요:
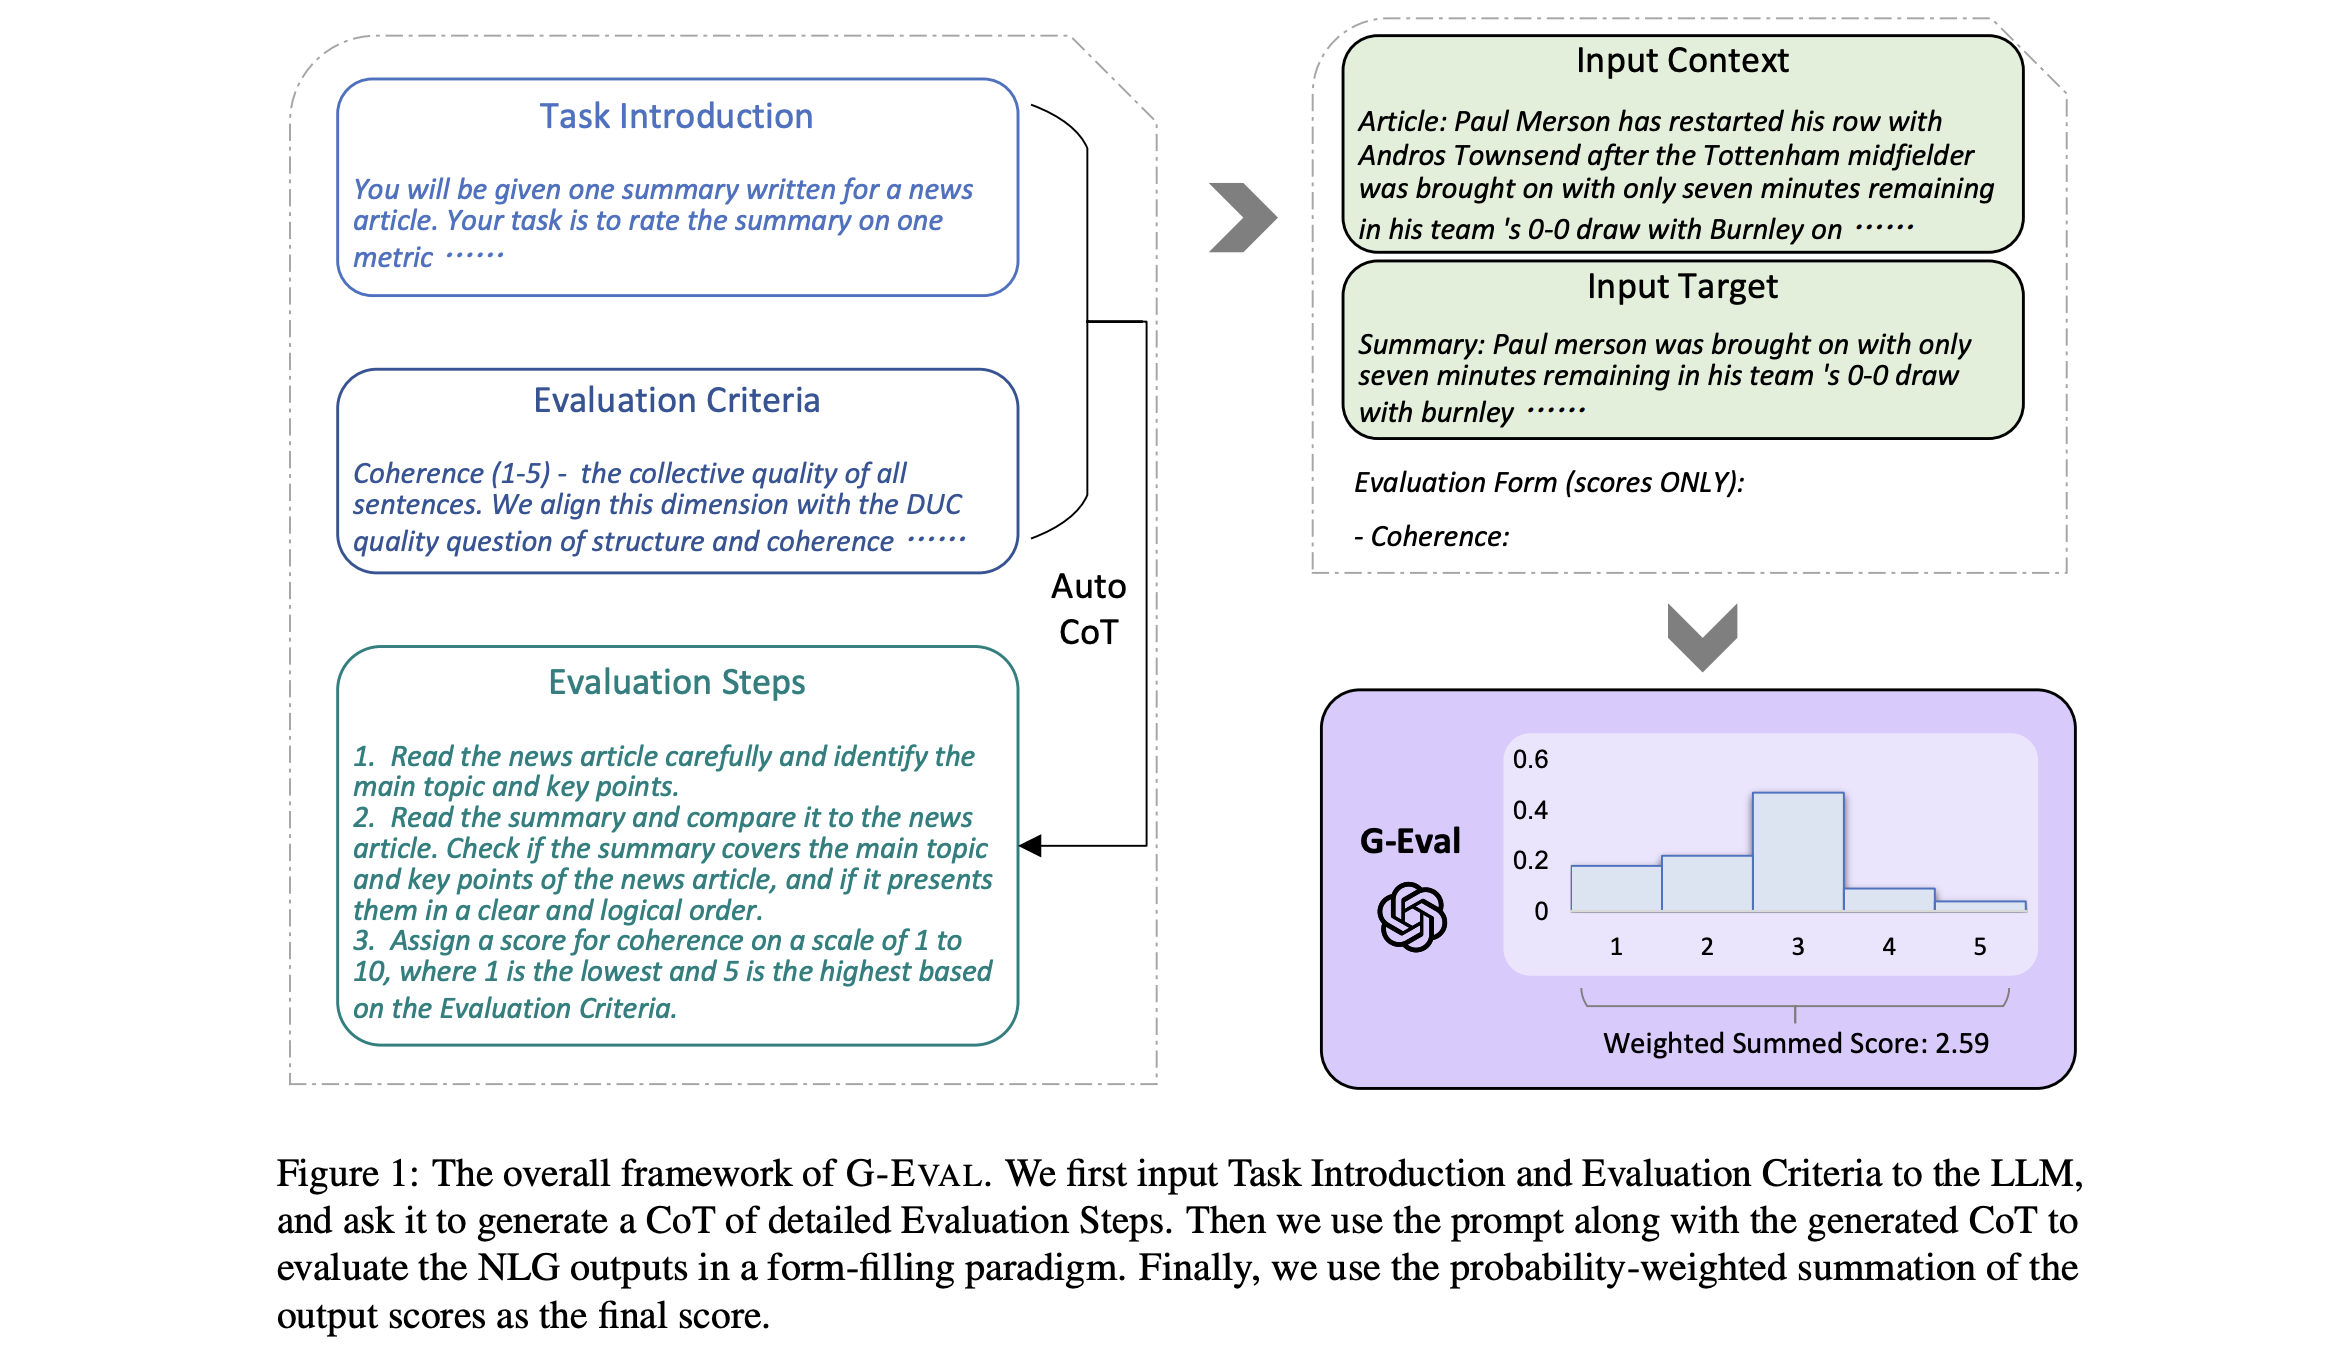
G-Eval 알고리즘
G-Eval은 주관적 기준에 대해 훌륭한 LLM 평가 메트릭이 돼요. 정확하고 쉽게 조정할 수 있으며, 실행 간에 놀랍도록 일관적이기 때문이에요. deepeval에서 로컬 평가에 사용하는 방법은 다음과 같아요:
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCaseParams

correctness_metric = GEval(
    name="Correctness",
    criteria="Determine whether the actual output is factually correct based on the expected output.",
    evaluation_params=[LLMTestCaseParams.ACTUAL_OUTPUT, LLMTestCaseParams.EXPECTED_OUTPUT],
)
실제로 플랫폼에서 만드는 모든 커스텀 메트릭도 G-Eval을 기반으로 해요. Confident AI는 이제 싱글턴과 멀티턴 G-Eval을 모두 지원해요:
from deepeval.test_case import ConversationalTestCase
from deepeval.metrics import ConversationalGEval

metric = ConversationalGEval(
    name="Professionalism",
    criteria="Determine whether the assistant has acted professionally based on the content."
)
G-Eval에 대한 자세한 정보는 여기에서 찾을 수 있어요.
G-Eval은 창의성, 뉘앙스, 의미 이해를 요구하는 주관적이거나 자유 형식의 작업에서 종종 부족한 전통적 참조 기반 메트릭인 BLEU·ROUGE의 더 강력한 대안으로 설계됐어요.
DAG
Deep Acyclic Graph(DAG)는 결정 트리 기반의 결정론적 싱글 아웃풋 LLM-as-a-judge 메트릭이에요. DAG의 각 노드는 판정(verdict)이며, 각 노드는 LLM judge가 거쳐야 할 로직을 담고 있어요. 결국 리프 노드(leaf node)가 점수와 이유를 반환해요.
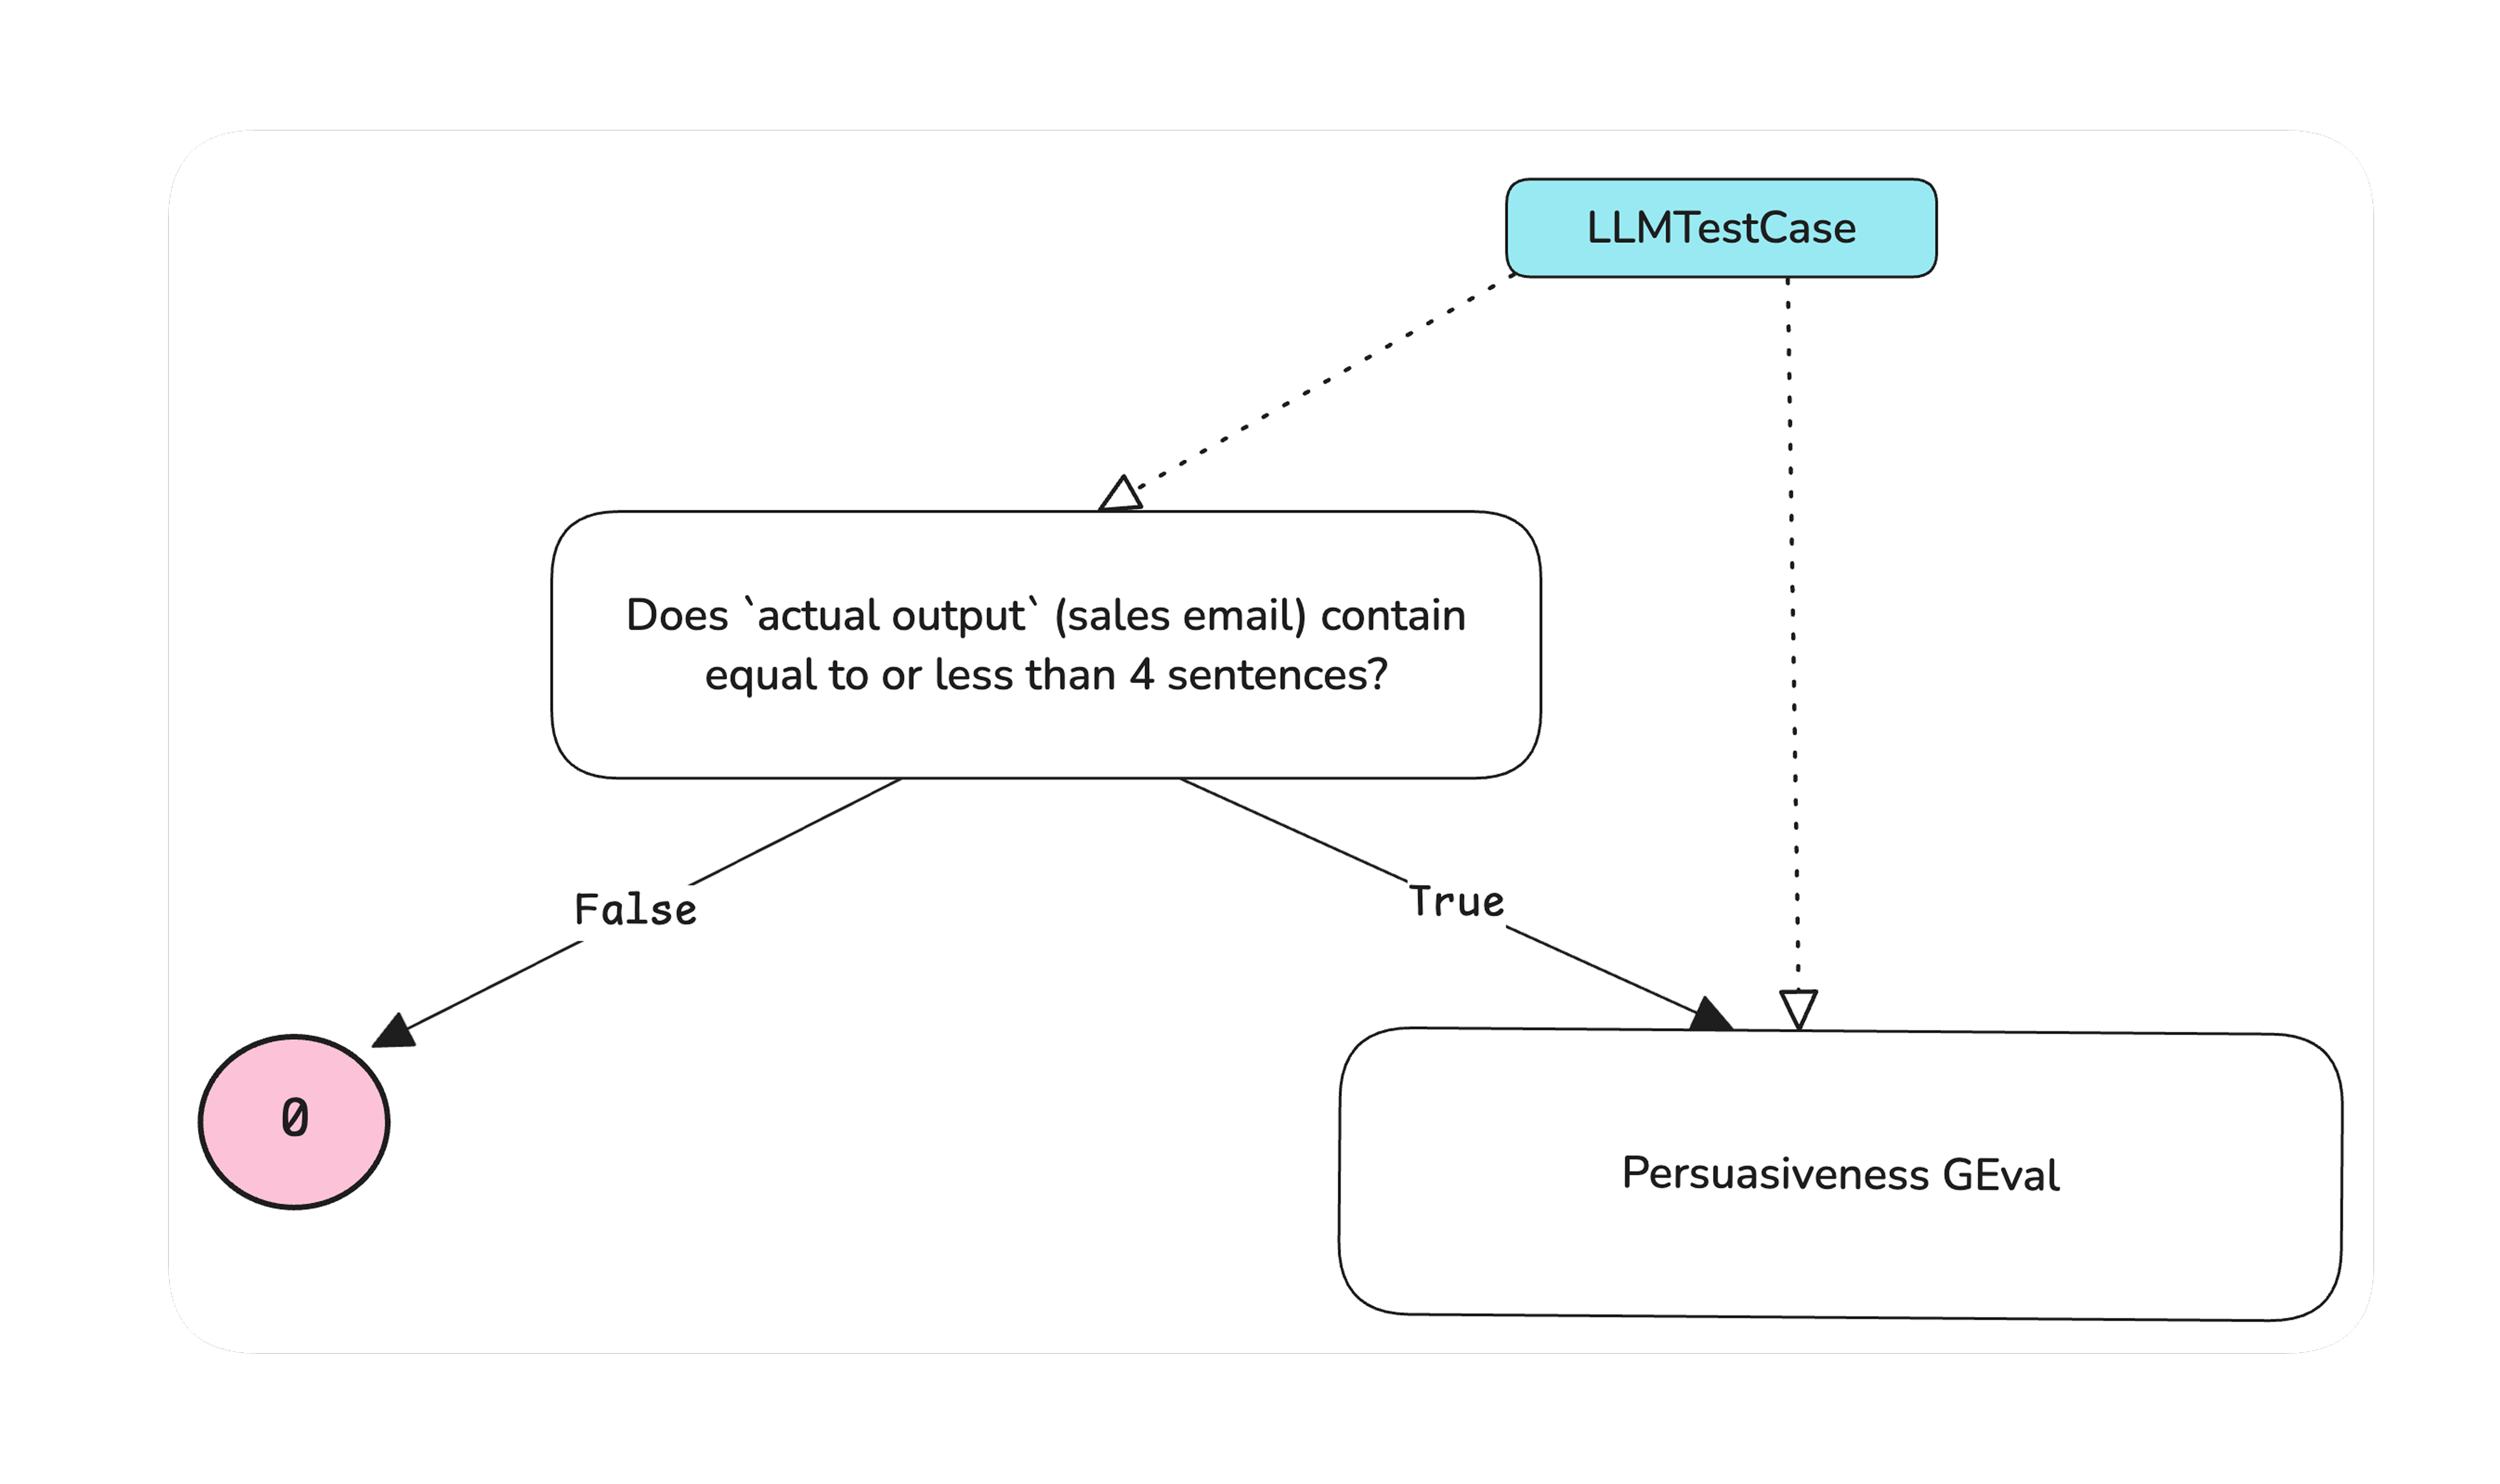
결정 기반 LLM-as-a-Judge
DAG 메트릭은 현재 플랫폼에서 아직 사용할 수 없지만, deepeval을 통해 로컬 평가로 실행할 수 있어요:
from deepeval.test_case import LLMTestCase, LLMTestCaseParams
from deepeval.metrics.dag import (
    DeepAcyclicGraph,
    TaskNode,
    BinaryJudgementNode,
    NonBinaryJudgementNode,
    VerdictNode,
)
from deepeval.metrics import DAGMetric, GEval

geval_metric = GEval(
    name="Persuasiveness",
    criteria="Determine how persuasive the `actual output` is to getting a user booking in a call.",
    evaluation_params=[LLMTestCaseParams.ACTUAL_OUTPUT],
)

conciseness_node = BinaryJudgementNode(
    criteria="Does the actual output contain less than or equal to 4 sentences?",
    children=[
        VerdictNode(verdict=False, score=0),
        VerdictNode(verdict=True, child=geval_metric),
    ],
)

# create the DAG
dag = DeepAcyclicGraph(root_nodes=[conciseness_node])
metric = DAGMetric(dag=dag)
G-Eval을 리프 노드로 포함할 수도 있다는 점을 눈여겨보세요. 이렇게 하면 최종에 주관적 스코어링을 유지하면서, 더 결정 기반의 필터링에 LLM-as-a-judge를 적용할 수 있어요.
DAG 메트릭은 통과해야 할 하드 기준이 있는 G-Eval보다 더 낫습니다.
QAG
질문-답변 생성(QAG, Question-answer-generation)은 어떤 수학적 질문에 따라 LLM 메트릭 점수를 계산하는 싱글 아웃풋 LLM-as-a-judge 기법이에요. G-Eval처럼 어떤 기준에 따라 점수를 만들어 내도록 LLM에게 묻는 대신, QAG는 다음과 같이 동작해요:
- 테스트 케이스 인자를 더 세분화된 "단위(units)"로 분해
- 각 세분화된 "단위"에 LLM-as-a-judge 적용
- 각 LLM judge의 판정을 집계해 점수와 이유 계산
answer relevancy 메트릭을 통한 구체적인 예시를 볼게요:
- actual output을 "문장(statements)"으로 분해 — 여기서 문장은 일관된 텍스트 그룹(문장, 문단 등)으로 정의
- 각 문장에 대해 인풋과 관련 있는지 판정
- 최종 점수는 actual output에서 찾은 관련 문장의 비율
Confident AI에서 이 모든 것은 deepeval이 처리해요:
from deepeval.test_case import LLMTestCase
from deepeval.metrics import AnswerRelevancyMetric

test_case = LLMTestCase(input="...", actual_output="...")
metric = AnswerRelevancyMetric()
metric.measure(test_case)
print(metric.score, metric.reason) # QAG score reason here
QAG라고 불리는 이유는, 이 기법이 폐쇄형 질문(closed-ended questions)을 활용해 LLM 아웃풋을 집계 가능한 것으로 제한하기 때문이에요. 이 예시에서 LLM judge에게 모든 것을 원샷으로 하게 하는 대신, 알고리즘은 LLM judge가 각 문장이 관련 있는지에 대한 판정으로 "yes" 또는 "no"만 출력하게 해요. 이렇게 하면 점수를 수학 공식으로 제한할 수 있어요.
모든 RAG 메트릭은 QAG 기반 메트릭이에요.
LLM 아레나
LLM 아레나는 전통적으로 최고의 LLM을 고르는 elo 투표 시스템이지만, 여기서는 쌍 비교 LLM-as-a-judge를 적용해 투표 과정을 자동화하고 있어요.
Confident AI에서는 ArenaGEval 메트릭으로 처리하며, 싱글 아웃풋만 지원해요:
from deepeval.test_case import ArenaTestCase, LLMTestCase, LLMTestCaseParams
from deepeval.metrics import ArenaGEval

a_test_case = ArenaTestCase(
    contestants={
        "GPT-4": LLMTestCase(
            input="What is the capital of France?",
            actual_output="Paris",
        ),
        "Claude-4": LLMTestCase(
            input="What is the capital of France?",
            actual_output="Paris is the capital of France.",
        ),
    },
)
metric = ArenaGEval(
    name="Friendly",
    criteria="Choose the winner of the more friendly contestant based on the input and actual output",
    evaluation_params=[
        LLMTestCaseParams.INPUT,
        LLMTestCaseParams.ACTUAL_OUTPUT,
    ],
)
ArenaGEval 메트릭은 현재 개발 단계의 로컬 평가에서만 사용할 수 있어요(DAG와 동일).
메트릭에 LLM Judge 사용하기
LLM judge가 핵심 평가 엔진이라면, 메트릭은 그 주변의 비계(scaffolding)예요. 메트릭은 다음을 결정해요:
- 평가 기준/루브릭
- 평가 알고리즘
- 통과 임계값
- 사용할 테스트 케이스 파라미터
모든 메트릭이 통과해야 테스트 케이스가 통과해요.
Confident AI에서는 앞으로 LLM-as-a-judge를 직접 언급하지 않아요. 메트릭이 평가가 어떻게 실행되어야 하는지에 대한 더 많은 정보를 담고 있기 때문이에요.
애플리케이션 기반 메트릭 (Application-Based Metrics)
만드는 각 LLM 유스케이스에는 1-3개의 애플리케이션 기반 메트릭이 있어야 해요. 이 메트릭은 LLM 앱이 구축된 방식에 전적으로 기반하며 유스케이스에 구애받지 않아요.
RAG
RAG 컨텍스트에는 리트리버와 생성기를 별개 컴포넌트로 평가하는 싱글턴 메트릭 5개가 있어요:
- Answer Relevancy: LLM의 응답이 유저의 쿼리에 얼마나 관련 있는지 측정
- Faithfulness: LLM의 응답이 검색된 컨텍스트에 의해 뒷받침되는지 평가
- Contextual Relevancy: 검색된 컨텍스트가 쿼리에 얼마나 관련 있는지 평가
- Contextual Recall: 검색된 컨텍스트의 정밀도(precision) 측정
- Contextual Precision: 검색된 컨텍스트의 재현율(recall) 평가
에이전트 (Agents)
에이전트의 경우 작업 완료와 툴 콜링 중심의 싱글턴 메트릭 3개가 있어요:
- Task Completion: 에이전트가 할당된 작업을 성공적으로 완료했는지 평가
- Tool Correctness: 주어진 작업에 에이전트가 올바른 툴을 사용했는지 측정
- Argument Correctness: 주어진 툴 콜에 에이전트가 올바른 인자를 전달했는지 측정
task completion 메트릭은 테스트 케이스가 아니라 전체 트레이스(trace)를 평가한다는 점에서 매우 독특해요.
챗봇 (Chatbots)
챗봇의 경우 이 메트릭들은 멀티턴이에요:
- Turn Relevancy: 각 응답이 진행 중인 대화에 얼마나 관련 있는지 평가
- Turn Faithfulness: 각 응답이 진행 중인 대화에 얼마나 관련 있는지 평가
- Conversation Completeness: 대화가 유저 요청의 모든 측면을 다루는지 측정
- Role Adherence: LLM이 할당된 역할을 얼마나 잘 지키는지 평가
- Knowledge Retention: LLM이 대화 턴을 넘나들며 정보를 얼마나 잘 유지하는지 측정
Confident AI의 멀티턴 메트릭도 RAG를 고려한다는 점을 눈여겨보세요.
유스케이스 특정 메트릭 (Use Case-Specific Metrics)
이전 섹션과 대조적으로 유스케이스 특정 메트릭은 애플리케이션에 구애받지 않아요. 평가 스위트에는 커스텀 메트릭 1-2개를 두는 것을 권장해요.
유스케이스 특정 메트릭을 위해 커스텀 메트릭을 만들어야 해요:
- G-Eval: LLM 아웃풋을 위한 범용 평가 메트릭
- DAG: 결정 트리 기반의 LLM 평가 메트릭
- Conversational G-Eval: LLM 대화를 위한 멀티턴 범용 평가 메트릭
현재 플랫폼에서는 G-Eval만 지원돼요. 하지만 로컬에서 만들어 개발 중에 DAG를 활용할 수는 있어요.
커스텀 메트릭은 보통 유스케이스에 따라 다르지만, 애플리케이션 특정 메트릭(예: RAG나 에이전트 메트릭)은 비슷한 LLM 애플리케이션에서 일관성을 유지해요. 예를 들어 의료 상담용과 법률 상담용 두 대화형 에이전트는 tool correctness 같은 같은 에이전트 메트릭을 사용하지만, 각 산업 특정 성공 기준에 맞춘 서로 다른
GEval메트릭을 가져요.
커스텀 메트릭 만들기
메트릭은 로컬 또는 플랫폼에서 원격으로 만들 수 있어요.
로컬 평가 (Local Evals)
- 메트릭을 완전히 제어하며
deepeval로 로컬에서 평가 실행 - 커스텀 메트릭, DAG, 고급 평가 알고리즘 지원
적합한 대상: Python 사용자, 개발, 배포 전 워크플로우
원격 평가 (Remote Evals)
- 사전 구축된 메트릭으로 Confident AI 플랫폼에서 평가 실행
- 모니터링, 데이터셋, 팀 협업 기능과 통합
적합한 대상: 비 Python 사용자, 프로덕션 트레이싱을 위한 온라인 + 오프라인 평가
커스텀 메트릭 생성에 대한 모든 것을 여기에서 배울 수 있어요.
다음 단계
이제 평가를 시작하는 데 필요한 모든 것을 알았어요. 자신에게 가장 잘 맞는 것을 골라 시작하세요: