
멀티턴 평가
멀티턴 평가 (Multi-Turn Evals, 노코드)
여러 교환에 걸쳐 컨텍스트가 쌓이는 대화형 AI를 평가해볼게요. 싱글턴과 달리 멀티턴은 메트릭을 적용하기 전에 전체 대화를 먼저 생성해야 한다는 점이 핵심이에요. 다행히 Confident AI가 시뮬레이션까지 처리해주니, 몇 시간씩 AI를 수동으로 프롬프트할 필요가 없어요.
출처: 문서
본문
개요
멀티턴 평가는 여러 교환에 걸쳐 컨텍스트가 축적되는 대화형 상호작용을 테스트해요. AI가 대화 내내 일관성을 유지해야 하는 유스케이스가 대상이에요:
- 챗봇 — 고객 지원, 세일즈 어시스턴트, 또는 범용 채팅
- 대화형 에이전트 — 왕복이 있는 멀티스텝 작업 완료
- 에이전틱 시스템 — 턴을 넘나들며 툴 콜과 추론이 있는 복잡한 워크플로우
싱글턴 평가와 달리 멀티턴 평가는 메트릭을 적용하기 전에 전체 대화를 생성해야 하며, 이는 과정에서 가장 시간이 걸리는 부분이에요.
다행히 Confident AI가 시뮬레이션 측면도 처리해줘서 몇 시간 동안 AI를 수동으로 프롬프트하지 않아도 돼요.
요구 사항
멀티턴 평가를 실행하려면 다음이 필요해요:
- 멀티턴 데이터셋 — 대화 스타터 또는 전체 대화 히스토리를 가진 골든스
- 멀티턴 메트릭 컬렉션 — 대화형 평가를 위해 설계된 메트릭
멀티턴 메트릭은 개별 메시지가 아니라 대화 전체를 평가해요. 예로는 turn faithfulness와 turn contextual relevancy가 있어요.
동작 방식
멀티턴 평가는 5단계 과정을 따라요 — 싱글턴과의 핵심 차이는 시뮬레이션 단계예요:
- 메트릭 정의 — 대화형 메트릭 선택 (예: turn relevancy, conversation completeness)
- 데이터셋 생성 — 대화 스타터로 골든스 구축
- 아웃풋 생성 구성 — AI 연결 또는 프롬프트 설정
- 대화 시뮬레이션 — 유저 턴을 시뮬레이션해 전체 대화 생성
- 평가 — 완성된 대화에 메트릭 실행
데이터 흐름을 시각적으로 보면:
sequenceDiagram
    participant User as You
    participant Platform as Confident AI
    participant AI as Your AI App
    participant Sim as User Simulator
    participant Metrics as Metric Collection

    User->>Platform: Start Evaluation

    loop For each golden in dataset
        loop Simulate conversation
            Platform->>AI: Send user message
            AI-->>Platform: AI response
            Platform->>Sim: Generate next user turn
            Sim-->>Platform: Simulated user message
        end
        Platform->>Metrics: Run metrics on conversation
        Metrics-->>Platform: Metric scores
    end

    Platform-->>User: Test Run Produced
    Note over User,Platform: View results on Dashboard
평가 전에 대화를 완전히 시뮬레이션해야 하므로 멀티턴 평가는 싱글턴보다 약간 오래 걸릴 수 있어요. 큰 데이터셋은 이에 맞춰 계획하세요.
시뮬레이션 제어하기
데이터셋 내 시뮬레이션을 제어하려면 goldens의 scenario, expected outcome, user description 필드를 편집해야 해요. 각 필드는 시뮬레이션을 서로 다른 방식으로 제어해요:
- Scenario — 대화의 컨텍스트와 주제를 설정하며, 시뮬레이션된 유저가 무엇을 논의하고 어떤 상황에 있는지 안내해요 (예: "유저가 다음 주말 파리행 항공편을 예약하려고 함")
- Expected outcome — 시뮬레이션이 성공적으로 끝나기 위해 달성해야 할 목표를 정의해요 (예: "유저가 항공편 예약에 성공함" 또는 "유저가 환불 확인을 받음")
- User description — 대화 내내 시뮬레이션된 유저의 페르소나, 톤, 행동을 형성해요 (예: "참을성이 없고 짧고 직접적인 질문을 하는 불만 고객")
중요한 점은, 시뮬레이션된 최대 유저 턴 수 이후에도 expected outcome을 달성하지 못하면 시뮬레이션이 자동으로 끝난다는 거예요. 이는 멀티턴 데이터셋의 드롭다운 설정에서 구성할 수 있어요.
평가 실행하기
데이터셋 페이지 오른쪽 위의 Evaluate 버튼을 클릭해 데이터셋을 평가할 수 있어요.
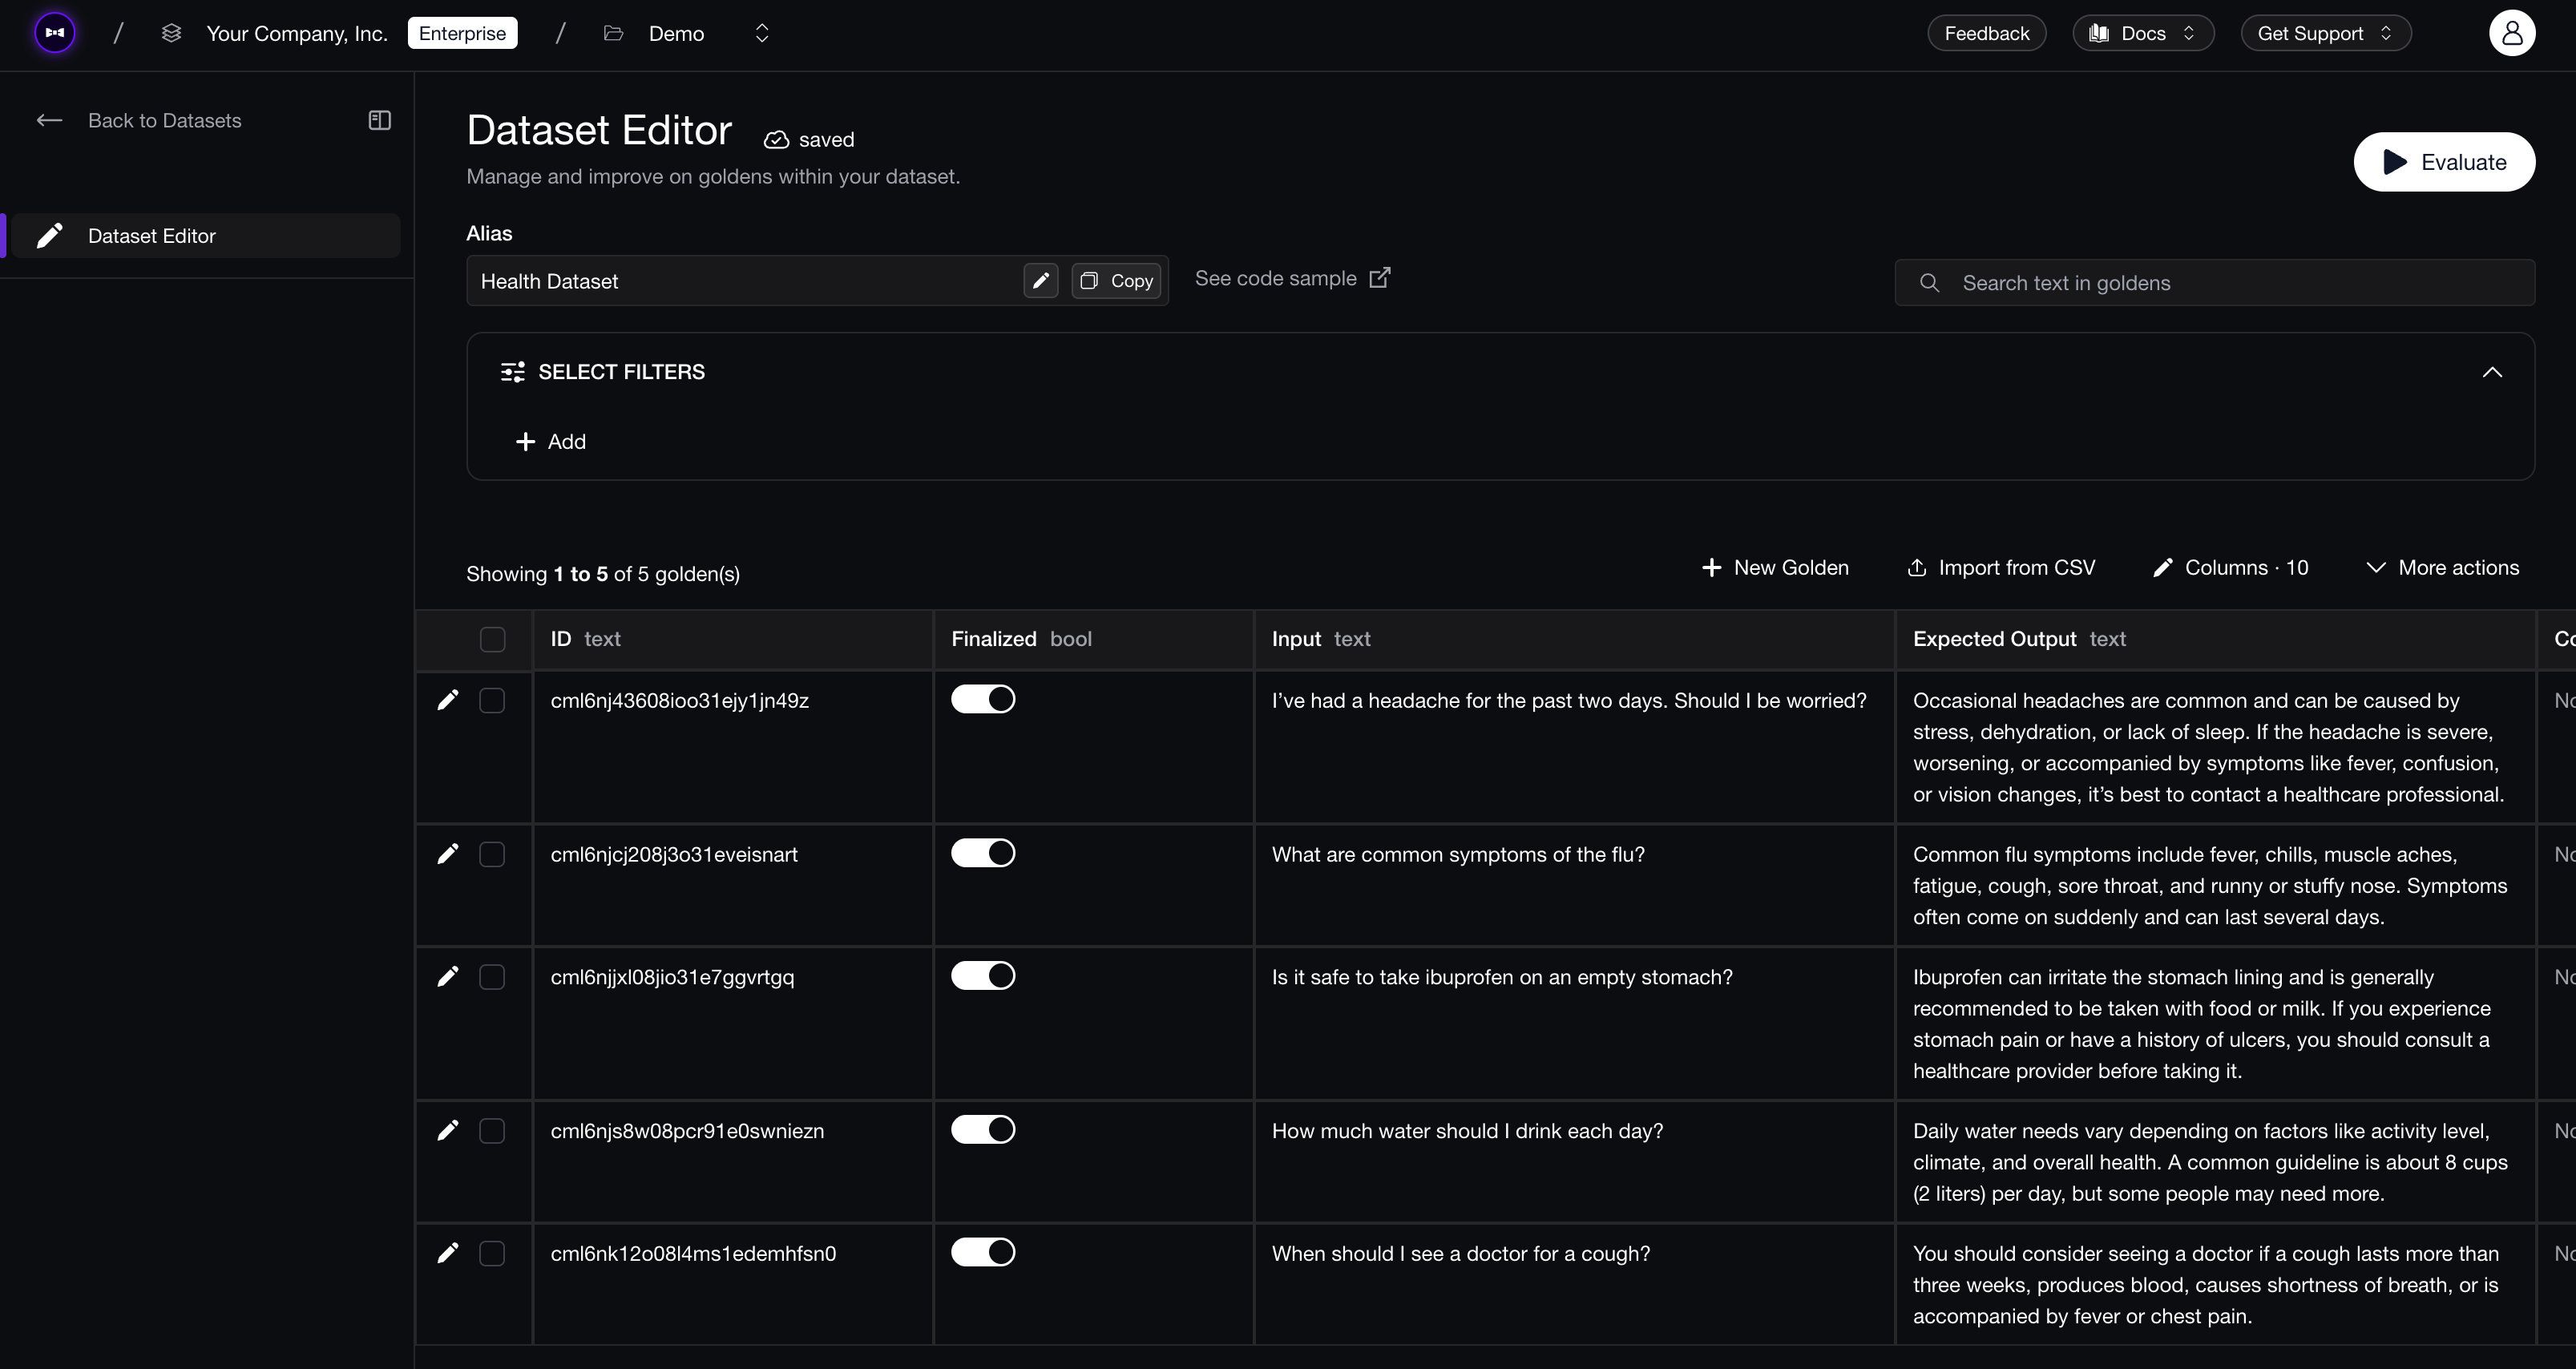
멀티턴 데이터셋의 Evaluate 버튼
데이터셋과 메트릭 선택
- Project > Datasets로 이동해 평가할 멀티턴 데이터셋 선택
- Evaluate 클릭
- 멀티턴 메트릭 컬렉션 선택
시뮬레이션 켜기
평가 시점에 AI 앱을 호출하려면 이 옵션을 활성화해야 해요
잘 짜여진 시뮬레이션 지침이 현실적인 대화의 핵심이에요. 골든스의 scenario, expected outcome, user description 필드를 통해 유저의 목표, 톤, 지식 수준을 구체적으로 정하세요.
아웃풋 생성 구성
시뮬레이션이 켜져 있다면, AI 앱이 각 턴에 어떻게 응답할지 선택해요:
프롬프트 (Prompt)
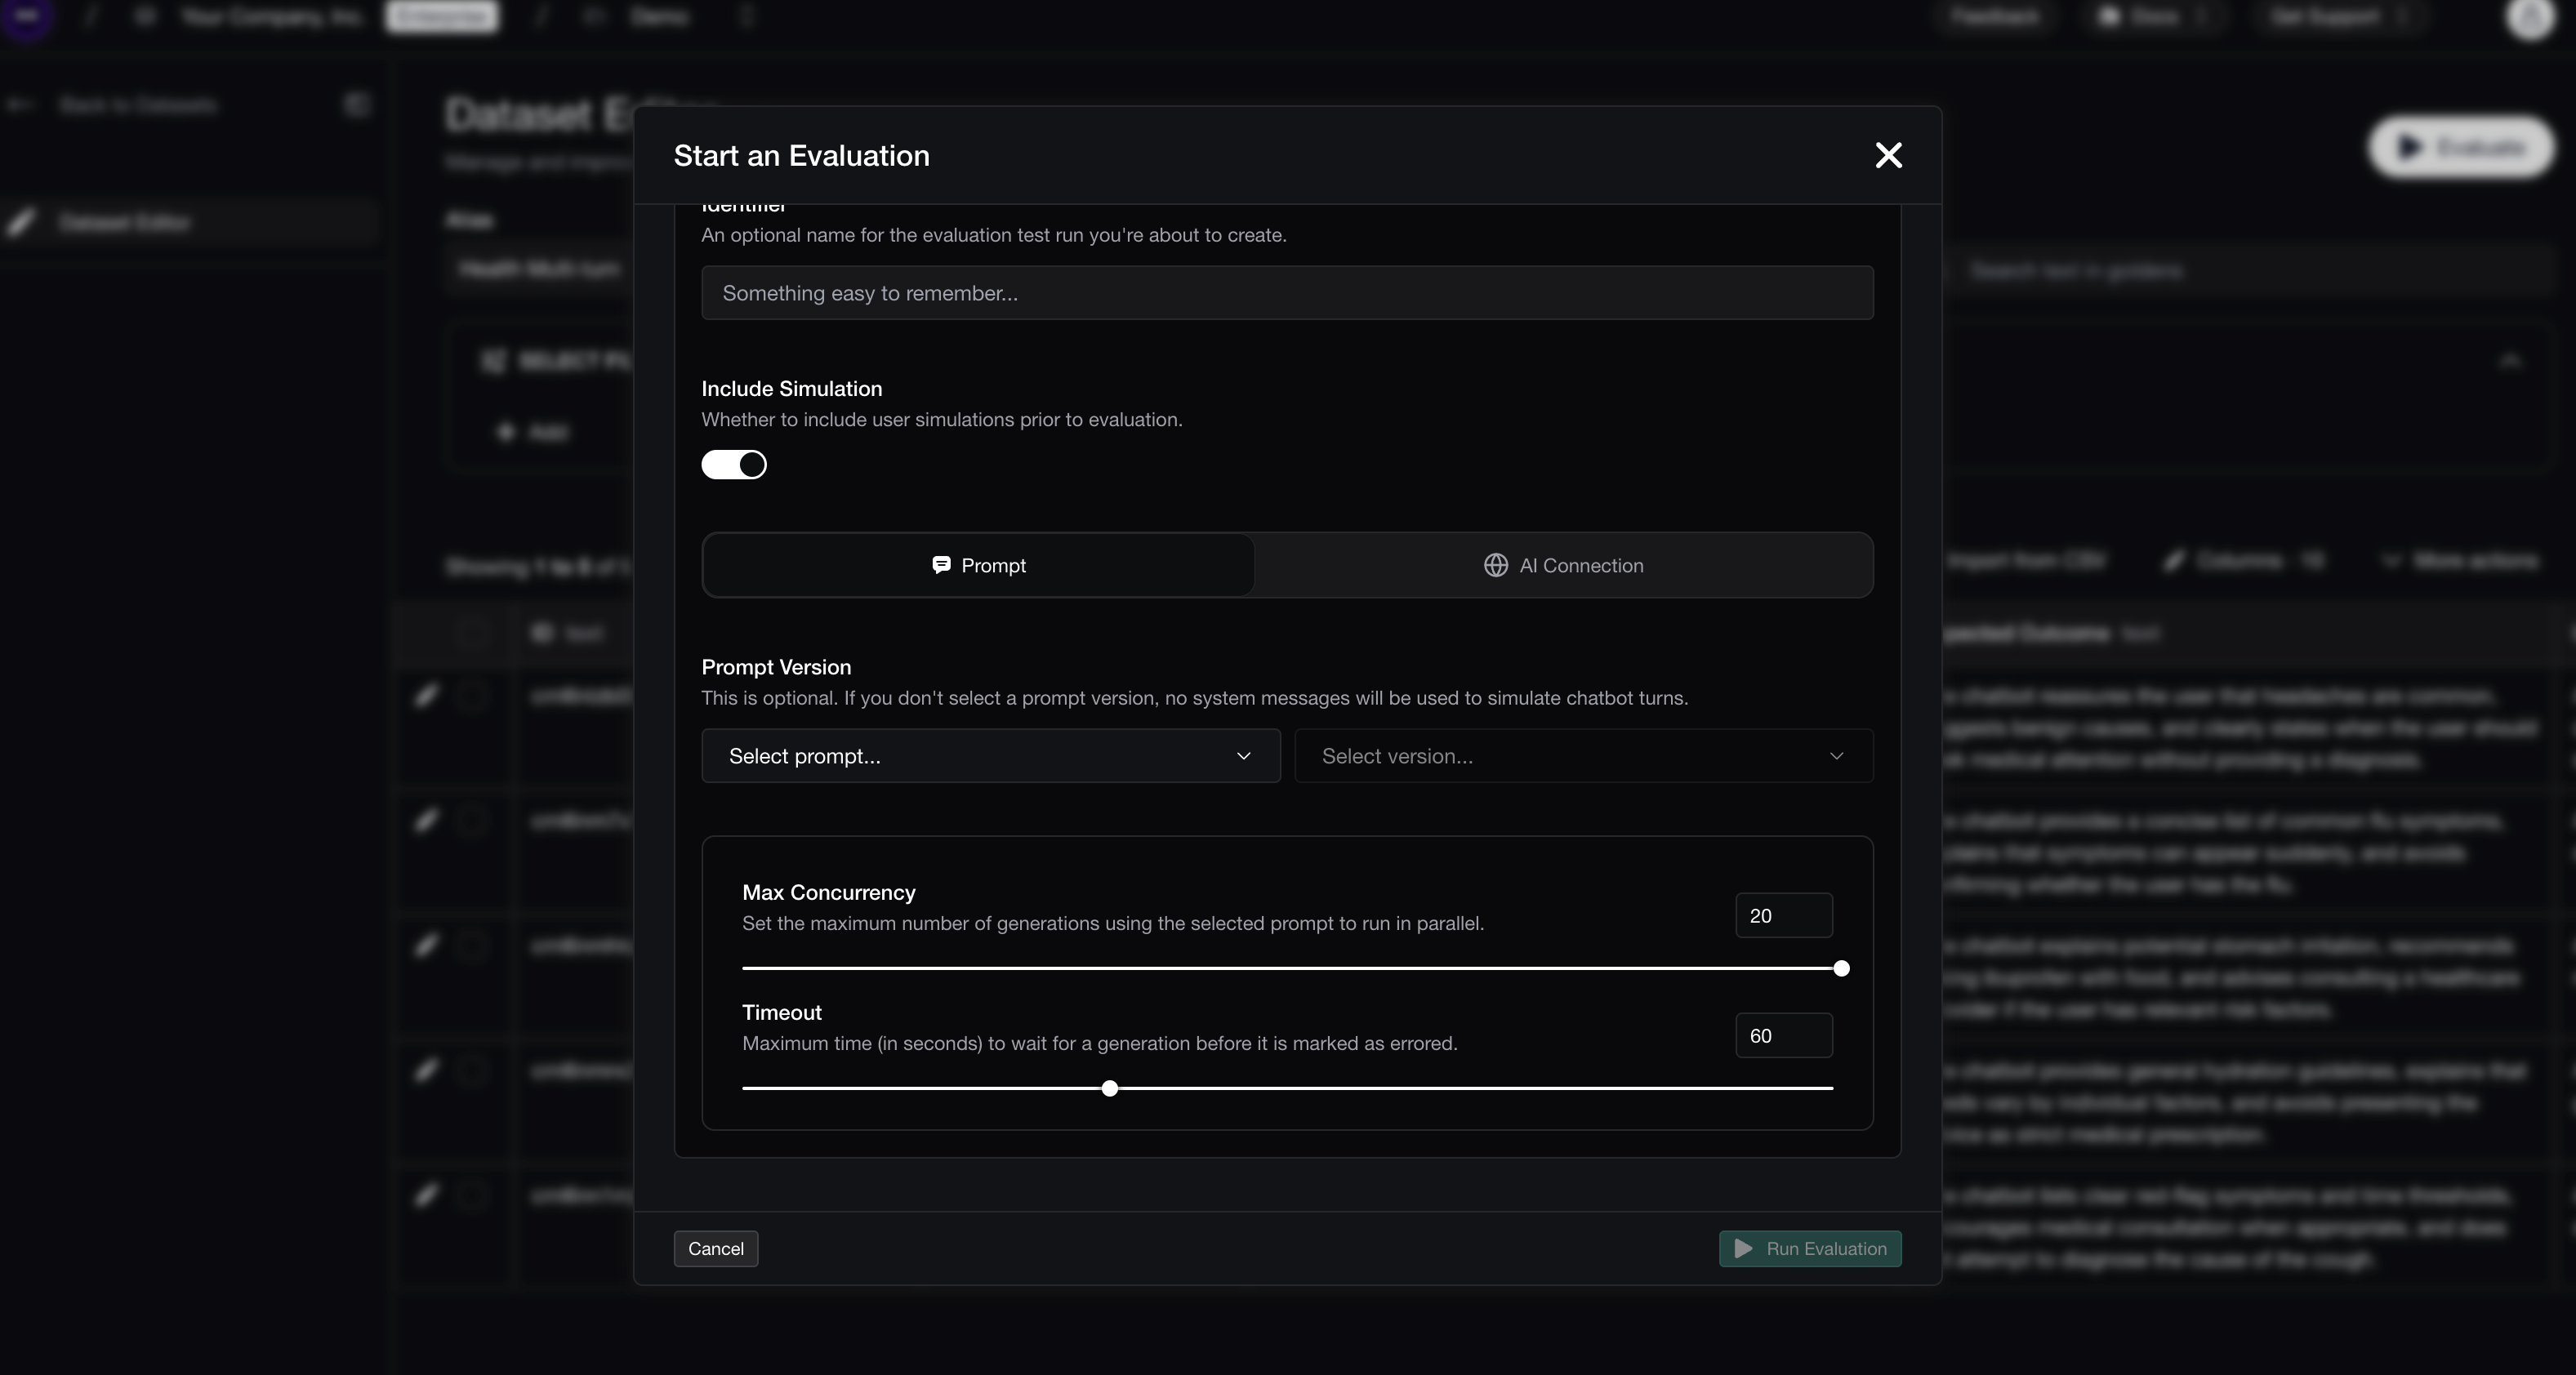
멀티턴 평가를 위한 프롬프트 구성
프롬프트 기반 챗봇의 경우 대화 기록을 포함하는 프롬프트 템플릿을 선택해요.
- 평가 설정에서 이 프롬프트를 아웃풋 생성 방식으로 선택
- Confident AI가 각 턴마다 LLM을 호출하며 대화 기록을 전달
이 기능이 동작하려면 기존 프롬프트가 필요해요. 아직 없다면 Prompt Studio에서 프롬프트를 만들 수 있어요.
AI 연결 (AI Connection)
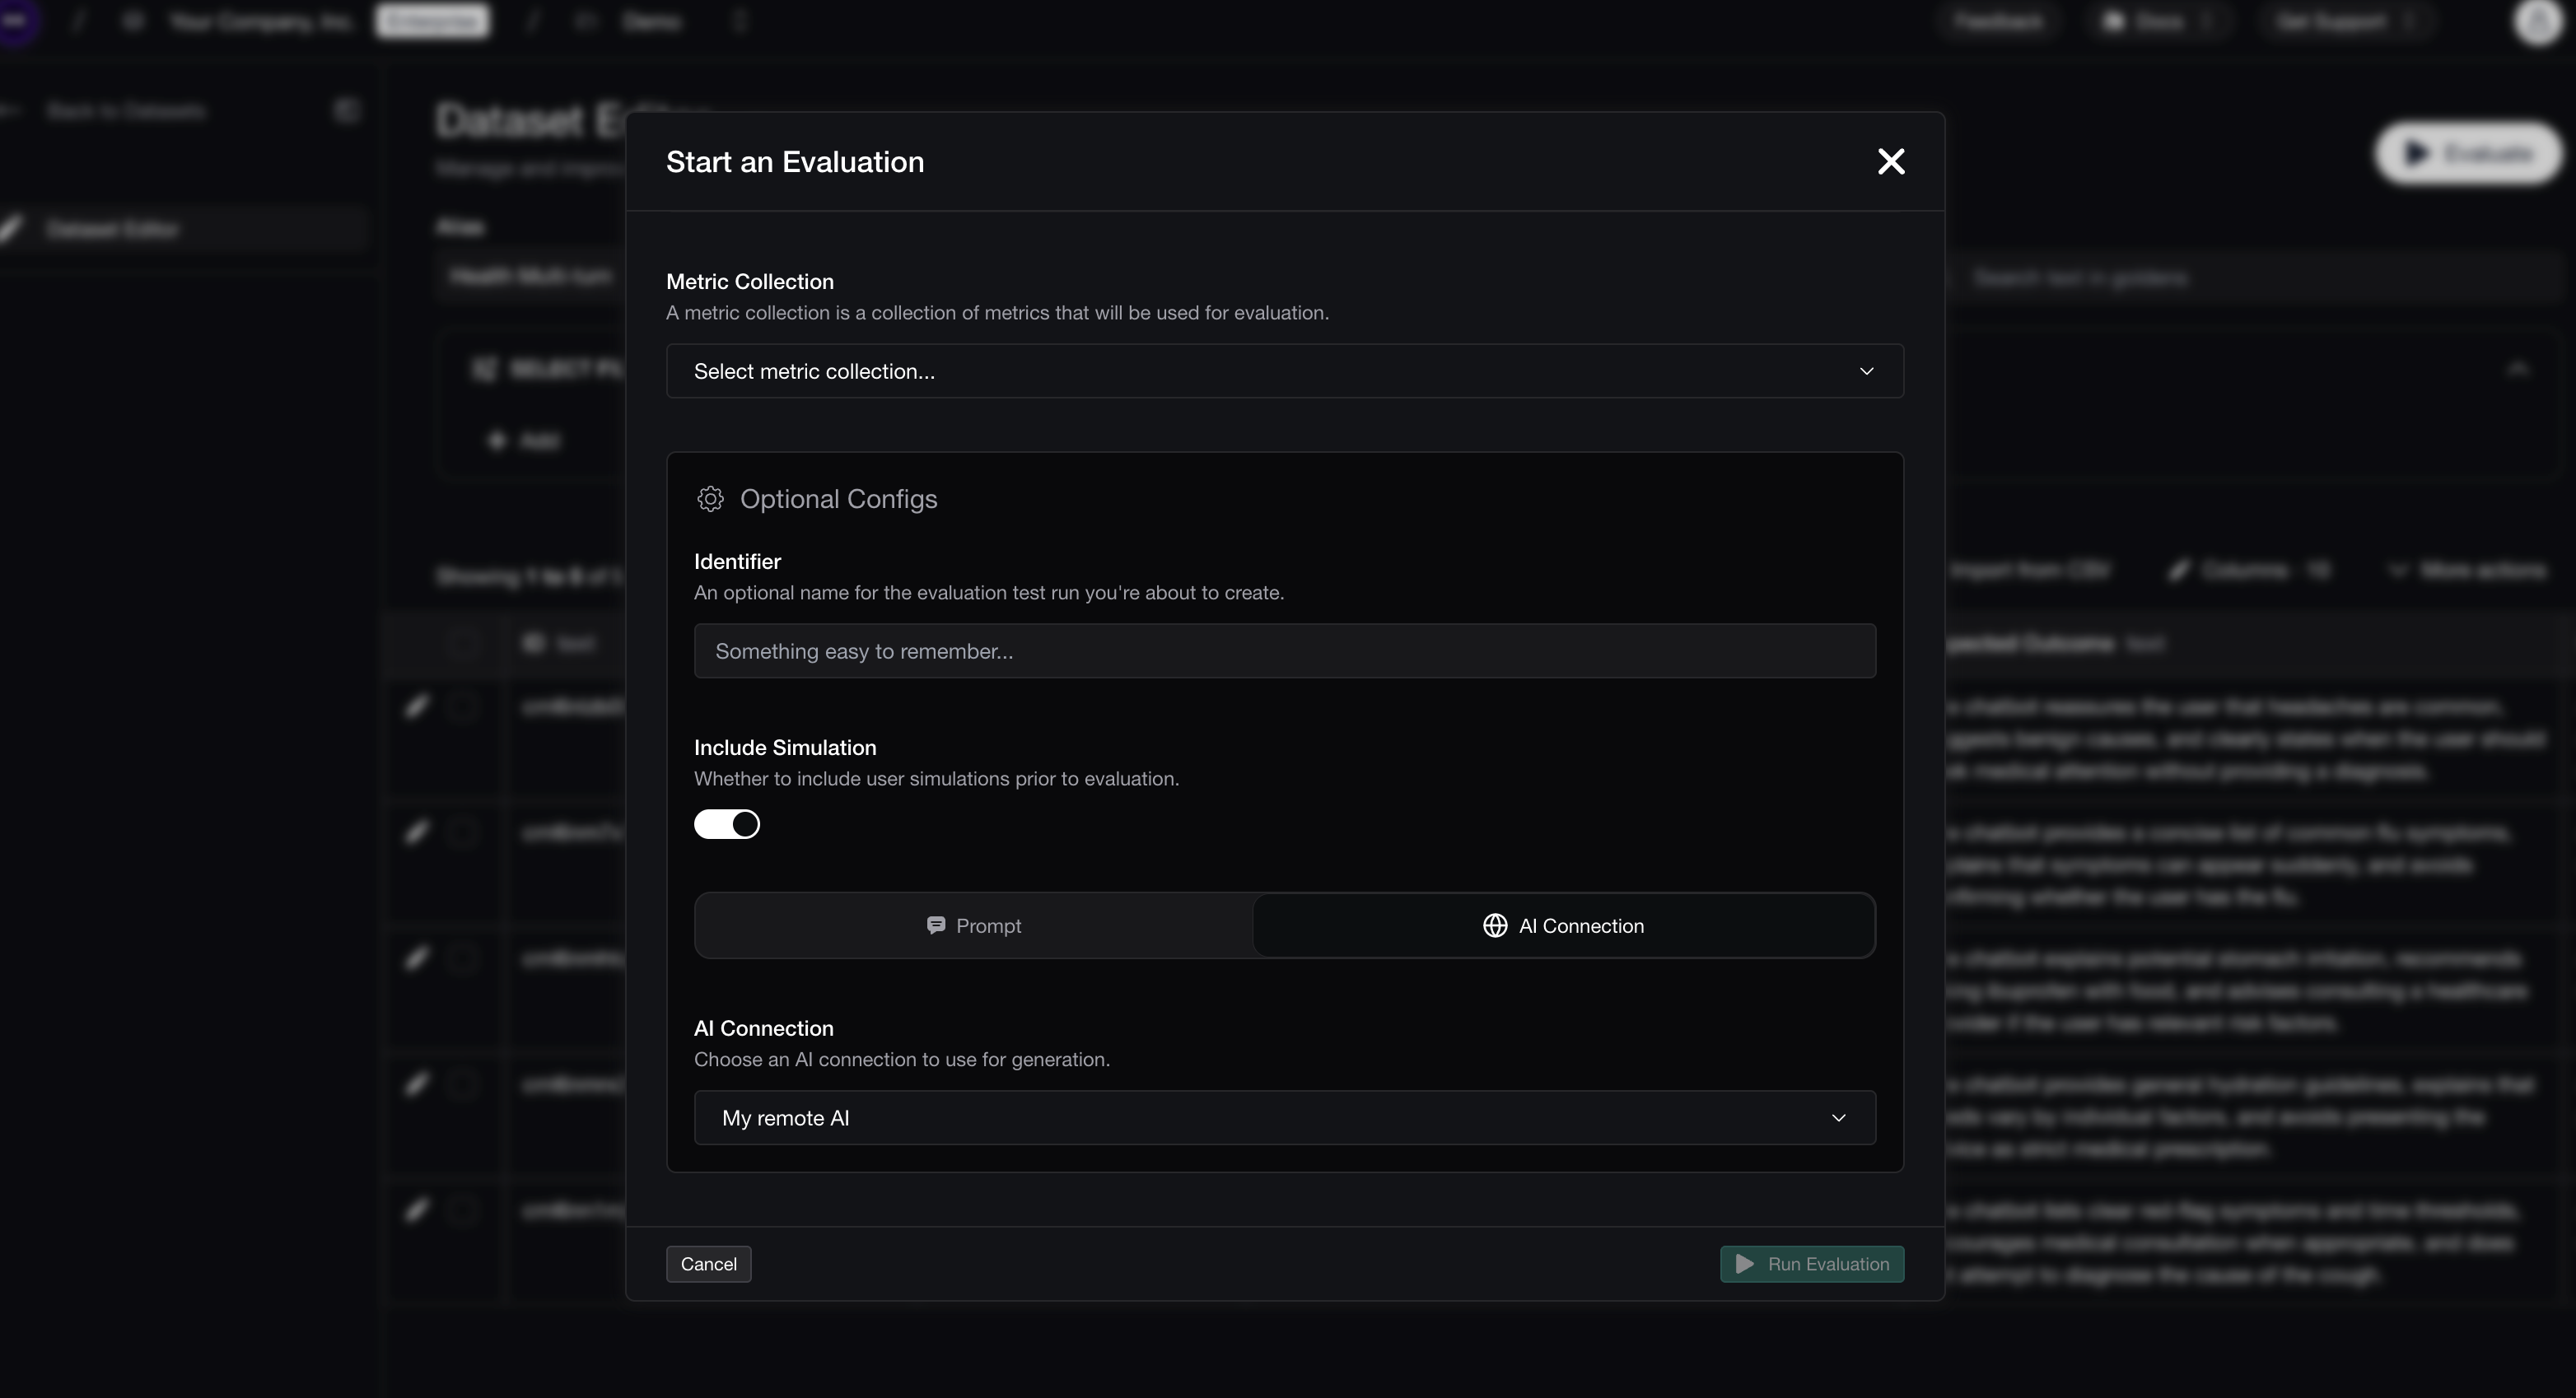
멀티턴 평가를 위한 AI 연결 구성
배포된 대화형 시스템의 경우 Confident AI를 HTTP 엔드포인트에 직접 연결해요.
- Settings → AI Connections로 이동해 연결 생성
- 요청 페이로드가 대화 기록을 수용하도록 엔드포인트 구성
- 평가 설정에서 이 AI 연결을 아웃풋 생성 방식으로 선택
이 기능이 동작하려면 기존 AI 연결이 필요해요. 아직 없다면 프로젝트 설정에서 AI 연결을 만들 수 있어요.
실행 및 결과 확인
Run Evaluation을 클릭하고 시뮬레이션이 완료될 때까지 기다려요. 대화 생성 단계 때문에 싱글턴 평가보다 오래 걸릴 수 있어요.
테스트 런 대시보드가 다음을 보여줘요:
- 점수 분포 — 각 메트릭의 평균, 중앙값, 백분위
- 통과/실패 결과 — 모든 메트릭이 임계값을 충족할 때만 대화 통과
- 전체 대화 로그 — 완전한 시뮬레이션된 대화 검토
- 턴별 분석 — 각 단계에서 AI가 어떻게 수행했는지 확인
멀티턴 테스트 런 결과
회귀 테스트 (Regression Testing)
테스트 런이 두 개 이상 있으면 나란히 비교해 회귀를 식별할 수 있어요.
회귀 테스트 열기
- 테스트 런의 A|B Regression Test 탭으로 이동
- New Regression Test 클릭
- 비교할 테스트 런 선택
회귀 분석
비교 보기는 다음을 강조해요:
- 회귀(Regressions) (빨강) — 더 나빠진 대화
- 개선(Improvements) (초록) — 더 좋아진 대화
- 나란히 보는 점수 — 런 간 메트릭 비교
A|B 회귀 테스트
다음 단계
싱글턴 평가 (Single-Turn Evals)
원샷 Q&A, 요약, 분류 작업을 평가해요.
Arena
프롬프트와 모델을 실시간으로 나란히 비교해요.